

Google souhaite que Gemini 4 Argon soit le seul modèle d’IA dont les robots ont besoin
 Jonathan Kemper
Voir le profil LinkedIn de Jonathan Kemper
15 octobre 2026
 Google Deepmind
Points clés
- Gemini 4 Argon est l’essai de Google pour un modèle d’IA unique qui contrôle les robots, génère des environnements d’entraînement 3D interactifs et évalue les données d’entraînement.
- Depuis des entrées simples telles que des photos ou des esquisses, le système crée des simulations permettant aux robots de s’entraîner à des mouvements avant leur déploiement dans la réalité.
- Les démonstrations nécessitent encore une instruction et une orientation humaines détaillées. Argon est disponible via les programmes payants d’accès pour développeurs de Google.
Avec le Gemini 4 Argon, Google propose un seul modèle pour l’ensemble du pipeline de robotique. Il contrôle les robots, crée des mondes de pratique virtuels et évalue les vidéos d’entraînement. Cependant, les exemples fournis révèlent à quel point le modèle a encore besoin de l’aide humaine.
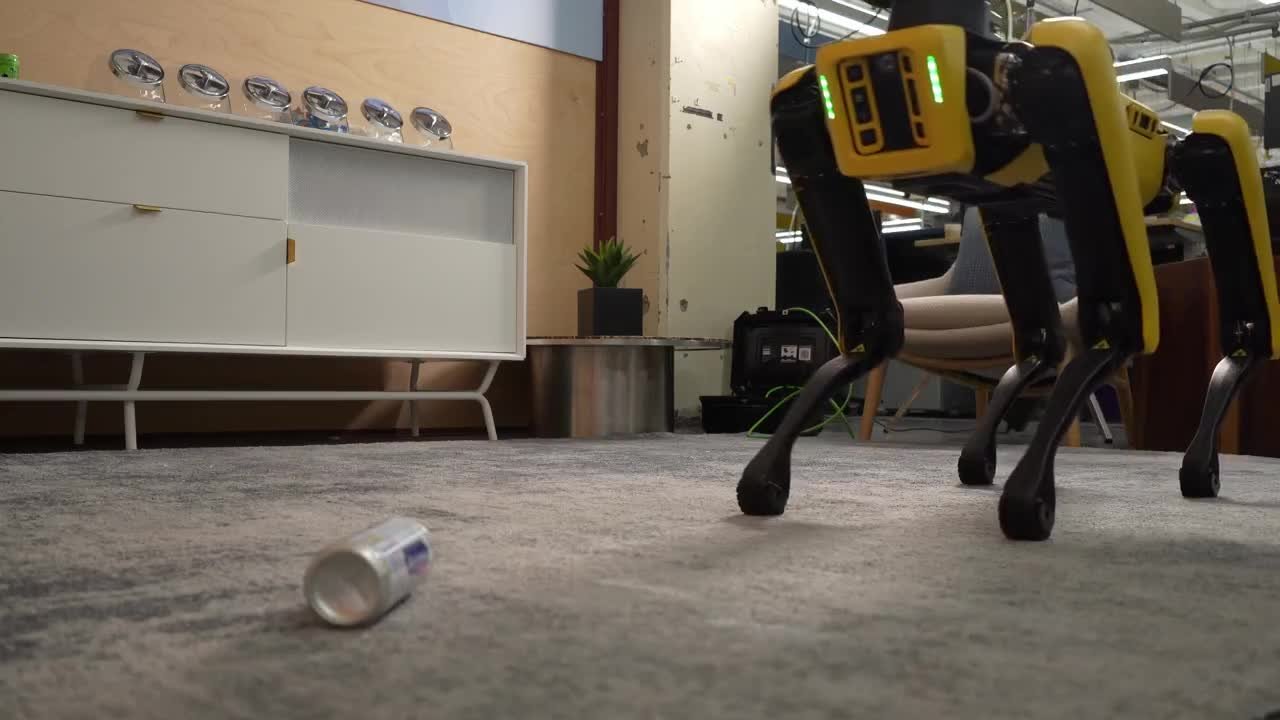
Un robot Spot de Boston Dynamics est censé jeter des bouteilles de soda dans un bac à ordures sur marche. Avant de toucher le pied réel, Gemini 4 Argon crée une copie virtuelle du bac, et le robot s’entraîne à se tenir debout sur trois pattes dans cette simulation. Ce n’est qu’après cela que le robot tente l’exercice avec du matériel réel. Avant de laisser tomber la bouteille, deux agents d’IA supplémentaires vérifient que le pied et le capteur sont positionnés correctement.
C’est ainsi que Google démontre les capacités de son nouveau modèle pour les tâches de robotique. Argon est conçu pour mieux comprendre les relations spatiales, écrire du code de contrôle et interpréter des vidéos en termes de physique. Google considère ce modèle comme un outil polyvalent qui couvre tout, depuis le contrôle de robots individuels jusqu’à la reproduction de recherches publiées, et il est considéré comme une nouvelle étape vers l’« AGI physique », une objectif que lui et sa filiale AI DeepMind ont pursuivant depuis des années.

Une seule photo devient des milliers de tours d’entraînement
Le démonstration Spot suit un modèle qui apparaît dans de nombreux exemples de Google : Argon utilise des simulations pour préparer des tâches, les vérifier ou générer des données d’entraînement. À partir d’une seule photo d’une table avec des accessoires de fête, le modèle a créé une réplique virtuelle, y compris un bonnet en peluche mousseux. Il a identifié 77 tâches, allant du rétablissement d’objets renversés à la nettoyage de la table, et a généré plus de 4 500 épisodes d’entraînement pour un modèle de contrôle. Lors de la test sur le robot réel, le taux de succès est passé de 56 à 75 % et le temps d'exécution est passé de 35 à 24 secondes.

L’argon peut également provenir d’autres sources. D’une enregistrement d’un robot téléopéré, il crée une simulation qui ressemble à la réalité et reproduit les mêmes lectures de force sur les doigts. D’un vidéo en première personne d’un humain effectuant une tâche de prise, le modèle mappe les mouvements de la main et des doigts sur un humain virtuel à cinq doigts.
Même un esquisse avec un stylo à bille suffit. Un dessin montre un robot humanoïde qui frappe une pile de boîtes avec une balle, et Argon transforme cela en simulation qui calcule le mouvement de lancer pour renverser toutes les six boîtes sans que le robot ne tombe.

Argent dirige un modèle vidéo d’IA pour planifier les actions des robots
Une démonstration se déroule entièrement dans un vidéo généré par l’IA. Gemini Omni est un modèle de monde vidéo qui génère des clips montrant comment une scène change lorsque quelque chose se produit, et Argon joue le rôle du directeur. Il écrit des instructions en temps réel décrivant ce que les mains doivent faire, comme placer une pièce de Scrabble au centre de la table. Gemini Omni génère un vidéo à partir de ces instructions, puis Argon vérifie chaque frame et ajuste la commande suivante. L’objectif est d’organiser cinq pièces de lettres éparses pour former le mot “ARGON”, et après 33 étapes, elles sont dans l’ordre correct.

Dans une démonstration distincte avec un simple bras robotique, Argon devait placer une brique Lego dans une boîte en bois et améliorer ses propres performances au fil du temps. Lorsque les tentatives échouaient, l’instruction demandait à Argon de consulter ses propres logs et images de caméra, de trouver la cause du problème et de réessayer après avoir appliqué une correction vérifiée. La première tentative a duré moins d’une minute, et la deuxième a été beaucoup plus rapide, en 23 secondes, bien que la brique ait heurté le bord de la boîte. Au troisième essai, elle est tombée exactement au centre après environ 17 secondes.

Google souhaite également que Argon fournisse des données de recherche. Avec un seul prompt par article, il reproduit les expériences de robotique publiées sous forme de simulations interactives qui s’exécutent dans le navigateur. Google indique qu’à ce jour, 68 sandboxes ont été créés, incluant des jeux de football robotique et un robot humanoïde sur un skateboard.
Le benchmark ERQA (Embodied Reasoning Question Answering) évalue la capacité des modèles d’IA à comprendre et résoudre des problèmes physiques et spatiaux dans des environnements 3D. Le test comporte 400 questions sans outils d’aide, de sorte que les modèles doivent résoudre tout cela uniquement par raisonnement. Argon obtient 87 % selon Google, devant tous les autres modèles de pointe. Le deuxième place, Claude Opus 5.5, atteint 82,3 %, soit environ cinq points de moins. GPT-6 Astra se classe à 81 %, et Claude Fable 5.1 est derrière à 74 %, avec 13 points de retard.

Le benchmark AA-Robotics de Artificial Analysis, publié un jour plus tard, raconte une histoire différente. Dans cet essai, les modèles de langage contrôlent directement un bras robotique réel sur huit tâches, et Argon obtient la troisième place avec 55 points sur 100, derrière GPT-6 Astra avec 69 points et GPT-6.1 Sol avec 65 points.
Argón examine également la qualité des données de formation
En plus de contrôler les robots et de créer des simulations, Argon vise à évaluer les données d’entraînement. Dans un vidéo d’un peu plus de deux minutes montrant un robot à deux bras pliant un renard origami, le modèle divise la séquence en sous-étapes et marque les pauses et les prises mal effectuées. Ces segments reçoivent alors une poids moindre pendant l’entraînement. Dans un autre vidéo montrant une personne triant des anneaux, Argon trace où la tâche progresse, où elle s’arrête ou où elle revient en arrière.
Google a également présenté un exemple d’utilisation plus ludique basé sur un énigme de pesée classique. Parmi douze boules ayant la même apparence, une est plus lourde ou plus légère que les autres. Argon a construit une simulation avec deux bras robotiques et un plateau de balance, en lisant simplement la inclinaison du plateau à partir des images de caméra. Il trouve la boule étrange en trois pesages ou moins.
Le véritable cadre se trouve dans les prompts
Google a publié des exemples détaillés pour les démonstrations, et il a mis en perspective certaines affirmations importantes. Pour redresser une tasse renversée, décrit comme « zéro-shot », Argon reçoit une image de caméra avec un overlay en grille de centimètres et des commandes prêtes à l’emploi telles que « saisir » ou « abaisser jusqu’à contact ». Pour les simulations, il y a de longues listes d’interdictions afin d’empêcher le modèle de prendre des raccourcis, comme simplement copier les valeurs mesurées par le capteur. Google ne partage pas les taux d’échec pour chaque démo dans le blog post, et le taux de succès de 75 % ne mentionne pas non plus le nombre total d’essais sur lequel il est basé.

L’argon est désormais disponible dans Google AI Studio et l’environnement de développement Antigravity, mais uniquement pour les abonnés Google AI Ultra. Les développeurs peuvent également accéder au modèle via le niveau payant de l’Gemini API.
Google avait lancé Gemini 4 Argon dans le monde juste quelques jours avant. En matière de robotique, l’entreprise avait déjà introduit Gemini Robotics-ER 1.6, un modèle destiné à la perception spatiale et à la planification des tâches. L’entraînement dans des environnements virtuels n’est pas non plus nouveau : l’entreprise World Labs a montré comment des scènes réelles peuvent être transformées en mondes de formation virtuels, tandis que DreamDojo de Nvidia simule les actions des robots sous forme de vidéos. Ce qui distingue l’approche de Google, c’est l’ambition de gérer la simulation, le contrôle et l’évaluation avec le même modèle.
Nouvelles sur l’IA sans hype – sélectionnées par des humains
S'abonner à THE DECODER pour une lecture sans publicités, un bulletin informatif sur l’IA semestriel, notre rapport exclusif « AI Radar » six fois par an, accès complet à l’archive et à la section de commentaires.
Source : Google