
Muse Spark Open, le modèle open-weight optimisé pour le codage de Meta, est désormais disponible dans Amazon SageMaker JumpStart, le hub d'apprentissage automatique (ML) d' Amazon SageMaker AI. Le modèle a été entraîné sur des flux de travail réels de développeurs, tels que le refactorisation multi-fichiers et les longues sessions de débogage, et il prend en charge une fenêtre de contexte de 1 million de tokens. Vous pouvez le déployer sur un point de terminaison SageMaker AI dans votre propre compte AWS en quelques étapes, sans avoir à gérer vous-même l'infrastructure de service. SageMaker JumpStart propose deux variantes : BF16 (Muse-Spark-Open-816B-A42B) et quantisée NVFP4 (Muse-Spark-Open-816B-A42B-NVFP4).
Dans cet article, nous présentons Muse Spark Open et vous montrons comment déployer le modèle avec Amazon SageMaker Studio et le SageMaker Python SDK, lui envoyer une première requête d'inférence, puis procéder au nettoyage.
Présentation de Muse Spark Open
Meta décrit Muse Spark Open comme un modèle optimisé pour le codage, entraîné pour les flux de travail de codage agentique, avec un accent sur la précision dès la première tentative, l'appel d'outils et la compréhension de grandes bases de code. C'est un modèle de raisonnement, et il accepte en entrée du texte, des images, des documents, de l'audio et de l'audio-vidéo, et renvoie du texte.
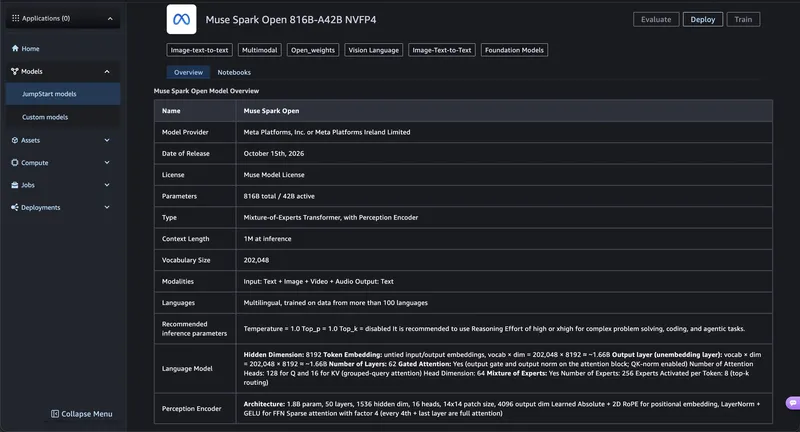
Muse Spark Open utilise une architecture mixture-of-experts (MoE) avec 816 milliards de paramètres au total, dont 42 milliards sont actifs pour chaque token. Le modèle possède la capacité d'un très grand réseau, tandis que le calcul qu'il consacre à chaque token se rapproche de celui d'un modèle dense bien plus petit. Meta publie les poids sous la Muse Model License, qui inclut la Muse Spark Usage Policy.
Le tableau suivant résume le modèle.
| Attribut | Muse Spark Open |
| Fournisseur | Meta |
| Architecture | Mixture of experts (MoE), modèle de raisonnement |
| Paramètres | 816B au total, 42B actifs |
| Longueur du contexte | 1M de tokens |
| Modalités d'entrée | Texte, image, document, audio, audio-vidéo |
| Modalités de sortie | Texte |
| Variantes dans SageMaker JumpStart | BF16 et NVFP4 |
| Licence | Muse Model License, y compris la Muse Spark Usage Policy |
Conçu pour les agents de codage de longue durée
Meta a entraîné Muse Spark Open sur la façon dont les développeurs travaillent dans de vrais dépôts : génération de code, débogage, refactorisations multi-fichiers et tâches qui s'exécutent longtemps. Avec la fenêtre de contexte de 1 million de jetons, le modèle peut absorber un projet entier, y compris ses dépendances, son code historique et des milliers de fichiers. Vous n'avez pas besoin de diviser une tâche en morceaux plus petits pour qu'elle tienne dans le contexte.
Meta a également conçu Muse Spark Open comme un modèle agentique dès le départ. Meta indique que le modèle planifie, agit, observe le résultat et se corrige sur de longues séquences, plutôt que de faire de simples appels d'outils. En tant que modèle de raisonnement, il réfléchit à une tâche avant d'agir, et le point de terminaison SageMaker AI renvoie ce raisonnement avec la réponse, ce qui vous permet de suivre ce qu'un agent fait et pourquoi. Meta a entraîné le modèle à naviguer sur le web, à coordonner des sous-agents pour un travail pouvant être réparti et à utiliser des ordinateurs dans des environnements de bureau, mobiles et de navigateur. Ce sont des capacités du modèle. Sur SageMaker AI, votre application ou votre framework d'agents fournit les outils, le navigateur et l'environnement d'utilisation de l'ordinateur que le modèle appelle. Au-delà du code, Meta rapporte que Muse Spark Open raisonne sur des images, des documents, de l'audio et de la vidéo.
Deux propriétés du modèle déterminent la manière de le servir. Premièrement, l'activation parcimonieuse maintient un calcul par jeton faible, mais le service nécessite tout de même suffisamment de mémoire GPU pour contenir les 816 milliards de paramètres, de sorte que le choix de l'instance se résume à la capacité mémoire. Deuxièmement, la variante NVFP4 stocke les poids au format flottant 4 bits de NVIDIA, qui nécessite environ un quart de la mémoire des poids BF16. Sur SageMaker AI, cette différence décide de l'instance : la variante NVFP4 s'exécute sur ml.p5e.48xlarge, et la variante BF16 s'exécute sur ml.p6-b300.48xlarge. Cela fait de NVFP4 la variante à essayer en premier lorsque vous dimensionnez pour le coût. Évaluez-la sur vos propres charges de travail pour confirmer que la qualité convient à votre cas d'utilisation.
Avec des poids ouverts sur SageMaker AI, vous contrôlez également le déploiement. Le point de terminaison s'exécute dans votre compte AWS, de sorte que votre code source et vos invites sont traités sur une infrastructure que vous configurez et contrôlez. Vous pouvez attacher le point de terminaison à votre propre Amazon Virtual Private Cloud (Amazon VPC), chiffrer son volume de stockage avec une clé de AWS Key Management Service (AWS KMS), et activer l'isolement réseau pour le conteneur. Vous choisissez également le type d'instance et les limites de mise à l'échelle, et vous figez la version du modèle, de sorte que le modèle ne change que lorsque vous redéployez.
Cas d’utilisation
Vous pouvez utiliser Muse Spark Open pour un large éventail d’applications. L’accent mis par Meta sur le codage et les flux de travail agentiques le rend adapté aux cas d’utilisation suivants :
- Assistants de codage sur des dépôts privés: répondre à des questions sur de grandes bases de code, les refactoriser et les déboguer avec l’ensemble du projet en contexte, pendant que le code est traité sur un point de terminaison dans votre compte.
- Agents de codage à exécution longue: exécuter des agents qui planifient une modification, éditent plusieurs fichiers, exécutent des tests dans votre propre sandbox et corrigent le cap en fonction des résultats.
- Flux de travail d’ingénierie multimodaux: transformer des captures d’écran, des documents de conception ou un rapport de bug enregistré avec audio et vidéo en un plan de reproduction ou une ébauche de correctif.
Prise en main de SageMaker JumpStart
Vous pouvez déployer Muse Spark Open depuis SageMaker Studio ou avec le SageMaker Python SDK. Chaque méthode crée un point de terminaison SageMaker AI en temps réel dans votre compte.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
- Un compte AWS avec les autorisations nécessaires pour créer des modèles et des points de terminaison SageMaker AI.
- Un rôle d’exécution AWS Identity and Access Management (IAM) pour SageMaker AI. Pour cette procédure pas à pas, la
AmazonSageMakerFullAccessstratégie gérée est suffisante. En production, limitez le rôle aux actions et ressources dont votre déploiement a besoin. Pour plus de détails, consultez How to use SageMaker AI execution roles. - Un domaine SageMaker AI avec accès à SageMaker Studio, pour la méthode Studio. Pour les instructions de configuration, consultez Use quick setup for Amazon SageMaker AI.
- Quota de service pour le type d’instance du point de terminaison : ml.p5e.48xlarge for endpoint usage pour la variante NVFP4, ou ml.p6-b300.48xlarge for endpoint usage pour la variante BF16. Pour demander une augmentation de quota, consultez Requesting a quota increase.
- Pour la méthode SDK : Python 3.10 ou version ultérieure et SageMaker Python SDK v3 (
pip install --upgrade sagemaker). - Une Région AWS où Muse Spark Open est disponible dans SageMaker JumpStart. Au lancement, Muse Spark Open est disponible dans US East (N. Virginia) et US East (Ohio). Pour vérifier la disponibilité dans d’autres Régions, ouvrez SageMaker JumpStart dans votre Région.
Les instances qui hébergent Muse Spark Open sont des instances multi-GPU, et vous payez un point de terminaison tant qu’il est actif, qu’il traite ou non des requêtes. Supprimez le point de terminaison une fois terminé, comme décrit dans la section de nettoyage de cet article. Pour les tarifs, consultez Amazon SageMaker AI pricing.
Déployer avec SageMaker Studio
La méthode SageMaker Studio convient à une première évaluation : vous trouvez le modèle, examinez sa licence et le déployez depuis une seule carte de détails du modèle.
Pour trouver Muse Spark Open dans SageMaker JumpStart
- Ouvrez SageMaker Studio.
- Dans le volet de navigation, choisissez JumpStart.
- Dans la zone de recherche, saisissez Muse Spark Open.
- Choisissez Muse-Spark-Open-816B-A42B pour la variante BF16 ou Muse-Spark-Open-816B-A42B-NVFP4 pour la variante NVFP4 afin d'ouvrir sa carte de détails du modèle.
La figure 1 montre la carte de détails du modèle, qui répertorie la description du modèle, la licence et l'option Deploy .
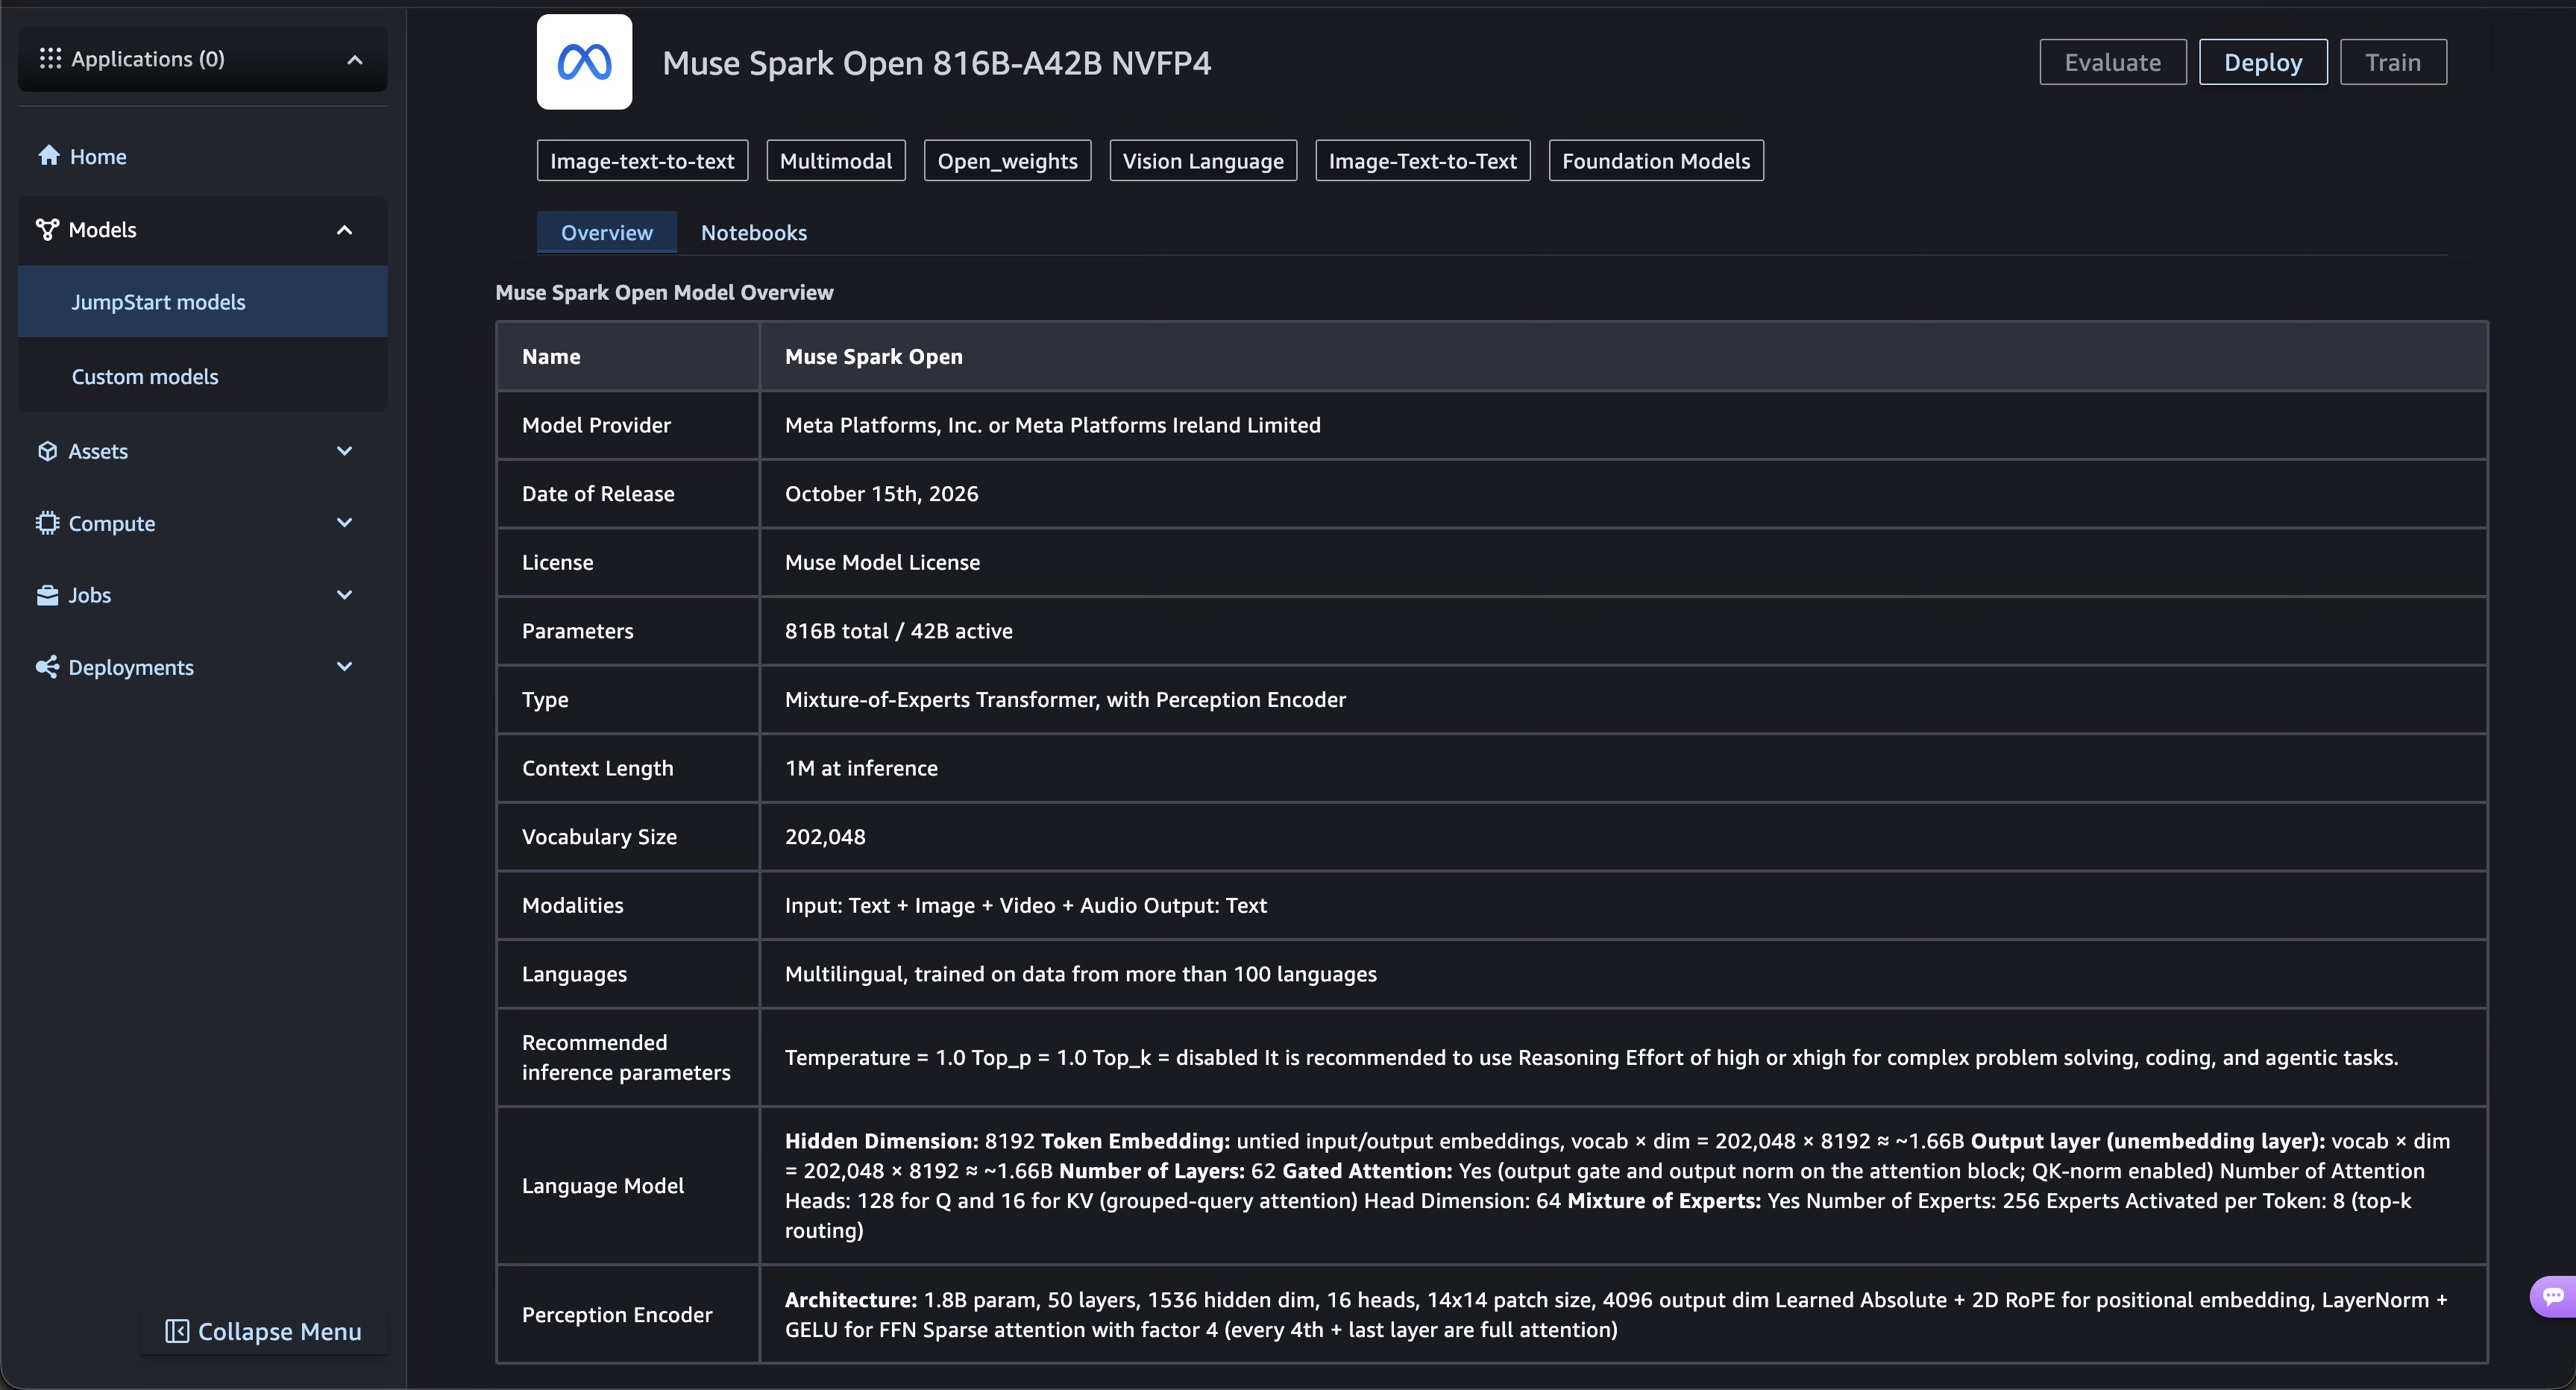
Figure 1 : la carte de détails du modèle Muse Spark Open dans SageMaker JumpStart
Pour déployer le modèle
- Sur la carte de détails du modèle, choisissez Deploy.
- Muse Spark Open est un modèle gated, donc SageMaker Studio affiche son contrat de licence utilisateur final (EULA). Examinez le contrat et acceptez-le pour continuer.
- Pour Endpoint name, conservez le nom généré ou saisissez le vôtre.
- Pour Instance type, sélectionnez ml.p5e.48xlarge pour NVFP4 ou ml.p6-b300.48xlarge pour BF16. SageMaker Studio répertorie uniquement les types d'instance pris en charge par le modèle.
- Pour Initial instance count, saisissez 1.
- (Facultatif) Sous Options avancées, sélectionnez un VPC et une clé AWS KMS, ou activez l'isolation réseau.
- Choisir Déployer.
La figure 2 montre les paramètres de déploiement pour la variante NVFP4.
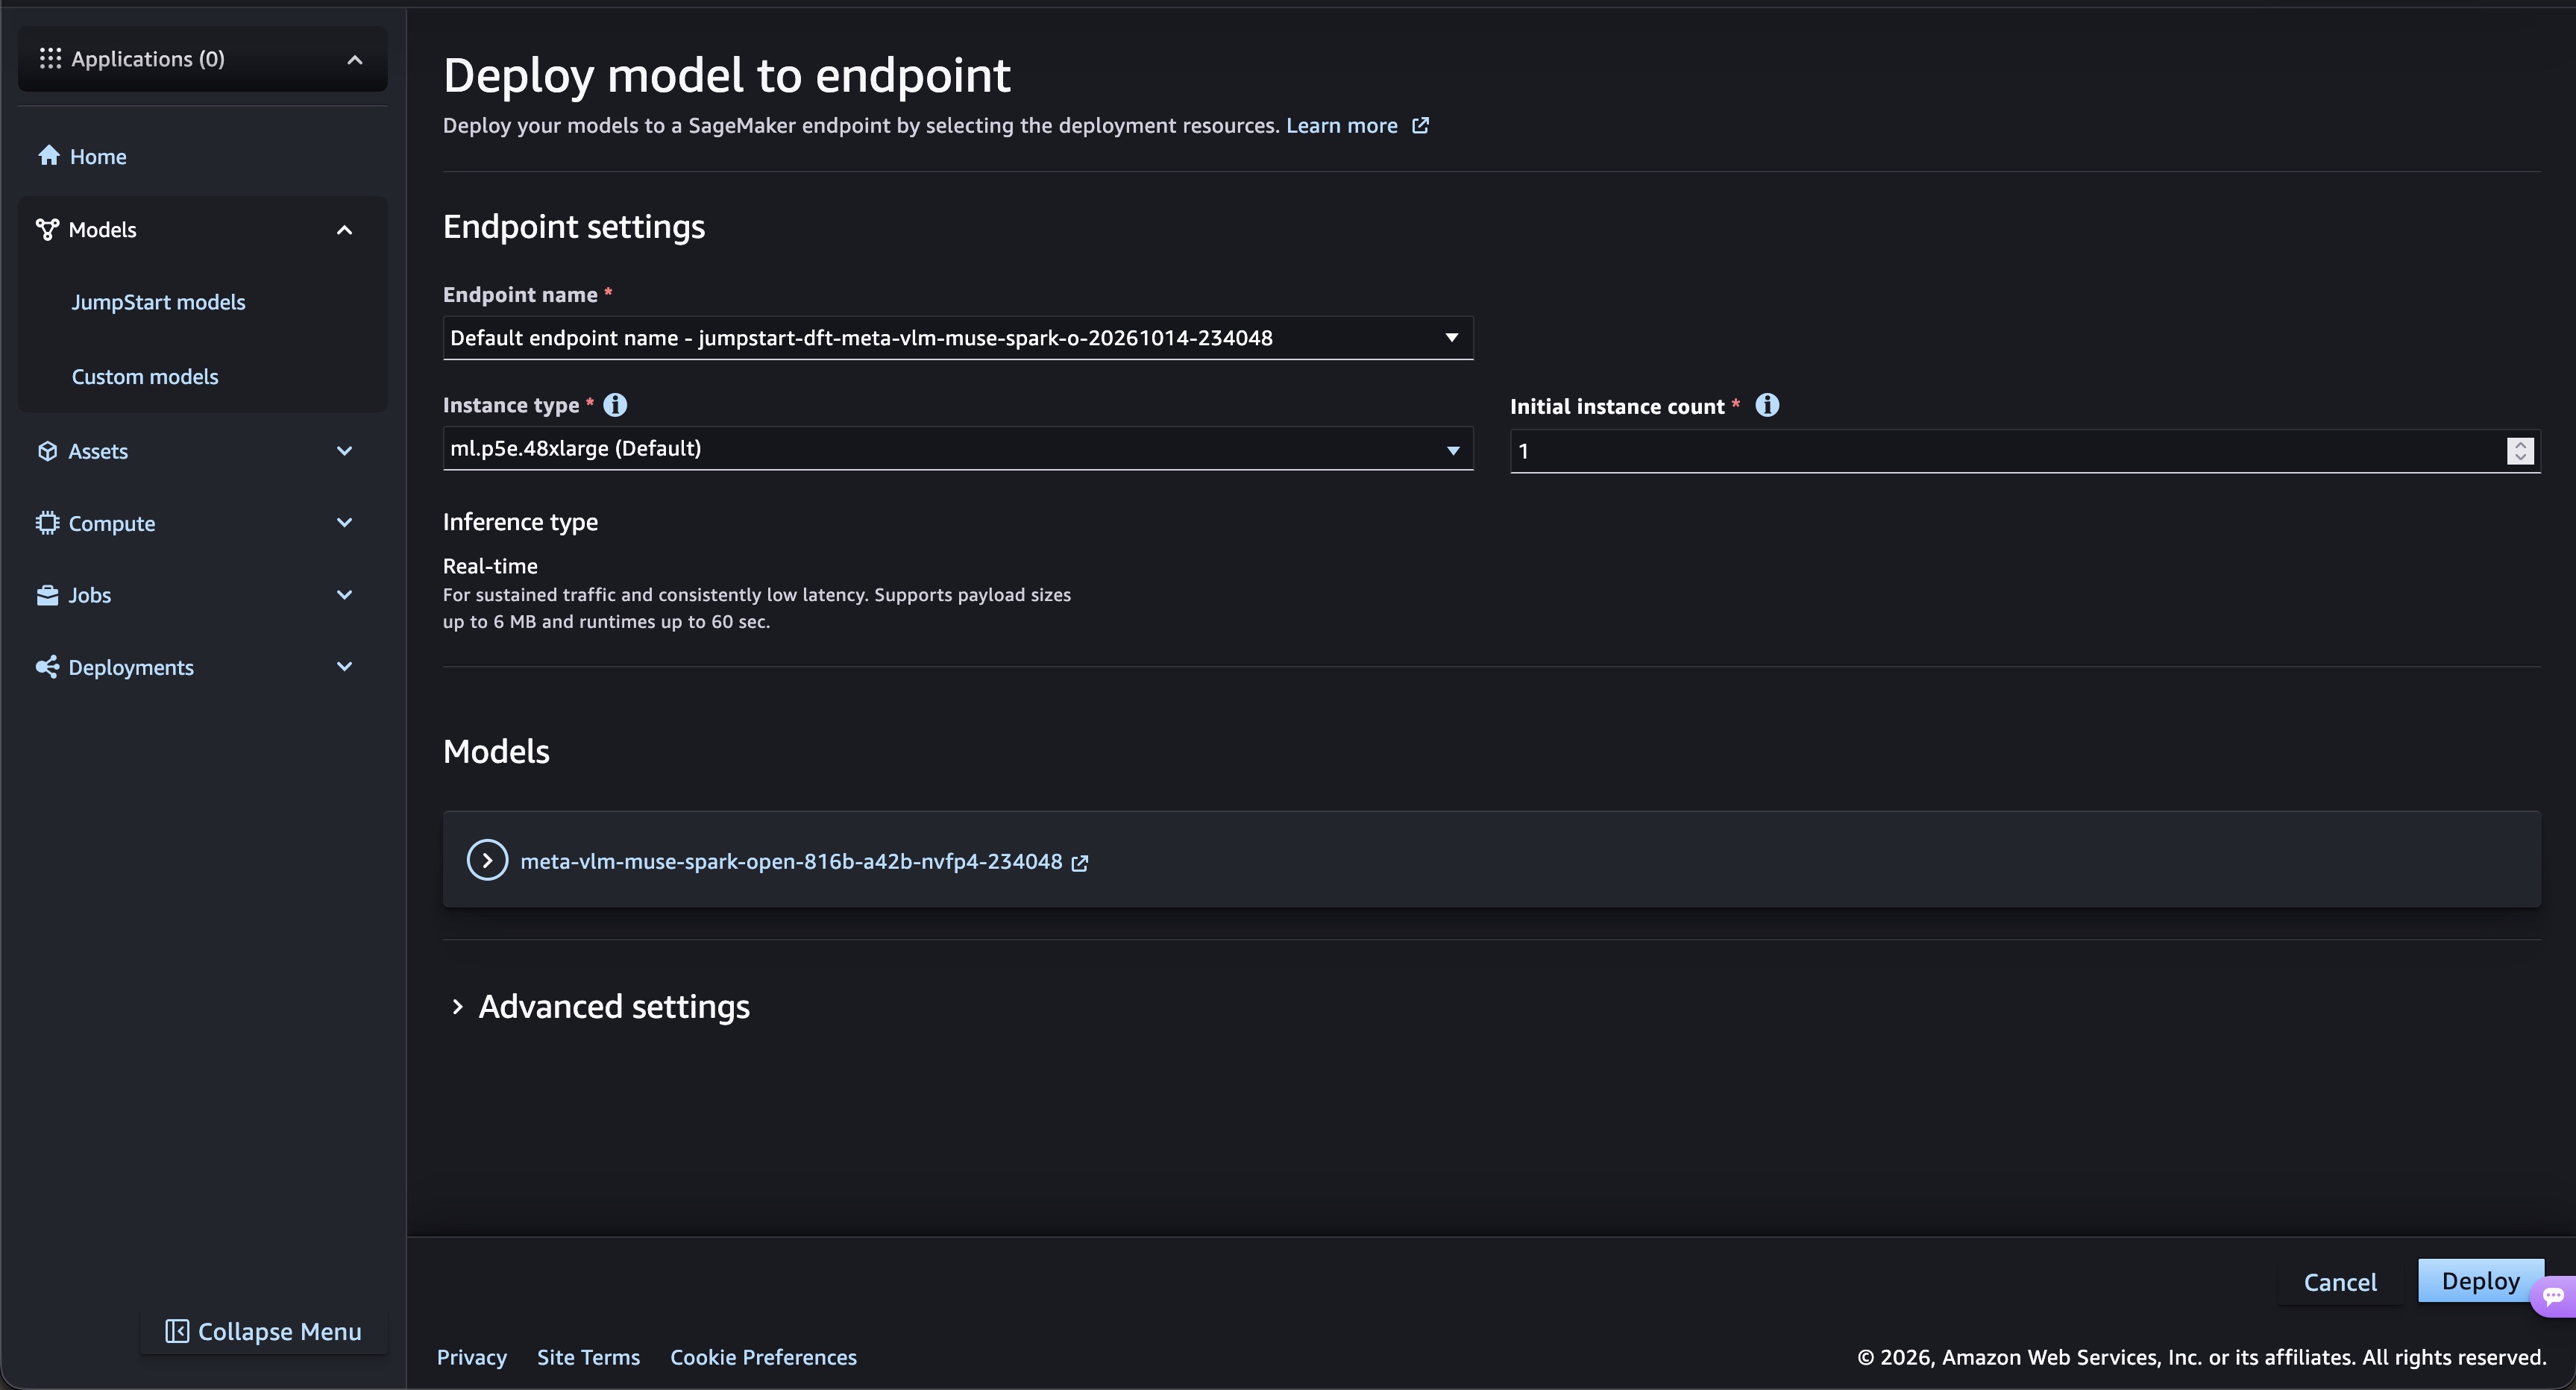
Figure 2 : Paramètres de déploiement pour Muse Spark Open
Le déploiement prend généralement 15 à 20 minutes, le temps que SageMaker AI approvisionne l'instance et charge les poids. Lorsque le statut du point de terminaison passe à InService, le point de terminaison est prêt à recevoir des requêtes, comme le montre la figure 3.
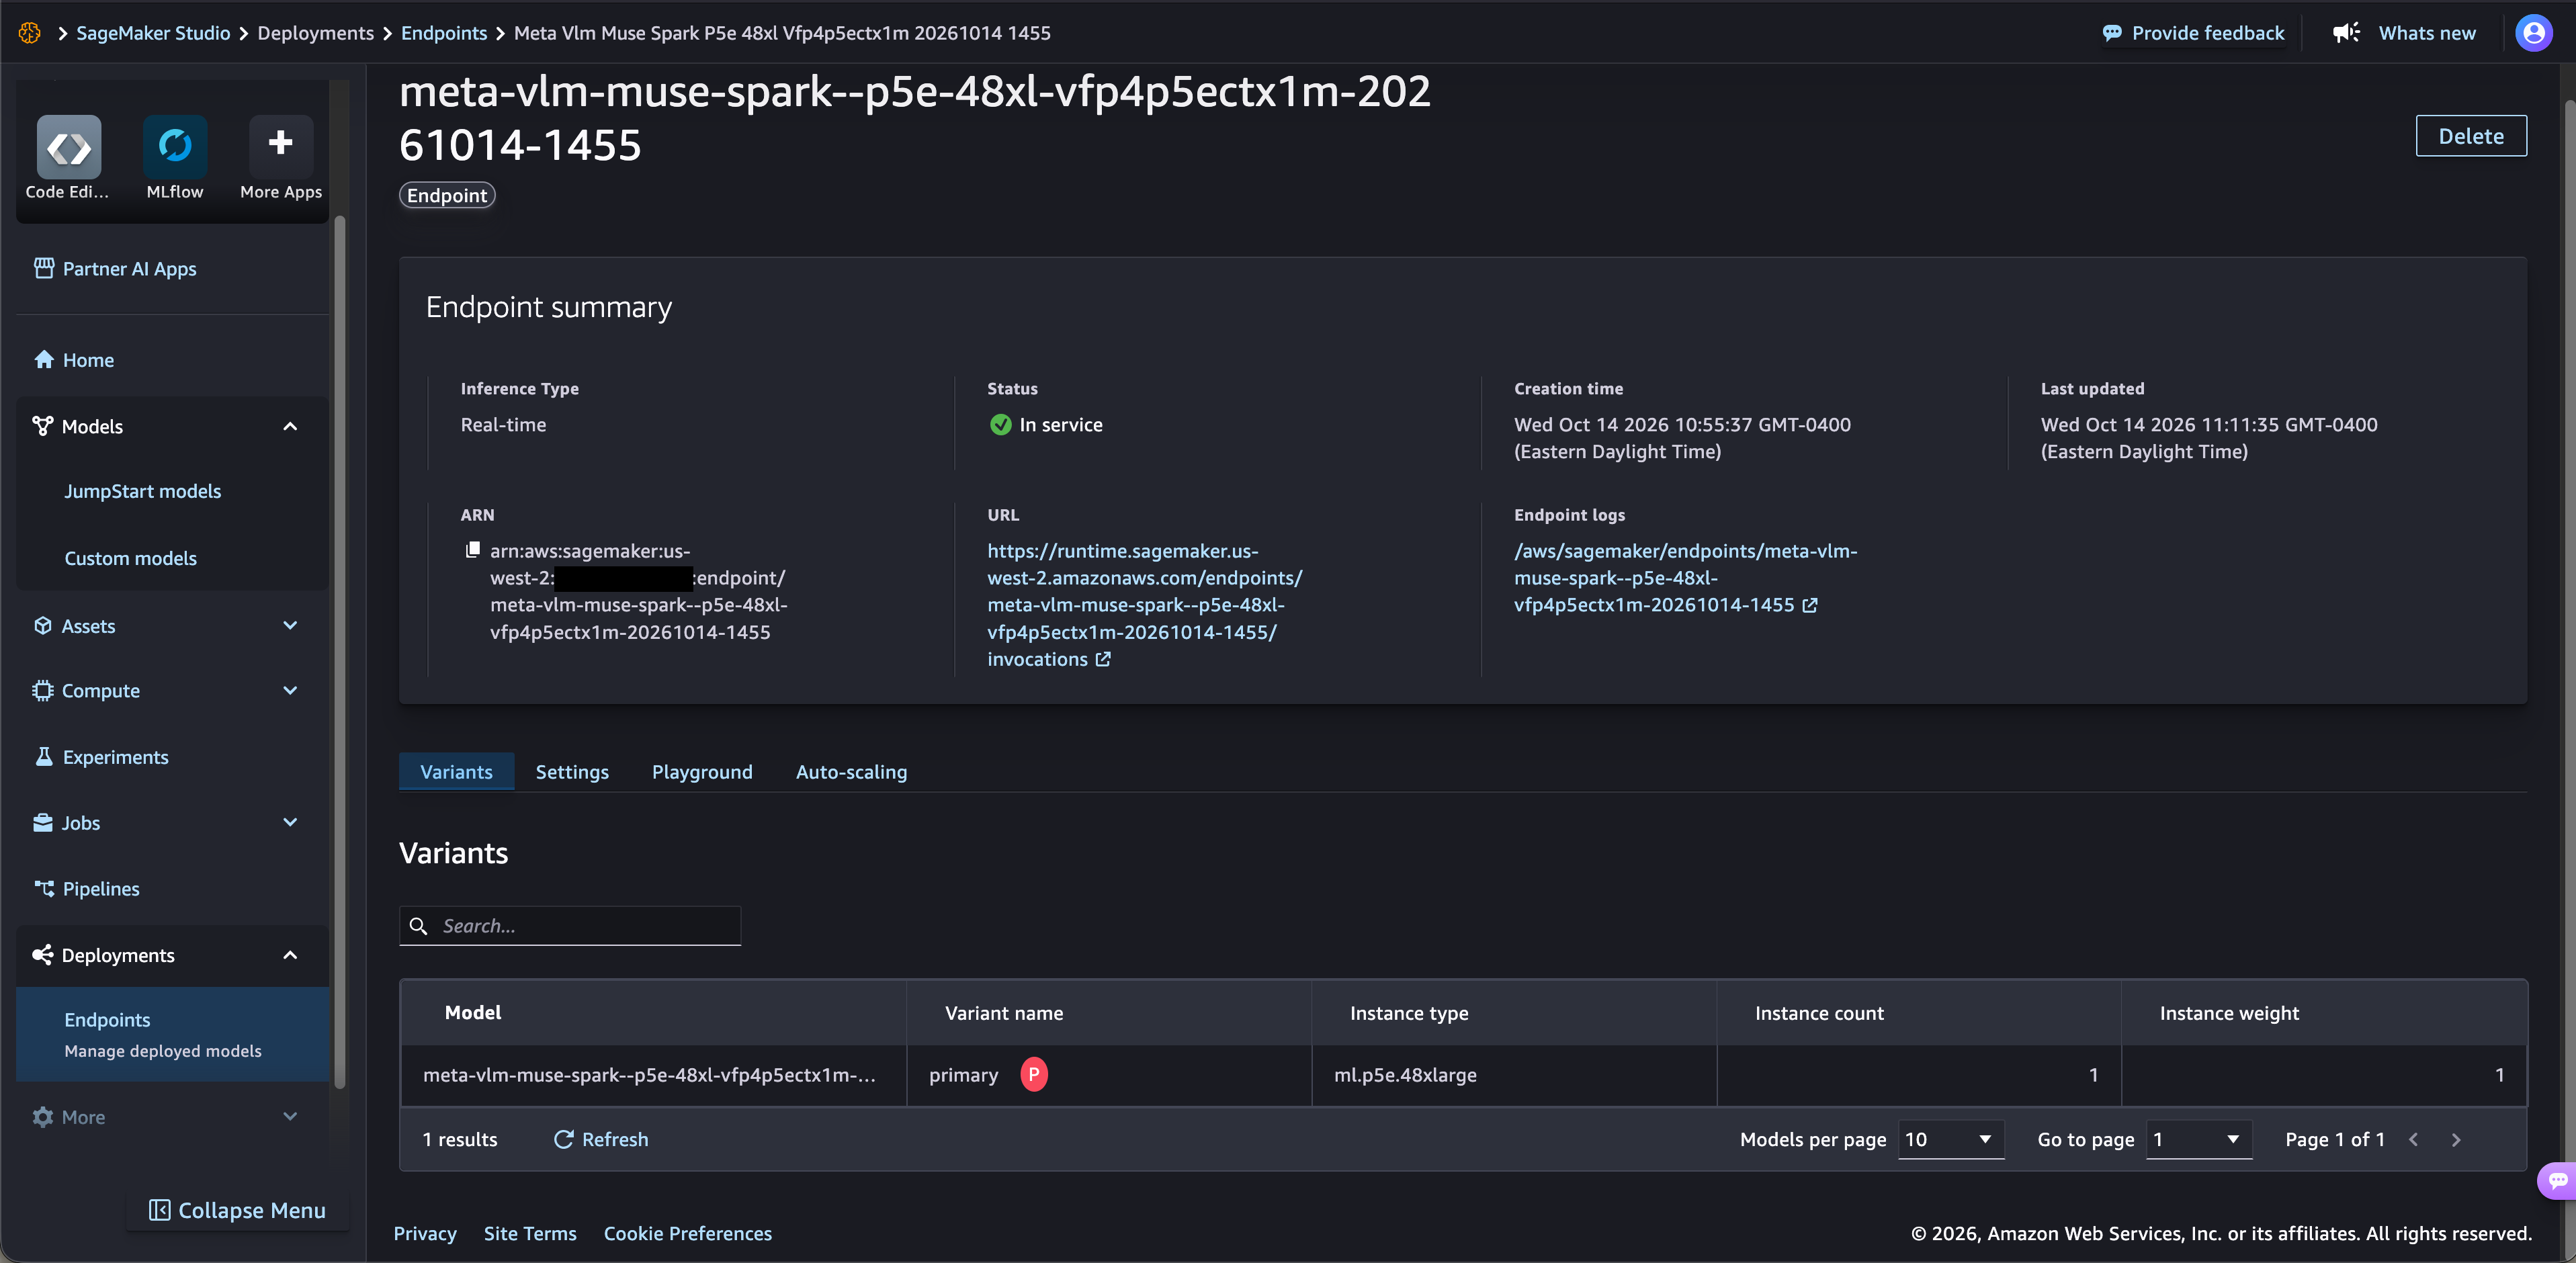
Figure 3 : Le point de terminaison Muse Spark Open en service
Déployer avec le SageMaker Python SDK
SageMaker JumpStart identifie chaque variante par un ID de modèle :
- BF16 :
meta-vlm-muse-spark-open-816b-a42b. - NVFP4 :
meta-vlm-muse-spark-open-816b-a42b-nvfp4.
Le code suivant déploie la variante NVFP4 avec le SageMaker Python SDK v3. Vous pouvez l'exécuter dans un bloc-notes SageMaker Studio, qui utilise le rôle d'exécution de votre domaine. Dans tout autre environnement Python disposant d'identifiants AWS, transmettez votre rôle d'exécution SageMaker AI via le paramètre role_arn . Muse Spark Open est un modèle à accès restreint, vous devez donc définir accept_eula=True pour le déployer. Pour épingler une version spécifique du modèle, ajoutez model_version à JumpStartConfig.
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve import ModelBuilder
from sagemaker.train.configs import Compute

# NVFP4 variant; for BF16, use "meta-vlm-muse-spark-open-816b-a42b" with ml.p6-b300.48xlarge
model_id = "meta-vlm-muse-spark-open-816b-a42b-nvfp4"

jumpstart_config = JumpStartConfig(
    model_id=model_id,
    accept_eula=True,  # Confirms that you accept Meta's license terms
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(instance_type="ml.p5e.48xlarge"),
    # role_arn="<your-sagemaker-execution-role-arn>",  # Required outside SageMaker Studio
)

model = model_builder.build(model_name="muse-spark-open-nvfp4")
endpoint = model_builder.deploy(endpoint_name="muse-spark-open-nvfp4")
Exécuter l'inférence
Lorsque le point de terminaison est en service, envoyez-lui une requête avec la méthode invoke . Le point de terminaison accepte une charge utile de chat compatible OpenAI avec une liste messages et renvoie une complétion de chat. La réponse finale se trouve dans message.content, le raisonnement du modèle se trouve dans message.reasoning_content, et usage.reasoning_tokens indique combien de jetons le raisonnement a utilisés. Comme Muse Spark Open est un modèle de raisonnement, laissez suffisamment d'espace dans max_tokens pour son raisonnement et la réponse finale.
import json

payload = {
    "messages": [
        {
            "role": "user",
            "content": "Write a Python function that validates ISO 8601 dates, and add pytest unit tests for it.",
        }
    ],
    "max_tokens": 4096,
}

response = endpoint.invoke(
    body=json.dumps(payload),
    content_type="application/json",
)

result = json.loads(response.body.read().decode("utf-8"))
message = result["choices"][0]["message"]
print("Reasoning:", message.get("reasoning_content"))
print("Answer:", message["content"])
Le point de terminaison prend également en charge le streaming. Pour recevoir les jetons au fur et à mesure de leur génération, ajoutez "stream": true au corps de la requête et appelez endpoint.invoke_with_response_stream au lieu de invoke.
Nettoyage
Pour arrêter d'encourir des frais, supprimez le point de terminaison lorsque vous n'en avez plus besoin. Si vous avez déployé avec le SDK, supprimez le modèle, le point de terminaison et la configuration du point de terminaison :
from sagemaker.core.resources import EndpointConfig

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_name)
model.delete()
endpoint.delete()
endpoint_config.delete()
Si vous avez déployé depuis SageMaker Studio, supprimez le point de terminaison dans la console SageMaker AI : choisissez Inference, puis Points de terminaison, sélectionnez le point de terminaison, puis choisissez Actions, Supprimer.
Conclusion
Dans cet article, nous avons montré comment déployer Muse Spark Open, le modèle open-weight optimisé pour le code de Meta, depuis SageMaker JumpStart vers un point de terminaison dans votre propre compte AWS. Vous avez utilisé SageMaker Studio ou le SageMaker Python SDK et envoyé une première requête d’inférence au modèle. Testez les deux variantes en benchmark sur vos propres dépôts avant de choisir une instance pour la production.
Pour commencer, recherchez Muse Spark Open dans SageMaker JumpStart dans SageMaker Studio. Pour plus d’options de déploiement, telles que les composants d’inférence et les configurations de déploiement optimisées, reportez-vous à JumpStart foundation model usage dans l’Amazon SageMaker AI Developer Guide. Avant de déployer, consultez la Muse Model License, que SageMaker JumpStart affiche lorsque vous déployez le modèle. Pour obtenir de l’aide sur la planification d’un déploiement en production, contactez AWS.