
Points forts
- Architecture : 816B de paramètres au total, 42B actifs par token avec une fenêtre de contexte de 1M.
- Quantification : Meta a publié le modèle en BF16 et NVFP4. Les poids MXFP4 ont été publiés par AMD.
- Multimodal : perception native des images et des vidéos grâce au même Perception Encoder que Muse Glimmer, avec une prise en charge supplémentaire de l'audio.
- Parallélisme : Tensor Parallelism et Pipeline Parallelism sur Nvidia et AMD. EP, TEP, DEP et désagrégation PD sur Nvidia. Une prise en charge initiale sur TPU est également disponible.
- Décodage spéculatif : nous avons entraîné un modèle de brouillon DSpark, pris en charge à la fois sur CUDA et ROCm, qui accélère les performances du modèle, testé sur le banc SPEED.
Utilisation
Des images préconstruites sont disponibles pour les deux fournisseurs :
- Nvidia : vllm/vllm-openai:muse-spark-open
- AMD : vllm/vllm-openai-rocm:muse-spark-open
Notez que le modèle ne sera disponible que via la roue PyPI nightly après que le code (PR #61879) aura été examiné et fusionné, ce qui prend généralement environ une semaine.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
Pour utiliser ce modèle avec du texte brut :
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
Pour la perception multimodale :
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
Détails d'implémentation
Architecture du modèle
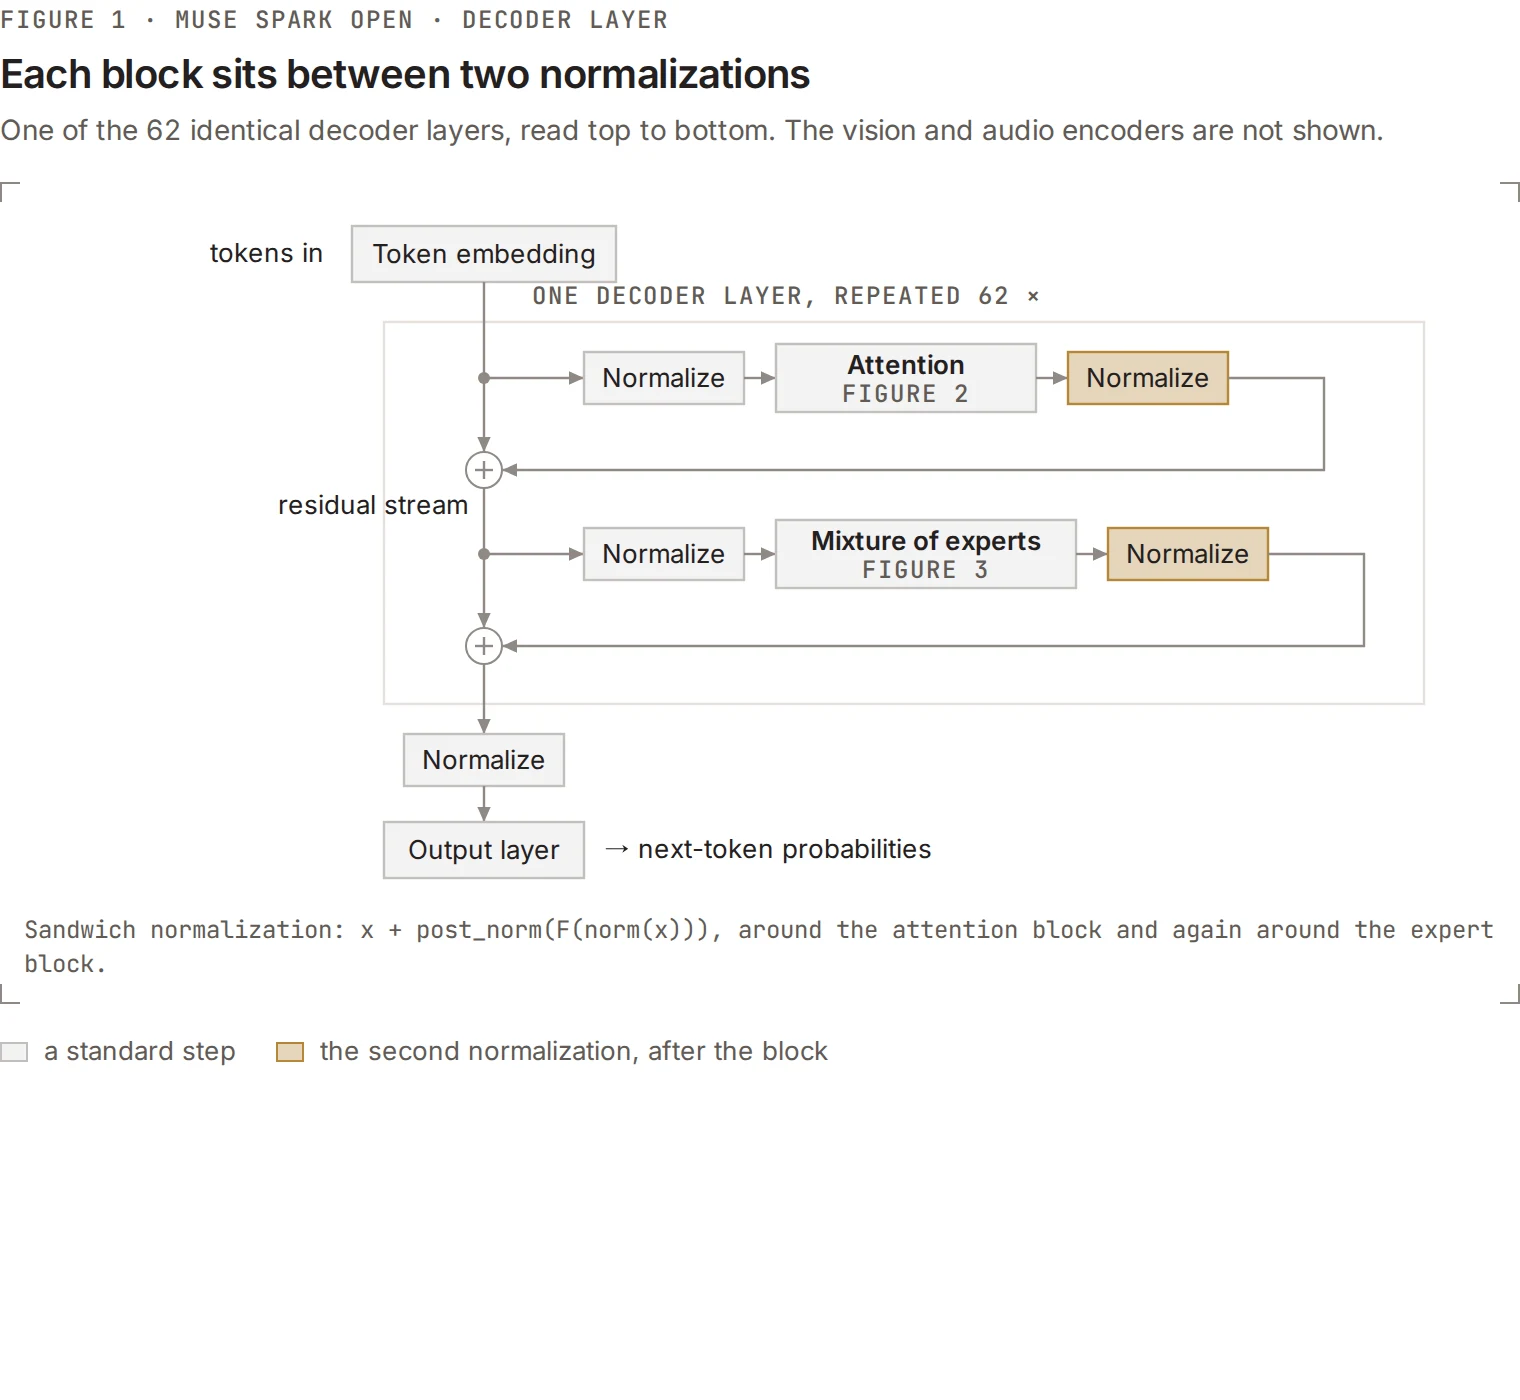
Muse Spark Open est un modèle mixture-of-experts de 816B de paramètres au total, incluant le décodeur de texte, plus un encodeur de vision de 2B et un petit encodeur audio qui l'accompagnent. Le décodeur compte 62 couches, et chacune d'elles est une couche mixture-of-experts. Voici la répartition des poids :
| partie | taille |
|---|---|
| 256 experts par couche | 799 B |
| attention | 13.5 B |
| projections latentes MoE | 4.2 B |
| couche d'embedding et couche de sortie | 3.3 B |
| tour de vision (séparée) | 1,9 Md |
L'architecture du modèle est similaire à celle de Muse Glimmer. Pour ceux qui n'ont pas utilisé Muse Glimmer, voici quelques éléments de cette architecture qui méritent un examen plus approfondi.
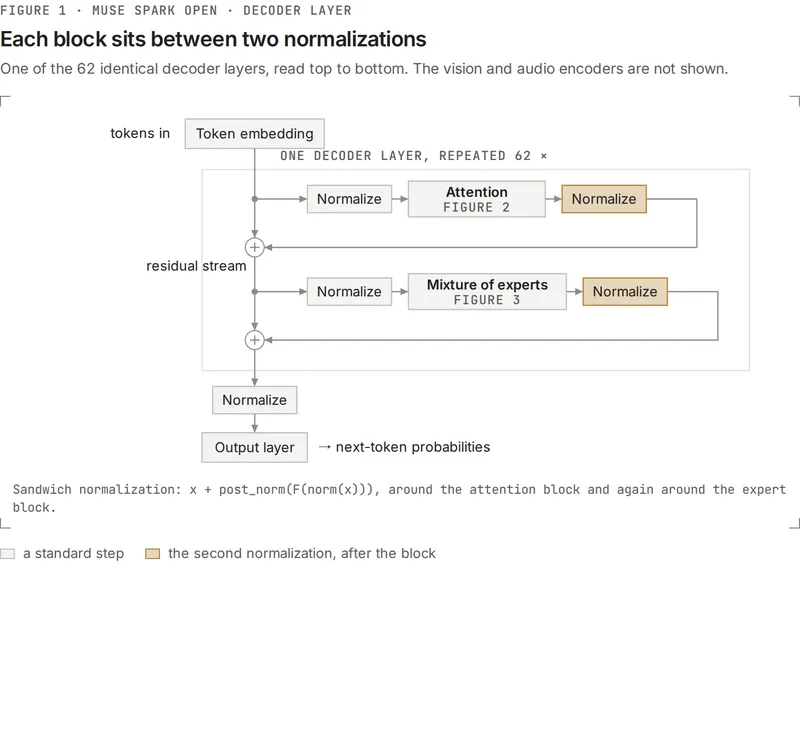
Normalisation sandwich. La plupart des décodeurs placent une couche de normalisation avant chaque bloc, donnant x + F(norm(x)). Muse Spark Open, comme Muse Glimmer, en place une avant et une après, comme les deux tranches d'un sandwich avec le bloc au milieu, donnant x + post_norm(F(norm(x)))
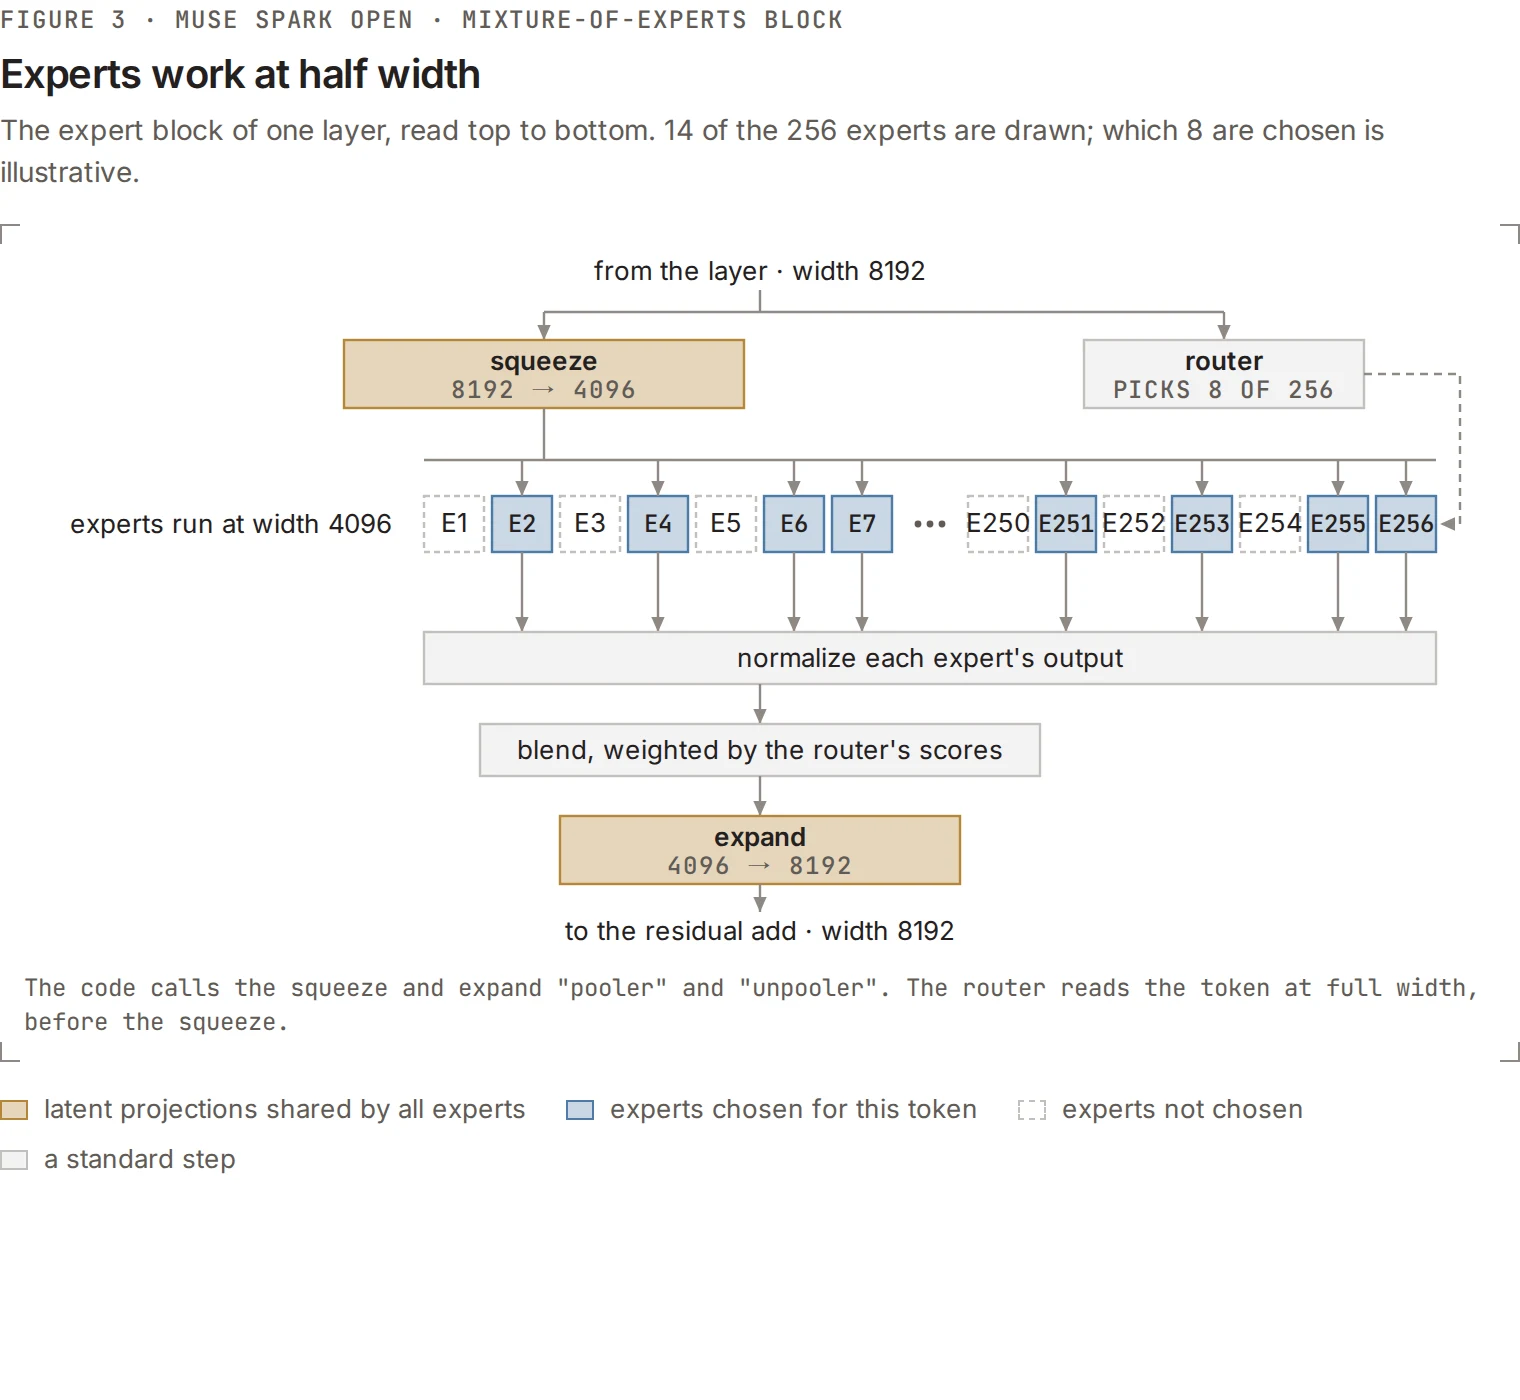
MoE latent. Chaque couche mixture-of-experts (MoE) comporte deux matrices supplémentaires, partagées par les 256 experts de cette couche. Le code les appelle le pooler et l'unpooler, bien qu'aucun des deux ne fasse de pooling au sens habituel : ce sont plutôt deux projections apprises pour compresser et étendre les dimensions. Le pooler est une matrice 8192 × 4096 qui divise par deux la largeur de chaque token avant qu'il n'atteigne les experts ; tandis que l'unpooler restaure la largeur complète ensuite. Les experts travaillent donc entièrement à 4096 plutôt qu'à 8192, ce qui a efficacement réduit de moitié le nombre de paramètres requis dans les deux couches de projection des experts.
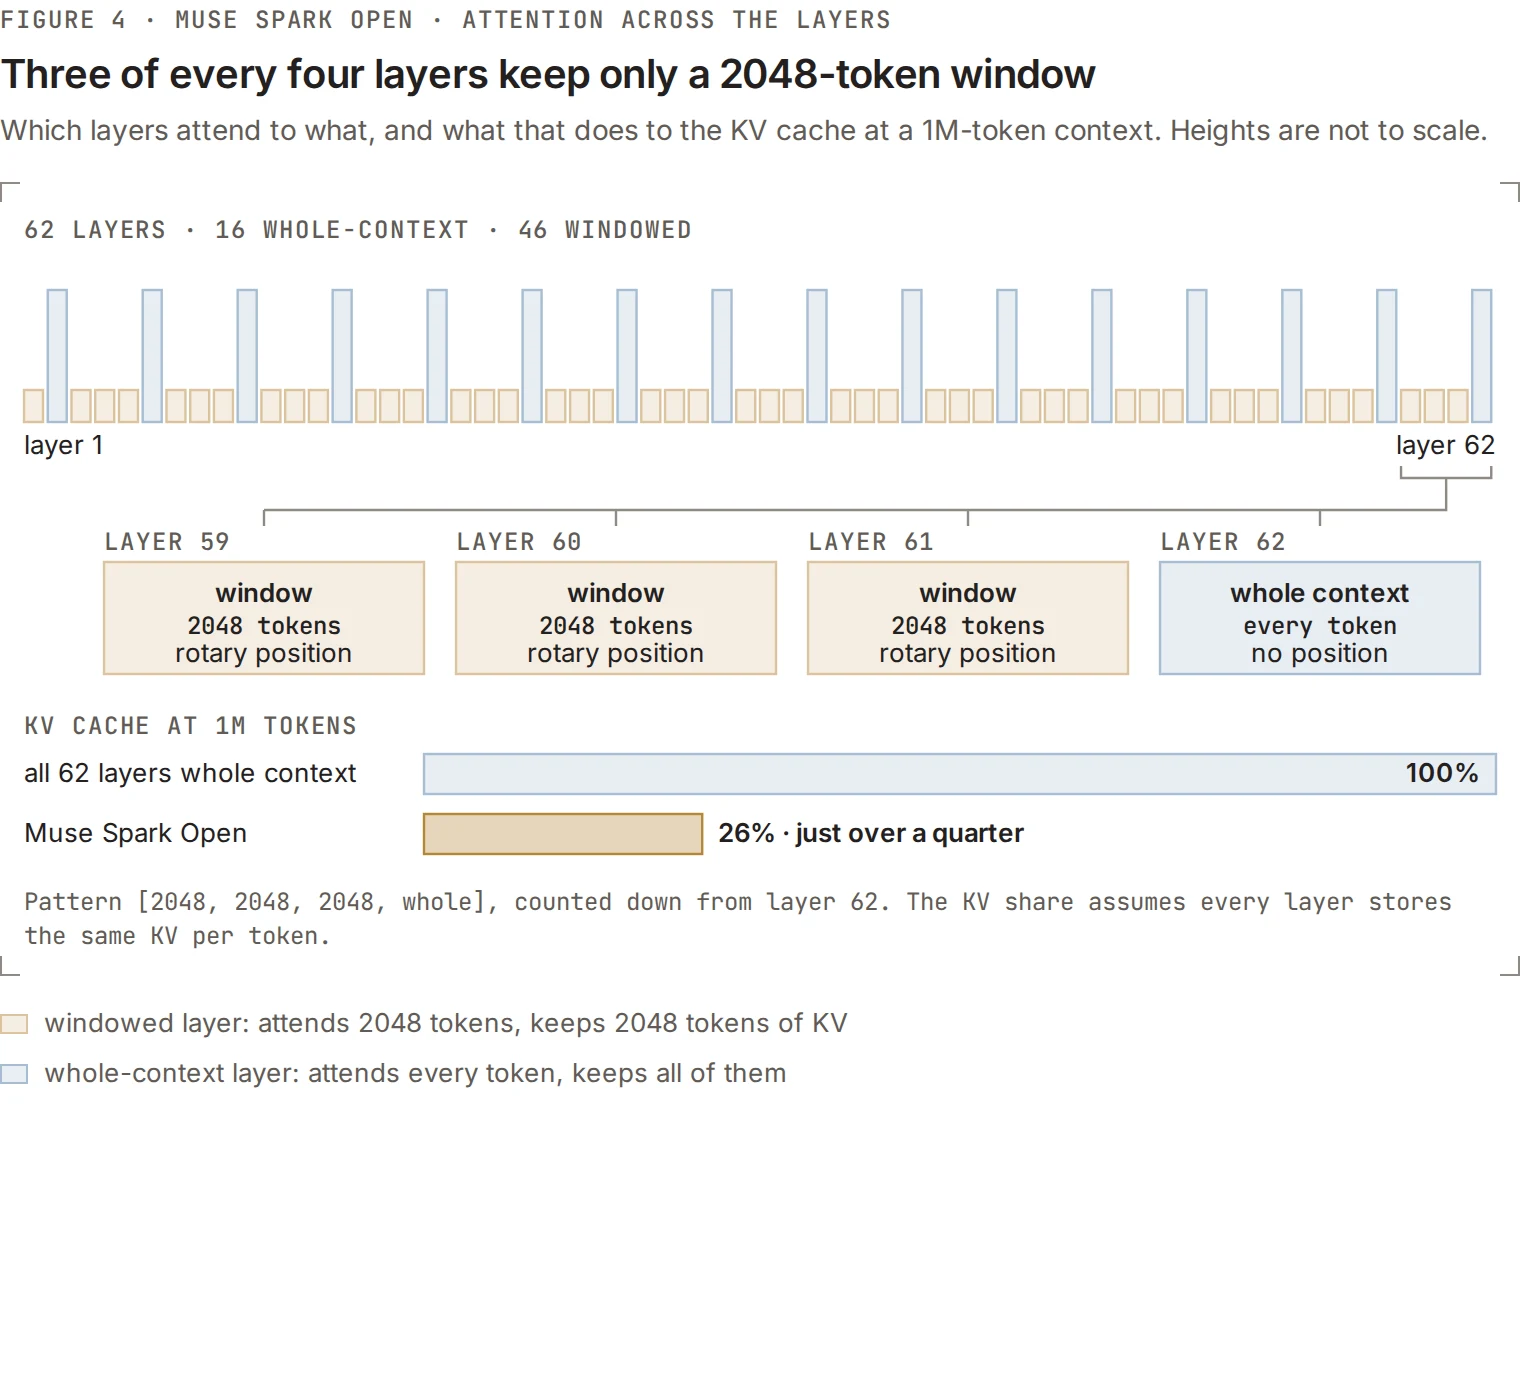
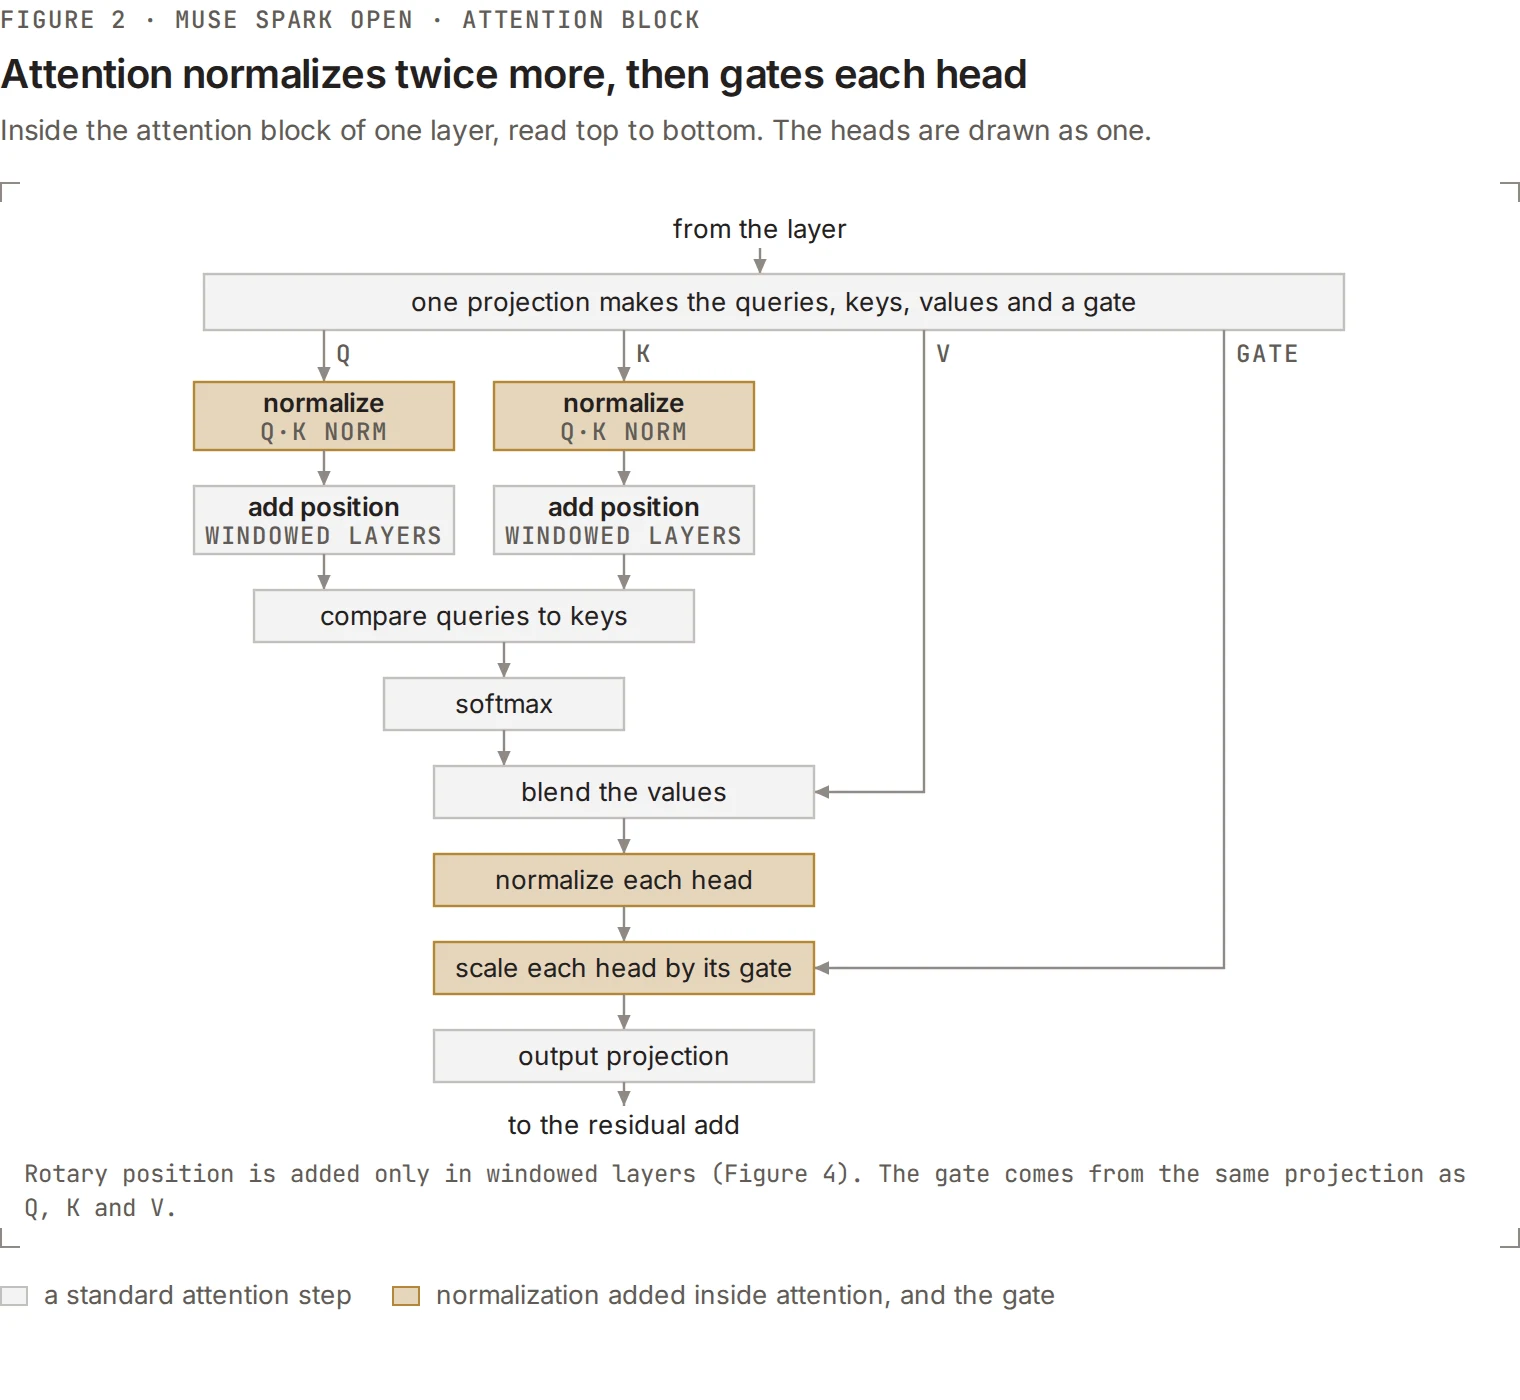
Attention hybride. Les couches alternent entre attention complète et Sliding Window Attention (SWA) selon un cycle répétitif de 4, avec trois couches assistant à une fenêtre de 2048 tokens et la quatrième regardant l'ensemble du contexte. Le cycle est ancré à la fin de la pile, de sorte que la dernière couche est toujours une couche d'attention complète. Sur 62 couches, cela donne 46 couches étroites et 16 larges, où les couches étroites ne conservent que les KV récents. À 1M de tokens, cela ramène le cache à un peu plus de ¼ de ce que nécessiterait une attention entièrement complète. C'est ce qui rend un contexte de 1M abordable.
Encodeur de vision. Muse Spark Open utilise le même Perception Encoder que Muse Glimmer, une tour de 2B de paramètres qui lit les images à leur résolution native, plutôt que de les redimensionner en carré. Les vidéos passent par le même encodeur : les images sont échantillonnées au chargement sous forme d'une série d'images vidéo échantillonnées avec un horodatage tokenisé dans le prompt.
Encodeur audio. L'audio est lu sous forme d'onde brute à 24 kHz et tous les 1920 échantillons, soit 80ms, deviennent un token à travers une série de transformations. L'ensemble de l'encodeur audio ne compte que 118M de paramètres. Notez que la piste audio de la vidéo n'est pas traitée. Pour donner au modèle à la fois les images et le son d'un clip, envoyez la vidéo et l'audio extrait comme deux parties de contenu distinctes dans la même requête.
DSpark
Pour accélérer l'inférence de Muse Spark Open sur vLLM, nous avons entraîné un speculateur en utilisant DSpark, un algorithme de décodage spéculatif qui utilise la diffusion par blocs pour proposer jusqu'à sept draft tokens en un seul passage. L'ordonnancement basé sur la confiance aide à maintenir des accélérations significatives même à de grandes tailles de batch, où le décodage spéculatif offre traditionnellement des rendements décroissants, comme le montrent les résultats ci-dessous.
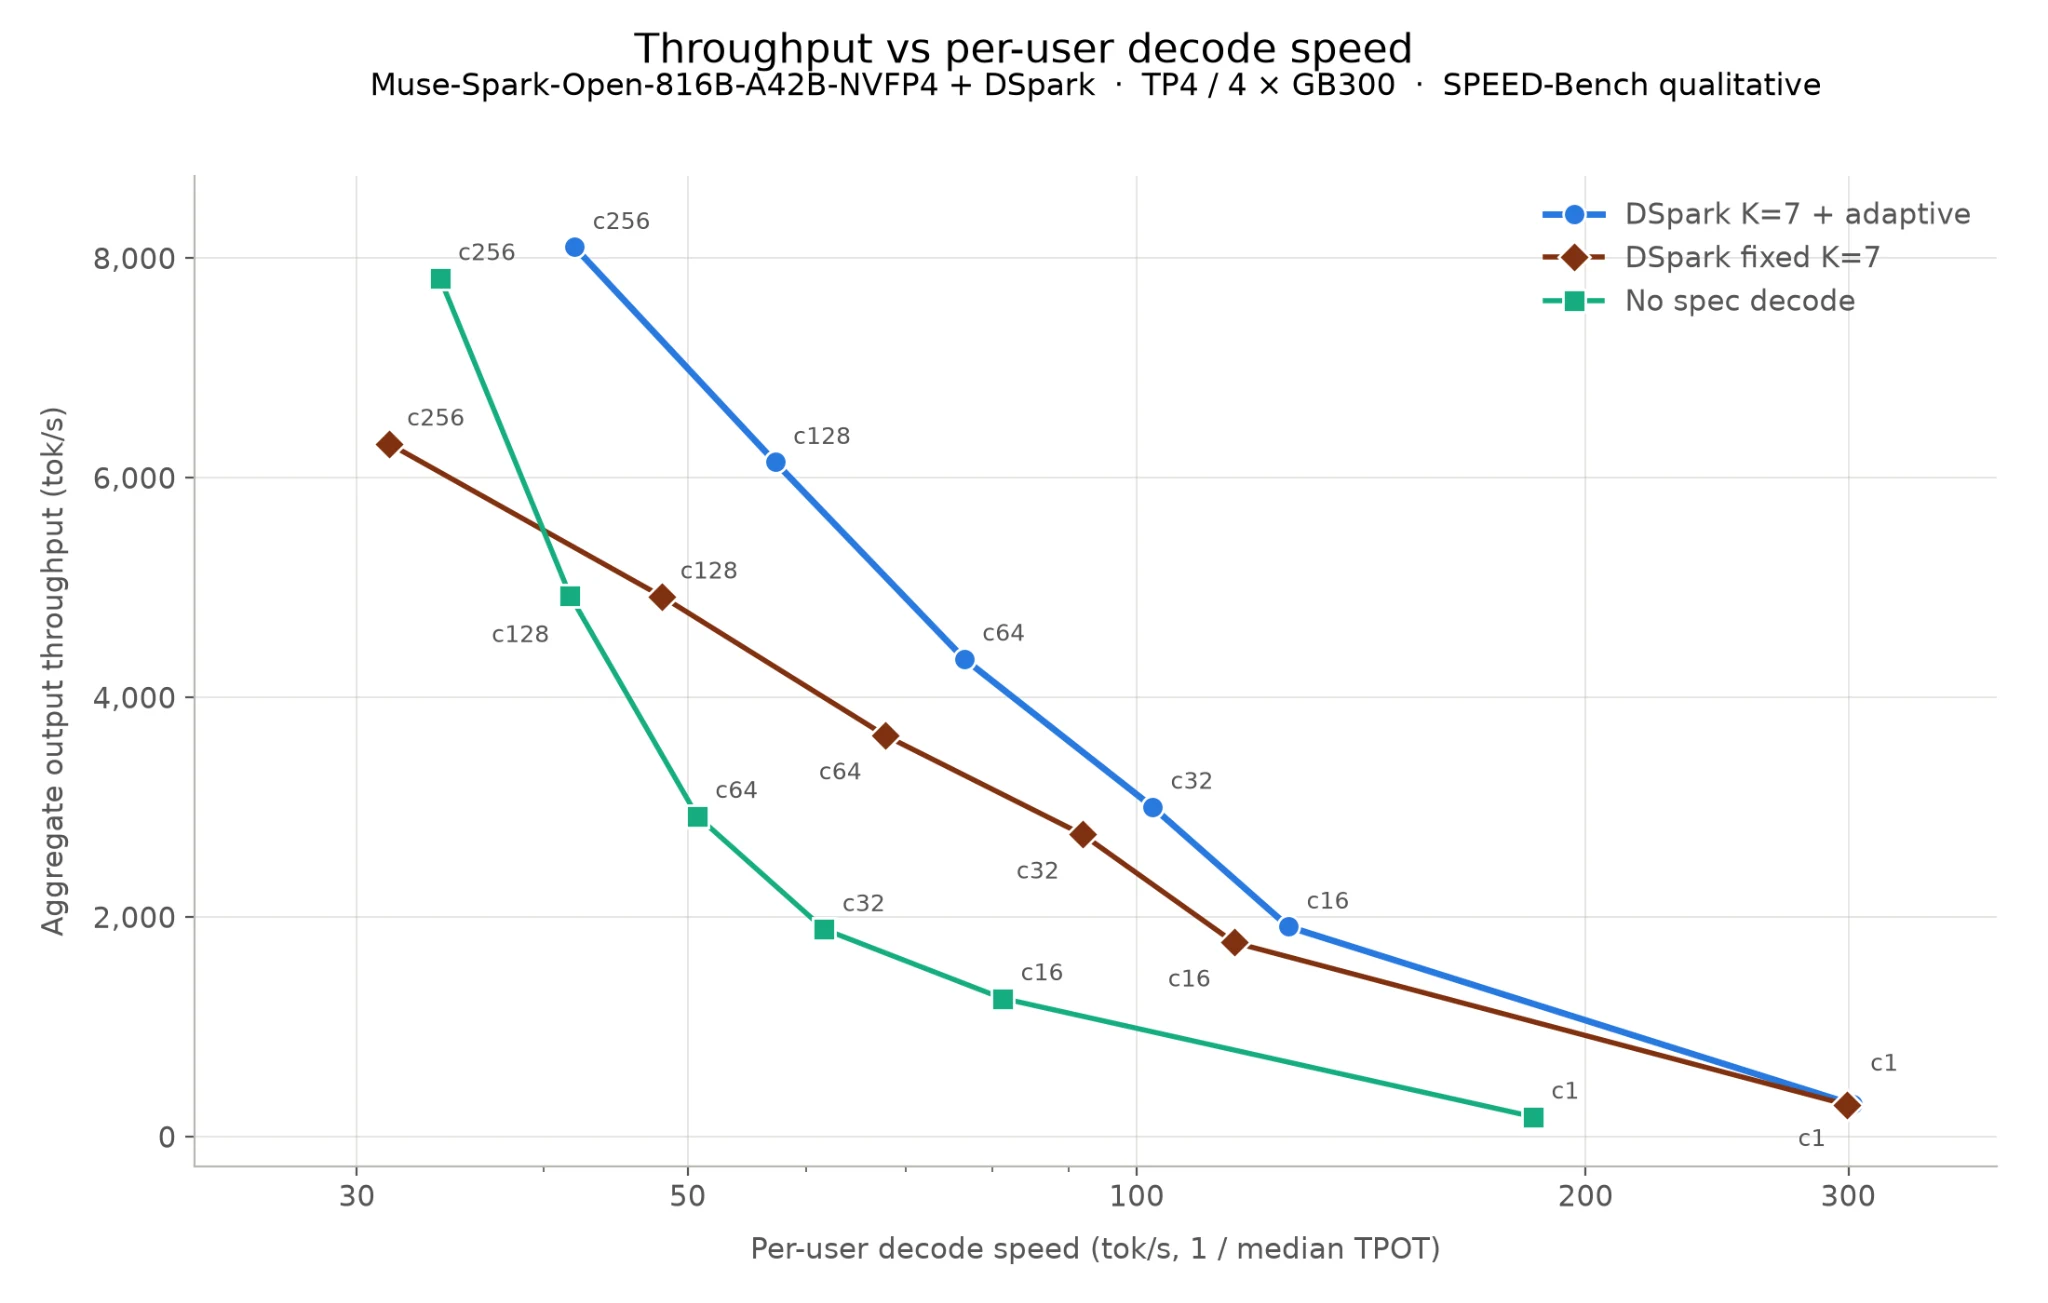
Notre speculateur utilise également l'attention à fenêtre glissante de Muse Spark Open pour maintenir le drafting léger, même avec un contexte de 1M de tokens. Ensemble, ces choix le rendent bien adapté aux charges de travail en production couvrant un large éventail de tailles de batch et de longueurs de contexte.
Pour l'activer, ajoutez ceci au démarrage du serveur :
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
L'équipe Nvidia a amélioré l'inférence de Muse Spark Open sur FlashInfer et vLLM grâce à des kernels fusionnés de normalisation, de gating et de résidu ; une finalisation MoE fusionnée avec la communication tensor-parallel et RMSNorm ; une nouvelle implémentation GEMM BF16 à faible latence et une réduction de la surcharge de compilation ; le sharding TEP du pooler/unpooler avec des collectives MNNVL fusionnées ; un GEMM de routeur TF32 alimenté par la sortie FP32 de la norme ; et des améliorations du déplacement des données, du support matériel et de la fiabilité du runtime.
AMD
Grâce à l'équipe AMD, nous prenons également en charge le modèle sur les GPU AMD Instinct™ MI355X, aux formats quantisés FP8 et MXFP4, offrant de meilleures performances d'inférence et une meilleure efficacité de déploiement. Notez que ROCm prend actuellement en charge à la fois le Tensor-Parallel et le Pipeline-Parallelism.
TPU
Nous avons ajouté la prise en charge de Muse Spark Open sur TPU au-dessus de TorchTPU. Veuillez nous contacter ou contacter Google pour l'accès au code. Nous avons également construit des megakernels pour Muse Spark Open. Avec le décodage spéculatif DSpark (longueur d'acceptation = 6), ils atteignent plus de 650 tokens/sec sur 4 puces TPU v7 et plus de 960 tokens/sec sur 8 puces. Sans décodage spéculatif, ils délivrent toujours respectivement plus de 270 et 350 tokens/sec.
Apprentissage par renforcement dans vLLM
vLLM prend également en charge LoRA RL sur Muse Spark Open dès le jour 0, servant de moteur de rollout avec Verl FSDP2 comme trainer. vLLM sert le checkpoint NVFP4 original avec l'adaptateur LoRA appliqué par-dessus. Le trainer tourne sur une déquantisation BF16 des mêmes poids et ne met à jour que l'adaptateur (rang 32, alpha 64), qui couvre l'attention, les projections latentes MoE et tous les experts routés. Il rejoue également le routage MoE du rollout (R3), et seul l'adaptateur est synchronisé avec vLLM après chaque étape.
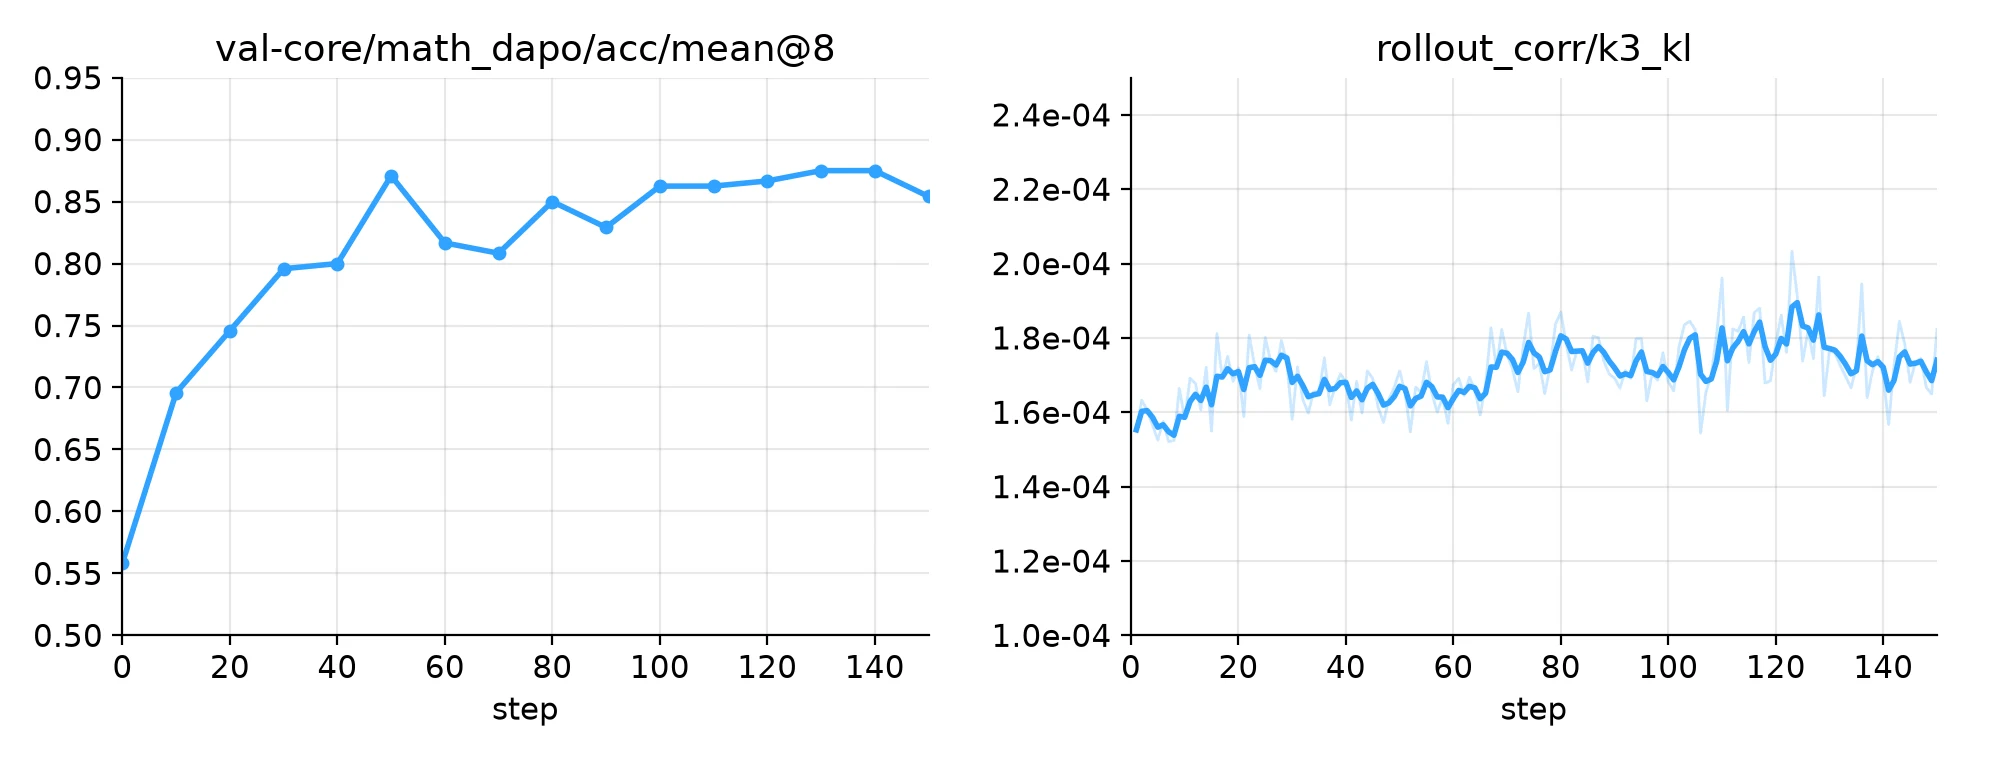
Nous avons entraîné avec GRPO sur DAPO-Math-17K pendant 150 étapes sur 16 GPU GB300, en échantillonnant 8 réponses pour chacun des 32 prompts par étape, avec jusqu'à 4K tokens par réponse. La précision sur AIME-2024 (mean@8) est passée de 0.56 avant l'entraînement à 0.85 à la fin de l'exécution. Tout au long de l'exécution, la k3 KL entre les log-probabilités du trainer et celles de vLLM est restée proche de 2×10⁻⁴. Plus de détails sont disponibles dans https://github.com/verl-project/verl/pull/8257. Dans l'écosystème vLLM, Titan RL utilise également vLLM comme moteur de rollout pour fournir un support RL dès le jour 0.
Remerciements
Nous exprimons notre sincère gratitude aux équipes de Meta Superintelligence Labs et à la communauté vLLM pour leur collaboration étroite dans la mise en place du support Day 0 pour Muse Spark Open sur vLLM. Nous remercions également Inferact pour l'entraînement du spéculateur DSpark et l'intégration TPU, ainsi que NVIDIA et AMD pour leurs optimisations matérielles essentielles.
Contributeurs :
- Inferact : Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta : Beto de Paola, Sidhartha Reddy Potu
- Nvidia : Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD : Andy Luo, Hongxia Yang, Haichen Zhang