
Think tank QbitAI
Compte public AI123All
Au cours de l'année écoulée, il n'y a guère d'entreprise qui n'ait crié « adoption totale de l'IA ».
Les chatbots ont été déployés, les Agents ont été utilisés, et les chiffres du type « amélioration de l'efficacité de XX % » dans les rapports internes sont de plus en plus flatteurs.
Mais si l'on pose aux responsables métier une question toute simple : les ruptures de stock ont-elles diminué ? Les livraisons sont-elles plus rapides ? La satisfaction des clients a-t-elle augmenté ? La réponse reste souvent bien incertaine.
En réalité, la transformation intelligente de la grande majorité des entreprises se heurte collectivement à une « prospérité factice ». Nous avons pris l'habitude de considérer l'IA comme un outil d'efficacité personnelle, en négligeant une vérité brutale :
l'efficacité dans les tâches individuelles n'équivaut pas à la concrétisation de la valeur opérationnelle de l'entreprise.
Si l'IA ne parvient pas à établir véritablement la boucle complète reliantles données, le jugement, l'action et le contrôle des systèmesl'intelligence des entreprises restera à jamais bloquée au dernier kilomètre du déploiement à grande échelle.
Comment débloquer la situation dans la seconde moitié de l'IA d'entreprise ? Comment les Agents peuvent-ils réellement pénétrer les capillaires du métier et réaliser une refonte systémique tournée vers l'avenir ?
Récemment, le think tank QbitAI a officiellement publié le rapport« L'intelligence d'entreprise pilotée par les Agents : de l'efficacité ponctuelle à la refonte à grande échelle ». Dans ce rapport, nous tentons de dissiper les brouillards du déploiement des grands modèles et de trouver une nouvelle solution pour la planification de l'intelligence des entreprises.
L'IA est utilisée, mais où ça bloque-t-il ?
Les points de blocage fréquents du déploiement de l'IA en entreprise peuvent être illustrés par un seul scénario :le traitement du risque de rupture de stock en magasin。
Un même assistant d'analyse opérationnelle : l'équipe technique considère que la génération du rapport équivaut à une tâche accomplie, les personnels métier estiment que ce n'est réglé que lorsque la cause a été identifiée, et les dirigeants se soucient de savoir si les ruptures de stock ont réellement diminué — les critères d'achèvement des trois parties ne correspondent tout simplement pas.
Un décalage similaire existe au niveau des données : les comptes affichent un stock, mais après déduction des quantités déjà allouées et gelées, la quantité réellement mobilisable diffère sensiblement du chiffre présent dans le système. Lorsque l'IA fonde son jugement sur les chiffres comptables, elle part d'une base faussée.
Même avec des données exactes et une analyse correcte, entre la recommandation et l'exécution s'intercalent encore toute une chaîne : remplissage manuel des formulaires, soumission à validation, suivi de la livraison. L'entrée d'une recommandation dans le système ne signifie pas que l'affaire est réglée, et la possibilité ou non de retransmettre le statut d'achèvement à l'IA détermine si la boucle de la tâche peut réellement se refermer.
Sans parler du fait que chaque opération soulève des questions dequi a le droit d'initier, qui valide, et qui prend le relais en cas de problème, autant de questions de responsabilités et d'autorisations.
Ces points de rupture ont été regroupés en six catégories :la définition des tâches, la fiabilité des données, la vérifiabilité des jugements, la concrétisation des actions, la répartition des droits et responsabilités, ainsi que la mesure et la réplication de la valeur。
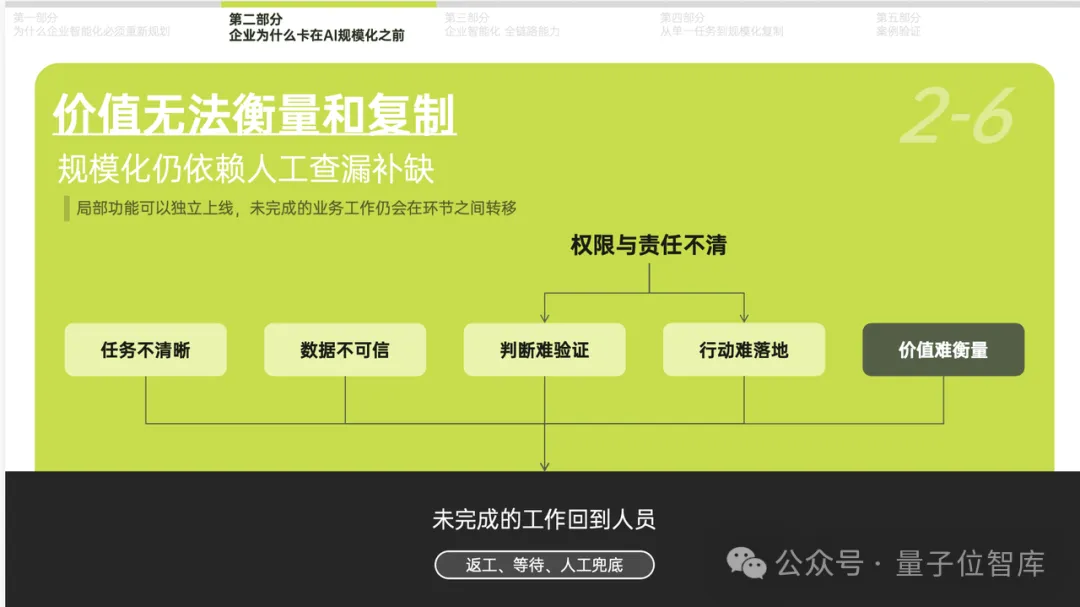
. Chacun, pris isolément, n'est pas fatal, mais mis bout à bout, ils expliquent pourquoi les projets d'IA de beaucoup d'entreprises restent bloqués dans un état « utilisable localement, mais impossible à généraliser ».
Ce travail inachevé finit par retomber entre les mains des humains, se transformant en longues reprises, attentes et dépannages.
Alors, comment les entreprises peuvent-elles systématiquement éliminer ces angles morts ?
Un cadre complet de bout en bout centré sur les résultats métier
Puisque les petites retouches locales ne peuvent pas résoudre le problème de fond, comment les entreprises peuvent-elles reconstituer une solution intelligible véritablement efficace ?
Dans son rapport, le think tank QbitAI affirme qu'un Agent d'entreprise mature n'est absolument pas un simple outil de questions-réponses isolé, mais qu'il doit nécessairement posséderune « capacité de chaîne complète » reliant les tâches, le contexte, le jugement, l'action, le contrôle et la mesure。
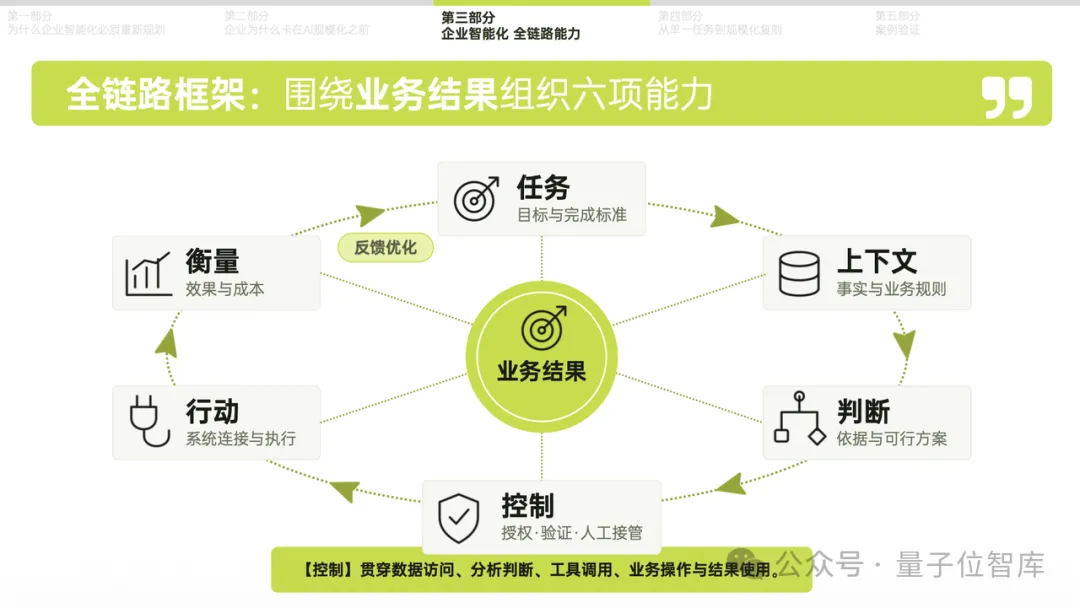
Parmi ces éléments, le point de départ de toute décision intelligente consiste à briser les silos de données et à établirun environnement contextuel réellement fiable。
Bien souvent, si l'IA semble « pas assez intelligente » dans l'analyse métier, la raison profonde réside dans le décalage entre les données sous-jacentes et la sémantique métier : définitions de champs confuses, référentiels de versions incohérents — l'IA ne peut naturellement pas fournir de conclusions fiables.
Pour qu'un Agent devienne véritablement un « conseiller » qui comprend le métier, il faut d'abord faire évoluer les données d'un simple « consultable » vers un « fiable » sur toute la chaîne.
À cet égard, certaines pratiques technologiques de pointe offrent à l'industrie un excellent modèle. Par exemple, la marque d'intelligence des données du groupe NetEase Zhixiang,Shufan, grâce à sa plateforme intégrée de développement et de gouvernanceEasyData, fusionne en profondeur le développement des données, la qualité, la sécurité et la gouvernance métier, fournissant ainsi aux Agents de manière stable une sémantique d'actifs de haute qualité et traçable.
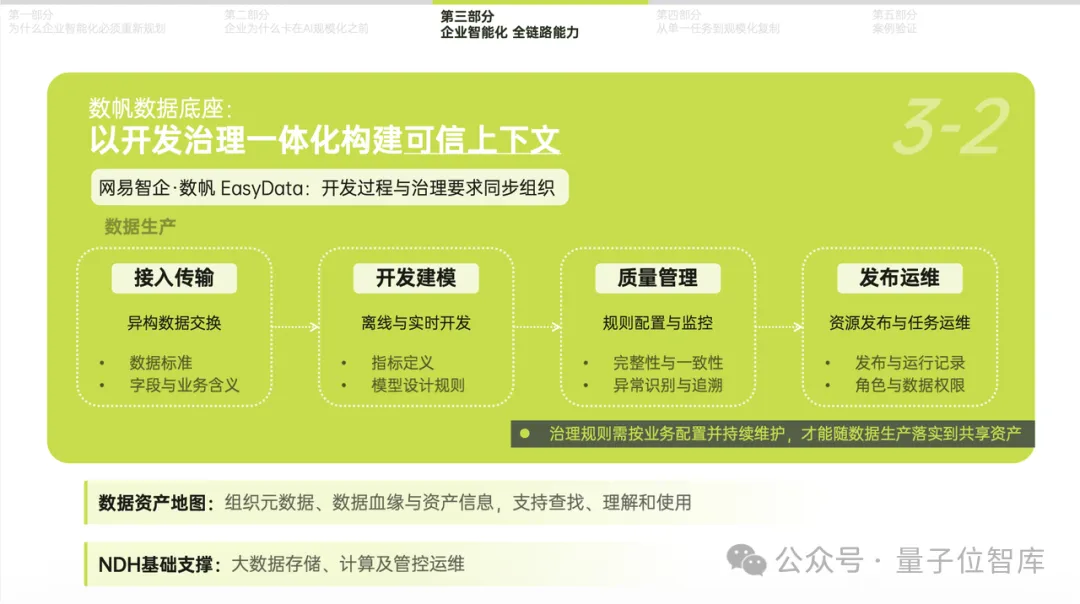
Sur cette base, en s'appuyant sur NetEase Zhixiang ·Zhishu DataAgent, les entreprises peuvent relier sans couture les indicateurs dispersés, les bases de connaissances et les requêtes en langage naturel, permettant ainsi à l'IA de comprendre réellement le langage du métier.
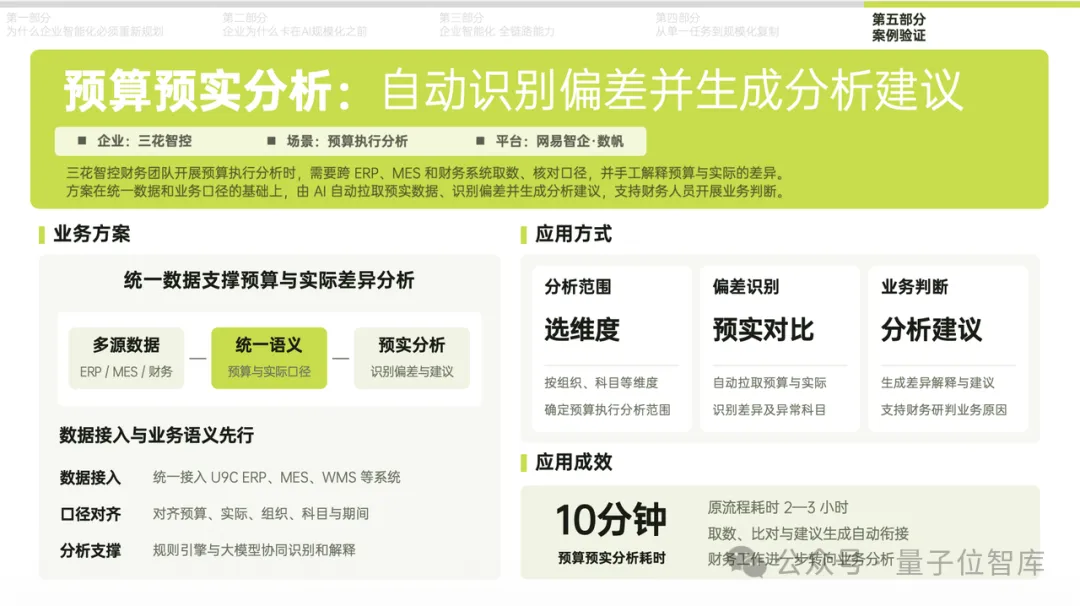
Dans la mise en œuvre concrète, cette connexion de bout en bout libère le potentiel métier. Prenons l'exemple deSanhua Intelligent Controls: grâce à l'unification, par Shufan, des données et des référentiels sémantiques au niveau infrastruture, l'IA peut extraire automatiquement les données prévisionnelles et réelles, identifier les écarts, et comprimer considérablement une analyse budgétaire qui prenait auparavant2-3 heuresà seulement10 minutes, permettant ainsi aux équipes financières de passer du traitement fastidieux des rapports à une analyse métier approfondie.
Mais lorsque l'intelligence artificielle passe de l'analyse et de la prise de décision à quelque chose de plus profond : lalivraison d'applications et d'ingénierie logicielle, de nouveaux défis apparaissent : comment éviter que le Coding Agent ne dévoie les exigences lors du développement d'applications, et comment réduire le temps perdu à la jointure entre le front-end et le back-end ?
Un changement digne d'attention est que les entreprises tentent de ramener le développement par IA d'une « génération libre » vers un processus d'ingénierie plus contrôlable.
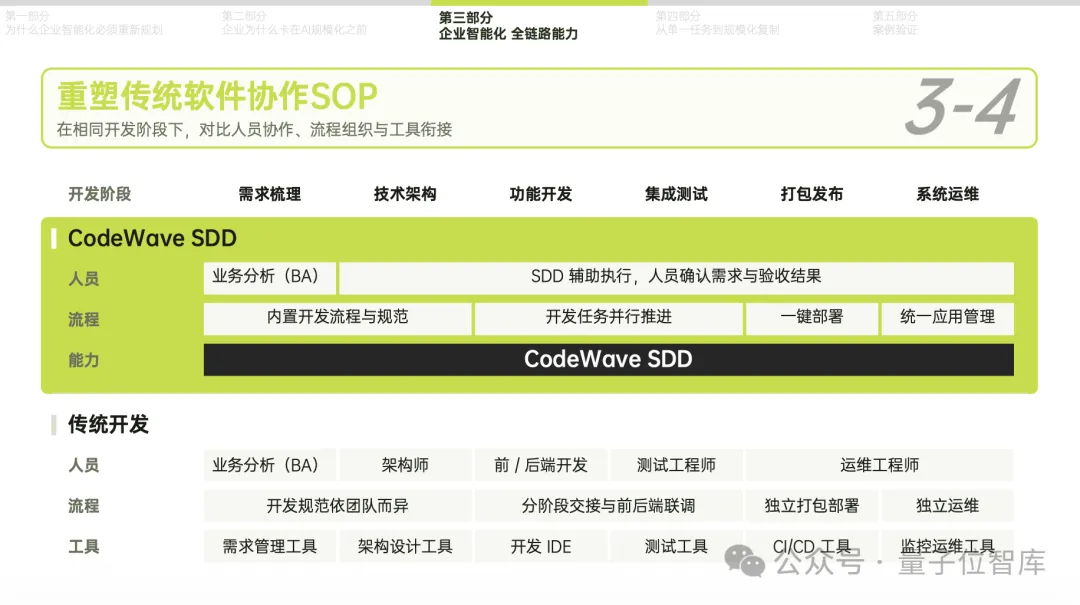
Prenons l'exemple deNetEase Zhiliang · CodeWave et de son SDD (développement piloté par spécifications, Spec-Driven Development) : l'idée centrale n'est pas de laisser l'IA « écrire directement », mais de décomposer la livraison en plusieurs niveaux — exigences, architecture, développement, tests, publication, livraison — avec une transmission échelonnée de niveau en niveau :
les besoins métier sont d'abord convertis en spécifications structurées, puis traduits en conception technique et en décomposition de tâches, et ce n'est qu'à la fin que la génération de code intervient.
Chaque étape dispose d'entrées et de sorties claires ainsi que de points de contrôle de validation, de sorte que l'ensemble du processus — clarification des besoins, développement, tests jusqu'à la publication — reste contrôlable et traçable.
Cette « transmission échelonnée » répond précisément aux trois points de rupture des solutions SDD courantes sur le marché : des spécifications rédigées de façon non standard, sans mécanisme de clarification, ce qui n'impose au grand modèle qu'une contrainte souple ; des besoins qui, dès qu'ils deviennent complexes, saturent la fenêtre de contexte, provoquant oublis et hallucinations ; et une couverture limitée à la seule phase de recherche et développement, laissant les exigences et la livraison sans prise en charge.
CodeWave SDD comble ces lacunes une à une : standardisation du format des exigences avec EARS et clarification explicite des ambiguïtés, découpage modulaire et sous-tâches à granularité fine pour isoler le contexte et fragmenter les problèmes, puis enchaînement des exigences, de la conception, du codage, des tests et de la publication en une chaîne de bout en bout collaborant entre plusieurs rôles.
Cette approche commence déjà à démontrer sa valeur en efficacité dans des projets réels. Par exemple,Kongge Digital Technologya réduit le cycle de développement de son CRM énergies nouvelles de 60 jours-homme à 16 jours-homme ;Shanghai Qitong Digital Technology, dans le développement de son système BIMS, a obtenu un gain d'efficacité d'environ 2,5 fois, avec un taux de disponibilité fonctionnelle dès la première utilisation de 78,63 %.
Réaliser une démo est facile, la reproduire 100 fois est la vraie compétence
Le cadre existe, la question suivante est comment démarrer.
La pratique de beaucoup d'entreprises est de déployer des projets pilotes et d'avancer sur plusieurs fronts ; la recommandation du Think Tank QbitAI est :choisir d'abord un scénario à forte valeur, réussir la boucle complète, puis envisager l'extension.
Le choix du scénario repose sur cinq critères de sélection :
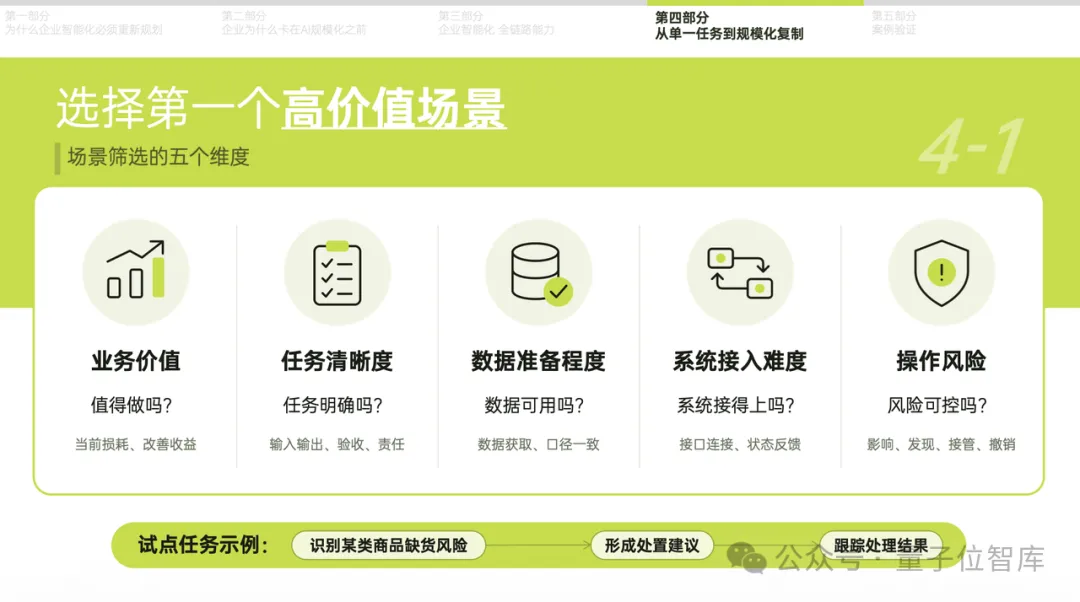
Cela semble relever du bon sens, mais en pratique beaucoup d'équipes font l'inverse — elles commencent par ce qui est techniquement le plus facile, et découvrent après coup que la valeur métier est faible, si bien que la motivation de généraliser disparaît.
Une fois le scénario choisi, les travaux de la phase pilote sont plus minutieux qu'on ne l'imagine.
Quelles étapes du processus existant peuvent être confiées au système, lesquelles nécessitent encore une revue humaine, comment gérer les cas anormaux — tout cela doit être repensé, et non simplement superposé.
Un piège facile à éviter : conserver l'intégralité de l'ancien processus tout en ajoutant en plus un contrôle des résultats de l'IA, ce qui a pour effet d'augmenter au total l'investissement.
Après la phase pilote, les entreprises font souvent face à trois choix :
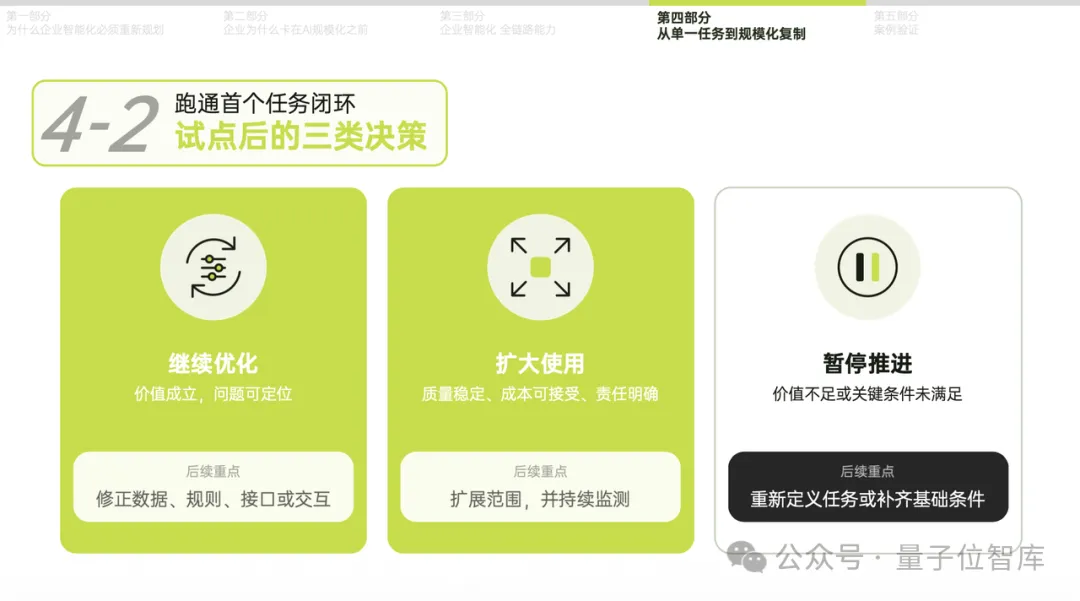
Mais ce qui détermine réellement si l'entreprise peut passer de « 1 » à « 100 » vient ensuite —transformer l'expérience accumulée lors du premier succès en actifs d'intelligence réutilisables à volonté.
Par exemple, des indicateurs déjà validés, des composants d'interface, des règles d'approbation, des échantillons de cas anormaux — inutile de tout refaire à chaque changement de scénario. Les nouvelles tâches peuvent directement réutiliser ces capacités communes, en n'apportant que les ajustements nécessaires au métier concerné.
Ainsi, l'essence de la reproduction à grande échelle, c'est de permettre au 2e, au 10e et au 100e chantier de s'appuyer sur la précédente réalisation pour continuer à avancer.
Obtenir gratuitement le rapport complet
À l'étape où en est aujourd'hui l'intelligence d'entreprise, ce qui creuse les écarts, c'est en réalité la capacité de l'entreprise à connecter les capacités des modèles à son activité, à son organisation et à ses processus, pour les transformer enfin en résultats d'exploitation visibles.
Une bonne planification de l'intelligence artificielle ne part jamais des outils, mais exige de «remonter des résultats métier vers l'amont» ; et pour un Agent tourné vers l'avenir, l'essentiel consiste à faire en sorte que «l'humain fixe les limites, l'IA progresse”。
». Ce rapport offre précisément unedémarche complète, allant du diagnostic des problèmes à la construction d'un cadre jusqu'à la validation concrète sur le terrain。
. Que vous soyez un responsable métier menant actuellement un projet pilote d'IA, une équipe technique à qui l'on demande de « gagner en efficacité grâce à l'IA » sans savoir comment mesurer les résultats, ou encore un manager devant coordonner les responsabilités de plusieurs parties lors de la phase de passage à l'échelle, vous y trouverez très probablement des repères correspondant à votre étape actuelle.
De nombreux détails, comme la définition des critères d'achèvement des tâches, la conception de méthodes de mesure avant/après, ou encore la transformation des résultats du projet pilote en actifs réutilisables... ne sont pas détaillés un à un dans l'article, mais ce sont peut-être précisément les points sur lesquels vous êtes bloqué en ce moment.
Le rapport complet est disponible via le lien ci-dessousen téléchargement gratuit:
https://jkhbjkhb.feishu.cn/wiki/W5D7wuDcbiPXDLkaRLQcAJpOn8f