
Luyu, depuis Aofeisi
Quantum Bit | Compte officiel QbitAI
OMG ! C'est encore le Double 11 annuel...
Ceux qui bossent dans l'e-commerce, are you ok ? Mon ami ne tient plus, il me bombarde de messages tous les jours :
Y a-t-il unoutil AI de travail efficacequelqu'un a une recommandation ? Vite vite vite, idéalement un qui fait bien le travail et qui tient longtemps.
Et figure-toi que j'ai déniché une pépite récemment.
Le nouveau modèle open source de Ant Bailing,Ling-3.1-flash, s'occupe de tout ce qui concerne mes rapports hebdomadaires et mes synthèses de sujets.
u1s1 (franchement), j'ai aussi utilisé Claude Code, Codex et d'autres, mais au final ce sont les modèles nationaux qui me plaisent davantage.
SurtoutBailing, qui reste discret en temps normal, ne mise ni sur les paramètres ni sur les classements, mais quand il s'agit de vraiment travailler, il est terriblement fiable.
Selon la version officielle, ce modèle se concentre sur une seule chose :finir le travail dans les flux de travail réels.
Prenons le rapport e-commerce du début : une phrase du patron comme« résume la situation de cette grande promotion »repose sur les épaules du salarié : chercher des informations, vérifier les données, suivre les avancements, puis faire un Excel et un PPT de compte-rendu...
Derrière une même tâche, il faut souvent la coopération de multiples étapes, et plus embêtant encore, les données sont dispersées dans différents fichiers et différents outils.
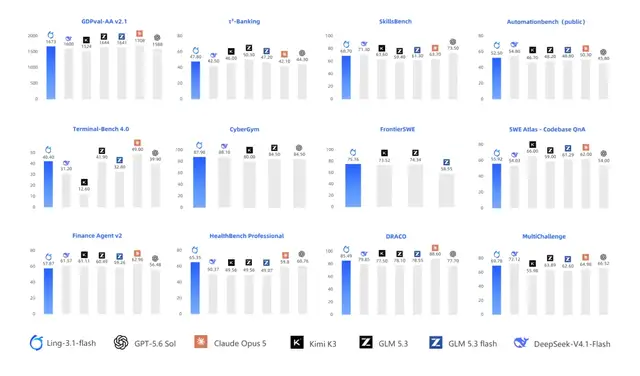
Image provenant du compte officiel Weibo de Bailing
Ling-3.1-flash est un modèle professionnel àhaut ratio intelligence-efficacitéissu de ce type de besoins réels.
En clair, ce qu'il veut prouver, c'est que répondre avec élégance n'est que secondaire ; l'essentiel, c'est de pouvoir livrer la tâche.
Conçu pour les tâches du monde réel
Pour gérer un travail aussi fastidieux que l'analyse d'une grande promotion, le modèle doit avancer de manière continue sur plusieurs processus. La conception du modèle Ling-3.1-flash peut être comprise en suivant cette chaîne de tâches.
Le premier problème que le modèle doit résoudre,Décomposer clairement les objectifs de livraison。
L'utilisateur peut ne donner qu'une seule instruction vague, alors que ce qui doit réellement être livré est un ensemble complet de supports de présentation ; le modèle doit donc trouver lui-même les documents pertinents, déterminer ce qui manque et ce qui est nécessaire, puis continuer à avancer en fonction des résultats intermédiaires.
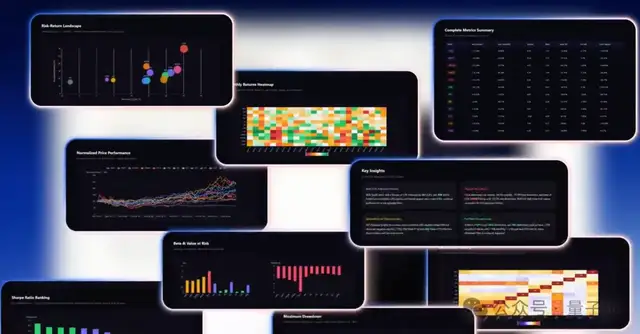
Ling-3.1-flashfonctionne précisément ainsi.
Il relie la compréhension des besoins, la décomposition des tâches, l'intégration des informations, l'appel d'outils et la vérification des résultats, et peut travailler à travers des environnements web, des documents, des tableurs et du code.
Sur le plan civil, il peut créer des fichiers Excel et des PPT ; sur le plan technique, il peut également générer et tester du code.
Et surtout ! Ces capacités ont déjà une forme concrète assez précise demise en œuvre。
Ling-3.1-flash a déjà été intégré au client Agent de collaboration de bureau interne d'Ant,« Xiaohu »où le modèle dirige les actions, tandis que l'environnement d'exécution lui permet de réellement lire des fichiers, exécuter des programmes et écrire des résultats.
C'est une approche dont il vaut la peine de s'inspirer ; bien que nous ne puissions pas encore utiliser Xiaohu, notre propreAgent bureautiquecombiné avec Ling-3.1-flash devrait, pense-t-on, donner de bons résultats.
À mesure que la tâche progresse, les documents et le contexte historique gonflent de manière significative, et les coûts de calcul augmentent en conséquence.
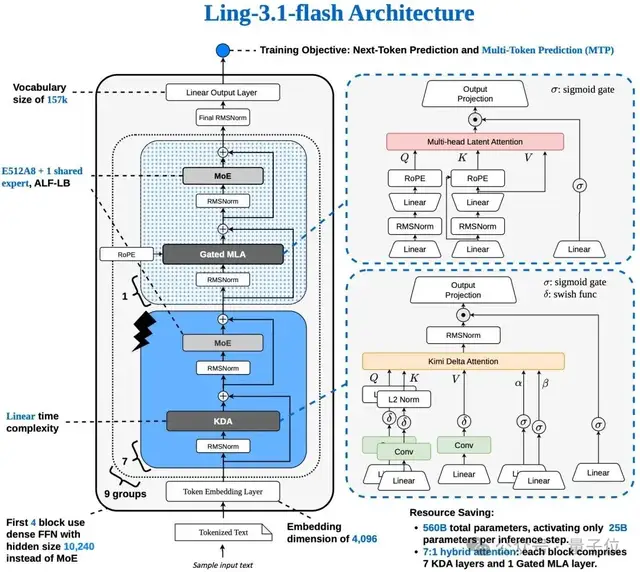
C'est alors que Ling-3.1-flasharchitecture hybridede Ling-3.1-flash joue un rôle clé.
Le modèle possède environ 560B de paramètres au total, avec environ25Bactivés par token. Tout en préservant la capacité de connaissances, Ling-3.1-flash a réduit la taille des poids réellement impliqués dans le calcul à chaque étape.
En ce qui concerne la structure d'attention, il reprend l'architecture de Ling-3.0-flash et augmente encore la proportion d'Attention linéaire.
Il adopte une architecture de 7 couches de KDA combinée à 1 couche de Gated MLA : le KDA assure le traitement des séquences avec une complexité temporelle linéaire, et 1 couche de Gated MLA est conservée toutes les 8 couches afin de maintenir un chemin d'attention global.
La limite supérieure de la fenêtre de contexte du modèle peut atteindre1M, peut accueillir en une seule fois davantage de documents, de code et de tâches historiques, réduisant le travail de découpage manuel et de transferts répétés d'informations.
Parallèlement, le modèle est configuré avec 512 experts de routage, chaque Token en sélectionne 8, et 1 expert partagé est également appelé simultanément.
Ce type deMélange linéaire avec MoE clairsemécomme approche, dans un but unique : que le modèle ne déraille pas lors d'exécutions longues, sans pour autant faire exploser la consommation de calcul.
Par ailleurs, l'équipe s'attelle activement à abaisser les barrières de déploiement ; grâce à la quantification en précision mixte, l'occupation des poids du modèle est passée d'environréduction de 534 Go à 292 Go, dans la configuration de test Hopper correspondante, les GPU nécessaires au déploiement étaient fournis parRéduction de 8 cartes à 4 cartes。
Pour répondre à des cas d'usage métier spécifiques, l'équipe propose également une solution d'inférence parallèle à long contexte (PCP/DCP), et renforceJSON Schema…的支持, permettent au modèle de traiter plus facilement les longs documents et de se connecter aux interfaces métier existantes.
Au-delà de l'architecture, pour savoir ce que valent réellement les choses, il faut encore les passer à l'épreuve de tests concrets.
ÀÉvaluation des tâches bureautiquesDans GDPVal-AA V2.1, Ling-3.1-flash obtient un score ELO de 1673, démontrant sa compétitivité dans le traitement de tâches professionnelles en plusieurs étapes.
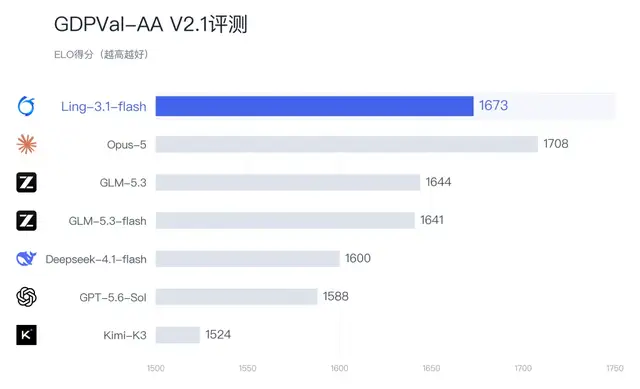
Image provenant du compte officiel Weibo de Baili
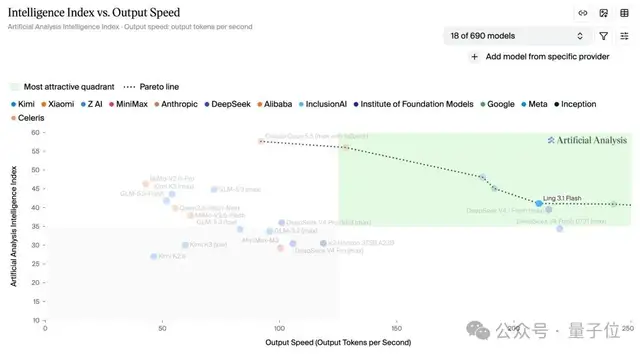
Parallèlement, selonArtificial AnalysisSelon les derniers tests publics, Ling-3.1-flash affiche un indice d'intelligence de 41, une vitesse de sortie d'environ 210 tokens par seconde et un prix d'appel hybride d'environ 0,19 dollar par million de tokens, offrant ainsi aux scénarios métiers à haute fréquence une option qui équilibre niveau d'intelligence, efficacité de génération et coût d'appel.
Scénario médicalDans l'évaluation HealthBench Professional sous la version inférieure, Ling-3.1-flash conserve également une position relativement en tête.
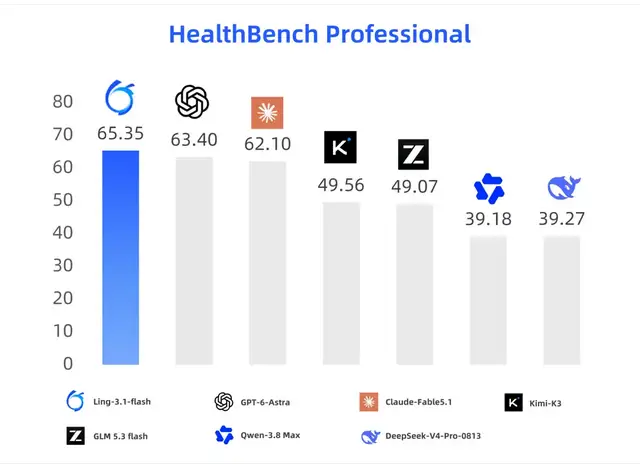
Image provenant du compte officiel Weibo de Baili
De plus, dans des scénarios tels que le développement logiciel et les opérations sur terminaux, Ling-3.1-flash possède également une certaine capacité de compréhension et d'exécution des informations.
Prenons l'exemple d'une tâche de développement de longue durée d'un compilateur natif Lua menée en interne chez Ant : l'ensemble du processus a duré environ 17 heures, pendant lesquelles le modèle a développé et corrigé à plusieurs reprises, et le taux de réussite des tests indépendants finaux est de97.8%。
C'est pourquoi, lors du choix d'un Agent bureautique, Ling-3.1-flash, complet et professionnel sans erreurs, est devenu un choix prioritaire à essayer.
Testé en conditions réelles, Ling-3.1-flash montre sa vraie valeur
Pour tester à quel point il travaille vraiment« vrai », lançons-nous dans le test pratique~
Pour ce premier exercice, commençons par unemission e-commerce du Double 11pour voir ce que ça donne.
Supposons que vous soyez le responsable e-commerce de Ling, une marque d'articles de rangement pour la maison. D'après les documents fournis, vous devez soumettre à votre patron un plan promotionnel pour le Double 11 couvrant la période du 15 octobre au 11 novembre ; ce plan sera remis directement aux équipes opérations, contenu, service client et entrepôt pour exécution ultérieure.
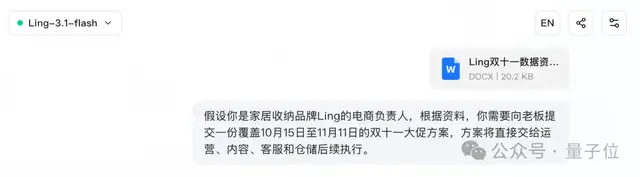
P.S. Les données associées ont été générées avec l'aide de Codex.
Une fois les objectifs commerciaux, les fiches produits, la composition de l'équipe et les données historiques des canaux fournis, le modèle se met rapidement à organiser les documents et à concevoir le plan promotionnel.
D'abord, le modèle procède à uneévaluation de la faisabilité de l'objectif initial。
il n'a pas accepté directement le chèque en blanc signé par le patron ; après avoir identifié à l'avance les contraintes telles que le rendement marginal décroissant de la publicité, les stocks et la capacité d'expédition, il a proposé une estimation relativement raisonnable de l'objectif initial.
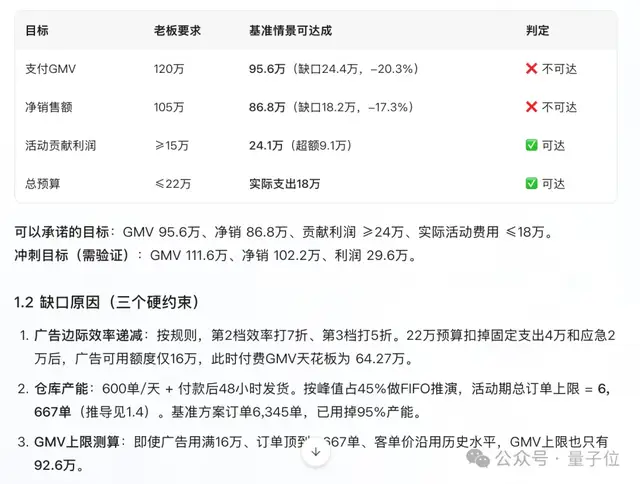
Il a également proposé unchemin d'ajustementcorrespondant, afin d'aider les salariés à répondre aux interrogations de leur patron.
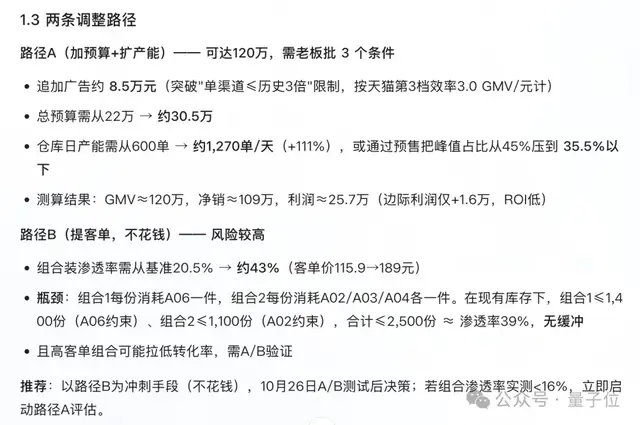
Examinons maintenant le plan promotionnel proposé par le modèle : les chiffres clés qu'il a calculésrésistent bien à la vérification。
qu'il s'agisse du tableau des combinaisons de produits ou du détail des budgets par canal, chaque donnée est traçable, ce qui témoigne d'une certaine capacité d'analyse des données.
Ling-3.1-flash a également fourni avec soin uncalendrier d'exécution par phasesincluant même les prérequis nécessaires à chaque phase.
Bien que notre prompt ne demandait le plan promotionnel que jusqu'au jour du Double 11, le modèle a de lui-même ajouté le débriefing et le calcul des bénéfices pour la suite.
Franchement, c'est chaleureux et attentionné~
Lesproductions textuellesdu modèle sont également très correctes : par exemple, il maîtrise parfaitement les relances de commande pour l'acquisition via vidéos courtes et les scripts de直播 (directs en livestream).
Visuels, textes, accroches, tout y est ; nous, pauvres travailleurs, n'avons qu'à copier le travail de l'IA, un gain de temps et d'efforts considérable.
Enfin, le modèle procède de lui-même à unevérification de cohérenceen indiquant clairement quelles données restent à valider par l'utilisateur et quels contenus doivent être confirmés par lui ; le contrôle final de l'exécution du plan reste ainsi toujours entre les mains de l'utilisateur.
En plus du travail bureautique quotidien,les scénarios de santé médicalesont également un point fort de Ling-3.1-flash.
Nous avons fourni des données virtuelles d'un bilan lipidique et une description floue des symptômes, en demandant au modèle de préparer une fiche de communication à emporter en consultation.
En cas d'informations insuffisantes,Ling-3.1-flash n'a pas tiré de conclusion directement, mais a d'abord listé les détails que l'utilisateur devait compléter, puis a distingué les faits connus, les points incertains et les questions à poser au médecin.
Après avoirguidél'utilisateur pour compléter les informations clés, il a croisé les nouveaux contenus avec les contenus existants pour obtenir une référence de consultation plus professionnelle.
Il est à noter que, tout au long de son raisonnement, le modèle insiste constamment surle principe d'alerte aux lignes rouges, rappelant sans cesse à l'utilisateur de surveiller l'évolution de son état et de consulter un médecin rapidement, sans jamais fournir explicitement de guide médicamenteux.
Ce faisant, il agit davantage comme un assistant réalisant le travail préparatoire pour le médecin.
Cependant, Ling-3.1-flash présente aussi quelques petits bugs : par exemple, si l'on injecte d'un coup un long texte au modèle,l'attention du modèle peut parfois diverger。
. Par exemple, un plan de promotion pour le Double 11 est en soi une tâche de travail très complexe et de longue durée ; il est plutôt recommandé de procéder par livraisons progressives, par exemple en traitant d'abord les données avec un script avant de générer le plan, de manière graduelle.
Il existe également des limites d'adaptation lors de la génération en une seule fois: si le résultat actuel n'est pas satisfaisant, il est souvent plus efficace pour l'utilisateur de revenir en arrière pour redéfinir clairement l'approche de mise en œuvre et les spécifications de livraison, plutôt que de continuer à tenter sa chance.
De plus,la version actuelle ne dispose pas encore de compréhension visuelle native: il faut ajouter en amont un modèle visuel pour le traitement, ce qui augmente le coût de l'ensemble du processus.
En somme, la capacité du modèle à produire des résultats utilisables varie selon les tâches.
Bailing s'invite en avant-première dans les flux de tâches réels
Après avoir parlé du modèle lui-même, revenons surBailing, qui a en réalité visé avec précision les points sensibles du secteur.
Cette année, le cercle des grands modèles s'est presque entièrement concentré sur le coding et les classements.
Mais à force de compétition, de plus en plus de personnes commencent à poser une question plus fondamentale : le coding est-il la seule épreuve possible pour l'AGI ?
Le jugement de Xiting, responsable de Bailing, lors de la Conférence du Bund est quele coding n'est pas la seule épreuve。
. À ses yeux, l'objectif de Bailing reste de servir les tâches du monde réel, en extrayant les capacités du modèle du niveau technique,en notant le modèle à l'aide de tâches réelles。
C'est pourquoi Bailian a placé ses modèles de la série 3.0 dans les deux endroits où l'erreur est la moins tolérable :La finance et la santé。
LingFinC'est un grand modèle financier à haute efficacité intelligente qui restructure l'efficacité financière en prenant la recherche sectorielle comme point d'entrée ; un modèle de renforcement pour la santé médicaleLingSanteportent quant à elles sur le raisonnement en matière de connaissances médicales, la recherche fondée sur des preuves et l'exploration des procédures standardisées.
Parmi eux, Ling-3.0-flash-Fin (124B de paramètres au total, 5.1B activés) fait entrer l'IA dans le flux réel des tâches de recherche sur les investissements, en connectant la chaîne complète allant de la recherche documentaire à l'analyse, jusqu'à la production de résultats de recherche.
Il égale les modèles de pointe de classe 3T sur des tâches de recherche d'investissement à haute difficulté, atteint un niveau de référence en open source pour les performances globales des agents financiers, et ses performances sur les tâches critiques rivalisent avec celles de modèles de pointe tels que GPT-5.4.
Ling-3.0-flash-Sante, quant à lui, apporte un rapport intelligence/efficacité élevé aux scénarios médicaux, atteignant la meilleure performance parmi les modèles de moins de 1.6T avec une échelle de 124B paramètres,Performances globales comparables à celles de plusieurs modèles phares。
Photo provenant du compte officiel Weibo de Baili.
Par rapport aux modèles de base, il ne s'agit pas de simples ajustements de secteur : ils sont véritablement intégrés dans des environnements de travail complexes, où ils sont continuellement affinés et validés.
À plus grande échelle, Bailing est également en train d'accomplir une chose qui mène le secteur, à savoir redéfinir« Efficacité »Ce mot.
Autrefois, le secteur ne parlait que deRatio d'efficacité de calcul, la puissance de calcul utilisée et son efficacité.
Bailing est la première à associer dans une même discussion l'efficacité de calcul des modèles, l'efficacité des paramètres et l'efficacité des Token, en soulignant que les modèlesrapport intelligence-efficacité。
Cette affirmation a rapidement reçu un écho de l'industrie : au cours du dernier semestre, Anthropic et OpenAI ont également lancé successivement des capacités professionnelles destinées aux secteurs de la finance et de la santé.
Par exemple, Anthropic, avecClaude for Financial Advisorslancé le mois dernier, organise des connecteurs et des Skills de tâches autour de travaux concrets, ce qui constitue une autre pratique d'intégration de processus spécialisés.
Certes, le débat sur la voie à suivre est encore loin d'être tranché, mais« entrer dans les flux de travail réels »passe du choix d'un seul acteur à une tendance pour toute l'industrie.
Cette année est également une année décisive pour Bailian, qui passe des capacités du modèle à la valeur des tâches.
À travers Ling-3.1-flash, la voie que suivra Bailian est déjà tracée :
Vers le haut, continuer à élever le plafond des capacités des agents pour les développeurs ;Vers le bas, réduire davantage le seuil d'utilisation pour les utilisateurs ordinaires, en transformant un meilleur rapport intelligence-efficacité en une réelle capacité d'accomplissement des tâches ;Vers l'extérieur, continuer à approfondir la spécialisation des modèles afin de réaliser des percées dans le monde réel.
On voit que la façon dont le monde des modèles prouve sa valeur est en train de changer de régime, mais tout ne fait que commencer.
Ling Studio :
https://ling.tbox.cn
OpenRouter :
https://openrouter.ai/inclusionai/ling-3.1-flash
HuggingFace :
https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope :
https://modelscope.cn/models/inclusionAI/Ling-3.1-flash