
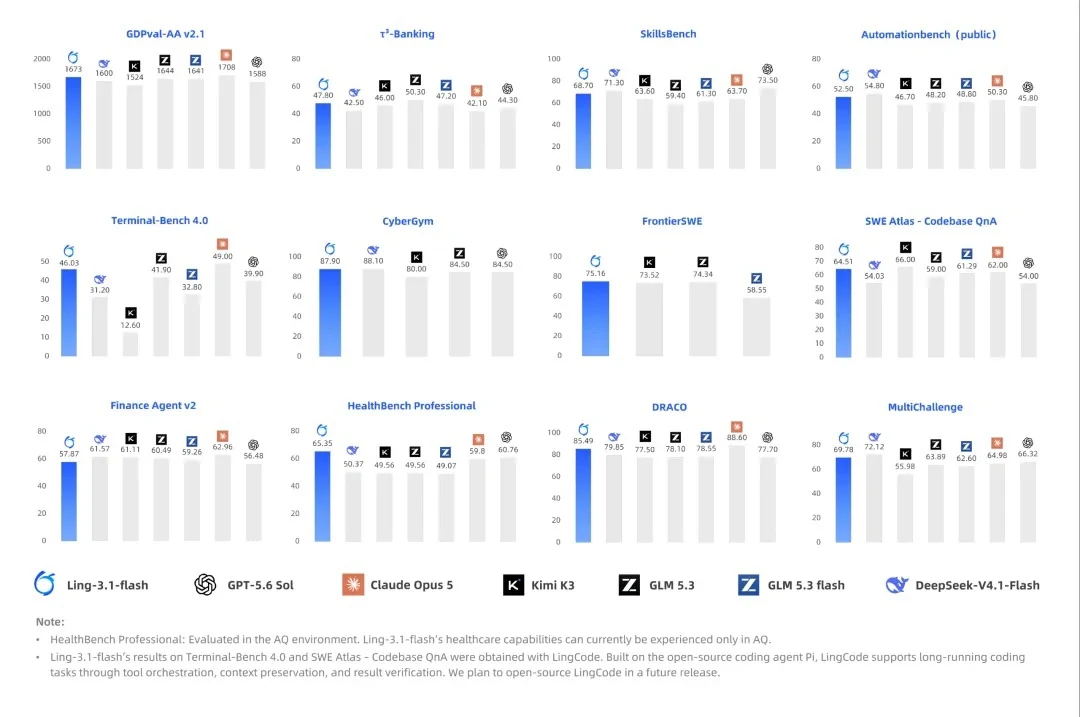
ITHome Le 16 octobre, Ant Ling a annoncé hier le passage en open source du modèle Ling-3.1-flash. Ling-3.1-flash compte environ 560B de paramètres au total, dont environ 25B activés par Token, et prend en charge jusqu'à 1M de contexte.
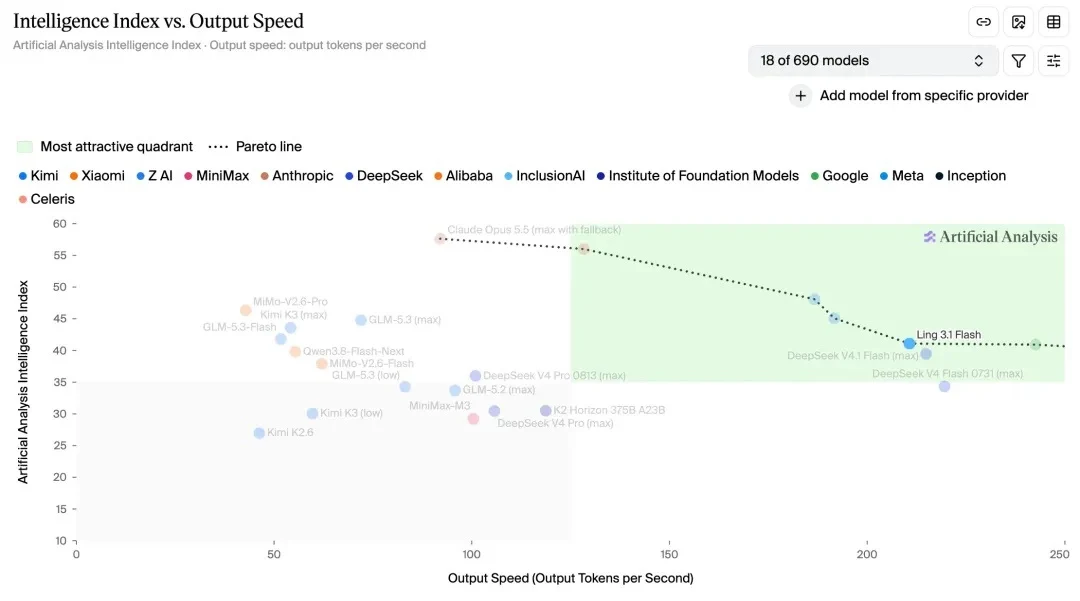
Dans les évaluations publiques d'Artificial Analysis, Ling-3.1-flash obtient un indice d'intelligence de 41 et une vitesse de sortie d'environ 210 Token par seconde.
Pour le déploiement local, l'équipe a appliqué une quantification MXFP4 aux routed experts tout en conservant les couches denses en block-FP8, faisant passer l'occupation des poids d'environ 534GB à 292GB. Dans la configuration de test correspondante sur GPU Hopper, le déploiement du service passe de 8 cartes à 4 cartes, permettant aux équipes disposant de GPU de niveau serveur de faire tourner le modèle avec moins de cartes ; les besoins réels varient néanmoins selon le contexte, la concurrence et la configuration du service.
Pour le traitement de longs documents, l'équipe propose un schéma d'inférence parallèle en contexte long (PCP / DCP) ; les appels d'outils renforcent également la prise en charge du JSON Schema, facilitant l'interface avec les API métier existantes.
Les questions-réponses en entreprise et les assistants bureautiques doivent souvent lire d'abord de longs documents, alors que les utilisateurs souhaitent encore une réponse rapide. L'équipe réduit les coûts d'inférence grâce à la fusion d'opérateurs et au décodage spéculatif DSpark : dans des requêtes de production simulées avec une entrée moyenne d'environ 25.47K Token, une sortie d'environ 224 Token et un taux de succès du cache de 76%,8 cartes Hopper confiriguration : le temps moyen au premier Token est de 604 millisecondes, avec un intervalle moyen entre Token de sortie consécutifs de 3.28 millisecondes. Cela fournit une référence de test pour la réponse interactive après l'entrée de longs documents.
Pour les systèmes métier qui doivent fournir un service continu, il faut également évaluer combien de requêtes une seule instance peut absorber dans le cadre d'un budget GPU fixe. Avec une entrée moyenne d'environ 8.5K Token et une sortie d'environ 800 Token 4 cartes Hopper avec une entrée moyenne d'environ 8.5K Token et une sortie d'environ 800 Token, le modèle atteint environ 1.36 QPS, tout en respectant les contraintes de test d'un temps au premier Token P50 inférieur à 3 secondes et d'un intervalle entre Token de sortie consécutifs P90 inférieur à 70 millisecondes. Cela fournit une référence pour la planification de capacité des déploiements autonomes.
Côté expérience en ligne, Ling-3.1-flash propose actuellement une remise limitée dans le temps de 2.5 折 (soit 75% de réduction), aux tarifs suivants après remise :
OpenRouter(en dollars) : entrée 0.075 dollar ; sortie 0.225 dollar ; lecture du cache 0.015 dollar.
Ling Studio(en yuans) : entrée 0.5 yuan ; sortie 1.5 yuan ; lecture du cache 0.1 yuan.
IT之家 ajoute le lien open source :
Hugging Face :https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope :https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
À lire également :
Déclaration publicitaire : les liens de renvoi externes contenus dans le texte (y compris mais sans s'y limiter les hyperliens, codes QR, codes d'accès et autres formes) servent à transmettre plus d'informations et à faire gagner du temps dans la sélection ; les résultats sont fournis à titre indicatif uniquement. Tous les articles d'IT之家 contenant des liens externes incluent cette déclaration.