
Nous avons déjà dit que Claude écrit environ 90 % du code de Claude Code lui-même. Alors, comment pouvons-nous revoir le code que nous produisons en grande quantité ? Est-ce que quelqu’un lit encore le code ? Et si quelque chose se bloque, qui le détecte ?
Cet article couvre le flux de revue de code au sein de l’équipe Claude Code et comment il s’est développé. De juin à septembre, le nombre de demandes de fusion des pull requests dans le codebase de Claude Code a plus que doublé, tandis que la part nécessitant un rejet a diminué de plus de 40 %.
Nous n’avons pas supprimé l’avis. Mais nous avons transféré la plupart de la lecture vers les machines, les optimisant pour le temps et l’attention humains, et nous avons investi beaucoup d’argent pour en faire une opération rapide et facile afin d’annuler les erreurs.
Réfléchir à la finalité de l’examen du code
Lorsque les agents écrivent du code, le nombre de modifications augmente rapidement. Dans le monorepo d’Anthropic, le nombre de modifications enregistrées par jour est passé de environ 2 500 en mai à plus de 30 000 en septembre cette année.
Le code Claude vit dans son propre répertoire, séparé du monorepo, mais il subit également beaucoup de pression. Lorsque vous livrez ce code rapide et manuel, avec une revue ligne par ligne, la tâche est incroyablement difficile, voire impossible.
La revue de code fait deux tâches :
- Trouvez et corrigez les problèmes avant leur mise en production
- Créer une compréhension commune du contexte et du code source au sein de l’équipe
Cet article se concentre principalement sur la détection et la correction des problèmes, mais nous reviendrons au deuxième point vers la fin.
Nous pensons que « une personne a lu le code » est un proxy imprécis pour « quels problèmes pourraient survenir avec ce changement, et quelle vérification – automatisée ou humaine – est la bonne pour les détecter ? »
Cette question a également changé quand la revue a lieu. Avant, la revue était une étape à la fin du parcours : écrire le code, ouvrir un PR, attendre son collègue.
Maintenant, les revues se font en continu, plutôt comme un correcteur de typographie pendant l’écriture. La plupart des corrections ont été vérifiées et corrigées par Claude au moins une fois avant qu’un humain ne soit chargé de vérifier. Cela permet de repérer la plupart des erreurs de routine, et permet à l’équipe de se concentrer sur les questions de niveau supérieur et les examens plus approfondis.
L’ressource rare : le temps et l’attention humains
Nous voulons préserver le temps et l’attention humaine pour les problèmes que seuls les humains peuvent résoudre, et nous veillons à ce que les vérifications automatisées couvrent le reste. Avec notre rythme actuel de changement, il reste encore une quantité incroyable de travail à accomplir par les humains, et notre équipe rencontre des défis nouveaux et inédits presque tous les jours.
Le temps humain couvre les deux aspects du coût de l’examen : le temps que les personnes passent à examiner, et le temps qu’elles passent à corriger les erreurs du code. Cibler le premier aspect ne sert à rien si le temps se retrouve uniquement dans le second.
Ainsi, l’objectif est que la plupart des pull requests dans le repos Claude Code (la CLI, les applications de bureau et web, ainsi que les applications mobiles) soient fusionnés avec au maximum une seule personne humaine en rôle de contributeur, sans augmentation des retours ou d’incidents. Pour mesurer le temps consacré par les humains, nous suivons les approbations humaines par PR (médiane et 95e percentile), les commentaires humains et la durée pendant laquelle un PR attend une personne. Les taux de retours et d’incidents constituent la barrière : si ils augmentent, cela signifie que nous n’avons pas économisé du temps humain, mais simplement déplacé le temps.
LA VIE D’UN CHANGEMENT
Une modification typique, provenant d’un ordinateur portable d’ingénieur (ou d’une session Claude sur Slack), passe par plusieurs couches de revue de code.
ÉTAGE PAR ÉTAGE
1. Le travail est vérifié avant que quiconque ne le voie
La plupart des revues se font maintenant avant l’existence d’un PR. Nous donnons à Claude quelque chose qu’il peut exécuter – comme des tests, une build ou une capture d’écran pour comparer avec le design – et nous lui demandons de montrer les résultats plutôt que de dire qu’il est terminé. Ensuite, un sous-agent examine le diff avec un contexte renouvelé. Ces deux habitudes proviennent de notre guide des meilleures pratiques.
Avant d’ouvrir un PR, beaucoup d’entre nous mettent également en œuvre quelques compétences internes : l’un cherche les bugs, l’autre simplifie le diff, et un autre vérifie le comportement de manière complète. Les modifications de l’interface utilisateur sont également examinées selon nos directives de conception.
Boris Cherny, qui a créé Claude Code, a déclaré que fournir à Claude une manière de vérifier son travail est probablement la chose la plus importante pour obtenir de bons résultats. Il estime que cela rend le résultat final deux à trois fois meilleur, et écrit : « La vérification diffère selon chaque domaine. Elle peut être aussi simple que d’exécuter un commande bash, ou d’exécuter un ensemble de tests, ou encore de tester l’application dans un navigateur ou un simulateur de téléphone. »
Quand le réviseur automatique continue à signaler la même chose, nous le corrigeons à la source : dans la compétence, avec une règle de lint, ou par des mises à jour des fichiers d’instruction tels que :
CLAUDE.mdindique à Claude de quelle projet il s’agit : la stack, les conventions, les objectifs et les non-objectifs. Chaque revue charge ce fichier ; donc, dans un code-base large, nous le gardons court et nous renvoyons vers d’autres documents. Le réviseur note également tout code qui viole une convention ou qui rend une ligne obsolète.REVIEW.md, rédigé par les propriétaires du code, indique au revueur ce qui est important dans sa partie de code. Nous vérifions séparément si le revueur le suit vraiment. Les bonnes revues sont courtes. Elles décrivent comment le problème se manifeste dans ce repo (pour les documents : « c’est faux », pour les configurations : « c’est une mauvaise routage »), limitent les erreurs, listent les chemins à ignorer, et demandent un fichier et une ligne comme preuve plutôt qu’une supposition basée sur un nom. Elles demandent également un résumé commençant par un chiffre et indiquent clairement quand il n’y a rien à corriger.
2. Revue de l’IA pour chaque pull request
Chaque pull request reçoit une revue de Claude avant que quelqu’un ne l’examine. Il lit la différence par rapport à tout le répo et à l’intention indiquée dans le PR, et se demande : la modification résout-elle le problème, s’adapte-t-elle au système, ou endommage-t-elle autre chose ?
En raison d’une correction de bug, on cherche la cause racine. La version publique Code Review pour Claude Code est désormais disponible en général sur les plans Team et Enterprise, et /code-review exécute une version plus légère localement.
Lorsque nous avons lancé la preview de recherche, la part des PR internes qui reçoivent des commentaires réellement pertinents est passée de 16 % à 54 %. La plupart des PR de plus de 1 000 lignes reçoivent des observations, et la plupart des petits PR sont traités sans problème. Les administrateurs définissent chaque repo en Quick, Standard ou Deep. Le mode Deep est valable lorsque l’erreur manquée coûte plus que le temps supplémentaire de revue.
Les découvertes sont vérifiées par d’autres agents avant que les humains ne les examinent. Plusieurs agents cherchent des bugs en même temps. Ensuite, un groupe distinct vote pour chaque découverte, et elle n’est publiée que si suffisamment de personnes estiment qu’elle est réelle. Les découvertes qui concernent uniquement le style, les diagnostics ou la correction sont éliminées. Nous avons testé ces filtres A/B sur nos propres PR avant de les mettre en place. Ce qui reste apparaît sous forme de commentaires intégrés classés par gravité. Chaque commentaire est étiqueté comme « Important », « Nit » ou « Pré-existant », de sorte qu’un bug que le PR n’a pas introduit ne semble pas être la faute de l’auteur.
Chaque constatation doit être résolue. Vous devriez soit corriger le problème, soit expliquer la raison du dysfonctionnement. Souvent, l’agent trouve une solution en une nuit, de sorte que l’auteur revient sur un PR qui a déjà été examiné une autre fois.
3. Revue de sécurité qui peut bloquer
La sécurité fait également l’objet d’une revue automatisée. Un PR ne peut pas être fusionné tant qu’une constatation issue de la revue des bugs ou de la revue de sécurité est encore en cours. Il faut soit corriger le problème, soit clore le sujet avec une brève explication, ce qui permet d’éliminer un faux positif.
Si une modification ultérieure corrige le problème, la constatation disparaît d’elle-même. Vous pouvez mettre en place la même chose avec l’action GitHub Action de revue de sécurité open-source ou avec le commande /security-review. La configuration est décrite dans les revues de sécurité automatisées dans Claude Code.
4. Vérifications automatisées qui bloquent
Le processus habituel : vérification de la syntaxe, tests sur toutes les plateformes, et build. (Nous avons parlé de l’étalement du CI dans cet article ici.) Une demande de pull request CLI typique peut faire passer des dizaines de vérifications avant que quelqu’un ne la examine. Le modèle de PR demande comment le changement a été testé et comment le rétablir. Claude peut remplir ces informations, mais la personne qui a demandé le changement signe sa demande.
5. Approbation humaine, pondérée par le risque
Une correction de documentation et un changement d’automatiseur de mise à jour présentent des risques différents, donc ils font l’objet de revues distinctes.
| Risque | Exemples | Approbations humaines |
|---|---|---|
| Basse | Documents, copies, fonctionnalités interne uniquement, modifications additionnelles sous un drapeau | Aucune nécessité une fois les vérifications automatisées et les contrôles de sécurité validés |
| Moyen | Changements de produit ordinaires, ainsi que modifications dans des zones sensibles telles que le stockage en cache, l’autopollueur ou les messages système | Une personne |
| Haute | Le code à risque le plus élevé, ainsi qu’un petit ensemble de chemins qui nécessitent toujours deux personnes | Deux personnes |
Cette modification définit le niveau de risque, et non l’auteur. Un classificateur lit la modification et choisit son niveau de risque. Un second classificateur vérifie si cette modification spécifique nécessite une autre personne, même lorsque son niveau indique qu’il n’en est pas besoin. Certains processus nécessitent toujours une personne, tout ce que les propriétaires ont identifié comme sensible, ainsi que tous les fichiers de workflow CI.
Seuls les auteurs fiables obtiennent les chemins plus légers. Seuls les auteurs figurant sur la liste de confiance du repo reçoivent les chemins plus légers, principalement le groupe qui en est le propriétaire. Tout le reste nécessite l’approbation d’une autre personne. L’approbation d’un agent ne compte pas non plus comme celle d’une personne humaine. Une vérification automatisée peut valider un changement à faible risque, mais elle ne peut pas remplir une place qui exige une intervention humaine.
Quiconque a initié le changement en est responsable. Dans une pull request rédigée par un agent, la personne qui dirige l’agent compte comme l’un des réviseurs requis, tout comme si elle avait écrit le code elle-même.
Une approbation couvre un seul commit spécifique. Si de nouveaux commits sont ajoutés et que le système ne peut les valider, comme un push d’un agent ou une fusion résolue manuellement, l’approbation doit être donnée à nouveau.
6. Fusionner la file d’attente, les flag et une libération progressive
La file d’attente de fusion réexécute chaque vérification par rapport au main avec la modification appliquée, de sorte que deux PR qui passent séparément ne peuvent pas se combiner pour créer un main corrompu. Le nouveau comportement est généralement livré en premier aux employés d’Anthropic sous une marque, et notre utilisation intensive révèle souvent des regressions avant les utilisateurs. Les versions publiques sont d’abord envoyées dans le canal latest. Le canal stable suit ensuite.
7. Détection rapide, retour en arrière rapide
Certains erreurs continueront d’arriver, donc la dernière couche vise à les repérer rapidement. Les flags s’éteignent sans déploiement. Claude Code fait une rotation de prise en charge hebdomadaire, et les revues d’incident demandent quelle couche aurait dû repérer le problème.
Il est encore possible de remarquer une mauvaise fusion, mais cela dépend de l’auteur et du personnel en charge, ainsi que des tableaux de bord de réversion et d’incident. Nous ne disposons pas encore de dispositifs de coupure de courant qui renforcent l’approbation lorsque ces chiffres changent ; les ingénieurs ici souhaitent les avoir avant que davantage de code ne se transforme en fusion sans personnel.
Un collègue a dit que ralentir diminue le taux d’erreur, mais surtout parce qu’on fait moins de choses en même temps. Nous préférons aller plus vite dans la détection et la correction des problèmes.
Comment nous rendons le réviseur meilleur
Notre processus de revue de code s’améliore constamment en boucle.
Tous les incidents sont désormais évalués. L’équipe a collecté les PR passés qui ont provoqué des incidents, avec leurs correctifs et retours, et dispose d’ingénieurs qui connaissent le code et confirment chaque bug ainsi que son emplacement. Le réviseur teste ce ensemble quotidiennement.
Nous mesurons le bruit en observant ce que les gens font avec les commentaires. Il est facile de détecter plus de bugs si l’on ne se pèse pas sur les nombreux commentaires qui ne sont pas des bugs, donc nous avons besoin d’une vérification à cet égard. Nous classons chaque commentaire laissé par le réviseur en fonction de la réponse de la personne concernée : elle a corrigé le bug, a dit que c’était faux, a indiqué que le comportement était intentionnel, ou a décidé qu’il ne comptait pas. Nous testons également le réviseur sur des PRs que nous savons être propres, et comptons combien de fois il rapporte quelque chose qui aurait conduit à une modification nuisible. Notre priorité, écrite, est de détecter d’abord les vrais bugs, puis de réduire le nombre de tours de révision.
Le bruit coûte plus cher lorsque l’auteur est un agent. Une personne peut résoudre un problème en quelques secondes. Un agent s’en occupe, ce qui signifie une autre mise en œuvre et une nouvelle série de revues.
Le revue doit converger. Un auteur d’agent et un réviseur d’agent peuvent occuper l’autre indéfiniment. Un PR CLI a traversé plus de cinquante tours de revue et de corrections en une nuit avant que son auteur ne le mette fin.
Lorsque nous avons utilisé git blame sur ce que le réviseur signalait constamment, environ 59 % de ces problèmes de code étaient déjà présents depuis la première inspection du réviseur. Le réviseur trouvait rarement de nouveaux bugs ; il découvrait plutôt quelques anciens bugs à chaque cycle d’inspection.
Nous avons aggravé la situation nous-mêmes. Nous étions habitués à effectuer plusieurs tours par défaut, car chaque passage révélait quelque chose de nouveau. Cela peut être utile pour un changement risqué, mais pas pour tous les PR. L’équipe suit désormais les tours à effectuer en même temps que le rappel, et a modifié la révision :
- Un chapeau rond. Après trois tours, le réviseur demande à l’auteur de reculer et de reconsidérer sa méthode.
- Réexamen des différences seulement après les premières passes.
- Marquer la classe du bug, afin que l’auteur corrige chaque instance, et non une seule ligne.
- Aucune répétition des résultats déjà publiés.
Les agents de revue effectuent également une vérification quotidienne du code existant, nous permettant de repérer les anciens bugs avant qu’ils ne apparaissent ailleurs.
Où les humains restent dans le cycle
Détourner un ingénieur senior de son travail intense pour détecter une erreur routinée coûte bien plus que l’examen automatisé. Chez Anthropic, nos tâches ont passé de la lecture de chaque différence à les décisions auxquelles les machines sont mauvaises :
- Devrions-nous vraiment le construire ? Direction, goût et portée. Une équipe qui a identifié les goulots d’étranglement dans l’examen a continué à utiliser l’examen humain pour les modifications provenant de l’extérieur de l’équipe, donc quelqu’un demande : « Devrions-nous même le faire ? »
- Codage risqué, tel que les opérations de facturation, l’updater automatique et les workflows de CI.
- Architecture qui définit un modèle que les autres vont copier.
- Lire les preuves. Le résultat du test, la commande exécutée et ce qu’elle a renvoyé, une capture d’écran, les conclusions du réviseur. Si vous ne pouvez pas déterminer ce que les vérifications auraient manqué, demandez un véritable examen plutôt qu’une approbation rapide.
- Contrôler le résultat. Une personne est responsable de chaque modification qui est livrée, quel que soit celui qui l’a tapé.
Partager le contexte au sein de l’équipe
La deuxième tâche de la revue de code a toujours été de favoriser la compréhension du code source. Lire le diff d’un collègue permet de savoir quoi a changé et comment les éléments s’assemblent. Si les machines effectuent la plupart de la lecture, comment quelqu’un peut-il apprendre le code ?
Nous n’avons pas de processus formel pour cela. Personne dans l’équipe ne possède une représentation complète du code de Claude dans son esprit, et nous pensons qu’il n’est pas nécessaire. Lorsque quelqu’un souhaite comprendre une partie du code source, il demande à Claude d’écrire une explication pour cette portion spécifique. Cela prend quelques minutes et reflète le code tel qu’il est aujourd’hui.
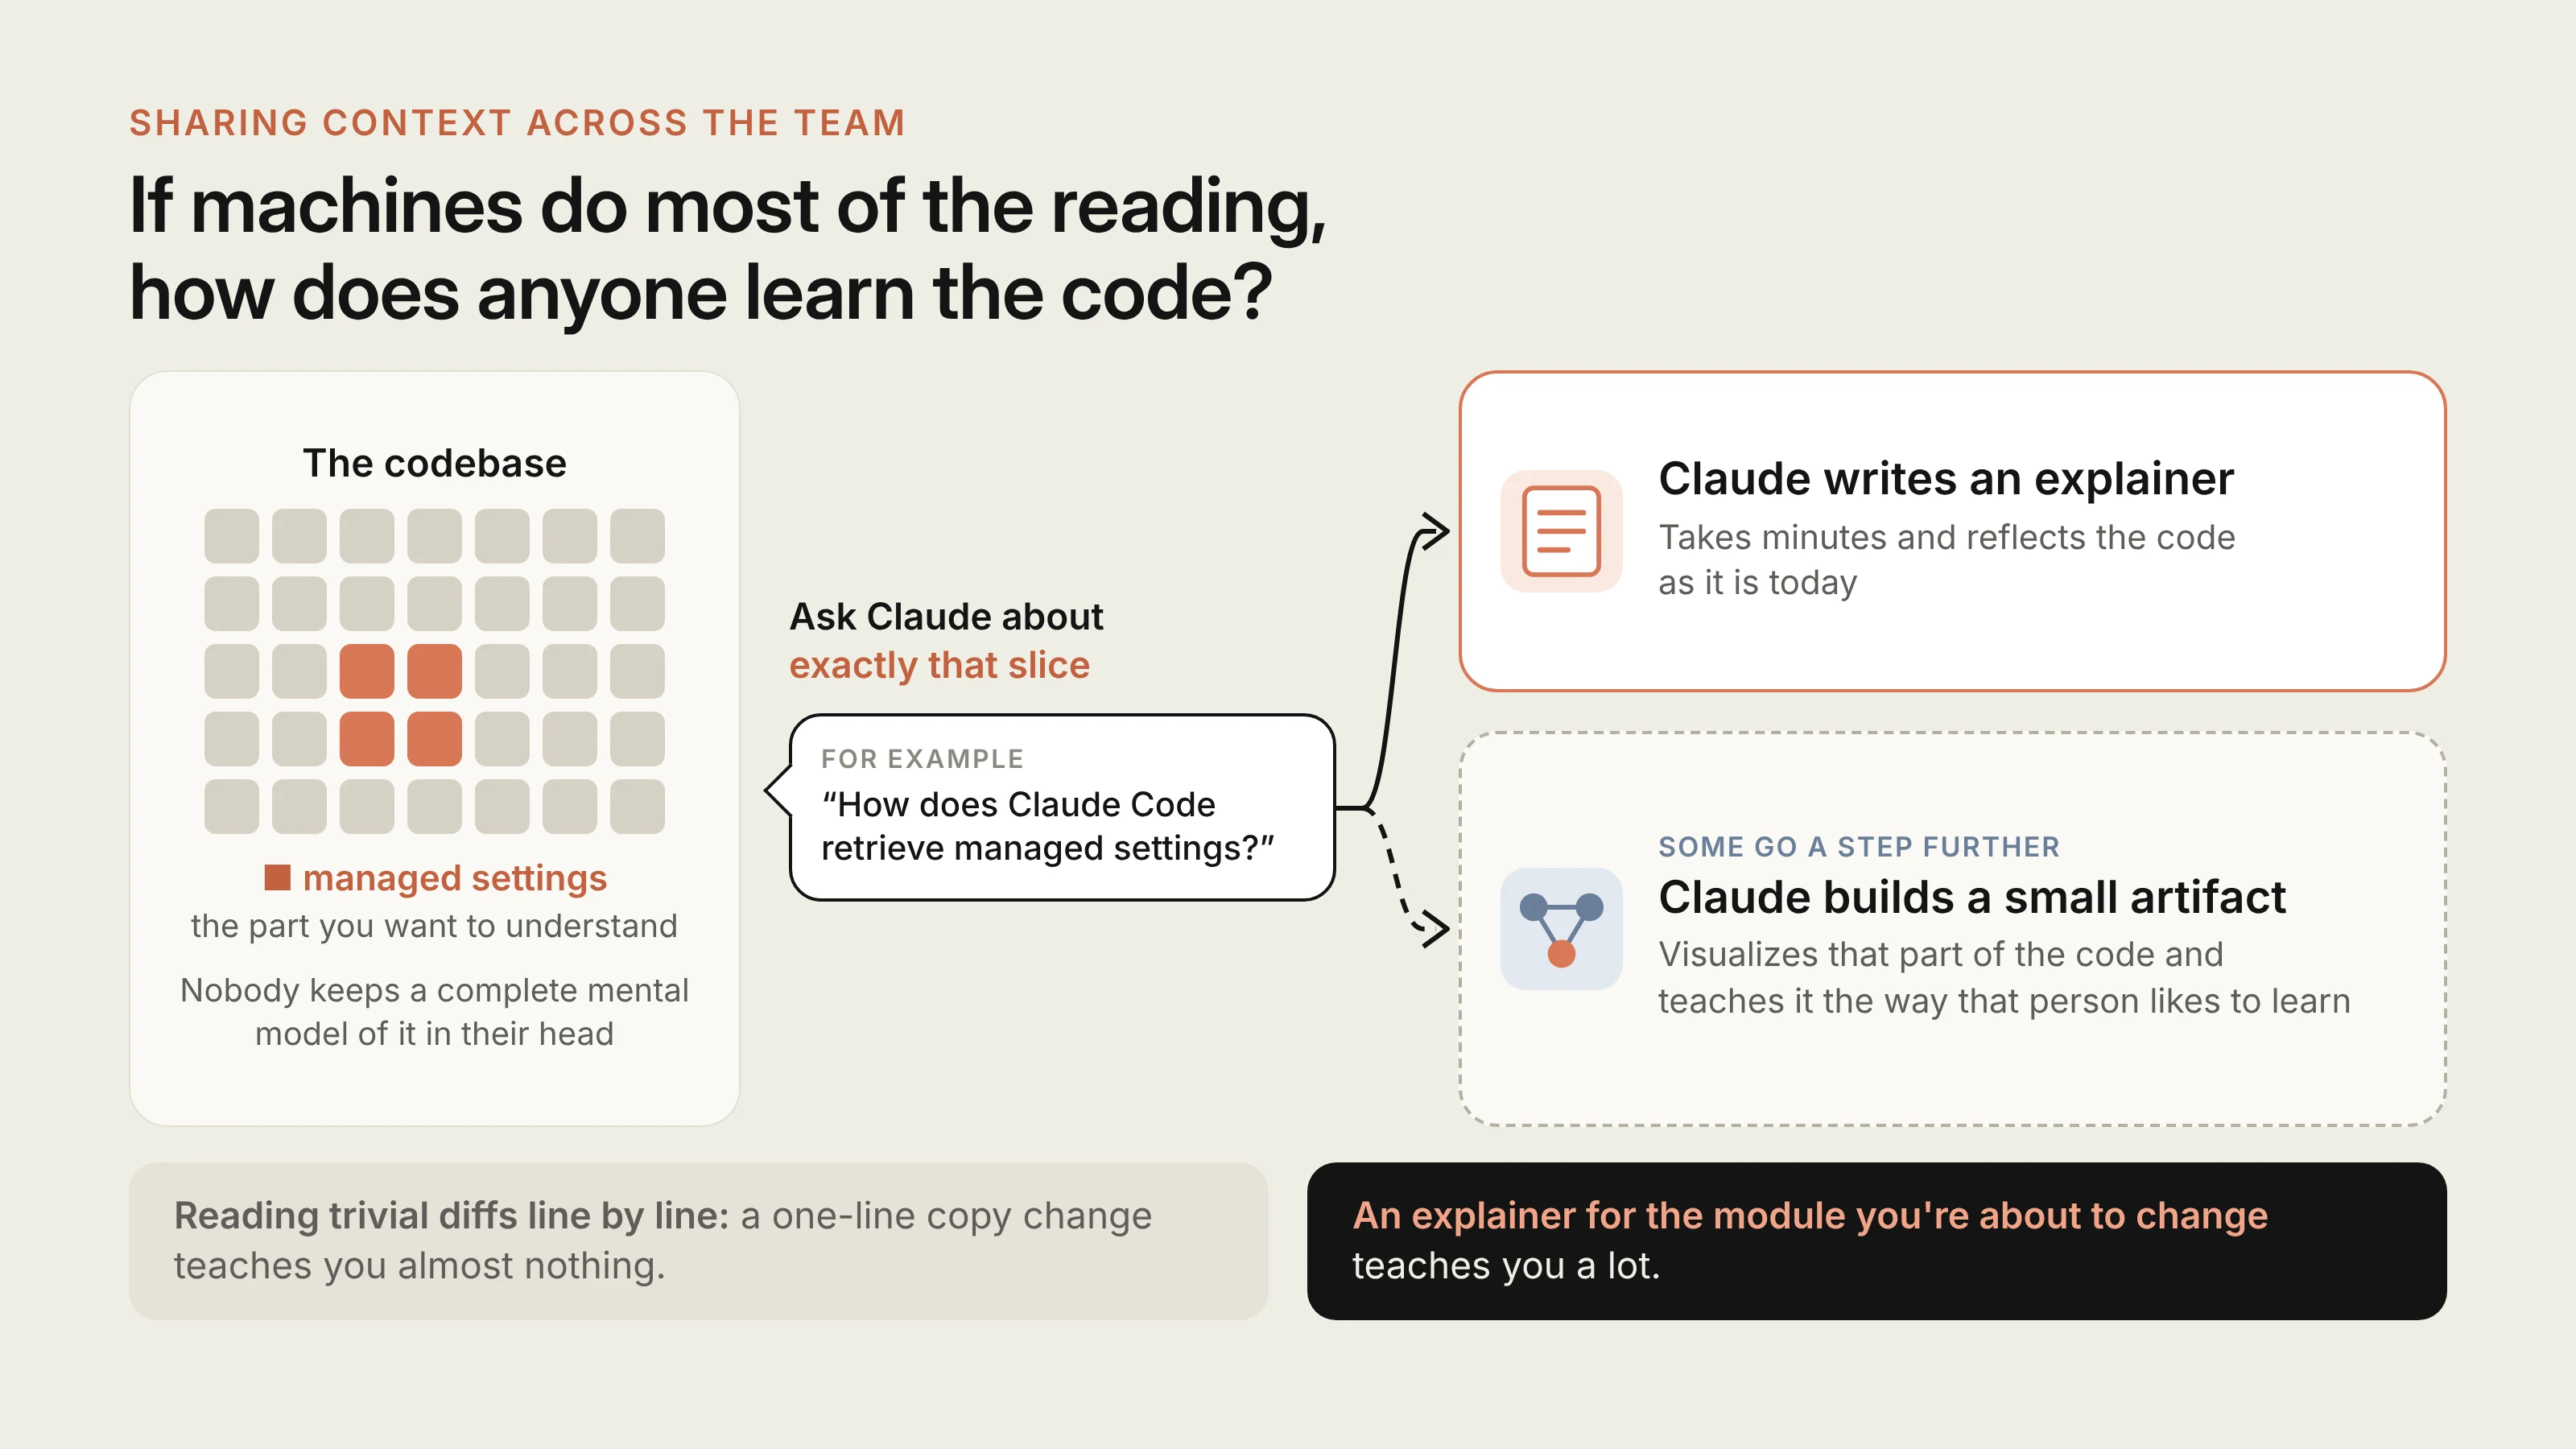
Certains d’entre nous vont encore plus loin : ils demandent à Claude de créer un petit artefact qui illustre cette partie du code, et l’enseignent de la manière dont cette personne aime apprendre.
Si l’objectif est de susciter l’attention humaine, cela vaut mieux que de lire des différences triviales ligne par ligne. Une modification d’une seule ligne ne vous enseigne presque rien. Une explication concernant le module que vous allez modifier vous enseigne beaucoup. Notre culture consistant à travailler dans des canaux Slack ouverts aide également, car vous voyez ce que les autres construisent pendant qu’ils le font.
« VOUS L’AVEZ, VOUS LA POSSEDEZ »
Si vous atterritez avec une petite ou moyenne quantité et qu’il se passe encore un problème, c’est une norme du groupe : on essaie généralement de le résoudre. Quelques facteurs empêchent que la situation ne se détériore :
- Les modifications sont modestes, donc elles sont faciles à examiner, déboguer et annuler.
- Tout est réversible. Les flag, les reverts et les versions de publication en étapes permettent d’annuler la plupart des erreurs en quelques minutes.
- Le rayon de détonation définit la barre. Les codes coûteux attirent plus de personnes et reçoivent plus d’examens.
- Les régressionnelles apparaissent rapidement grâce à la télémétrie et l’utilisation interne.
- Cela n’est pas une faute. Être responsable d’une solution signifie que vous disposez du plus grand contexte ; les revues d’incidents examinent le système.
La propriété est également partagée. Une grande partie de l’équipe travaille dans des canaux ouverts où toute personne peut voir ce que les autres construisent, prendre part à un sujet en discussion, ou utiliser Claude pour identifier un problème. Les retours viennent également de personnes qui ne possèdent pas le code. Cette ouverture est un élément essentiel qui permet de maintenir une qualité élevée sans avoir de barrières sur chaque ligne de code.
QUAND NOUS CHANGÉEZ LA DIRIGEANCE
Les agents rendent les choses faciles à commencer, donc certains travaux ne devraient pas être réalisés. Généralement, quelqu’un dans le canal demande pourquoi, pointe vers une décision antérieure ou propose une méthode plus simple, et l’auteur ferme ou transforme la communication publique.
Comme le code était facile à écrire, clôturer le PR ne semble pas être une perte. La astuce est de proposer tôt une direction différente dans la discussion, plutôt que de faire un commentaire bloquant sur un PR déjà terminé.
Comment vous pouvez adopter ce processus
La plupart des outils nécessaires pour faire cela avec votre équipe existent aujourd’hui.
Avant la demande de pull
- Donnez à votre agent des vérifications qui peuvent être exécutées, listées dans un court
CLAUDE.md, ainsi que des hooks permettant d’exécuter les formatteurs et les linters. - Exécutez
/code-reviewet/security-reviewlocalement, ou faites appel à un subagent de contexte neuf. - Ajoutez un fichier
REVIEW.md, et transférez les commentaires de revue répétés dans celui-ci.
Dans chaque pull request
- Exigez CI, et ajoutez « Testing », « Risque » et « Comment rétablir » à votre modèle de PR.
- Ajoutez un réviseur IA (Code Review pour Claude Code ou la Claude Code GitHub Action) dans un répo, adaptez
REVIEW.mdpendant quelques semaines, puis étendez l’application. - Ajouter une revue de sécurité automatisée, et exiger que chaque thread de revue soit résolu avant la fusion.
- Associer l’effort de la revue de code au risque : une revue rapide pour les modifications de routine, une revue approfondie où un bug manqué est coûteux (Rapide, Standard ou Profond dans la revue de code).
- Rounds de revue des capacités ; après les premières, seuls les nouveaux diffs sont réexaminés.
Approbation
- Ecrivez les niveaux de risque, définis par les changements plutôt que par l’auteur ; commencez avec des règles strictes et affinez-les en fonction des preuves.
- Conservez les chemins d’approbation plus légers pour les auteurs que vous confiez.
- Utilisez CODEOWNERS et la protection des branches afin que l’authentification, les factures, le CI et les processus de sortie, ainsi que les installateurs, nécessitent toujours une personne pour s’en occuper.
- Ne permettez jamais à l’approbation d’un bot de remplacer une approbation nécessaire d’un humain ; ignorez les approbations pour de nouveaux commits.
Fusionner et après
- Utilisez une file d’attente de fusion, des flags de fonctionnalité, l’utilisation interne en premier, des sorties par étapes et un retour en arrière en une seule étape.
- Transformer les incidents et les retours en un ensemble d’évaluations, et recompter le réviseur chaque fois que ses prompts, outils ou modèle changent.
- Mesure le temps humain, en utilisant les taux de retour et d’incidents comme garde-fou.
OÙ CELA SE DÉROULE
L’annonce de Code Review indique que l’approbation d’une pull request reste une décision humaine ; c’est le produit qui publie les résultats, et non les approbations. Nos propres réposoirs vont plus loin : ils permettent aux propriétaires de décider quelles modifications à faible risque fusionnent simplement grâce aux vérifications automatiques, et cette ligne continue de se développer.
Lorsqu’une revue manque quelque chose, nous demandons ce que le modèle n’a pas eu devant lui et insérons la correction dans un CLAUDE.md, une compétence ou une nouvelle vérification. L’objectif n’a pas changé : moins de temps humain par modification, et aucune réversion supplémentaire que précédemment.
Si votre équipe permet aux agents d’ouvrir des pull requests, nous aimerions savoir quelles vérifications vous avez automatisées, quelles nécessitent encore une intervention humaine, et ce que vous pensez que nous avons mal fait.
Merci à Emma Webb, Michael Segner et Amie Rotherham pour leurs critiques.