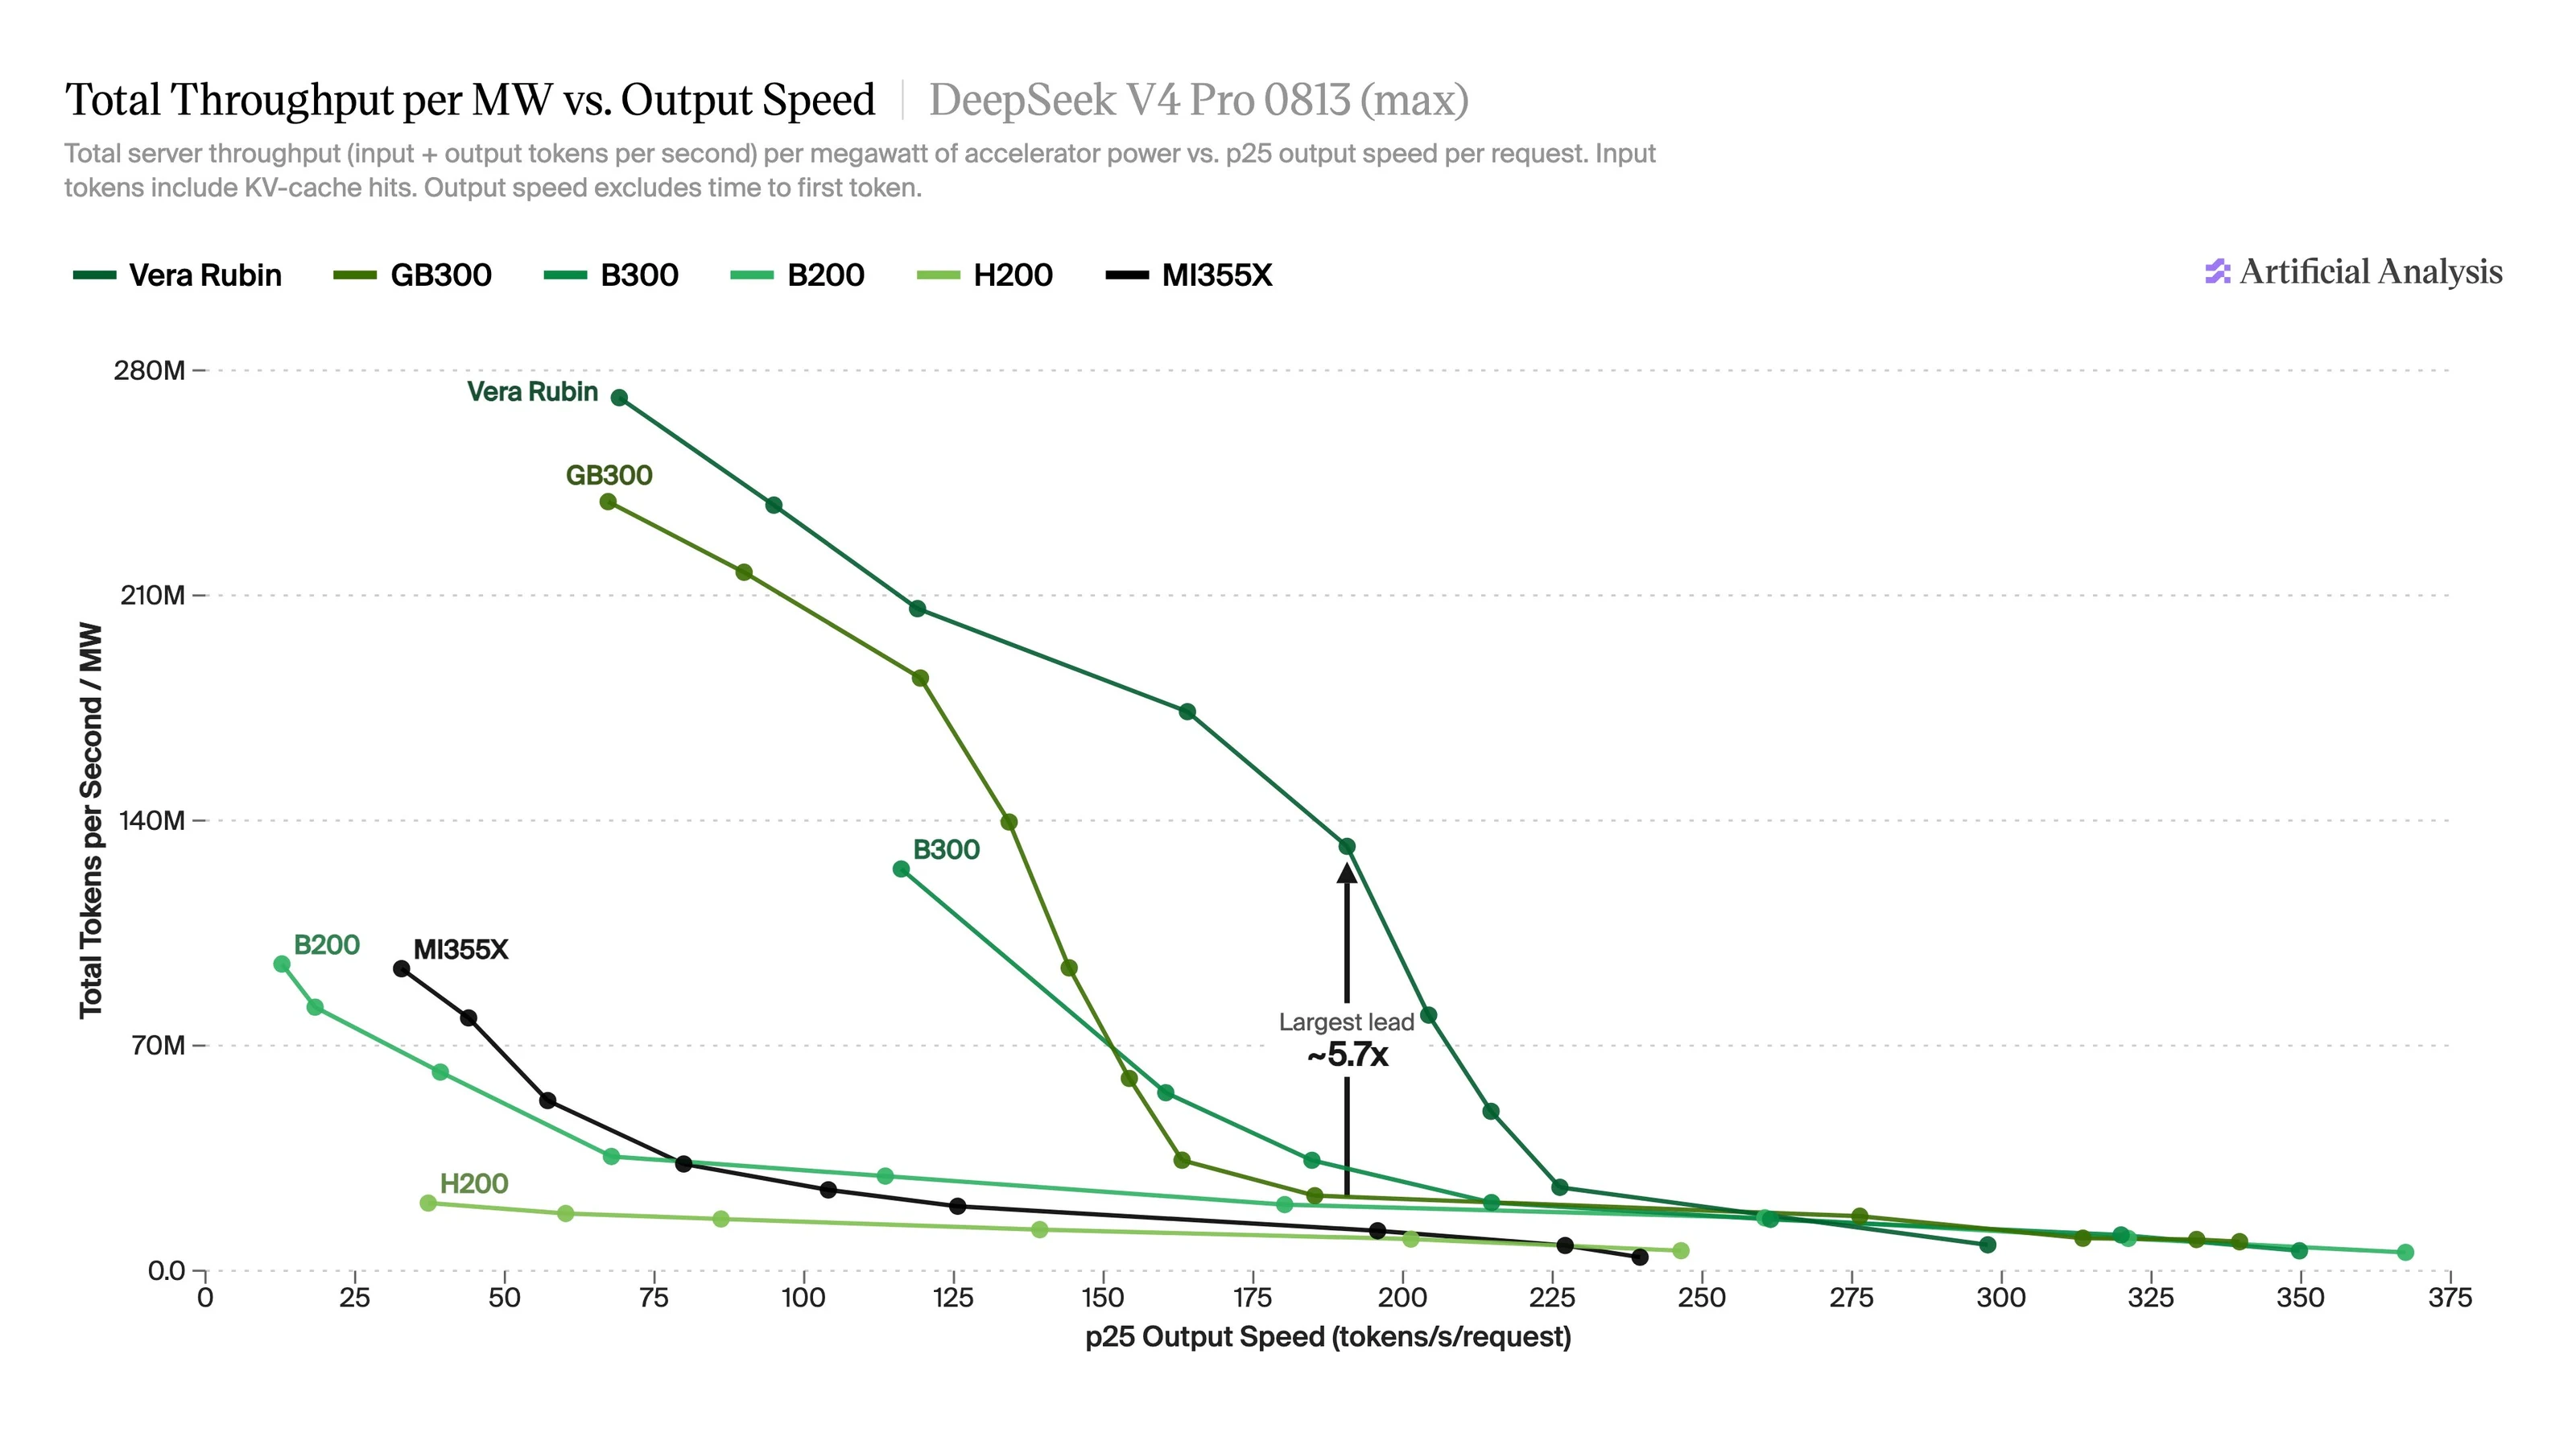
Les résultats initiaux pour le Vera Rubin NVL72 de NVIDIA sont maintenant disponibles sur AA-AgentPerf : jusqu’à ~5,7 fois le débit total par mégawatt de son prédécesseur GB300 NVL72 sur DeepSeek V4 Pro, ~5,4 fois sur DeepSeek V4.1 Flash, ~3,0 fois sur GLM-5.2 et ~2,8 fois sur Kimi K3
Vera Rubin est la successeure de Blackwell chez NVIDIA, et Vera Rubin NVL72 est son système à échelle de rack, comprenant 72 GPU Rubin et 36 processeurs Vera. Chaque GPU Rubin dispose de 288 GB de mémoire identiques à celles de Blackwell Ultra, mais avec 2,4 fois la bande passante de la mémoire, 1,7 fois la bande passante du NVLink et 2,3 fois le calcul dense NVFP4. NVIDIA a soumis tous les résultats de Vera Rubin, en utilisant TensorRT-LLM et vLLM avec NVIDIA Dynamo.
AA-AgentPerf est notre benchmark de performance d’inférence agentique. Il reproduit des sessions de codage agentique réelles, y compris des contextes longs stockés et des retards liés aux appels aux outils, afin de fournir une mesure réaliste de la performance d’inférence dans les tâches quotidiennes agentiques. Nous mesurons le débit total du système par mégawatt de puissance GPU mesurée, ainsi que la vitesse de sortie par agent (p25 sur les requêtes) à différents niveaux de concurrence, pour montrer le compromis entre l’utilisation du système et l’expérience utilisateur individuelle.
Résultats initiaux :
➤ La piste de Vera Rubin est la plus grande à des vitesses plus élevées par utilisateur, où le débit de GB300 diminue. Sur DeepSeek V4 Pro, passer de ~120 à ~165 tok/s par utilisateur coûte à GB300 81 % de son débit par MW, contre 16 % pour Vera Rubin
➤ À son rendement maximal, les deux systèmes sont proches : Vera Rubin atteint 272M tokens/s par MW sur DeepSeek V4 Pro, contre 239M pour GB300 (1,14x), 571M contre 395M sur DeepSeek V4.1 Flash (1,45x), 272M contre 201M sur GLM-5.2 (1,35x) et 70M contre 56M sur Kimi K3 (1,26x). Nous anticipons que l’écart entre les systèmes s’agrandira à mesure que les noyaux de Vera Rubin et d’autres logiciels de service sont optimisés.
➤ Vera Rubin fixe les vitesses les plus rapides par utilisateur sur notre classement pour DeepSeek V4.1 Flash (906 tok/s, le résultat le plus rapide pour tout modèle), GLM-5.2 (408 tok/s) et Kimi K3 (255 tok/s)
Félicitations à @nvidia pour les bons résultats !
Lisez l’analyse complète : https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf