
Dans les efforts d’optimisation du Kimi K3 : comprendre les goulots d’étranglement et les décisions qui ont accéléré l’inférence
Dans cet article- AgentX : le travail de charge et les résultats
- À l’intérieur de Kimi K3 : experts, attention et état récurrent
- 1. Cache : conserver l’état de la conversation disponible pour réutilisation
- 2. MoE : suppression des tâches répétées entre GPU
- 3. Trafic de mémoire : opérations de fusion et suppression des copies inutiles
- 4. MLA : décodage plus rapide de longs contextes avec l’assemblage AMD AITER
- 5. KDA : paralléliser le pré-fill et la vérification spéculative
- 6. Décodage spéculatif : choisir le nombre de tokens à écrire
- Quoi optimiser ensuite
- Contributions et remerciements
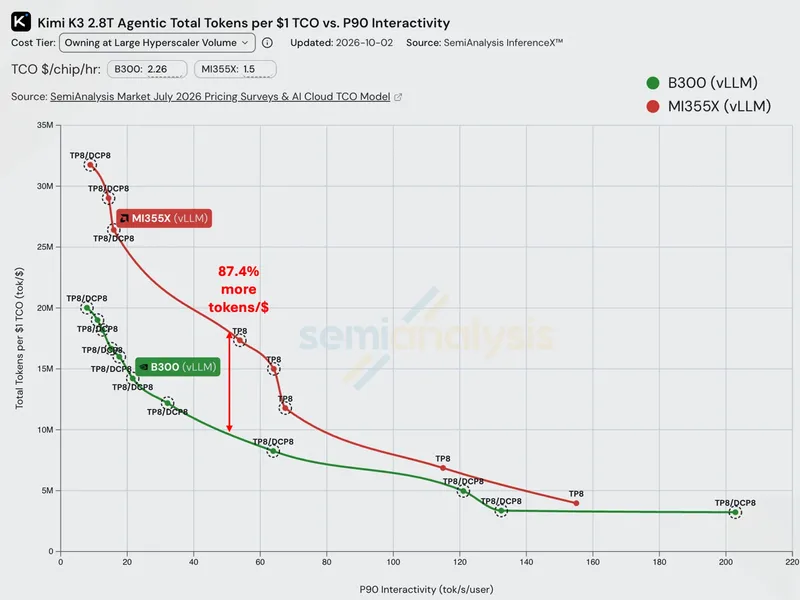
Sur AgentX, un système à huit GPU AMD Instinct MI355X servant Kimi K3 avec vLLM, il génère 24,4 % de plus en tokens total par seconde par GPU par rapport au NVIDIA HGX B300 à 50 tokens/s/utilisateur P90 interactivité. Selon le modèle de coût d’acquisition du benchmark, il génère 87,4 % de plus en tokens par dollar.
Dans cet article, nous détaillerons l’ingénierie qui se cache derrière Kimi K3 sur AMD Instinct MI355X, en reliant les décisions de service de vLLM aux noyaux GPU et au matériel sous-jacent. Nous expliquerons pourquoi ces optimisations fonctionnent, et nous vous aiderons à repérer les inefficacités, identifier les goulots d’étranglement et trouver les prochaines améliorations dans votre propre stack d’inférence.
L’interactivité est réciproque en termes de latence entre les tokens et de réponse P90, et exclut le temps nécessaire pour atteindre le premier token. Les tokens totaux comprennent l’entrée réutilisée et la sortie générée.
Source : SemiAnalysis InferenceX, snapshot du 9 octobre 2026. Configurations de comparaison.
Les pics de matrice dense publiés sont de 10,1 PFLOP/s MXFP4 pour l’AMD Instinct MI355X et de 13,5 PFLOP/s FP4 pour la NVIDIA B300. Les deux disposent de 288 GB de HBM3E et d’un bande passante mémoire de pic de 8 TB/s. Le réalisme de ces performances révèle une ingénierie logicielle soutenue par AMD et ses partenaires au sein de la communauté vLLM.
AgentX : le travail et les résultats
Le benchmark public AgentX reproduit les enregistrements des sessions de codage-agent réels avec des tokens synthétiques, tout en conservant la longueur des requêtes, les temps et les schémas de partage des préfixes. La charge de travail permet une réutilisation de préfixes théorique supérieure à 96 % avec un cache illimité. Les exécutions spéculatives utilisent une référence d’acceptation synthétique fixe.
À 50 tokens/s/utilisateur P90 interactivité, l’AMD Instinct MI355X génère environ 7 567 tokens/s/GPU, contre 6 083 pour NVIDIA HGX B300, soit une avantage de 24,4 % en performance. En utilisant le TCO modélisé par SemiAnalysis, qui est de $1,50 contre $2,26 par heure GPU, cela se traduit par 18,16 millions contre 9,69 millions de tokens par dollar de TCO : 87,4 % plus de tokens par dollar.
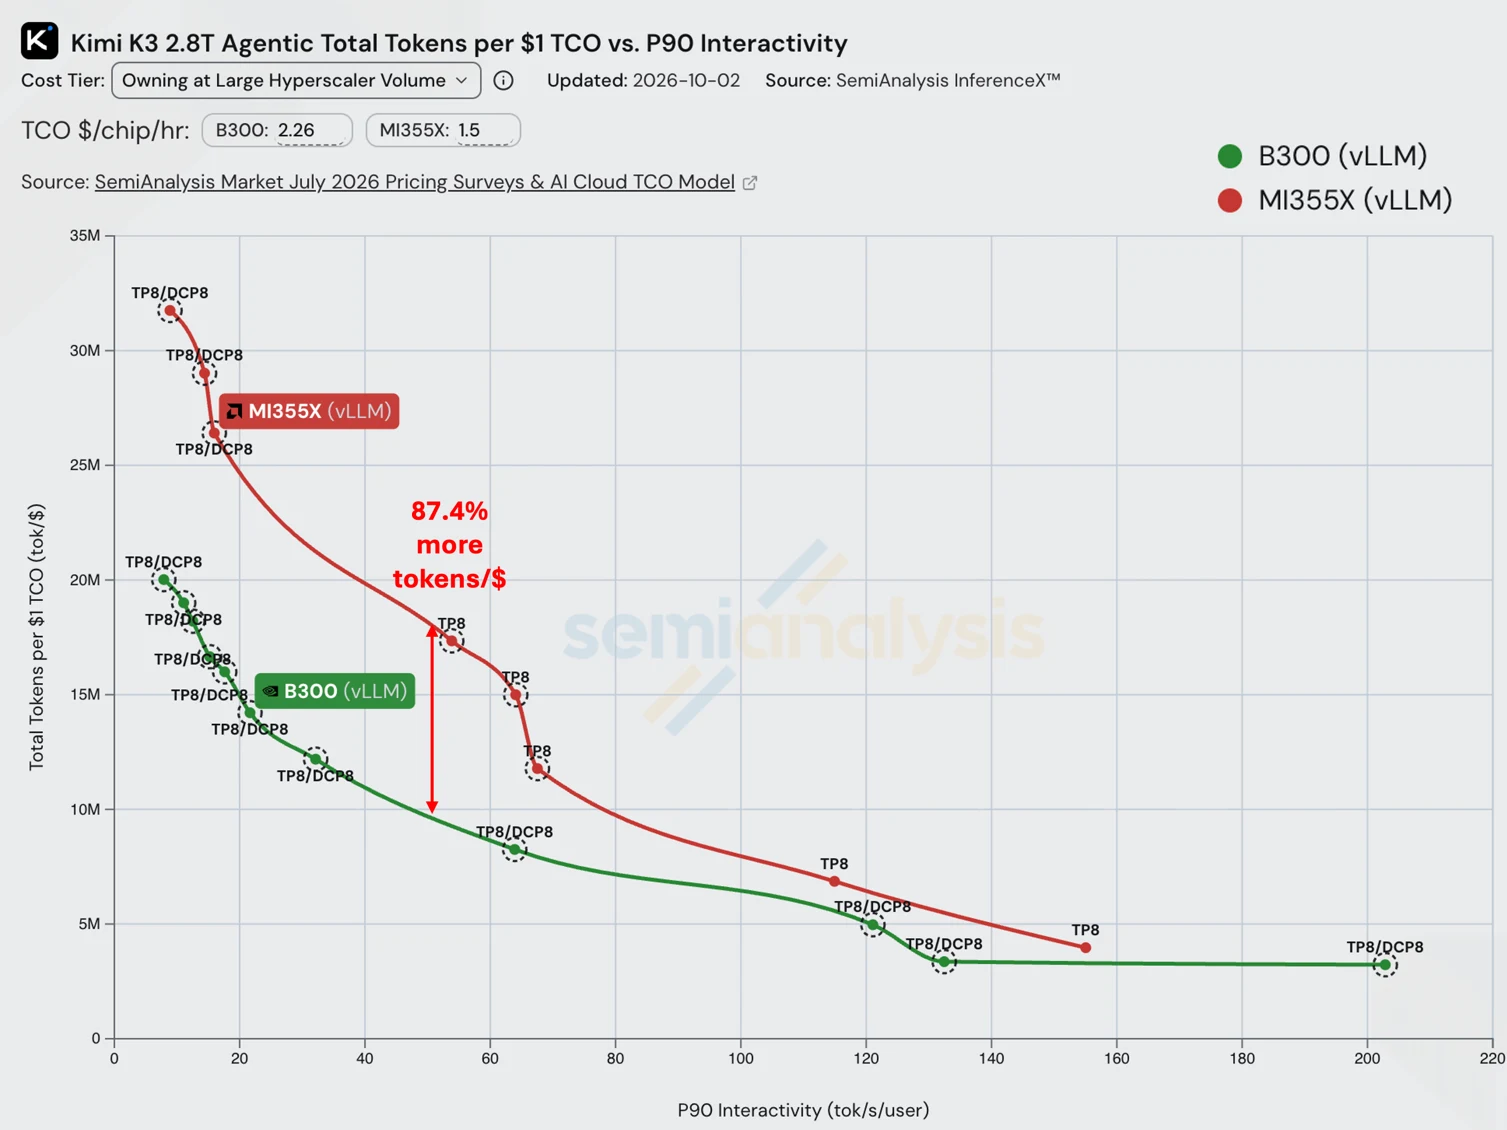
SemiAnalysis InferenceX courbes publiques, avec l’objectif de 50 tokens/s/utilisateur annoté. Notes de benchmark.
Les courbes publiques comparent les ensembles complets de services. Les mesures associées à chaque optimisation proviennent de tests distincts et expliquent les mécanismes individuels sous leurs configurations indiquées.
À l'intérieur de Kimi K3 : experts, attention et état récurrent
Un tour d’un agent de retour peut réutiliser la plupart de son préfixe, mais le traitement d’une continuation courte touche encore trois types de données.
Kimi K3 utilise deux types d’attention. Ses 24 couches MLA conservent une histoire compressée de KV qui croît avec la conversation. Une nouvelle requête consulte toujours cette histoire. Ses 69 couches KDA, en revanche, transmettent des matrices d’état à dimensions fixes, les mettant à jour à chaque nouvel token. Configuration du modèle.
Dans les couches MoE, un routage sélectionne des réseaux experts pour transformer chaque token. Leurs poids sont partagés entre les requêtes.
MLA conserve plus de histoire à mesure que la conversation progresse. KDA met à jour un état de dimension fixe ; conserver les points de contrôle antérieurs signifie garder des copies supplémentaires de cet état.
À travers les tours : réutilisation de la mémoire et déchargement (Section 1).
Dans une étape de modèle : projections d’experts, transferts de noyau et programmation MLA/KDA (Sections 2–5).
Choix de la profondeur du brouillon : sortie engagée contre coût du cycle complet (Section 6).
1. Cache : garder l’état de la conversation disponible pour une réutilisation
DCP réduit les historiques dupliqués dans la mémoire GPU ; le transfert sur la CPU préserve l’état réutilisable en dehors d’elle.
DCP : partager l’histoire entre les GPU
Sous TP8, chaque GPU gère 12 des 96 têtes de requête MLA de Kimi K3, mais stocke l’intégralité de l’histoire compressée KV. Le parallélisme de tenseurs divise les têtes sans diviser la mémoire cache.
Avec le parallélisme de contexte de décodage en huit voies (DCP8), chaque GPU stocke un huitième des positions mises en cache. Pendant le décodage, les GPUs échangent des requêtes, calculent en se basant sur leur histoire locale et fusionnent leurs réponses partielles.
Deux GPU illustrent la même partition utilisée par TP8/DCP8. Cette division supplémentaire s’applique à l’histoire de MLA ; l’état de KDA conserve sa partition existante entre les têtes.
Chaque réponse partielle contient des informations de normalisation afin que la fusion puisse évaluer correctement les shards. #51705 étend le chemin AITER DCP de ROCm à la vérification multi-token.
Pour une conversation de 142 000 tokens, le poids de données estimé est de 24 couches × 142 000 positions × 576 octets FP8 ≈ 1,96 GB par GPU. Le DCP8 réduit cela à environ 245 MB, avant l’overhead d’allocation. Chaque GPU traite huit fois plus de têtes avec un huitième de l’histoire, ce qui laisse l’arithmétique de l’attention principale pratiquement inchangée.
Décharge de la CPU : conserver l’état qui ne peut plus occuper l’HBM
Lorsque l’état ne tient plus dans la mémoire du GPU, l’offre de charge CPU native vLLM du AMD recipe préserve l’histoire MLA et les points de checkpoint KDA dans la DRAM de l’hôte.
Un coup de la cache nécessite des points de reprise correspondants. Si l’historique MLA atteint le token 3 072, mais que le dernier point de contrôle KDA compatible se situe à 2 048, la demande doit reprendre à 2 048 et calculer à nouveau le reste du préfixe.
Un point de résumé utilisable nécessite un état compatible entre toutes les couches requises. Les positions sont illustratives.
Sauvegarder la partie du bloc d’attention ainsi que le point de contrôle du KDA aligne leurs positions de résumé (#54736). Restaurer cet état permet d’éviter une nouvelle computation préfixale via le transfert vers le GPU. Une fois la requête reprise, ses nouveaux tokens peuvent encore faire que plusieurs GPU effectuent le même calcul.
2. MoE : éliminer les tâches dupliquées entre les GPU
Sur un GPU, la projection de sortie de routed-expert renvoie le vecteur complet que son consommateur attend. Dans le chemin original ROCm, une réduction et une normalisation préalables ont donné à toutes les huit GPUs la même entrée latente, et chacune conserve les poids complets. La même projection a donc été exécutée huit fois.
Les coordonnées de sortie peuvent être réparties entre les GPU, mais chaque rang nécessite toujours le résultat complet. Le Kimi K3 dispose déjà d’un all-reduce pour ses parties partagées expertes.
Chaque GPU ajoute uniquement les sorties routées qui lui appartiennent à sa partie partagée d’expertise. L’assemblage all-reduce existant produit le résultat complet, sans aucune nouvelle collecte (#51253). La mise en œuvre avec ROCm s’appuie sur la stratégie correspondante CUDA.
Deux GPU illustrent la propriété du coordonné d’output. Les deux parcours utilisent un algorithme all-reduce existant et renvoient le même résultat complet à chaque GPU.
Chaque coordonnée de sortie reçoit sa contribution routée exactement une fois. Les poids de projection complets restent réplicats.
Le débit de sortie a augmenté de 3,05 à 4,91 % lors du test du PR sur huit GPU AMD Instinct MI355X à TP8, avec une concurrence de 8 à 128, et des requêtes aléatoires de 8K entrée/1K sortie, avec le cache préfixe désactivé.
Libérer la mémoire de la GPU pour conserver plus d’état en cache
Chaque rangne ne calcule désormais que ses coordonnées de projection assignées, tout en conservant les poids complets.
Seule la chargement des lignes utilisées par chaque rangue libère environ 3,85 GiB par GPU sur 92 couches MoE à TP8 (#59591). Le calcul du chemin fusionné reste identique ; l’espace supplémentaire peut contenir l’histoire MLA et les points de sauvegarde KDA.
Cette modification a été appliquée après que l’image utilisée pour le titre a été publiée. L’expérience indépendante d’AgentX a montré que le débit était inférieur à 1 % plus élevé à des concurrences de 32 et 48, mais de 28,9 % à 70, tandis que le taux de réussite du préfixe-cache augmentait de 74,8 % à 80,1 %.
Séparément de #59591 mesures : huit GPU AMD Instinct MI355X, TP8/DCP8, FP8 KV, 30 minutes de charge, sans décharge CPU ni décodage spéculatif. Les points représentent les charges rapportées ; l’incertitude liée aux charges répétées n’a pas été indiquée.
L’avantage plus important à haute concurrence est en accord avec la pression de la mémoire cache. Comparer les deux implémentations avec une capacité de mémoire cache égale permettrait d’isoler cet effet.
Plus de renseignements sur le routage expert et les activations à quatre bits.
3. Trafic de mémoire : fusionner les opérations et éliminer les copies inutiles
Dans chaque GPU, la prochaine étape à examiner est les données transmises entre les noyaux.
Le chemin KDA à un seul token de Kimi K3 a été exécuté avec trois noyaux de calcul et deux copies d’output. La convolution s’est déroulée avant un noyau qui avait déjà fusionné la normalisation Q/K, le déclin et les portes beta, ainsi que l’actualisation récurrente ; la normalisation de l’output a suivi. Le chemin HIP fusionné exécute ces opérations en une seule exécution et écrit directement dans le buffer de destination (#50654).
Les transferts intermédiaires restent sur le chip. L’histoire de la convolution et l’état récurrent sont toujours enregistrés dans la mémoire GPU pour le prochain token.
Décodage du KDA à un seul token, non spéculatif, dans #50654. Avant, on utilise le chemin de normalisation fusionné Triton. Les comptes suivent le code source ; les projections se situent en dehors de la vue. Les lectures et écritures de l’état sauvegardé restent inchangées.
AttnRes mélange les sorties des blocs de couche précédents avec le résidu en cours. En combinant cette mixture avec RMSNorm, la mixture temporaire reste dans les registres (#50593). Le résidu en cours stocké pour les couches ultérieures conserve son arrondi BF16 ; la mixture reste en FP32 après normalisation. Les tests exigent des mises à jour persistantes exactes et permettent des tolérances numériques pour la sortie normalisée.
Avec la fusion de AttnRes, le débit d’écoulement a augmenté de 14,2 % sur huit GPU AMD Instinct MI355X lors du TP8, avec 100 000 requêtes d’entrée/1 000 requêtes de sortie et le stockage en préfixe désactivé. La latence liée au remplissage prolongé est restée pratiquement inchangée.
Copier les entrées uniquement pour les noyaux qui les utilisent
Le dispatcher de multiplication matrice ROCm emballe les entrées avant de choisir un noyau. Lorsqu’il sélectionne le fallback, ce noyau lit l’entrée originale et laisse la copie inutilisée. Transférer l’emballage dans les branches spécialisées élimine ces copies (#58566).
Le profil a rendu les déchets visibles : 69 copies inutiles par étape de décodage, une par couche KDA. Chaque mouvement ne déplace que 1 792 octets, mais cela prend environ 4,8 microsecondes. Agir plus rapidement sur ces octets ne serait guère utile ; l’overhead de lancement domine.
Dans le profil TP8 de la PR, avec concurrence-un, six-draft, 384K-contexte, les copies supprimées représentent 0,339 ms de temps du noyau de copie par étape.
4. MLA : décodage plus rapide de longs contextes avec l’assemblage AMD AITER
Kimi K3 dispose de douze têtes de requête par GPU à TP8. L’ajout de dix-six permet à la compilation d’AMD AITER de décoder les données. Dans le test concernant le long contexte, le temps par token de sortie est passé de 43,8 à 23,6 millisecondes.
La comparaison a utilisé TP8 sans DCP, à concurrence unique. L’adaptateur #50578 copie quatre têtes de requête, les met dans un schéma de seize têtes et enlève leurs sorties. DCP8 présente une forme différente, à 96 têtes.
Cela préserve le fonctionnement du modèle, car chaque tête de requête s’occupe indépendamment des positions mises en cache. L’ajout d’une autre tête ne modifie pas le softmax de la tête originale. Seule la requête est agrandie dans cette voie de décodage ; l’histoire KV compressée stockée reste de même taille.
Une longue conversation demande beaucoup d’attention, mais ce travail doit être réparti sur la GPU. Dans le code historique que nous avons examiné, une approche conservatrice indication de planification a limité le chemin de Gluon un groupe de travail par demandeCe groupe de travail continuait de traiter toute la conversation. Le padding a rendu le chemin d’assemblage d’AMD AITER disponible, avec un politique différente pour diviser l’histoire en morceaux parallèles et combiner les résultats.
Les partitions d’histoire sont des tâches assignées aux groupes de travail au sein d’un GPU. Quatre sont montrées à titre illustratif ; la politique d’assemblage inspectée a sélectionné seize. Le stockage KV reste inchangé.
| Tokens d'entrée / de sortie | Trajet original de Gluon | Chemin d'assemblage avec remplissage |
|---|---|---|
| 1K / 1K | 22.9 ms/token | 22.8 ms/token |
| 32K / 1K | 43.8 ms/token | 23.6 ms/token |
Temps moyen rapporté par PR pour chaque token de sortie : huit GPU AMD Instinct MI355X, TP8, concurrence une, poids du modèle MXFP4, attention BF16 et décodage simple de token unique.
Le cas deentrée courte ne change presque rien ; dans le cas deentrée longue, le temps par token de sortie est presque divisé par deux. Ces mesures de service comprennent la préparation des requêtes et le traitement des sorties.
5. KDA : paralléliser le préremplissage et la vérification spéculative
MLA peut diviser l’histoire conservée entre les groupes de travail. Le KDA pose un problème de planification plus difficile : chaque token dépend du état précédent. Le pré-fill fusionné dans #54038 prépare la transformation combinée de chaque groupe de tokens avant que l’état suivant ne soit connu.
Par exemple, « réduire la taille de l’état et ajouter deux », puis « réduire la taille de l’état et ajouter un » peuvent être combinés en « prendre un quart de l’état initial et ajouter deux ». Cette règle peut être calculée avant l’arrivée de l’état initial.
KDA fait cela grâce à des transformations matricielles. Une lecture ordonnée des résumés de groupe détermine l’état initial de chaque groupe ; les groupes reproduisent ensuite leurs tokens en parallèle. L’ordre des tokens reste intact, mais chaque groupe ne doit plus attendre la reproduction du groupe précédent.
Le regroupement ajoute une deuxième marche et étend le chemin du morceau fusionné de deux démarrages à quatre. Cela aide lorsque peu de séquences ou de têtes exposent trop peu de travail parallèle ; sinon, les passages supplémentaires peuvent coûter plus que ce qu’ils rapportent.
Dans chaque groupe, le parcours récurrent conserve l’état dans les registres du matrice-accumulateur entre les blocs, évitant ainsi une écriture et un rechargement de la mémoire globale. Diagramme de stockage de l’état.
Le Fused KDA affiche une meilleure vitesse d’entrée de 5,3 à 5,6 % par rapport à Triton pour les longueurs d’entrée de 4K et 16K, dans une comparaison distincte sur trois backends : huit GPU AMD Instinct MI355X, TP8, concurrence 32, stockage en préfixe désactivé et sorties à un jeton. Cela mesure l’ensemble du backend. Résultats de benchmark.
Utilisez des tuiles plus petites pour la vérification spéculative
Les lots de vérification courts nécessitent une division différente. Au TP8, chaque GPU dispose de 12 KDA heads avec 128 colonnes de valeur. En divisant chaque head en quatre tiles de 32 colonnes, on ne crée que 48 groupes de travail sur 256 unités de calcul. #58045 passe à des tiles de quatre colonnes, augmentant le nombre de groupes de travail à 384.
Chaque carte possède des colonnes de valeurs différentes et suit la même séquence de tokens dans l’ordre. Les cartes plus étroites augmentent le nombre de groupes de travail indépendants de 48 à 384.
Dans une épreuve distincte de répétition de graphiques sur une GPU AMD Instinct MI355X (dimensions TP8, une seule séquence, quatre positions de vérification), le temps a diminué de 16,20 à 5,61 microsecondes par couche (2,89×). Cela inclut des tuiles plus étroites, des groupes de travail à onde unique, une spécialisation de longueur uniforme et du travail basé sur l’invariance des tokens. Les lots irréguliers conservent un chemin dynamique ; les tests comparent les sorties et l’état récurrent.
6. Décodage spéculatif : choisir le nombre de tokens à générer
Une vérification plus rapide peut modifier le nombre de tokens de proposition à examiner. Le taux utile est le nombre de sorties commitées divisé par le temps total du cycle de révision et de commit.
Par exemple, la référence de acceptation fixe d’AgentX indique que 3,00 tokens engagés attendus par cycle avec trois drafts, et 3,36 avec quatre drafts, y compris les tokens de récupération ou de bonus. Cela représente une augmentation de 12 % dans le nombre de tokens engagés par cycle. Quatre drafts améliorent le débit uniquement si l’ensemble du cycle est inférieur de 12 % à celui avec trois drafts.
Comparaison illustrative sous référence d’acceptation contrôlée. Le seuil de 12 % représente un budget de coûts ; la croissance du cycle complet n’a pas été mesurée ici.
recette publique d’AMD utilise de trois à sept versions de la version finale avec DCP1 et désactive la spéculation aux paramètres de concurrence plus élevés DCP8.
Que faire pour optimiser ensuite
Le travail en cours de remplissage/decodage et de décomposition ajoute une autre source à explorer : l’équilibre des travailleurs et si les transferts se terminent avant que leurs données ne soient nécessaires.
Pour un autre modèle ou charge de travail, commencez par les formes de demande déployées et effectuez trois vérifications :
Comparaison des classements. Plusieurs GPU calculent le même résultat avant qu’une équipe ne puisse le rassembler ?
Suivez les buffers. Chaque tensor temporaire dispose-t-il d’un consommateur sur le chemin sélectionné ? Les données peuvent-elles rester sur le chip ?
Comptage du travail indépendant. Les têtes, les tokens et les tuiles produisent-ils suffisamment de groupes de travail pour répartir la charge ?
Mesurez la demande complète à la vitesse de réponse que vous souhaitez, et vérifiez les deux sorties ainsi que l’état sauvegardé. Un noyau plus rapide est utile lorsqu’il accélère le travail qui retarde le prochain token.
Contributions et remerciements
L’effort sur Kimi K3 comprend plus de 50 PR liés à AMD/ROCm, fusionnés par vLLM provenant d’AMD, d’Embedded LLM et de la communauté en général, ainsi que du développement, de l’intégration, de l’examen et du benchmarking d’AITER. Les contributions couvrent l’attention, la récurrence, le MoE, la quantification, l’exécution graphique, le support à la mémoire cache et l’intégration à la plateforme.
Remerciements spéciaux à : Pin Siang Tan, Jun Kang Chow, Ye Hur Cheong, Hongxia Yang, Seungrok Jung, Bill He, Yichao Zhu, Hyukjoon Lee, Andy Luo, Mrinal Karvir, Richard Li, Sun Peng
Andy Friedrich, Ethan Yang, Tang Rui, Andreas Karatzas, Ankur Singh, Yihua Cheng, Badr Ba Sowid, Benjamin Chislett, Taoyu Zhu, Bill He, Bin Ding, Bowen Bao, Brandon Zhang, Chaemin Lim, Charles Wu, Chuan (Richard) Li, Felix Li, Cameron Quilici, Weishu Deng, Dewei Wang, Divakar Verma, Douglas Lehr, Edwin Lim, Yudong Pan, Elvir Crnčević, Fang Che, Fangzhou Ai, Xingran Fan, Fulu Li, Felix Marty, Canlin Guo, Summer Yang, Haichen Zhang, Yufeng He, Il Liu, Hongxia Yang, Hyukjoon Lee, Yifan Qiao, James E T Smith, Jiahui Cao, Yanyuan Qin, Jonathan Chen, Juntian Liu, Shao-Chun Lee, Kedar Potdar, Kevin H. Luu, Kuan-Fu Liu, Kuntai Du, Kyle Sayers, @lalala-sh, @linnea-lin-00638949, Yinfeng Liu, Lucas Wilkinson, Gabriel Wu, Markus Hartikainen, Maithili Joshi, Jeff (Junze) Ma, Matthew Wong, Misha Va, Micah Williamson, @minmengdie, Matvei Pashkovskii, Mathews Neha, Nicolò Lucchesi, Nick Hill, Nicholas Susanto, Oxana Korzh, Pei Zhang, @ppalanga, Peiran Qin, Qiuyang Yue, Rita Brugarolas, Rebecca Lee, Ryan Rock, Rohan Potdar, @Saddss, Samuel Shen, Sean Filimon, Seungrok Jung, Shantipriya Parida, Shanshan Shen, Shengnan Xu, Simon Danielsson, Siraj Shaikh, Stacy Roberts, Stefan Koncarevic, Asan Stefanski, Minghui Jiang, Tarık Saraç, Tun Jian Tan, Lingpeng Jin, Vansh Bhatia, Maksim Vedenev, Ye Hur Cheong, @wenwzhan, Wei Zhao, Xavier Aguilar, Xiaobing Zhang, Xiaohu Guo, Xin Li, Xudong Lyu, Yanxue Ren, Wentao Ye, Yongqin Wang, Riggins Chen, Chao Hong, Yuchen Shen, Matt Qin, Yichao Zhu, Roger Wang, Zheng Gong, Jiangyun Zhu, Zvi Grinberg, Yongye Zhu.
Notes de benchmark
Servir les configurations aux cibles de comparaison
| P90 interactivité (tokens/s/utilisateur) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 et 50 | Offre de décharge SimpleCPU ; DCP8 / aucun projet en cours vers DCP1 / trois projets en cours | Mooncake offload ; DCP8 |
| 150 | GPU uniquement ; DCP1 ; cinq à sept versions préliminaires | Mooncake offload ; DCP8 |
Les deux systèmes utilisent huit GPU, des poids TP8, FP4 et FP8 KV. Les valeurs sont interpolées au sein de chaque série publiée avec offload ou uniquement GPU, en respectant la même interactivité ; la concurrence, le DCP et la profondeur de rédaction peuvent varier entre les exécutions en bracketing. Les recettes AMD (YAML) et lancement NVIDIA fournissent les étiquettes d’image et les paramètres complets.
Le rejouement utilise le jeu de données cc-traces-weka-062126 et un AIPerf harness pinné, en excluant le warmup et en effectuant une heure de profiling sous curves d’acceptation synthétiques fixes. Les recettes indiquent les paramètres de séance, de démarrage et de warmup. La révision du jeu de données téléchargé n’est pas enregistrée. Le rejouement en boucle fermée peut produire différentes combinaisons de requêtes complétées.
Logiciel et offload. Les submissions utilisent vLLM 36768d1bf (AMD) et 5894fdf98 (NVIDIA). Les budgets de cache hôte configurés sont respectivement de 224,875 et 281 GB par GPU ; les paramètres de connecteur et d’image se trouvent dans les recettes liées.
Coûts. Le modèle de propriété du grand hyperscaler de SemiAnalysis et les constantes de coût des GPU publiées utilisent 1,50 $ par heure de GPU pour l’AMD Instinct MI355X et 2,26 $ pour la NVIDIA HGX B300. Le total de tokens/$ = total de tokens/s/GPU × 3 600 ÷ $/heure de GPU modélisée. Certaines hypothèses de capital et d’utilisation restent inédites. À l’objectif d’interactivité de 50 tokens, la comparaison montre un coût modélisé 46,6 % inférieur par token.
Snapchat. Données d’InferenceX SemiAnalysis obtenues le 9 octobre 2026 ; soumissions datées du 30 septembre 2026 (AMD) et du 16 août 2026 (NVIDIA). Les benchmarks PR utilisent leurs charges de travail indiquées ; #59591 est une expérience distincte après l’image principale.
| Spécification publiée, par GPU | AMD Instinct MI355X | GPU NVIDIA B300 |
|---|---|---|
| Pointe de matrice de faible précision dense | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| Mémoire GPU | 288 GB HBM3E | 288 GB HBM3E |
| Bande de bande mémoire maximale | 8 TB/s | 8 TB/s |
Sources : AMD Instinct MI355X, NVIDIA HGX B300, Spécifications de la mémoire NVIDIA. Détails du benchmark : Méthodologie AgentX.
Note technique : routage expert et précision
Kimi K3 sélectionne 16 des 896 experts par token, de sorte qu’un grand nombre de batches serveurs peut encore laisser quelques lignes par expert. Les tiles d’experts obtenus peuvent contenir du padding.
A4W4 réduit une autre partie du trafic : l’intégration dans #53940 change les activations de huit bits à quatre, tandis que les poids restent à quatre bits. Le trafic total inclut également les sorties intermédiaires BF16 et le padding expert-tile.
Note technique : Précision du KDA et mémoire intégrée
Chaque morceau doit encore résoudre les dépendances entre ses tokens. Le noyau les combine en une transformation que les produits matriciels ultérieurs peuvent appliquer. Cela pose deux questions pratiques : quelle précision est nécessaire pour conserver la réponse, et combien de données temporaires peuvent être stockées sur le chip ?
Un petit exemple illustre l’idée. Remplacez les corrections antérieures par celles ultérieures, et chaque réponse peut être exprimée directement en fonction des entrées connues. Le tableau de coefficients obtenu prend déjà en compte la chaîne de dépendances :
Dans cette illustration scalaire, l’effet de la position un sur la position trois prend deux manières : directement, −1/8 ; ou par l’intermédiaire de la position deux, (−1/4) × (−1/4) = 1/16. Ensemble, ils donnent −1/16, l’entrée située dans la partie inférieure gauche du tableau. Les zéros situés au-dessus de la diagonale indiquent que les positions ultérieures ne peuvent pas influencer les positions précédentes.
Le prologue réel calcule l'inverse de la matrice de dépendance intérieure de 64×64 par bloc. Les produits ultérieurs de la matrice utilisent cette transformation pour tenir compte de ces dépendances.
Les valeurs intermédiaires de l'inverse peuvent augmenter et se annuler. Les rounds trop précoces entraînent la perte d'informations nécessaires pour le résultat final. La mise en œuvre utilise les instructions matrice FP32 natifs d’AMD, en conservant les entrées en FP32 et l’accumulation pour l’inverse sensible. Seule l’inverse complétée est rounded en BF16 pour les produits ultérieurs. Mise en œuvre du noyau.
Pourquoi l’accumulation en FP32 ne peut pas récupérer les entrées arrondies
Considérez la soustraction de 256 de 256,5. Les deux entrées sont exactes en FP32. À cette magnitude, la conversion de 256,5 en BF16 le ramène à 256 :
| Précision de l'entrée | Soustraction effectuée en FP32 | Résultat |
|---|---|---|
| Conservez les entrées FP32 originales | 256.5 − 256 | 0.5 |
| Réduisez les entrées au format BF16 en premier | 256 − 256 | 0 |
La soustraction en FP32 ne peut pas récupérer les informations perdues avant le début. Ces valeurs de jeu illustrent pourquoi l’inverse utilise des instructions matricielles natives 16×16×4 en FP32, conservant à la fois la précision des entrées et celle de l’accumulation.
Un modèle FP4 dépend également d’opérations à une précision plus élevée. Son efficacité dépend de l’efficacité des parcours numériques.
Le prologue dispose également d’un budget de mémoire locale. AMD appelle sa mémoire partagée intégrée LDS. Les tuiles Q et K réutilisent le stockage, car elles sont nécessaires à des moments différents ; l’entrée triangulaire ne stocke que ses dix blocs 16×16 occupés. Le groupe de travail demande 79,5 KiB, ce qui se rapproche de 80 KiB, soit la moitié du budget LDS de 160 KiB de l’unité de calcul AMD CDNA 4 .
Allouement en unités de 1 280 octets. Les KIB supplémentaires illustrés dépassent le seuil de résidence : deux allouements ne suffisent plus. Il s’agit d’un calcul de capacité ; les registres et autres ressources peuvent imposer des limites supplémentaires.
Testez cette limite en réservant suffisamment de LDS inutilisé pour la franchir, tout en maintenant le binaire du noyau constant. Si le temps de exécution ne change presque pas, le travail supplémentaire effectué par le groupe de travail résident est peu significatif pour cette configuration.
État entre les morceaux
Les résumés de groupe et l’état de départ continuent de traverser les frontières du noyau ; les points de vérification demandés et l’état final sont sauvegardés.
Retourner au résultat de service du KDA.
Explications
Les informations présentées dans ce document ont uniquement une fonction d’information et peuvent contenir des erreurs techniques, des omissions et des erreurs de typographie. Les informations contenues dans ce document peuvent changer et pouvoir devenir imprécises pour de nombreuses raisons, notamment les modifications des produits et du plan de développement, les changements de versions des composants et de la carte mère, les nouveaux modèles et/ou produits sortis, les différences entre les différents fabricants, les modifications logicielles, les flashs du BIOS, les mises à niveau du firmware, ou autres facteurs similaires. Tout système informatique présente des risques de vulnérabilités de sécurité qui ne peuvent pas être complètement évités ou atténuées. AMD ne prend aucune obligation de mettre à jour ou de corriger ou de réviser ces informations. Cependant, AMD se réserve le droit de réviser ces informations et de apporter des modifications de temps en temps, sans que AMD ait l’obligation de notifier quiconque de telles révisions ou modifications. Ces informations sont fournies « telles quelles ». AMD ne fait aucune déclaration ni aucune garantie concernant leur contenu et ne assume aucune responsabilité pour les erreurs, défauts ou omissions qui pourraient apparaître dans ces informations. AMD nie spécifiquement toute garantie implicite de non-infraction, de conformité aux besoins du marché ou de adaptabilité à un usage particulier. DANS NÉANT CAS, AMD NE SERA PAS RESPONSABLE AVEC QUELQUELLE PERSONNE POUR TOUT SOIN, DÉRAISONNEL, SPÉCIALE OU AUTRE DOMMAGES CONSÉQUENT SURVENUS EN CARRYANT LES INFORMATIONS ICI PRÉSENTÉES, MÊME SI AMD A ÊTÉ EXPRESSEMENT INFORMÉE DE LA POSSIBILITÉ DE TELS DOMMAGES. AMD, le logo AMD Arrow et leurs combinaisons sont des marques déposées par Advanced Micro Devices, Inc. Les autres noms de produits utilisés dans cette publication ont uniquement pour but d’identifier et peuvent être des marques déposées par leurs sociétés respectives. © 2026 Advanced Micro Devices, Inc. Tous droits réservés.