
Des données en écriture native pour 22 langues, des données romanisées pour douze, et un pipeline réutilisable accéléré par GPU pour la traduction, l'évaluation de la qualité et la réparation.
Auteurs : AI4Bharat — Mohammed Safi Ur Rahman Khan, Mitesh Khapra, Anoop Kunchukuttan. NVIDIA — Niket Agarwal, Raviraj Joshi, Anusha Kamath, Markus Kliegl, Yev Meyer, Sriharsha Niverty, Kiran Praveen, Utkarsh Vaidya.
Nous sommes ravis de présenter Nemotron-pretraining-Indic-v1 environ 2,8 billions de tokens dans 22 langues indiennes, bientôt disponible aux côtés du pipeline ouvert de génération de données accéléré par GPU utilisé pour sa création. Ce sont les 22 langues figurant dans la Constitution de l'Inde : les premières langues de 97 % des Indiens, soit près de 1,2 milliard de citoyens au recensement de 2011. Développé par NVIDIA avec l' IIT Madras, la principale école d'ingénieurs de l'Inde, et son laboratoire AI4Bharat , cette version offre aux développeurs de modèles une nouvelle ressource substantielle pour le pré-entraînement indique. Le pipeline capture la recette complète de génération, y compris les invites, les flux de travail des LLM et les contrôles qualité, afin que les développeurs puissent l'adapter à leurs propres documents sources et générer davantage de données selon leurs besoins.
AI4Bharat, le laboratoire de recherche sur les langues indiennes de l'IIT Madras, construit des ensembles de données et des modèles open source pour les langues indiennes. Ses ressources, telles que Sangraha, un corpus de pré-entraînement ouvert pour 22 langues indiennes, ont contribué à poser les fondations de la recherche ouverte sur les modèles linguistiques indiques. Notre publication conjointe en open source représente une expansion substantielle des données d'entraînement synthétiques indiques ouvertes qui seront disponibles pour la communauté. Elle apporte un large éventail de contenus anglais curatés, incluant des mathématiques, du code et du contenu question-réponse, dans les langues indiennes, offrant ainsi aux équipes davantage de matériel d'entraînement pour construire des modèles capables d'expliquer des concepts techniques, de résoudre des problèmes et de répondre à des questions dans ces langues. Chaque enregistrement remonte à un document source curaté, et chaque sortie est vérifiée par rapport à son entrée, afin que le texte synthétique reste ancré dans des informations réelles.
Mitesh Khapra, qui dirige AI4Bharat et a figuré sur la liste TIME100 AI 2025, a nommé le problème central : la technologie pour les langues indiennes est en retard sur l'anglais parce que « nous n'avons pas assez de données pour les langues indiennes ». Nous répondons à cet appel avec davantage de données, plus une recette ouverte pour en générer encore plus.
Le corpus tient également compte de la manière dont les gens écrivent. Il inclut des données en écriture native pour les 22 langues et du texte romanisé pour douze, couvrant 34 configurations langue-écriture. Nos flux de travail combinent la traduction au niveau du document, l'évaluation de la qualité et la réparation ciblée, avec des contrôles pour préserver les contenus tels que les équations, les tableaux et le code. Ces données complètent le texte indique rédigé naturellement, qui reste essentiel pour les connaissances locales et le contexte culturel.
Nous partageons la recette de génération ouverte afin que la communauté puisse non seulement reproduire les données, mais aussi aller plus loin dans ce travail. Les équipes peuvent utiliser le corpus directement, adapter les invites et les contrôles qualité, ou apporter leurs propres documents sources au flux de travail. En ouvrant à la fois les données et le processus, nous visons à rendre la génération de données indiques à grande échelle plus accessible et à permettre à davantage de développeurs de contribuer à des modèles plus performants dans les langues indiennes.
Le pré-entraînement continu de Nemotron 3.5 Super VL a ajouté 10 milliards de tokens indiques, issus d'un sous-ensemble de douze langues de ce corpus et de textes indiques naturels. Notre rapport technique sur le modèle couvre l'histoire complète. Nous prévoyons de nous appuyer sur ce corpus dans de futurs modèles Nemotron.
Que contient le corpus ?
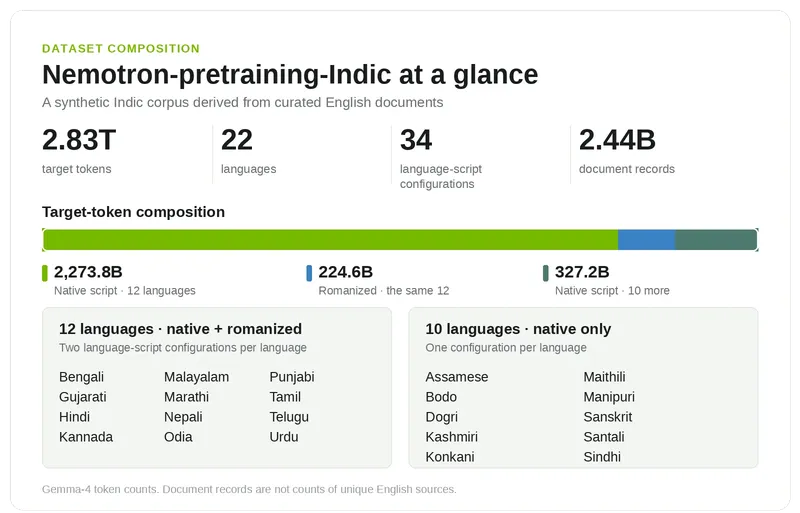
 Figure 1. Le corpus contient 2,601.0 milliard de tokens en écriture native et 224.6 milliard de tokens romanisés. Les décomptes utilisent le tokenizer Gemma-4. Les enregistrements de documents incluent les traductions et les variantes d'écriture de sources partagées ; il ne s'agit pas de décomptes de documents anglais uniques.
Le corpus comporte deux groupes de configurations linguistiques :
- Données en écriture originale et données romanisées : bengali, gujarati, hindi, kannada, malayalam, marathi, népali, odia, pendjabi, tamoul, télougou et ourdou.
- Données en écriture originale : assamais, bodo, dogri, cachemiri, konkani, maithili, manipuri, sanskrit, santali et sindhi.
Ici, écriture originale décrit le système d'écriture : le texte reste traduit de l'anglais. Romanisé signifie un texte en langue indienne écrit en alphabet latin, et non une traduction anglaise. Pour chacune des douze langues à double écriture, la romanisation couvre un sous-ensemble des traductions acceptées en écriture originale.
Cette distinction compte lors de la construction d'un mélange d'entraînement. Les enregistrements natifs et romanisés offrent une exposition différente aux écritures, mais peuvent exprimer le même contenu sous-jacent. Les décomptes de tokens décrivent le corpus conservé, y compris les réécritures acceptées, et non le budget de tokens d'une exécution d'entraînement. Les décomptes dépendent également du tokenizer utilisé, de sorte que l'inventaire du corpus et les décomptes de tokens d'entraînement doivent être lus séparément.
Des documents sources en anglais vers des données d'entraînement indicques
Pour construire ce corpus, nous partons de documents provenant de 15 Nemotron-CC-v2 sous-ensembles, couvrant du texte web, du matériel question-réponse, des mathématiques, du code et d'autres contenus spécialisés. Nous utilisons NeMo Data Designer, le framework open source de NVIDIA pour la génération de données synthétiques, afin d'exécuter la traduction, les contrôles qualité et les réparations ciblées. Tout au long du flux de travail, nous conservons chaque identifiant source afin que les développeurs puissent remonter d'une sortie jusqu'à son document d'origine. Une provenance claire de ce type fait partie de ce qui rend les données ouvertes pratiques à auditer et sur lesquelles construire. La figure 2 montre le flux de travail pour douze langues.
 Figure 2. Pipeline de données synthétiques indicques en quatre étapes pour douze langues, implémenté à l'aide de NeMo Data Designer et de Gemma-4-31B-it. Nous traduisons des documents en anglais, évaluons la qualité des traductions, réparons les sorties à faible score et convertissons un sous-ensemble des traductions acceptées en écriture latine. Les dix autres langues utilisent le flux de travail Indic Translate distinct décrit ci-dessous.
Le flux de travail en douze langues
Pour ces douze langues, nous traduisons les documents dans leur intégralité afin que le modèle puisse utiliser le contexte à travers les paragraphes, les tableaux et les équations. Nous avons sélectionné Gemma-4-31B-it en comparant des modèles sur des documents complets, en vérifiant la qualité de la traduction et la préservation du contenu technique. Nos invites distinguent la prose à traduire du contenu à préserver, y compris le code, les équations, les URL et le formatage.
Après la traduction, nous utilisons le même modèle pour évaluer chaque sortie par rapport à sa source anglaise. Une grille inspirée de Multidimensional Quality Metrics (MQM), un framework ouvert pour classer les erreurs de traduction par type et par gravité, couvre le sens, la fluidité, la terminologie, le style et le formatage. Nous ne conservons que les sorties obtenant au moins 75 sur 100 (un score de grille, pas un pourcentage d'exactitude). Pour les sorties à score plus faible, nous utilisons les retours de l'évaluation pour guider les réparations, puis nous les réévaluons par rapport au même seuil. Ce processus a permis de récupérer 438,4 milliards de tokens répartis entre les données en écriture native et les données romanisées, déjà inclus dans le total du corpus. Des revues humaines échantillonnées et des tests avec des erreurs délibérément introduites ont aidé à identifier les omissions et l'anglais résiduel, informant les améliorations apportées à nos invites et à nos contrôles.
Les traductions acceptées en écriture native fournissent également le point de départ des données romanisées. Nous convertissons un sous-ensemble en écriture latine et vérifions chaque résultat par rapport à son entrée en écriture native. Cela sépare la traduction de la conversion d'écriture. Dans notre comparaison humaine initiale, cette approche en deux étapes a produit moins d'ajouts hallucinés et moins d'anglais résiduel que la génération directe de texte romanisé à partir de l'anglais.
Le flux de travail en dix langues
Pour les dix autres langues, nous adaptons le flux de travail pour remédier aux problèmes de qualité des longs documents et de stabilité de l'écriture observés lors de nos comparaisons. Nous traduisons avec Indic Translate, un modèle de traduction au niveau du document pour l'anglais et 22 langues indiennes de Bodhan AI, un centre à but non lucratif pour l'IA dans l'éducation incubé à l'IIT Madras. Gemma-4-31B-it évalue ensuite chaque traduction par rapport à sa source anglaise. Pour huit langues, nous conservons l'approche du document entier. Pour les documents santali plus longs, nous traduisons des fenêtres chevauchantes et reconstruisons le document ; pour le manipuri, nous traduisons en écriture bengalie avant de convertir en Meitei Mayek, son écriture native. Ces flux de travail conservent les sorties obtenant au moins 75 sur 100 et produisent uniquement des données en écriture native, sans réécriture basée sur des retours.
Qu'est-ce qui a changé après le continued pretraining indique ?
Le rapport technique de Nemotron 3.5 Super VL compare le checkpoint immédiatement avant le continued pretraining (CPT) indique avec le checkpoint après cette étape. Le budget configuré était de 100 milliards de tokens d'entraînement, dont 10 % (10 milliards de tokens) alloués à un mélange de texte indique synthétique et naturel. Les 90 % restants maintenaient les proportions relatives du mélange d'entraînement précédent.
Les scores ont augmenté sur les cinq benchmarks indiques de connaissances et de raisonnement rapportés : MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy et Indic GSM8K.
 Figure 3. Nemotron 3.5 Super VL avant et après l'étape Indic CPT. Les gains vont de 4,98 à 9,82 points de pourcentage. La comparaison rapporte le changement au cours d'une étape d'entraînement qui combine des données indiques synthétiques et naturelles, plutôt que d'isoler la contribution du corpus synthétique. La couverture linguistique diffère selon le benchmark ; il s'agit de points de contrôle au niveau de l'étape, et non d'une comparaison des versions finales des modèles.
Source : rapport technique Nemotron 3.5 Super VL, Tableau 2. GSM8K exclut l'odia car l'évaluation a dépassé la limite de contexte de service.
Ces gains soutiennent la recette Indic CPT combinant synthétique et naturel, tout en laissant à de futures études le choix du mélange pour d'autres modèles et langues.
Le rapport indique complémentaire examine les mélanges de sources, la taille du pool de données synthétiques et la couverture des écritures en utilisant les données acceptées au premier passage pour le groupe de douze langues. L'évaluation du corpus complet, y compris les réécritures récupérées et les dix autres langues, reste une étape à venir pour ces études contrôlées.
Capacités indiques plus larges dans Nemotron 3.5 Super VL
Au-delà des résultats de l'étape CPT, comment le modèle publié se compare-t-il à la génération précédente ? La figure 4 compare Nemotron 3.5 Super VL avec Nemotron 3 Super sur les performances des tâches indiques et la qualité linguistique. Ces résultats reflètent le pipeline d'entraînement complet du modèle publié, y compris l'Indic CPT et l'entraînement postérieur.
Nemotron 3.5 Super VL obtient des scores plus élevés sur cinq des six benchmarks de tâches présentés, couvrant les connaissances, le raisonnement, les mathématiques, le code et la traduction. Le suivi des instructions sur IFEval 1.5 a baissé de 2,04 points. Le modèle s'améliore également sur les quatre dimensions IndiVibe : l'utilité, la fluidité, la fidélité à la langue et à l'écriture, et la verbosité appropriée. IndiVibe est le benchmark ouvert de Sarvam AI composé de prompts de type assistant en langues indiennes. Ensemble, ces évaluations examinent à la fois ce que le modèle peut faire et la qualité de sa communication dans les langues indiennes.
 Figure 4. Performances des tâches indiques et qualité linguistique à travers les générations de Nemotron Super. À gauche : six benchmarks de tâches. À droite : scores de préférence conditionnelle préliminaires d'IndiVibe, et non des taux de victoire en confrontation directe. Les étiquettes indiquent les changements en points de pourcentage, sauf WMT24++, qui utilise des points chrF. Voir le rapport technique indique complémentaire pour les détails des benchmarks et de l'évaluation.
Commencer à construire
Charger le corpus
Commencez par les langues et les écritures dont votre modèle a besoin, inspectez un échantillon, et consultez la fiche du jeu de données et la licence avant l'entraînement. Les configurations utilisent des balises de langue, d'écriture et de région : par exemple, hi-Deva-IN désigne le hindi en devanagari, tandis que hi-Latn-IN désigne le hindi romanisé.
L'exemple ci-dessous demande l'identifiant du dépôt à partir de la fiche du jeu de données, puis découvre les splits disponibles et diffuse un échantillon en streaming.
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
Hugging Face Datasets prend en charge le streaming afin que les lecteurs puissent inspecter les enregistrements sans télécharger tout le corpus. Une fois la version disponible, fixez une révision du jeu de données pour des expériences reproductibles.
Pour une première étude d'entraînement, comparez des mélanges à budget de tokens fixe et enregistrez les parts naturel/synthétique et natif/romanisé. Suivez les résultats par langue ainsi que la rétention des capacités en anglais et la qualité langue/écriture. Lors de la création de splits de validation, tenez compte des enregistrements issus de la même source à travers les langues et les écritures.
Pour construire une recette plus complète, associez le corpus aux données de post-entraînement Nemotron, telles que les collections Chat & Instruction ou Post-Training Blends . Pour des données synthétiques spécifiques à l'Inde, alimentez NeMo Data Designer avec Nemotron-Personas-India, des personas synthétiques en anglais et en hindi ancrés dans des distributions réelles pour l'Inde.
Adapter la recette de génération
Le plugin open-source Nemotron Bharat translation plugin pour NeMo Data Designer fournit des prompts de traduction et d'évaluation, une réécriture facultative basée sur le retour d'information, le fenêtrage de documents et la prise en charge du remapping de script. Utilisez sa référence de configuration pour choisir les modèles et les langues, adapter les prompts à votre domaine et définir les paramètres de réécriture. La note développeur accompagnatrice explique le flux de travail et les choix d'ingénierie.
Commencez avec un petit échantillon de vos propres documents sources. Inspectez la qualité de la traduction et la préservation du code, des mathématiques et de la mise en forme, puis affinez les prompts et les vérifications avec des relecteurs de langue maternelle avant de passer à l'échelle. Traitez la génération et l'acceptation du corpus comme des étapes distinctes : le plugin renvoie des candidats et des scores, tandis que votre politique de filtrage détermine quels enregistrements entrent dans le corpus d'entraînement.
Portée et limites
La traduction élargit l'accès au matériel source, mais ne remplace pas les textes rédigés à l'origine en langues indiennes et ne garantit pas la couverture des savoirs et de la culture locaux. Nous recommandons de combiner ce corpus avec du texte indien naturel provenant de sources appropriées et d'évaluer le mélange obtenu pour le cas d'usage visé.
L'évaluation de la qualité est principalement automatisée, complétée par une relecture humaine par échantillonnage dont la couverture varie selon les langues. Pour le flux de travail à douze langues (Figure 2), le traducteur sert également de juge. Le texte retenu peut encore contenir des erreurs, et le flux de travail à dix langues nécessite une validation plus large par des locuteurs natifs. Les vérifications de Source-ID éliminent les doublons de traitement ; il ne s'agit pas d'une déduplication sémantique des contenus similaires.
En parallèle du corpus, AI4Bharat à l'IIT Madras, avec le soutien de NVIDIA, construit Indic-LLM-Eval-Suite, une collection ouverte et évolutive de benchmarks pour les capacités des modèles indiens. Elle aide les créateurs de modèles à évaluer à la fois la performance des tâches et la qualité linguistique. Voir le blog associé, Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Explorez les configurations de langues, testez un mélange d'entraînement ou adaptez la recette ouverte à un nouveau domaine. Le partage des résultats par langue et des améliorations du flux de génération peut aider la communauté à s'appuyer sur ce travail.
Lectures complémentaires et remerciements
Les rapports associés, Scaling Synthetic Pre-training Data and Evaluation for Indic LLMs et le Nemotron 3.5 Super VL et le rapport technique Lightning, fournissent la comptabilité du corpus, les méthodes de génération, les expériences et les détails de l'évaluation. L'évaluation est l'autre moitié de ce travail. Pour la partie benchmark, voir le blog associé d'AI4Bharat et NVIDIA, Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Ce travail réunit NVIDIA, l'IIT Madras, AI4Bharat et Bodhan AI. Nous remercions également les contributions de modèles et d'outils utilisées dans le pipeline : Gemma de Google, Indic Translate de Bodhan AI et NeMo Data Designer. Des ressources de données NVIDIA supplémentaires sont disponibles dans la collection Nemotron Pre-Training Datasets.