
Beam de Reflection est disponible sur Hugging Face ! C'est le premier modèle du nouveau laboratoire américain, Reflection, et il est ouvert ! C'est un modèle mixture-of-experts (MoEs) de 501B paramètres (23B actifs par token), qui prend le texte en entrée, dispose d'une fenêtre de contexte de 1M tokens, et est publié sous licence Apache 2.0.
Beam est axé sur des cas d'usage de codage et agentiques . Il s'adresse aux équipes qui veulent un modèle à l'échelle de pointe sur leur propre matériel, infrastructure ou cloud, et qui souhaitent le personnaliser selon leurs propres cas d'usage. Beam est livré avec son propre harness open source dédié basé sur Rust qui délivre les meilleures performances du modèle.
Beam dispose d'une implémentation native dans transformers, ainsi que dans des bibliothèques en aval comme vLLM et SGLang. Nous avons travaillé avec l'équipe de Reflection pour vous apporter des recettes d'inférence, de SFT (fine tuning supervisé) et de RL (apprentissage par renforcement) afin que vous puissiez construire avec ce modèle selon vos besoins. En plus du support day-0 dans transformers, SGLang et vLLM, cet article vous montre comment l'exécuter, comment le post-entraîner et ce que nous avons construit avec lui.
TL;DR
- LLM MoEs de 501B paramètres avec 23B actifs par token. 52 couches, 256 experts par couche MoE, 8 routés par token.
- Texte en entrée, texte en sortie avec une fenêtre de contexte de 1M tokens.
- Formats de checkpoint : BF16, FP8, et NVFP4
- Raisonnement qui peut rester en contexte à travers les tours (
preserve_thinking), appel d'outils avec une grammaire dédiée. Le modèle prend en charge cinq valeurs de raisonnement : "low", "medium" (par défaut), "high", "xhigh" et "max".- Template de réponse dans le tokenizer.
- Modèle drafteur pour décodage spéculatif avec DFlash2
- Bibliothèques day-0 : transformers, SGLang, vLLM. RL à paramètres complets avec Miles.
- Livré avec un harness personnalisé basé sur Rust.
- Apache 2.0.
Construire avec Beam
Reflection va distribuer 10,000 $ de crédits Hub aux meilleurs projets utilisant Beam. Tout ce que vous avez à faire, c'est créer quelque chose et le partager sur le Hub :
- Vous pourriez créer une démo qui utilise le modèle Beam sur Spaces
- Vous pourriez le quantifier pour votre matériel préféré
- Vous pourriez générer un jeu de données synthétique pour votre problème préféré
- Vous pourriez construire un environnement RL avec ou pour Beam
- Vous pourriez évaluer Beam (benchmark) et partager les résultats.
- Vous pourriez nous surprendre !
Si vous construisez quelque chose avec Beam, partagez-le sur le Hub pour avoir une chance de gagner 10,000 $. Il vous suffit de créer le space, le modèle ou le dépôt de jeu de données et de le partager sur la page du dépôt du modèle. Nous collecterons tous les liens, sélectionnerons les meilleurs et enverrons les crédits sur vos comptes Hub.
Qu'est-ce que Beam ?
Beam est un modèle uniquement textuel conçu pour le raisonnement à long contexte (longueur de contexte de 1M) et le travail agentique. C'est un modèle MoE épars, où chaque token est calculé par une petite fraction du réseau, si bien qu'il fonctionne à la vitesse d'un modèle bien plus petit tout en conservant la capacité d'un grand modèle.
Attention
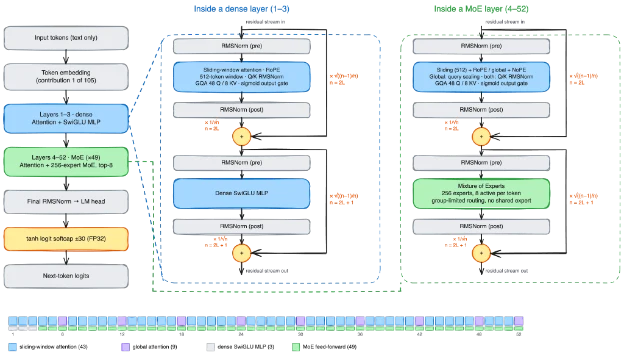
Le décodeur compte 52 couches avec une taille cachée de 5,120. La plupart des couches utilisent une attention à fenêtre glissante sur les 512 tokens précédents ; une couche sur six, ainsi que la dernière, portent leur attention sur l'intégralité du contexte. Cela donne 43 couches à fenêtre glissante et 9 couches globales.
À l'intérieur du bloc d'attention (les deux types de couches)
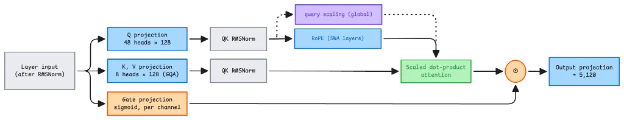
Les deux types de couches gèrent la position différemment. Les couches à fenêtre glissante utilisent RoPE, puisque la position relative compte le plus dans une fenêtre courte. Les couches globales n'utilisent aucun encodage positionnel. À la place, chaque requête est multipliée par un scalaire qui croît lentement avec le nombre de tokens visibles, (1 + (pos + 1) / 2048) ** 0.1. Elle agit comme une température : le softmax conserve sa précision à mesure que le contexte s'allonge au lieu de s'aplanir. L'implémentation appelle cela la mise à l'échelle des requêtes par softmax évolutif (scalable-softmax query scaling).
L'attention utilise une attention par requêtes groupées avec 48 têtes de requête et 8 têtes clé-valeur, avec RMSNorm sur les requêtes et les clés. Une porte sigmoïde apprise, calculée à partir de l'entrée de la couche, met à l'échelle chaque canal de chaque tête avant la projection de sortie.
Mixture of Experts
Les 3 premières couches utilisent un MLP dense SwiGLU. Les 49 autres le remplacent par un bloc Mixture-of-Experts de 256 experts, chacun étant un MLP SwiGLU de taille intermédiaire 2,560, soit environ 39M de paramètres. Les experts détiennent 98.4% des paramètres du modèle.
Le routeur suit le schéma à groupes limités de DeepSeek-V3. Il note les 256 experts avec un sigmoïde, les répartit en 8 groupes de 32, conserve les 4 meilleurs groupes (classés selon la somme des deux meilleurs scores de chaque groupe), puis choisit les 8 meilleurs experts en leur sein. Beam utilise les mêmes tailles de groupes que DeepSeek-V3 mais sans expert partagé. Les sorties des experts sont combinées avec des poids de routeur normalisés et mises à l'échelle par 2.5.
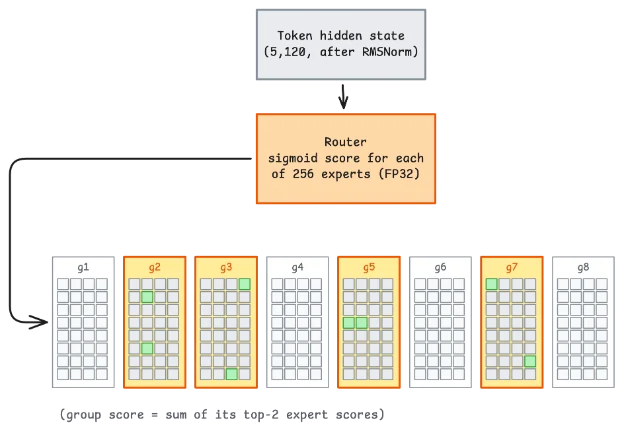
Seuls 8 experts s'exécutent par token, de sorte que le modèle calcule chaque token avec environ 23B de paramètres. Les 256 experts restent tous en mémoire, donc le déploiement nécessite la mémoire d'un modèle de 501B mais tourne à la vitesse d'un modèle de 23B. Le checkpoint BF16 fait environ 1 To au format safetensors. Le checkpoint NVFP4 stocke la plupart des paramètres en précision 4 bits pour les GPU NVIDIA Blackwell, certains paramètres sont conservés en BF16 pour l'exactitude. Il existe également des checkpoints FP8 sur le hub, qui sont idéaux pour les puces des séries Hopper et Ampere.
Si vous souhaitez déployer Beam vous-même, consultez les recettes vLLM ou SGLang ci-dessous.
Flux résiduel
Les connexions résiduelles sont la partie la plus distinctive. Un transformeur standard ajoute chaque sortie de sous-couche au flux avec un poids de 1, de sorte que le flux croît avec la profondeur.
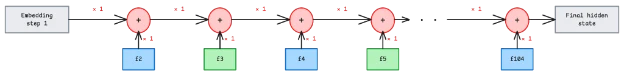
Beam compte l'embedding d'entrée comme l'étape 1. À l'étape k , il ajoute la sortie de la sous-couche avec un poids 1/sqrt(k) et conserve le flux existant avec un poids sqrt((k-1)/k). Les carrés des deux poids somment à un, de sorte que le flux reste à une échelle constante de la première couche à la dernière. Après les 104 additions, chaque sortie de sous-couche et l'embedding d'entrée portent le même poids dans l'état caché final.
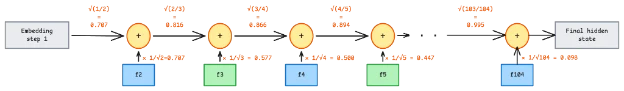
Chaque sous-couche est également normalisée avant et après, et les logits finaux passent par un tanh softcap à ±30, calculé en FP32. L'implémentation fixe les endroits où elle calcule en FP32 : le routeur, le produit SwiGLU, les normes, RoPE, la mise à l'échelle des queries et le softcap.
Contexte long
L'attention hybride fonctionne bien pour les contextes longs. Chaque couche met en cache 2 x 8 têtes KV x 128 dimensions = 2,048 valeurs par token. Si les 52 couches conservaient chaque token, le cache croîtrait de 208 KiB par token. Seules les 9 couches globales conservent toute la séquence. Les 43 couches à fenêtre glissante détiennent une fenêtre fixe de 512 tokens chacune et cessent de croître. Ainsi, le cache croît de 36 KiB par token, soit environ un sixième du taux naïf.
| Contexte | Si les 52 couches étaient globales | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| Contexte complet (1M) | 208 GiB | 36.08 GiB |
Ces chiffres sont par séquence, en BF16, avec le cache dynamique de transformers.
Résultats des benchmarks
Voici les résultats des benchmarks à différents niveaux de précision, tels que fournis par l'équipe de Reflection.
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| Codage agentique / Terminal | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| Raisonnement | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE (sans outils) | 36.0% | 36.0% | 34.8% |
| HLE (avec outils) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| Appel d'outils / Recherche | |||
| AutomationBench - split public uniquement | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| BrowseComp avec gestion du contexte | 76.8% | 76.7% | 75.6% |
| DeepSearchQA avec gestion du contexte | 80.5% | 79.6% | 81.1% |
| Capacités générales | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience (index) - split public uniquement | 10.8 | 8.8 | 9.8 |
Configuration matérielle requise
La manière la plus pratique de servir le modèle est de servir le checkpoint NVFP4, qui conserve l'essentiel de la qualité du checkpoint bf16. NVFP4 stocke certains poids en 4 bits, réduisant ainsi les 501B paramètres en BF16 de 1 TB à environ 280 GB. Les GPU Blackwell exécutent nativement le NVFP4, mais les GPU plus anciens que Blackwell, comme le H200, ne le peuvent pas. Les checkpoints FP8 conviennent aux GPU plus anciens que Blackwell.
Un B200 dispose de 180 GB de HBM3e, donc deux d'entre eux (360 GB) peuvent contenir les poids de Beam, laissant peu de place pour les activations et le cache KV. Prévoyez quatre B200 (720 GB), ce qui laisse largement la place pour des contextes longs et des requêtes concurrentes. Vous pouvez aussi le servir sur un nœud complet 8xB200, ou sur deux B300 de 288 GB chacun, ou même sur 8xRTX Pro 6000. Si vous ne disposez pas de matériel Blackwell, utilisez Inference Providers (serverless) pour tester Reflection.
Prise en charge de l'inférence
Beam bénéficie d'une prise en charge dès le jour 0 dans transformers, SGLang et vLLM.
Transformers
Installez la dernière version de transformers.
pip install -U "transformers>=5.20.1"
La manière la plus simple d'exécuter Beam est le pipeline text-generation :
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
Le pipeline renvoie l'ensemble du chat. Le dernier message est la réponse de Beam, déjà analysée par le template de réponse.
En descendant d'un niveau, utilisez AutoModelForCausalLM et AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
Chat
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Le tokenizer de Beam embarque un modèle de réponse. parse_response le lit et transforme la sortie brute en dictionnaire de message, avec le raisonnement, la réponse et les éventuels appels d'outils dans des champs séparés. Cela évite les regex habituelles pour séparer le raisonnement des réponses et des appels d'outils. Et les règles sont livrées avec le tokenizer, de sorte que la structure analysée correspond à ce que Beam a été entraîné à produire. Le modèle de chat peut pré-écrire une partie du tour de l'assistant, que le parseur doit voir.
Appels d'outils
Exemple complet d'appel d'outilsdef get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
Passez tools à parse_response également. Beam écrit les arguments des appels d'outils en ligne, dans sa propre grammaire de style XML, de sorte qu'un simple 7 peut être un nombre ou une chaîne. Avec les schémas des outils, le parseur convertit chaque argument vers son type déclaré.
Multi-GPU et multi-nœud
La config de Beam définit un plan d'expert-parallelisme. Le parallélisme d'experts place chaque expert sur un seul appareil. L'attention, les couches denses, les embeddings et la tête LM sont répliqués sur chaque appareil. Cela représente 8B de paramètres, soit 16 Go en BF16. Chargez le modèle avec un DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
Lancez le script avec torchrun sur 16 GPU H200. Chacun contient alors 78 Go de poids. Avec 8 GPU, chacun devrait contenir 139 Go, ce qui ne laisse aucune place sur un H200 de 141 Go. Le nombre de périphériques doit diviser le nombre d'experts, 256.
vLLM
Beam bénéficie d'un support dès le jour 0 dans vLLM. La commande ci-dessous sert le checkpoint BF16 avec du parallélisme de tenseurs sur 16 GPU (deux nœuds 8x H200) et expose une API compatible OpenAI :
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
Pour une génération plus rapide, ajoutez le décodage spéculatif DFlash2. Un petit modèle de brouillon propose jusqu'à 15 tokens en avance, et Beam les vérifie tous en une seule passe avant, de sorte que chaque étape peut accepter plusieurs tokens. Le coût est un peu de mémoire supplémentaire pour le brouillon :
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
Les deux commandes démarrent un serveur compatible OpenAI, vous pouvez donc pointer n'importe quel client OpenAI vers http://localhost:8000/v1. Pour des configurations de service supplémentaires, consultez la recette Beam proposée pour vLLM.
SGLang
Beam bénéficie également d'un support dès le jour 0 dans SGLang. Nous recommandons de le servir avec le décodage spéculatif DFlash2, que les deux commandes ci-dessous activent. Sur Blackwell, le checkpoint NVFP4 tient sur 4 B300 :
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Sur les GPU Hopper, utilisez plutôt le checkpoint FP8 sur 8 H200. Seuls trois drapeaux changent : le checkpoint, la taille du parallélisme de tenseurs (8 au lieu de 4) et le backend d'attention (fa3 au lieu de trtllm_mha, qui nécessite Blackwell) :
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Fournisseurs d'inférence
Beam est disponible sur Hugging Face Inference Providers, propulsé par Baseten, Fireworks et Together, avec d'autres à suivre prochainement.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
Inference Endpoints
Nous avons mis en place une recette Beam pour un déploiement en un clic dans Inference Endpoints depuis le catalogue en FP8 ou NVFP4, ou installez avec le hf cli comme ceci :
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
Ce que nous avons testé
Nous partageons quelques vibe evals de Reflection Beam-501B-A23B sur cinq tâches, chacune exécutée une fois avec un effort de raisonnement faible et une fois avec un effort de raisonnement élevé via la plateforme Reflection. Ce sont des vibe evals, pas des benchmarks. Si vous envisagez d'utiliser Beam, c'est un excellent moyen d'essayer le produit et de voir comment il se comporte sur des cas d'usage spécifiques et, surtout, où il gagne et où il perd.
Vous trouverez ci-dessous un aperçu des prompts que nous avons exécutés et des traces de sortie du hub. Les entrées complètes, les sorties, l'utilisation de l'API, les fixtures de tâches, les évaluateurs et les traces de conversation se trouvent dans ce bucket public Hugging Face.
| Catégorie | Description du prompt | Raisonnement faible (tokens) | Raisonnement élevé (tokens) |
|---|---|---|---|
| Appel d'outils en plusieurs étapes | Traiter la commande ORD-742 : comparer les stocks, les réservations, les surcharges et les dates d'arrivée ; réserver l'entrepôt éligible le moins cher. | ✅ 544 | ✅ 811 |
| Récupération sur un contexte long dans une base de code | Dériver la configuration de commandes Click et deux résultats d'invocation à partir de trois fichiers sources complets ; citer six symboles d'implémentation. | 🔴 1,613 * | ✅ 5,007 |
| Tâche dans un terminal au sein d'un bac à sable | Inspectez et réparez une CLI de registre CSV ; corrigez tous les bugs, conservez les tests, exécutez les tests et une vérification de la CLI. | ✅ 582 | ✅ 1,548 |
| Raisonnement mathématique (style AIME) | Combien de sous-ensembles à huit éléments de {1, …, 16} ont une somme divisible par 17 ? Justifiez votre réponse. | 🟠 829 † | ✅ 2,809 |
| Sortie structurée | Convertissez un journal de révisions désordonné en JSON strict : fusionner les correctifs, annulations, valeurs nulles, dates, devises et totaux. | ✅ 1,040 | ✅ 2,088 |
* La réponse en contexte long de Low a obtenu tous les comportements du code et les six citations sources correctes. Cependant, la réponse ne correspondait pas au format des analyseurs, c'est donc en partie une ambiguïté du prompt.
† Low a donné la bonne réponse, mais a omis la justification demandée. High a fourni une preuve correcte avec les racines de l'unité, revue de manière indépendante.
Ne vous fiez pas seulement à notre parole. Plongez dans le bucket, réécrivez-le pour votre cas d'usage ou projet et poussez Beam à ses limites.
Post-entraînement de Beam
Vous pouvez affiner Beam pour vos propres cas d'usage. Ici, nous partageons quelques exemples dans TRL et Miles pour vous lancer dans l'affinage supervisé et l'apprentissage par renforcement.
SFT avec TRL
La manière la plus rapide d'adapter Beam à vos propres données est l'affinage supervisé avec le SFTTrainer de TRL. Pour garder une mémoire gérable, nous entraînons des adaptateurs LoRA avec PEFT plutôt que de mettre à jour les 501B paramètres :
Nous avons utilisé SFTTrainer de TRL pour adapter Beam à un objectif simple : garder son raisonnement dans la langue demandée par l'utilisateur. Nous avons affiné sur Multilingual-Thinking avec LoRA, qui entraîne un petit ensemble de poids d'adaptateurs tout en gardant le modèle de base figé.
La configuration combine le sharding du modèle au chargement, le parallélisme d'experts, FlashAttention 4 et le packing de séquences. Le SFT LoRA tient sur un seul nœud avec 8 GPU B300, atteignant environ 19,000 jetons par seconde. La configuration H100 équivalente utilise quatre nœuds.
Après une époque de Multilingual-Thinking, Beam a raisonné dans la langue demandée sur 16 prompts retenus sur 16, contre 3 sur 16 pour le modèle de base. Cette petite évaluation mesure l'adhérence à la langue, plutôt que la justesse du raisonnement lui-même.
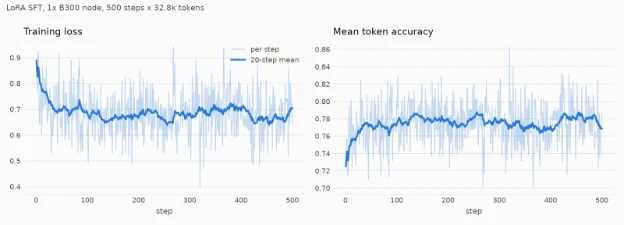
Perte d'entraînement (à gauche) et précision moyenne par jeton (à droite) lors d'une exécution séparée de 500 étapes sur un sous-ensemble de raisonnement d'open-r1/Mixture-of-Thought, en utilisant un seul nœud B300 à 8 GPU. Ces métriques d'entraînement proviennent du billet officiel Exemple PR TRL.
GRPO avec Miles
Reflection et RadixArk ont construit une recette qui entraîne le modèle avec GRPO dans Miles, en BF16. Vous pouvez mettre à jour le modèle complet ou utiliser LoRA pour entraîner des adaptateurs tout en gardant les poids de base figés. Megatron entraîne, SGLang génère les rollouts, et Miles publie les nouveaux poids vers les moteurs de rollout après chaque mise à jour. Nous avons examiné la recette.
| Charge de travail | Configuration de référence |
|---|---|
| Inférence / éval, BF16 | 16x H200 par moteur |
| GRPO en paramètres complets, BF16 (Miles) | 96x H200 : 64 en entraînement, 32 en rollout. Ou 64x H200 en colocalisation. |
| GRPO LoRA, BF16 (Miles) | 32x H200 : 16 en entraînement, 16 en rollout. |
| GRPO en paramètres complets, BF16, contexte de 128 jetons (Miles) | 48x H200 : 32 pour l'entraînement, 16 pour le rollout. La configuration a d'abord été validée par Reflection et RadixArk sur le vrai checkpoint. |
La recette exécute GRPO sur DAPO-Math-17K et évalue sur AIME25. Construisez l'image, téléchargez les données, puis soumettez le job à un cluster Ray de douze nœuds 8x H200 :
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Ce qui se passe lors d'un rollout :
Exemple : 32 prompts sont passés au modèle avec 8 réponses chacun. Deux moteurs SGLang servent les rollouts sur 16 GPU chacun.
Score : la réponse encadrée est comparée à l'étiquette, avec une pénalité douce pour les réponses proches de la limite de longueur.
Mise à jour : une étape d'optimiseur sur les 256 échantillons. Avantages relatifs au groupe avec importance sampling tronqué, sans pénalité KL ni d'entropie.
Entraînement en parallèle : parallélisme de tenseurs 8, parallélisme d'experts 8, parallélisme de données 8, avec parallélisme de séquence et recompute complet.
Optimiseur : Adam à un taux constant de 1e-6. Gradients en BF16, poids maître en FP32, moments en BF16. L'état de l'optimiseur transite par le NVMe local du nœud, donc chaque nœud d'entraînement a besoin de 2 TB d'espace temporaire.
Évaluation : AIME25 tous les cinq rollouts, huit échantillons par problème. Un checkpoint est sauvegardé tous les vingt.
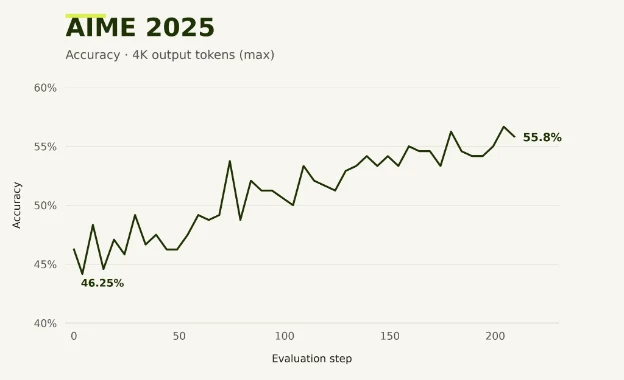
Le rollout suivant est généré pendant que le courant s'entraîne, donc les réponses ont une mise à jour de retard. Ajoutez --resume pour reprendre depuis le dernier checkpoint. execute-colocate exécute la même recette sur huit nœuds, chaque GPU s'entraînant et servant à tour de rôle.
Entraîner avec LoRA
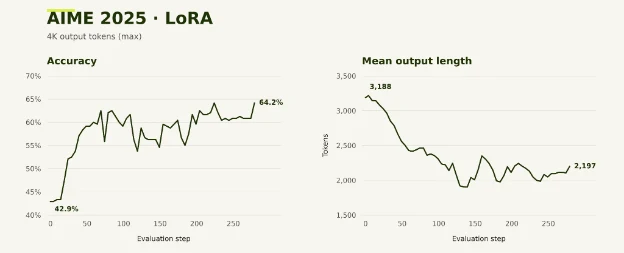
Vous pouvez aussi exécuter GRPO avec LoRA sur quatre nœuds 8× H200 : 16 GPU pour l'entraînement et 16 pour les rollouts. La recette entraîne des adaptateurs de rang 16 sur les couches d'attention, de MLP dense et d'experts de Beam, tout en gardant les poids de base gelés. Seuls les poids des adaptateurs sont synchronisés avec SGLang, et l'état de l'optimiseur reste dans la mémoire GPU, supprimant le besoin de déchargement NVMe de l'optimiseur.
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Construire avec Beam : Démos
Si vous construisez quelque chose avec Beam, partagez-le sur le Hub pour tenter de gagner 10,000 $. Il vous suffit de créer un espace, un dépôt de modèle ou de jeu de données et de le partager sur la page du dépôt du modèle. Pour vous inspirer, voici quelques choses que nous avons construites.
Hey Beam, construis une application locale native MacOS !
Chez Hugging Face, nous adorons les modèles ouverts et locaux qui tournent nativement sur leur matériel, mais créer des applications natives sur Mac peut être difficile ! Voyons si Beam peut nous aider.
Nous avons demandé à Beam de construire une application MacOS native qui convertit la parole en texte et la dépose commodément à l'emplacement de votre curseur. Nous voulons utiliser MLX pour tirer le meilleur parti de notre Mac Metal et le modèle Parakeet pour une excellente conversion parole-texte.
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
Nous avons utilisé Beam avec le harnais de codage Pi pour construire l'application initiale native dans la barre de menus macOS, exécutant Parakeet avec MLX. L'exécution sauvegardée inclut les invites de suivi ; le code source final inclut également des réparations Codex ultérieures. L'invite ci-dessus est une version condensée des exigences de construction.
Vous pouvez consulter la trace de l'agent montrant comment Beam a construit cela dans pi dans cette trace. Si vous voulez essayer la démo, téléchargez le code source ou lisez les instructions de configuration.
Hey Beam, comment passes-tu à l'échelle avec plusieurs agents ?
Nous voulions voir si Beam pouvait progresser plus vite en répartissant une tâche de programmation entre plusieurs agents. Nous avons associé Beam à l'agent de codage open-source Pi et comparé trois configurations : 1. un agent travaillant seul, 2. cinq pairs persistants collaborant via un dépôt Git partagé, et 3. un agent leader déléguant le travail à des sous-agents asynchrones. Le harnais tournait sur Hugging Face jobs avec l'inférence via l'API de la plateforme de Reflection.
Pour les tâches, nous avons utilisé ProgramBench : les agents doivent recréer un programme à partir de son exécutable compilé et de sa documentation, sans voir son code source ni les tests de l'évaluateur. Chaque configuration avait le même plafond de 8M de jetons API et une limite de résolution de deux heures par tâche, partagés entre ses agents. Nous avons sauvegardé des instantanés d'implémentation et les avons évalués contre des suites fixes de tests cachés issus du jeu de données ProgramBench-Tests.
Notre graphique score versus latence montre la fraction moyenne de tests réussis. L'axe temporel utilise des taux de référence fixes pour les jetons du modèle plus le temps d'outil mesuré, plutôt que le temps réel écoulé. Nous avons initialement exécuté cinq tâches. La figure actuelle montre un sous-ensemble a posteriori de jq, xsv, FIGlet et hexyl ; ripgrep a été exclu pour les trois configurations car l'évaluation de ses artefacts sauvegardés était trop lente. Les résultats publiés conservent les 15 épisodes originaux.
Vous pouvez inspecter les exécutions dans le tableau de bord Trackio, explorer les données des résultats publiés, et réutiliser le harnais d'étude.
Hey Beam, fine-tune un modèle de décision pour ma base de code !
Les modèles de décision sont très à la mode en ce moment parce qu'ils sont ultra rapides et pratiques pour de nombreux cas d'usage. Nous avons commencé avec Beam, puis nous avons continué avec GLM-5.3 dans Pi après épuisement du quota de Beam afin d'entraîner et d'évaluer un modèle de décision personnalisé pour le triage des incidents de développement.
Nous voulions voir si un agent de codage pouvait transformer une politique de triage d'incidents en un petit modèle de décision rapide. La tâche consistait à lire un incident de développement et à choisir l'équipe responsable, sa gravité, et si quelqu'un devait être averti immédiatement. À l'aide d'Unsloth, nous avons affiné Qwen3.5-0.8B pour évaluer directement ces choix.
Tout d'abord, le flux de travail a construit un jeu de données synthétique contenant 2.3k incidents répartis par groupe d'incidents pour l'entraînement, la calibration et le test. Nous avons entraîné un adaptateur LoRA et une tête de décision pendant trois époques, avec un backbone 4-bit, sur un H100 80GB du cluster Slurm Science.
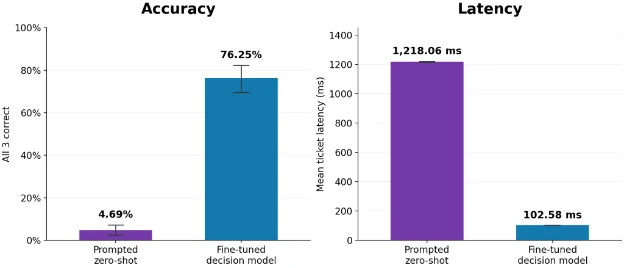
Comme référence, nous avons fourni au modèle non adapté une invite contenant la politique de triage complète et le ticket, sans exemples, et nous lui avons demandé de générer les trois décisions en JSON. Sur les mêmes 320 tickets de test synthétiques, le modèle de décision affiné a obtenu les trois réponses correctes dans 76.25% des cas, contre 4.69% pour le zéro-shot par invite. La latence moyenne par ticket est passée de 1,218.06 ms à 102.58 ms, soit une accélération de 11.9×.
Si vous souhaitez essayer cette expérience vous-même, consultez le compartiment d'artefacts qui contient les données, le code, les points de contrôle et les résultats.
Conclusion
Beam est un modèle ouvert de 501B que vous pouvez exécuter sur votre propre matériel et modifier. Commencez par le point de contrôle BF16 , ou essayez l'une des quantifications FP8, NVFP4. Si vous construisez quelque chose avec Beam, partagez-le dans l'onglet discussions.