
TL;DR : Le Beam de Reflection est un MoE à 501B de paramètres avec 23B de paramètres actifs par token. vLLM le prend en charge dès le jour 0 et l'optimise sur NVIDIA Blackwell :
- Prise en charge complète des fonctionnalités. Le raisonnement, l'appel d'outils et les sorties structurées fonctionnent dès l'installation, et vous pouvez exécuter le modèle avec le parallélisme de tenseurs, de données ou d'experts.
- Optimisation pilotée par des agents. Des agents de codage ont optimisé le modèle de manière autonome, rendant le décodage en batch-1 2,71× plus rapide et le préremplissage 1,87× plus rapide que notre première implémentation.
- DFlash2 avec vérification adaptative. Avec le drafter DFlash2 de Beam, une seule requête atteint 708 tokens/s sur TP8, avec une longueur d'acceptation de 3,7. La vérification adaptative, qui décide à chaque étape combien de tokens de brouillon valent la peine d'être vérifiés, ajoute 10% de débit supplémentaire à forte concurrence.
Pour l'essayer, utilisez notre image Docker vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
Architecture du modèle
Beam est un décodeur MoE de 52 couches avec une taille cachée de 5120. Le routage MoE suit DeepSeek-V3. Les principales différences se trouvent dans les couches d'attention et dans la manière dont le flux résiduel est normalisé.
Figure 1 : la pile de couches de Beam et une couche de décodeur clairsemée. Les marques dorées indiquent les parties qui diffèrent d'un MoE pré-norm standard. Ouvrir en plein écran.
Attention
- Couches hybrides à fenêtre glissante et NoPE. 43 couches utilisent une attention à fenêtre glissante sur les 512 derniers tokens, avec RoPE. Les 9 autres (une couche sur six, plus la dernière) portent leur attention sur l'intégralité du contexte avec aucun encodage positionnel (NoPE).
- SSMax sur les couches NoPE. Sans RoPE, l'attention s'aplatit à mesure que le nombre de clés augmente. SSMax met à l'échelle chaque requête par
(1 + p/2048)^0.1, oùpest la position à partir de 1, de sorte que le softmax se resserre à mesure que le contexte grandit. - GQA avec norme Q/K par tête. 48 têtes de requête, 8 têtes KV, dimension de tête 128. Q et K sont normalisés par RMS pour chaque tête avant RoPE ou SSMax.
- Porte de sortie sigmoïde. Avant
o_proj, la sortie de chaque tête est multipliée par σ(gate + bias), où le gate provient de sa propre projection pleine largeur avec un biais appris par tête. Une tête peut être atténuée ou désactivée token par token. - Petit cache KV. Seules les 9 couches à attention complète conservent le KV pour toute la séquence :
- 9 × 2 × 8 × 128 valeurs par token, soit 36 KiB en BF16 et 18 KiB en FP8.
- Environ 18 GiB de KV FP8 pour un contexte complet de 1M tokens, avant sharding.
MoE et flux résiduel
- MoE de type DeepSeek-V3. 256 experts routés (d_ff 2,560, NVFP4), routés de la même manière que DeepSeek-V3 : des scores sigmoïdes plus un biais de correction sélectionnent les 4 meilleurs groupes d'experts sur 8, puis les 8 meilleurs experts, et les poids renormalisés sont multipliés par 2.5. Contrairement à DeepSeek-V3, il n'y a pas d'expert partagé. Les couches 0–2 utilisent un MLP dense SwiGLU (d_ff 20,480) à la place.
- Routeur FP32. Les poids du routeur 5120 × 256, l'accumulation et les logits sont tous en FP32.
- Norme sandwich. Chaque sous-couche a un RMSNorm avant elle et un autre après elle.
- Résidus mis à l'échelle par la profondeur. Le n-ième ajout résiduel calcule
h ← √((n−1)/n)·h + x/√nau lieu deh + x. Avec des sorties de sous-couche de variance unitaire, le flux résiduel conserve une variance unitaire à chaque profondeur au lieu de croître avec elle.
Optimisation pilotée par des agents
Notre première version de l'implémentation était une version non optimisée, presque entièrement en PyTorch, du modèle. Nous l'avons ensuite optimisée de manière autonome avec des agents de codage : ils ont profilé le modèle, écrit les kernels et évalué chaque modification par benchmark. Sur TP8, les sept modifications ci-dessous ont fait passer le décodage batch-1 de 8.95 ms à 3.30 ms par étape, et un prefill 8 × 2K de 328 ms à 176 ms.
Figure 2 : latence du forward du modèle sur TP8 sur GB200 après chaque modification, pour le décodage batch-1 et un prefill de 8 × 2,048 tokens à ~100K de contexte. Les deux panneaux utilisent des échelles différentes. Affichez le tableau pour les valeurs exactes, ou ouvrez-le en plein écran.
- Norme → résidu → norme fusionnés (−40% en décodage). La post-norme, l'ajout résiduel mis à l'échelle et la pré-norme suivante à chacun des 104 points de jonction de sous-couches s'exécutent désormais comme un seul kernel Triton, avec des calculs FP32 et les points d'arrondi BF16 de la référence.
- Q/K norm, RoPE/SSMax et gate de sortie fusionnés. Le RMSNorm et le RoPE (ou SSMax) par tête Q/K s'exécutent comme un seul kernel, et le gate sigmoïde comme un autre.
- All-reduce fusionné dans les normes. Les deux all-reduce TP de chaque couche s'exécutent dans le kernel de norme, construit sur l'all-reduce multicast de FlashInfer. Après le MoE, le même kernel combine également les sorties des 8 meilleurs experts.
- Kernel GEMM spécialisé pour le routeur FP32. Le routeur utilisait auparavant un chemin générique. Le kernel de routeur FP32 de vLLM pour petits batchs prend désormais en charge la forme 5120 × 256 de Beam, en conservant les poids, l'accumulation et les logits en FP32.
- Projection QKV + gate fusionnée avec un GEMM à faible latence. Les poids Q, K, V et gate sont regroupés en une seule matrice au chargement, de sorte que les quatre projections s'exécutent comme un seul GEMM. Pour les petits batchs, il utilise un GEMM CuTe DSL à faible latence ou le TinyGEMM de FlashInfer.
- Mise à jour fusionnée du cache KV. Le noyau de norme Q/K et RoPE écrit désormais aussi K et V dans le cache KV, il n'y a donc plus de noyau d'écriture dans le cache séparé.
- Activation Dense-MLP en un seul noyau pour les trois couches denses.
Le graphe fusionné
Après ces changements, une couche MoE s'exécute en 13 noyaux en décodage batch-1 sur TP8.
Figure 3 : Noyaux dans l'ordre de lancement pour une couche MoE, à partir d'une trace rank-0 d'un décodage batch-1 TP8. Les noyaux en or ont été écrits, fusionnés ou étendus pour Beam. Chaque noyau liste les opérations qu'il calcule. Ouvrir en plein écran.
- 6 noyaux ont été écrits, fusionnés ou étendus pour Beam. Chaque petite opération spécifique à Beam est fusionnée dans une voisine, et les deux all-reduce se trouvent à l'intérieur des noyaux de norme.
- 7 noyaux proviennent de bibliothèques : attention TRTLLM-gen, projection de sortie cuBLAS et chemin MoE NVFP4 TRTLLM (quantification, deux noyaux de routage, deux GEMM groupés). La majeure partie du temps restant se trouve ici, ce sera donc la suite.
Attention DP + MegaMoE
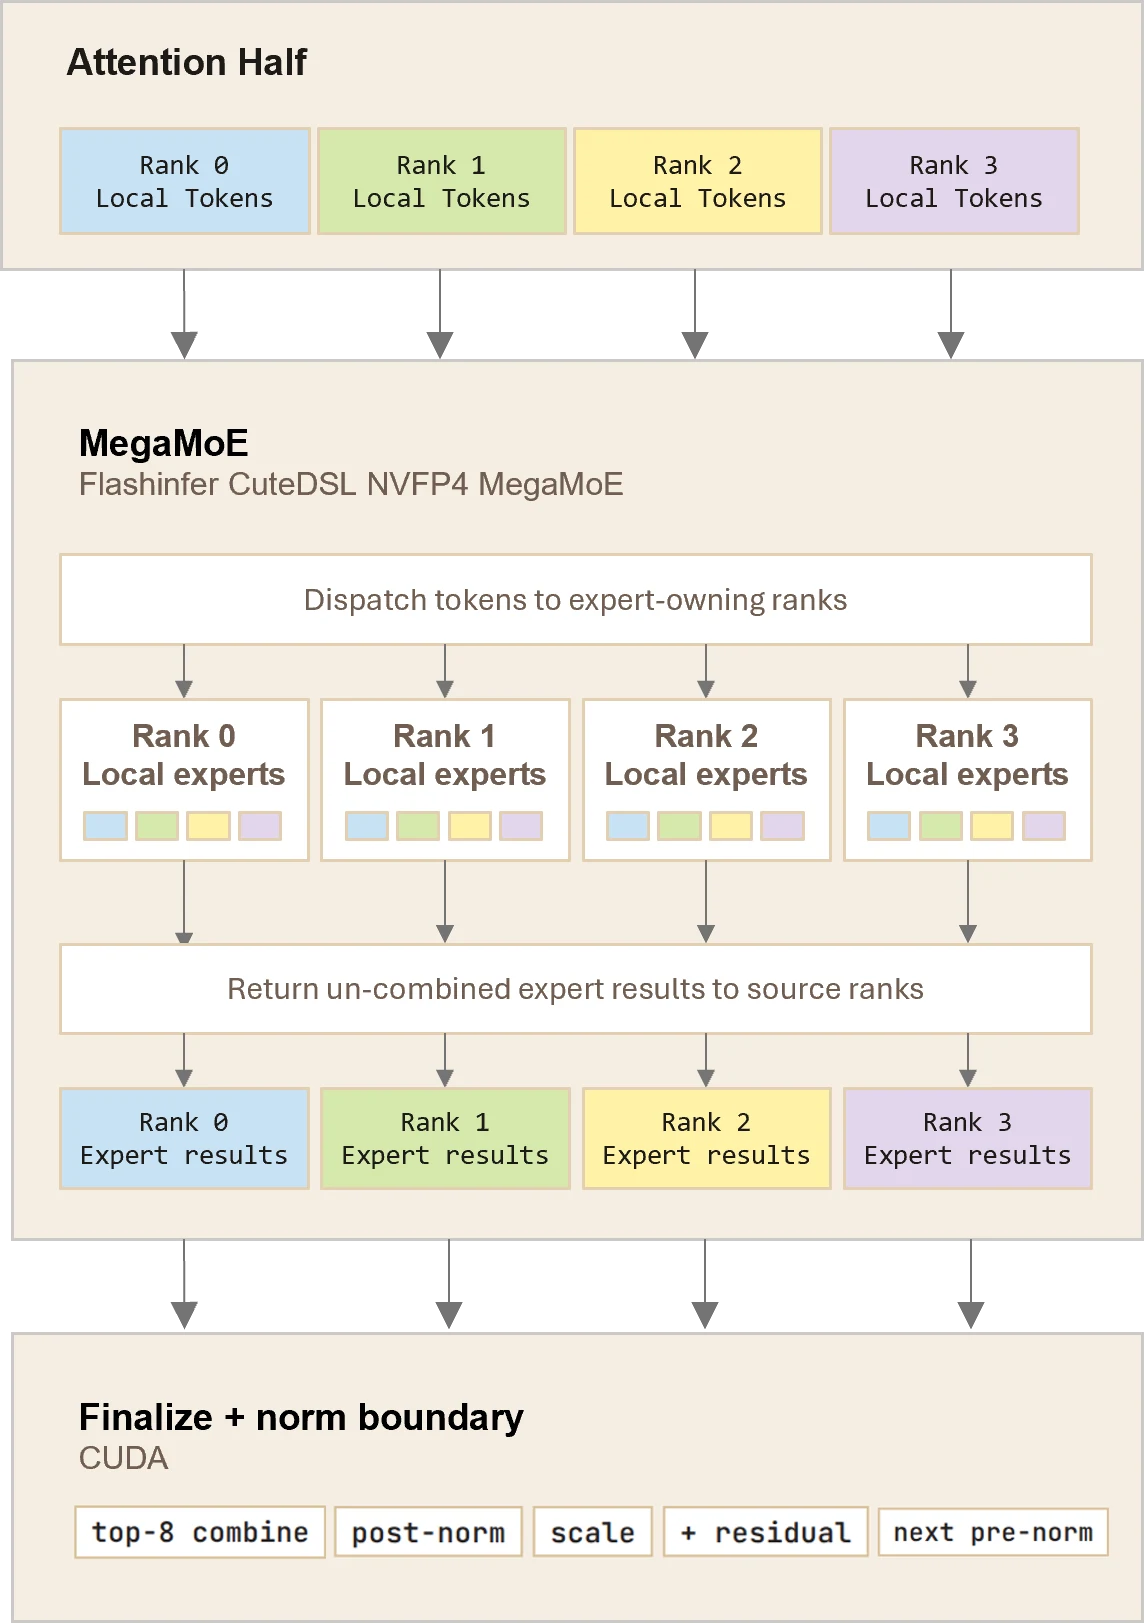
Figure 4 : FlashInfer CuteDSL NVFP4 MegaMoE peut fusionner les communications avec le calcul des experts.
Dans la région de haute concurrence, les performances de Beam peuvent être encore améliorées en combinant l'Attention DP avec MegaMoE, propulsé par le noyau CuTe DSL NVFP4 MegaMoE de FlashInfer. La fusion de frontière Finalize + norme reste applicable.
| Configuration | Débit maximal de tokens d'entrée |
|---|---|
| Attention DP + MegaMoE | 168.8K tokens / seconde |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7K tokens / seconde |
L'Attention DP avec MegaMoE a délivré un débit de préfill maximal 1,71× supérieur à TP4. Configuration du benchmark : 4×GB300, avec une longueur de séquence d'entrée de 32K tokens et une longueur de séquence de sortie de 1 token pour isoler les performances de préfill.
Pour activer l'Attention DP + MegaMoE, remplacez les réglages MoE et de parallélisme par :
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
Décodage spéculatif DFlash2
Beam est livré avec une tête de draft DFlash2 , que vLLM prend en charge dès le jour 0. Au lieu de proposer un token à la fois, elle prédit un bloc entier de tokens en une seule passe avant à partir des états cachés du modèle cible.
- Drafter. 5 couches à fenêtre glissante qui lisent les états cachés de 5 couches cibles et partagent l'embedding et la tête LM de la cible. Une convolution groupée et un petit sélecteur de candidats restaurent une partie de la dépendance de gauche à droite qu'un drafter parallèle perd.
- Vérification adaptative. Avec
"enable_adaptive_verification": true, vLLM prédit la probabilité d'acceptation de chaque token de brouillon et ne vérifie que ceux qui valent leur coût, au lieu d'un nombre fixe par étape. DFlash2 n'a pas de tête de confiance, l'estimation d'acceptation provient donc des logits du drafteur lui-même (voir notre article récent sur la vérification adaptative). - Kernels. La convolution du drafteur, les normalisations et les écritures KV sont fusionnées, et toute l'étape de brouillon s'exécute dans un CUDA graph. Le cache KV FP8 fonctionne aussi pour le drafteur, sans changement d'acceptation.
Résultats de service en TP8, avec et sans vérification adaptative, sur la catégorie à faible entropie de SPEED-Bench: throughput_1k split : invites d'environ 1K tokens, principalement de la complétion de code et du tri de texte, avec décodage glouton et jusqu'à 4K tokens de sortie. Le texte à faible entropie est plus facile à prédire, attendez-vous donc à une acceptation plus faible sur du chat ouvert.
| Concurrence | Brouillon fixe (tok/s) | Adaptatif (tok/s) | Changement | Longueur d'acceptation |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
La vérification adaptative porte ses fruits sous charge. À une concurrence de 128, elle augmente le débit de sortie de 10.8 % et réduit le p99 TPOT de 9 %, tout en vérifiant moins de tokens de brouillon par étape, ce qui abaisse légèrement la longueur d'acceptation mais économise plus de calcul qu'elle n'en perd. À faible concurrence, où les tokens de brouillon supplémentaires sont presque gratuits, elle est neutre.
Premiers pas
La commande en haut de cet article est un bon choix par défaut : TP4 sur un seul nœud GB300, avec DFlash2 et cache KV FP8. Pour activer la vérification adaptative, ajoutez "enable_adaptive_verification": true aux --speculative-config. Les autres optimisations ci-dessus sont activées par défaut.
- Choisir une configuration parallèle.
- Pour la latence la plus faible, utilisez TP4 ou TP8.
- Pour un débit plus élevé, utilisez l'attention en parallèle de données avec le parallélisme d'experts, par exemple.
-dp 4 --enable-expert-parallel.
- Raisonnement et appel d'outils. Le
beamles analyseurs lisent le modèle de réponse fourni avec le checkpoint. Par défaut, vLLM contraint également chaque réponse à ce modèle, de sorte que les appels d'outils sont toujours analysés et correspondent au schéma JSON de chaque outil.response_formatetthinking_token_budgetfonctionner comme d'habitude. Pour désactiver la contrainte par défaut, définissezVLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
Prise en charge dès le jour 0 (Day 0) du RL avec SkyRL
Nous avons également collaboré avec l'équipe SkyRL pour offrir un support Day 0 du RL sur Beam. LoRA, le full fine-tuning en BF16 et le RL en MXFP8 sont pris en charge dès la sortie, avec une pile RL améliorée pour l'échelle 500B.
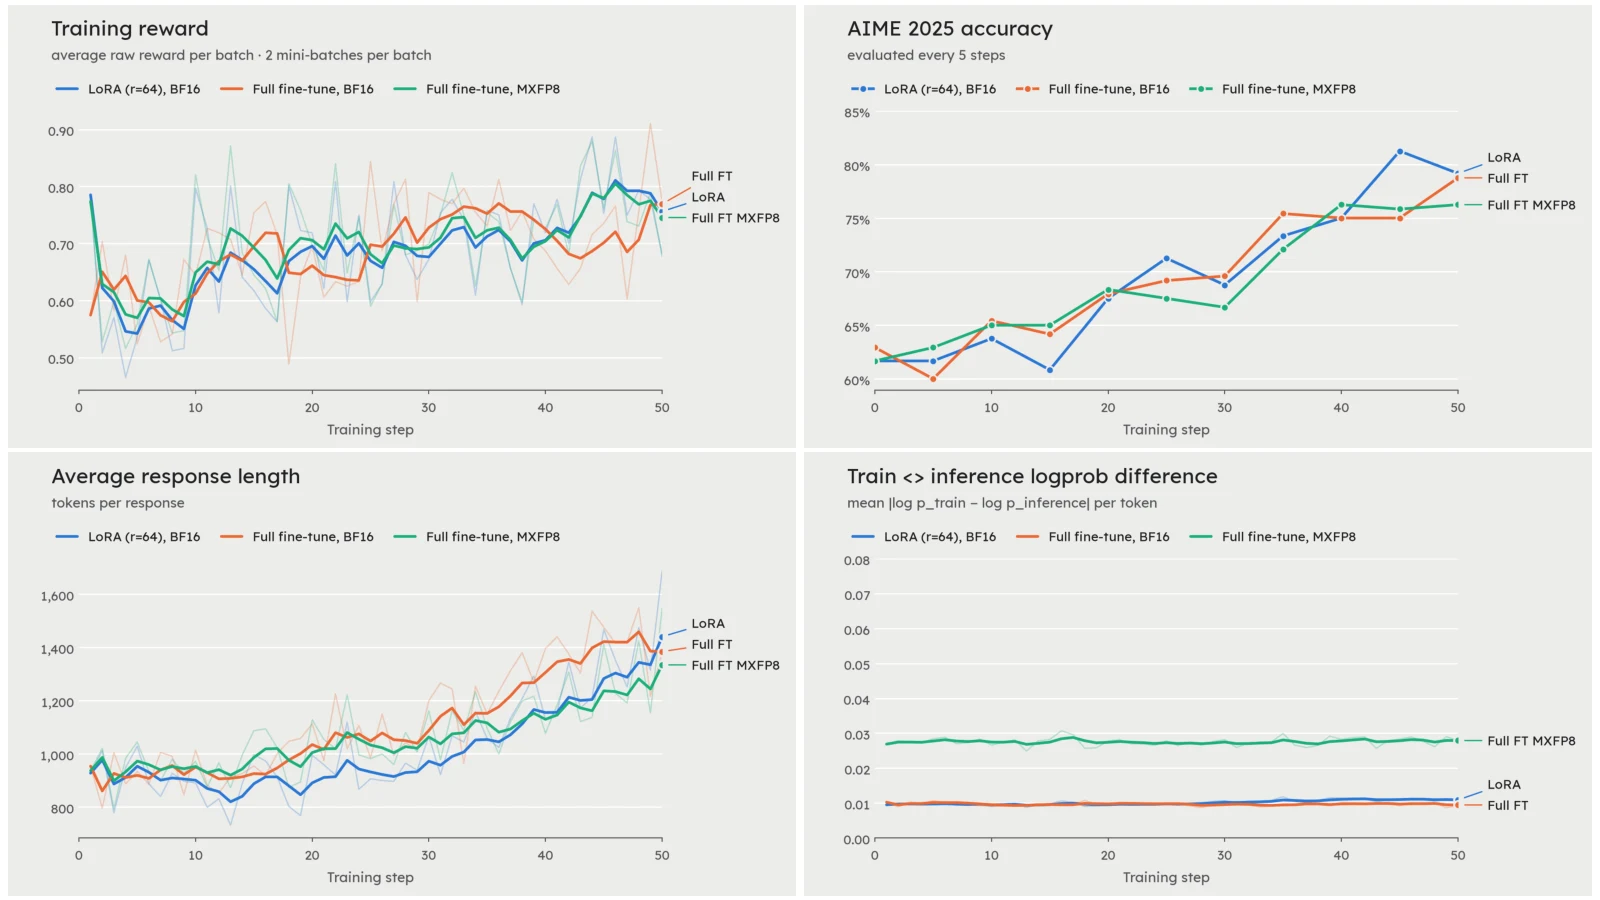
L'équipe SkyRL a effectué le post-entraînement du modèle Beam avec la recette DAPO, en utilisant vLLM pour l'inférence et Megatron pour l'entraînement. LoRA, le fine-tuning complet et le RL MXFP8 obtiennent des gains de performance similaires en 50 étapes d'entraînement, soit 100 mises à jour de l'optimiseur (raisonnement minimal) avec un bond de la précision moyenne (avg@8) d'environ 61 % à environ 79 % sur AIME25. La différence absolue moyenne de log-probabilité entre Megatron et vLLM reste inférieure à 0.01 avec Rollout Routing Replay (R3) activé pour le fine-tuning complet LoRA et BF16, et inférieure à 0.03 pour le RL en MXFP8.
Découvrez SkyRL blog pour plus de détails !
Remerciements
Ce travail a été le fruit d'une étroite collaboration entre les équipes Inferact, Reflection et Nvidia :
- Inferact : Woosuk Kwon, Ziqi Zhao, Ao Shen, Tiezhen Wang
- Réflexion : Kaixing Wu, Yoni Gozlan, Neil Gollapudi, Thibaut Barroyer, Aymen Kallala, Matthias Reso, Florent Gbelidji
- Nvidia : Siyuan Fu