
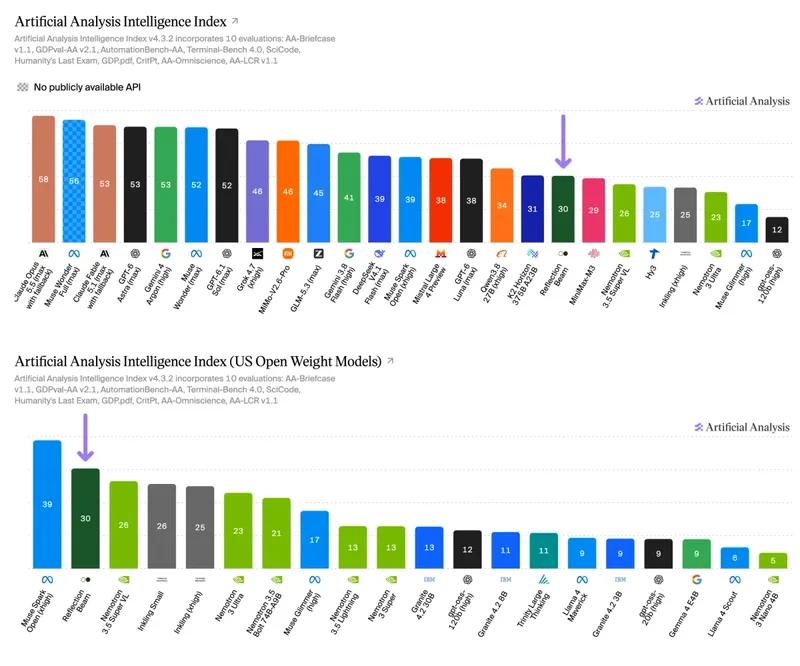
Le premier modèle de Reflection, Beam, obtient un score de 30 sur l'Artificial Analysis Intelligence Index, le plaçant à la 2e place parmi les modèles open weights américains
Voir la page du modèle Voir la page du modèleBeam est un modèle open weights avec 501B de paramètres au total et 23B actifs
Points clés :
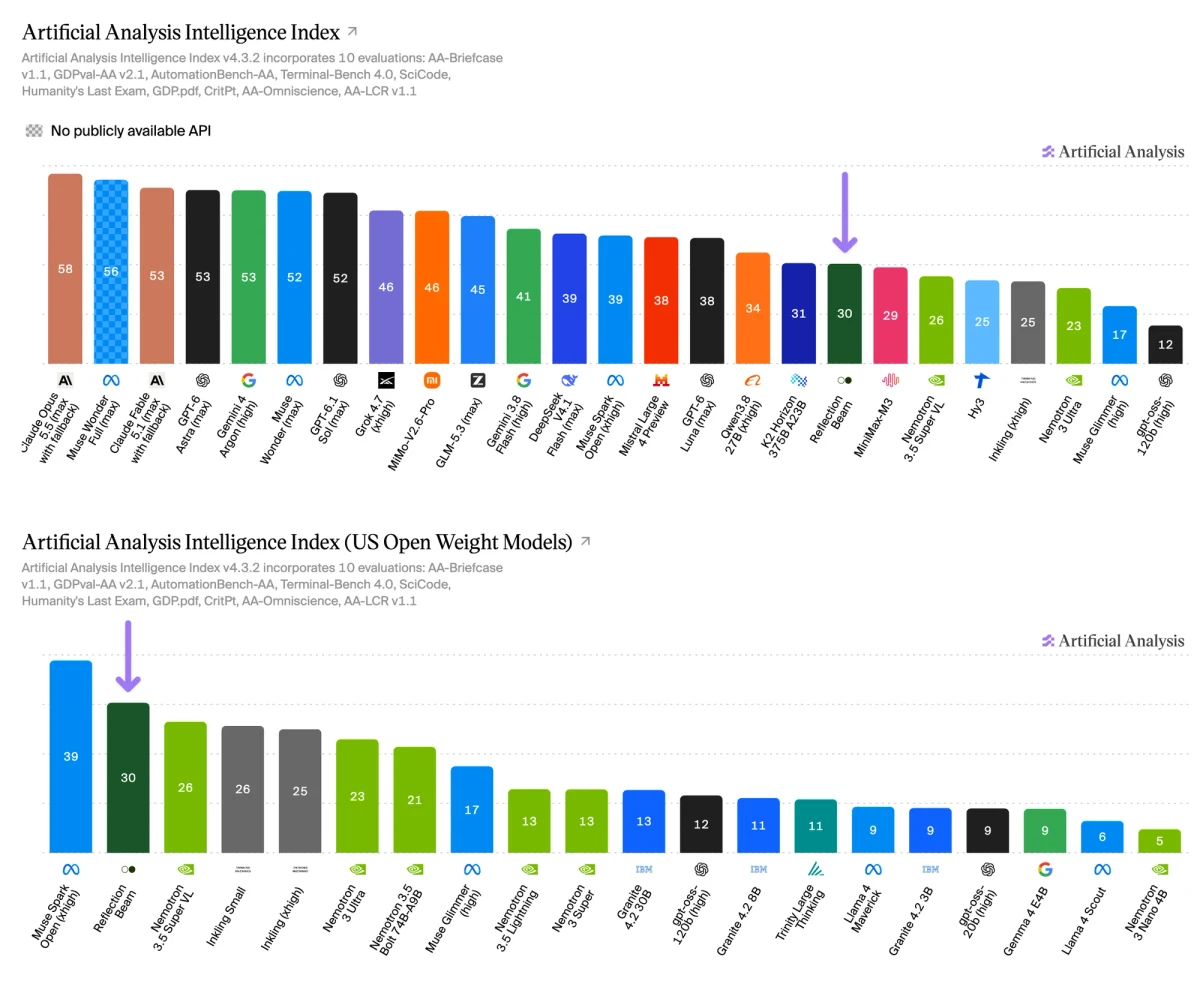
➤ Deuxième parmi les modèles open weights américains: Beam obtient un score de 30, derrière seulement Muse Spark Open de Meta (39) et devant la sortie d'hier NVIDIA Nemotron 3.5 Super VL (26). Hors de Chine, seuls Muse Spark Open et K2 Horizon des Émirats arabes unis (31) obtiennent un score plus élevé
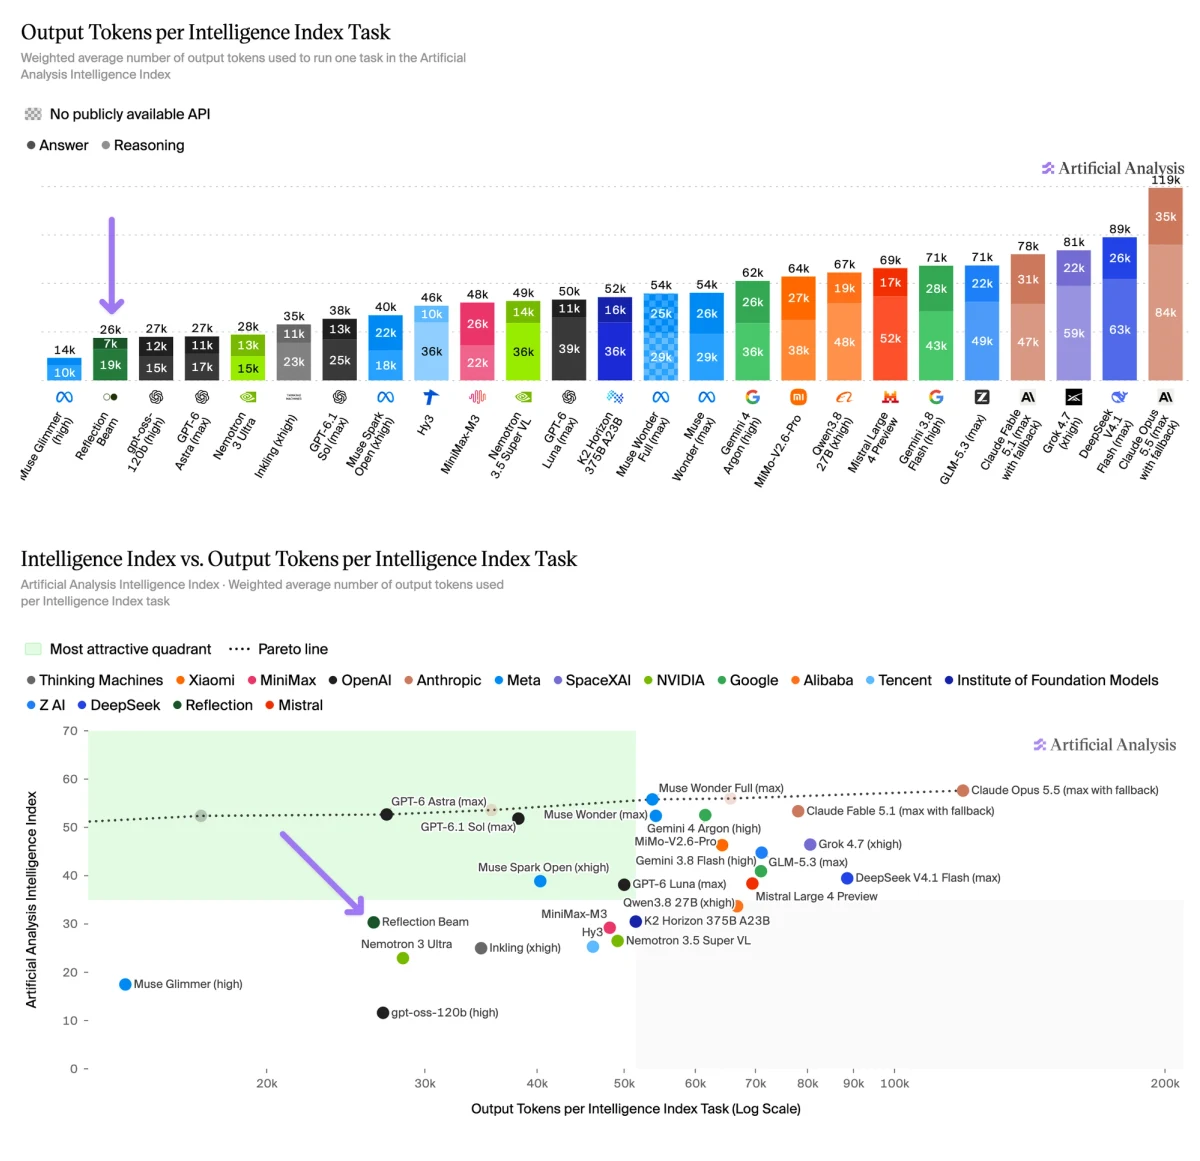
➤ Économe en tokens pour son intelligence: Beam utilise environ 26k tokens de sortie par tâche de l'Intelligence Index, contre K2 Horizon, qui a un point d'avance et en utilise deux fois plus (~52k). Les modèles propriétaires définissent toujours la frontière, avec GPT-6 Astra (max) qui obtient 53 sur le même budget (~27k)
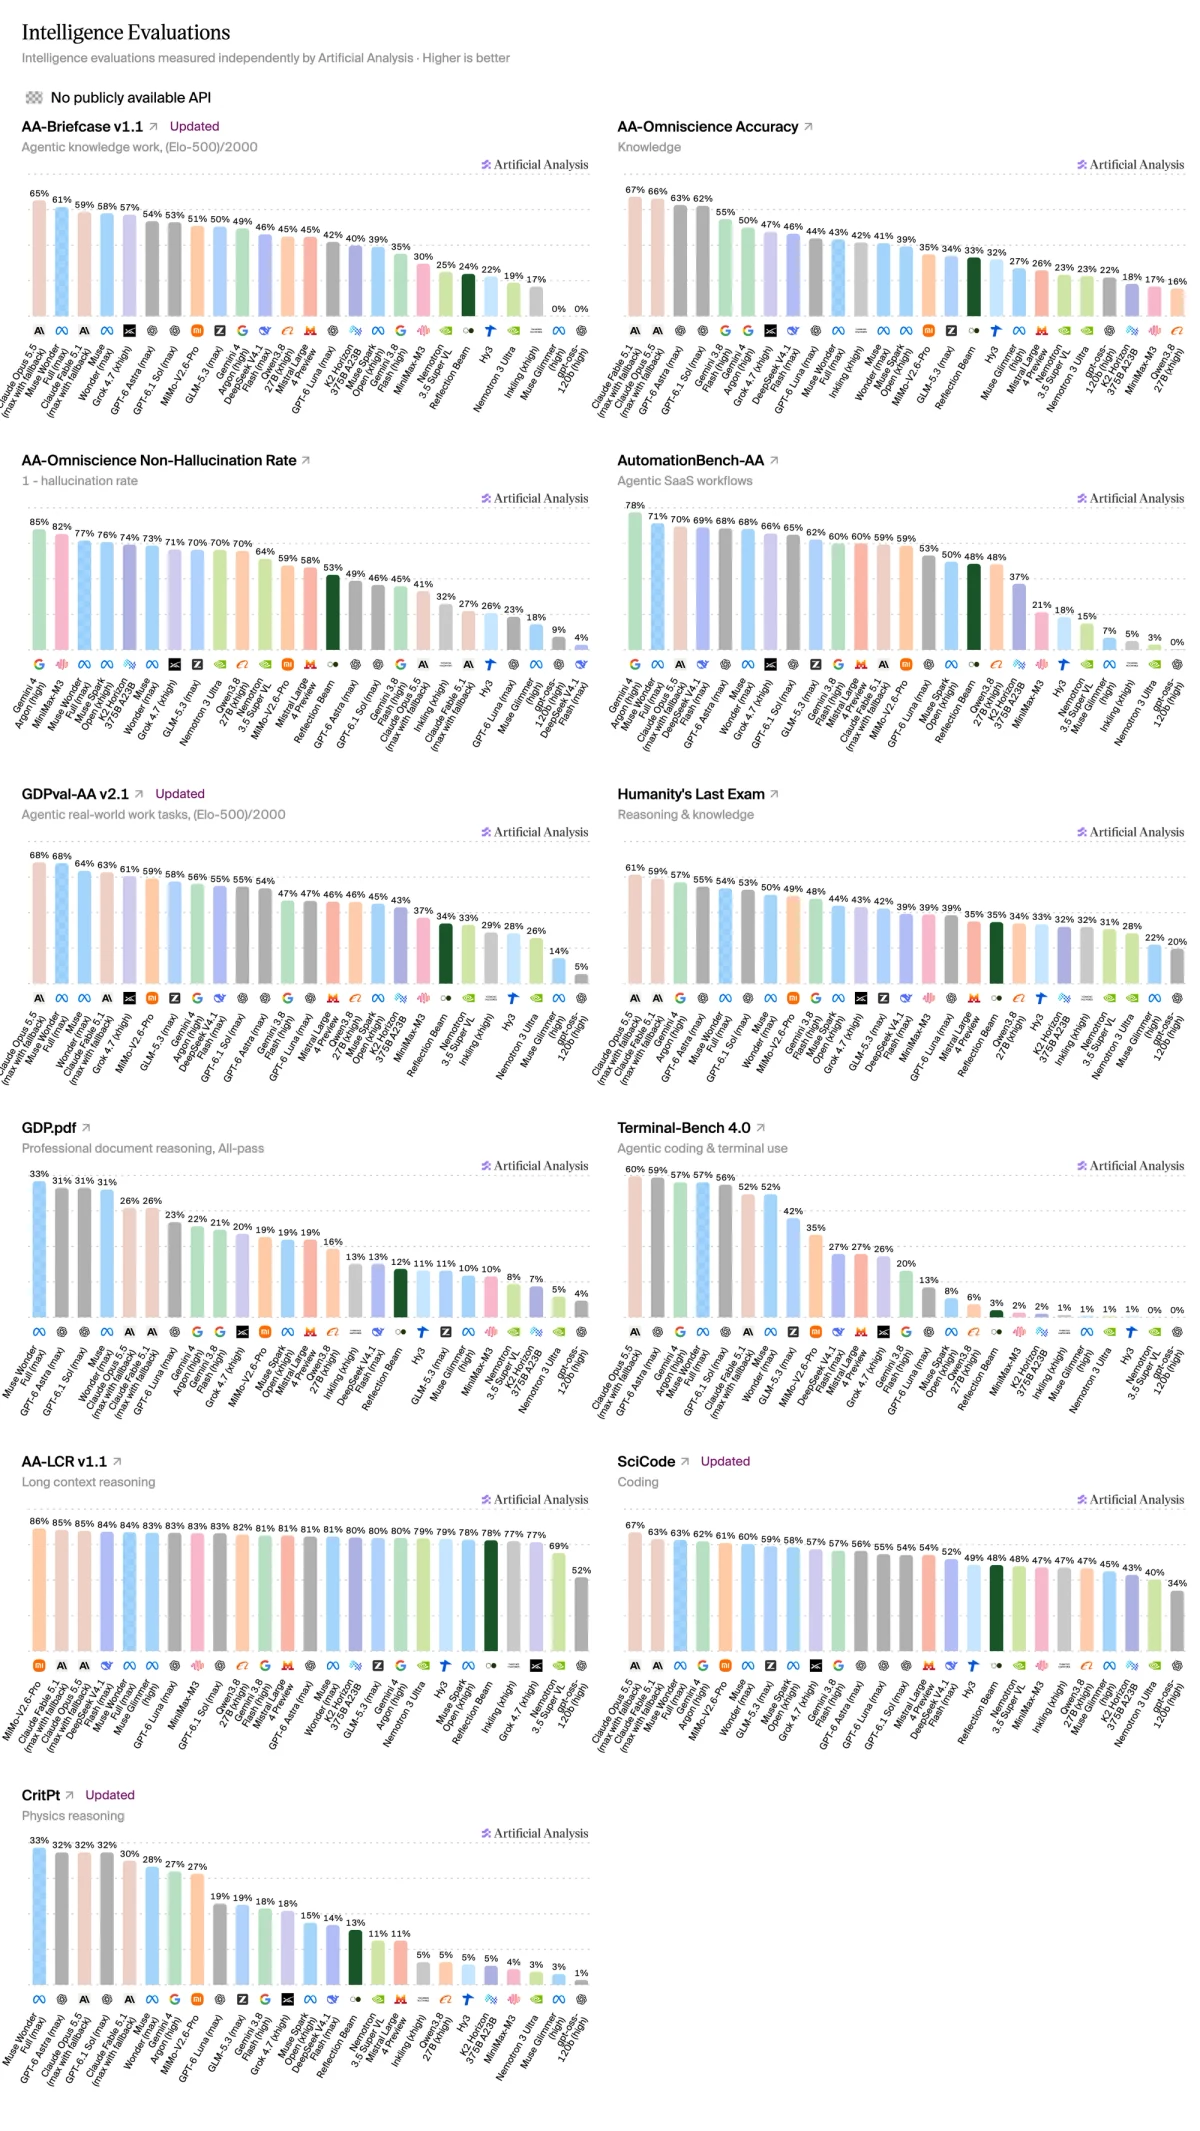
➤ Fort sur les flux de travail agentiques, plus faible dans le terminal: Beam obtient 48.5 % sur AutomationBench-AA, avec 11 points de pourcentage d'avance sur K2 Horizon (37.2 %) et au niveau de Qwen3.8 27B (48.2 %). Terminal-Bench 4.0 est un point faible, où Beam obtient 3.0 %, derrière Qwen3.8 27B (5.6 %) et Muse Spark Open (8.1 %)
➤ En sait plus, devine plus: Sur AA-Omniscience, il répond correctement à 33 % des questions, bien devant K2 Horizon (18 %) et Qwen3.8 27B (16 %). Mais son taux d'hallucination est de 47 %, contre 26 % pour K2 Horizon et 30 % pour Qwen3.8 27B, donnant à Beam un score net d'index de 1.5, devant les deux concurrents (−3.0 et −10.0)
Autres détails du modèle
- Fenêtre de contexte : 1M de tokens
- Modalités : Texte
- Paramètres: 501B / 23B
Comparé aux modèles open weights concurrents
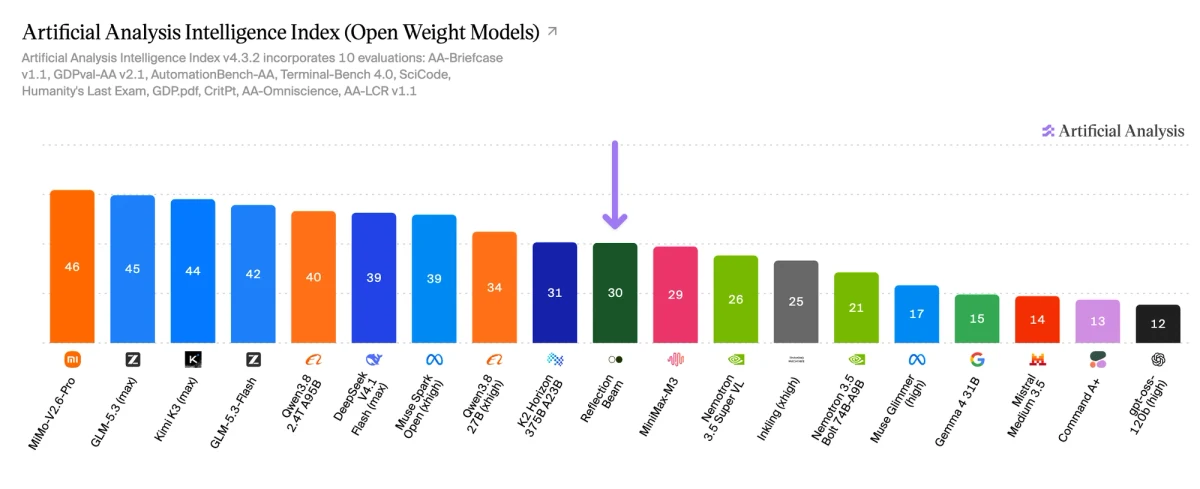
Beam obtient un score élevé face aux modèles open weights américains, derrière Muse Spark Open de Meta (39) et devant Nemotron 3.5 Super VL de NVIDIA (26), tous sortis cette semaine. Parmi tous les modèles open weights, il se classe dixième, à un point derrière K2 Horizon (31)
Capacités en cybersécurité
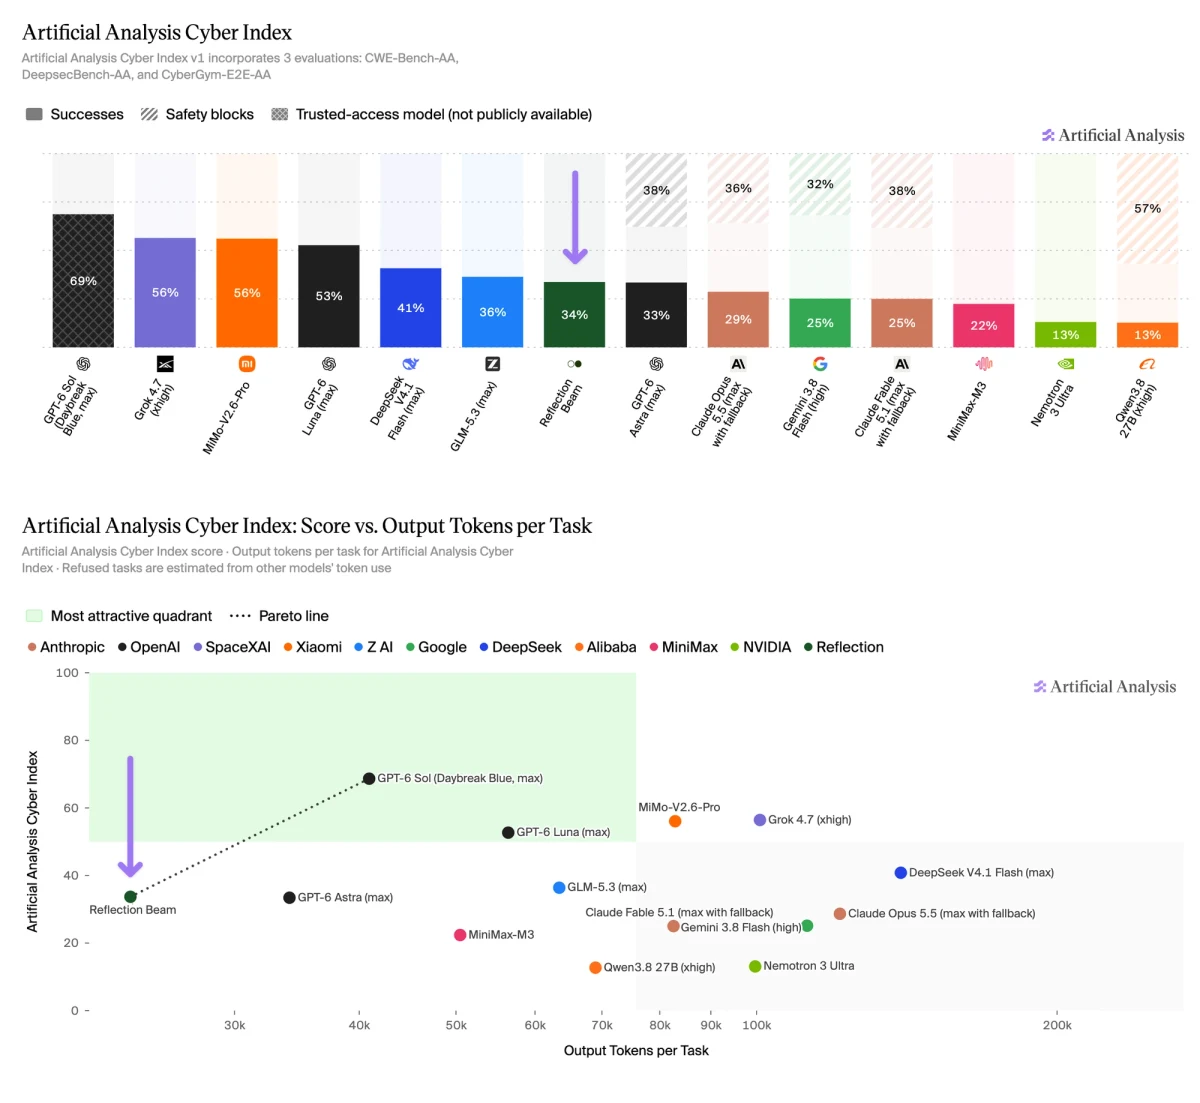
Beam complète 34 % des tâches de l'Artificial Analysis Cyber Index, ce qui en fait le meilleur modèle open weights américain que nous ayons testé
Porté par son efficacité en tokens, il se situe également sur la frontière Cyber Index vs. tokens de sortie par tâche, aux côtés de GPT-6 Sol (Daybreak Blue)
Très économe en tokens
Beam utilise ~26k tokens de sortie par tâche de l'Intelligence Index : ~19k pour le raisonnement et ~7k pour les réponses. Seuls 26 % de sa sortie vont aux réponses finales, la 28e part la plus faible des 219 modèles testés sur l'Intelligence Index v4.3
Compétences en codage
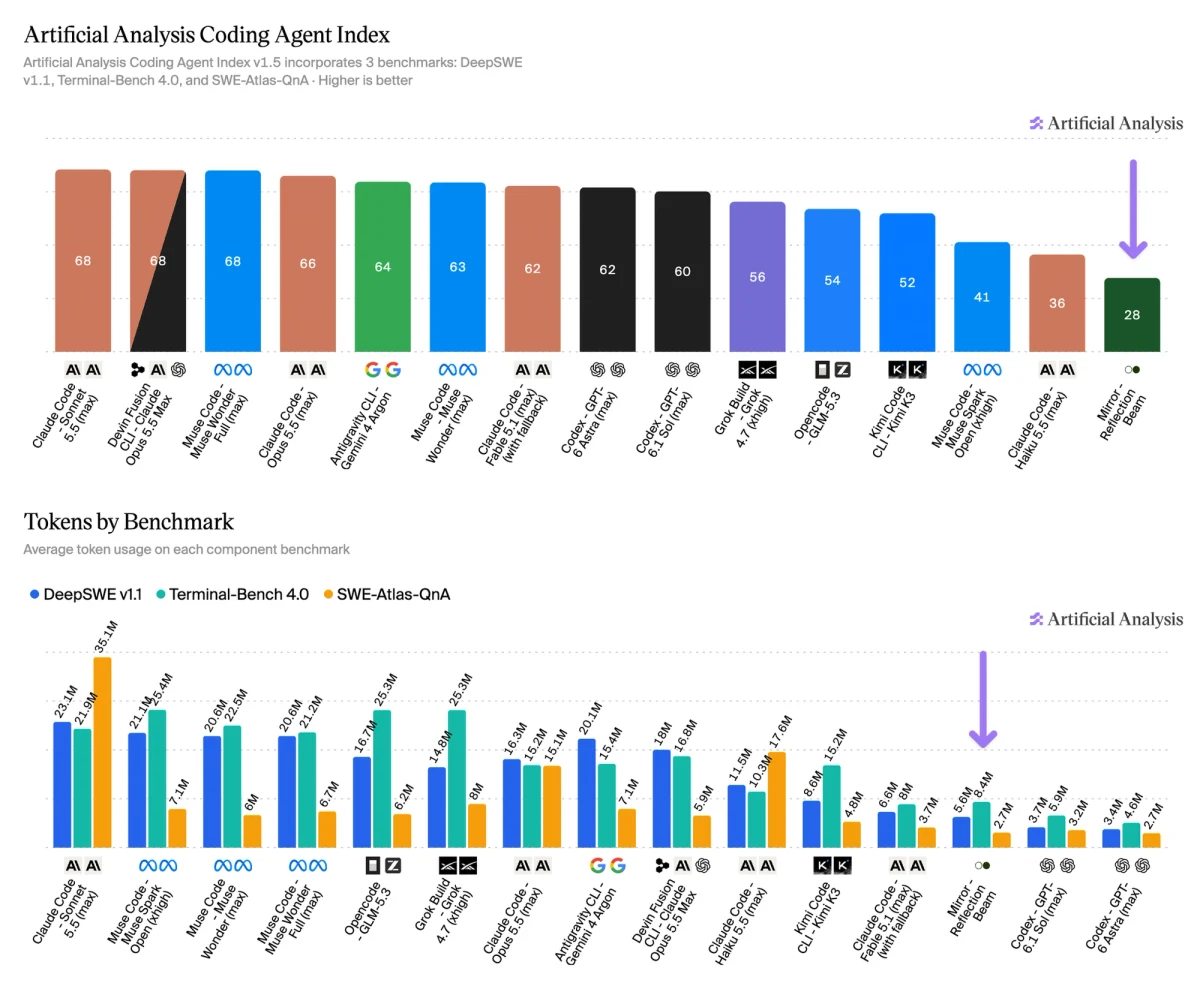
Exécuté dans Mirror, le harnais CLI open source de Reflection, Beam obtient 28 sur l'Artificial Analysis Coding Agent Index. Il se situe 15 points derrière la configuration suivante, Claude Code avec Qwen3.8 Max (43), et 40 derrière les leaders (68). Il est toutefois frugal : seuls Codex avec GPT-6 Astra et Codex avec GPT-6.1 Sol utilisent moins de tokens
Composantes de l'Intelligence Index
Sur les dix évaluations de l'Intelligence Index, Beam se distingue sur AutomationBench-AA (48,5 %) et CritPt (13,1 %), où il fait plus que doubler K2 Horizon (4,6 %) et Qwen3.8 27B (5,4 %). Ses résultats les plus faibles sont sur Terminal-Bench 4.0 (3,0 %) et AA-Briefcase (976 Elo)
Tous les détails sur la page Artificial Analysis de Beam https://artificialanalysis.ai/models/reflection-beam