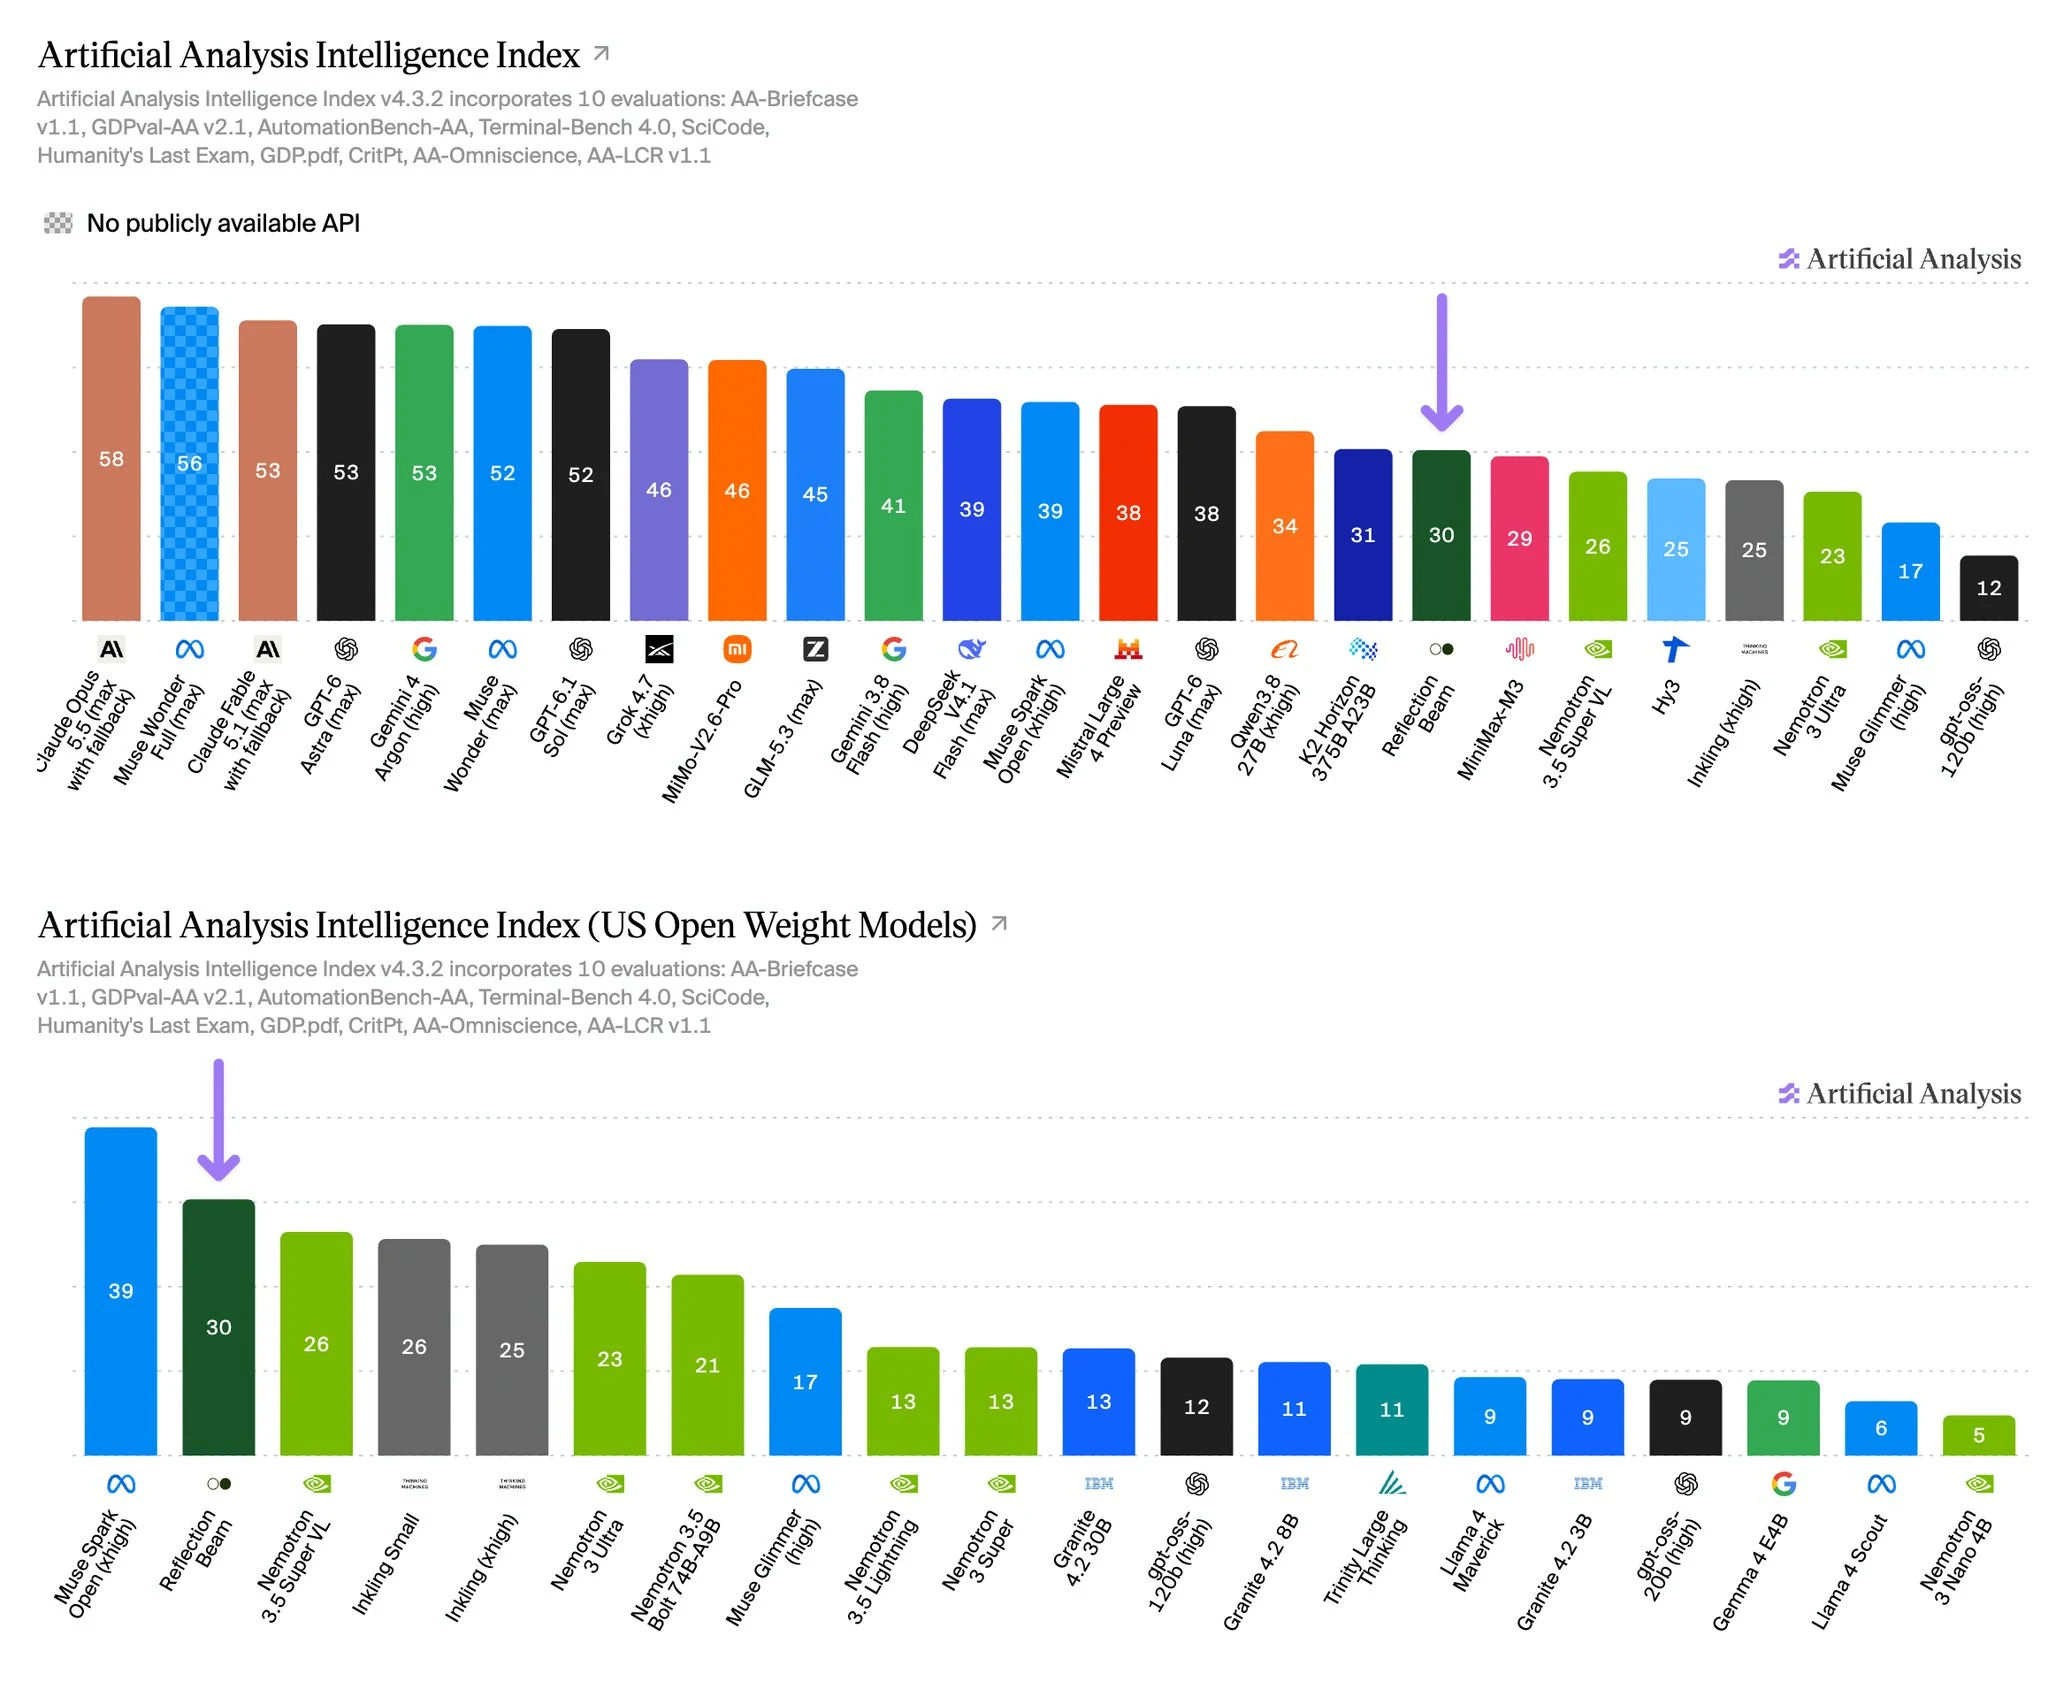
Le premier modèle de Reflection, Beam, obtient 30 sur l’Indice d’Intelligence en Analyse Artificielle, le plaçant à la #2 parmi les modèles de poids ouverts aux États-Unis
Beam est un modèle de poids ouvert avec un total de 501B et 23B paramètres actifs, publié sur @huggingface
Félicitations à @reflection_ai pour la sortie !
Points clés :
➤ Deuxième modèle des modèles de poids ouverts américains : les scores de Beam sont de 30, derrière seulement le Muse Spark Open de Meta (39) et devant la sortie du NVIDIA Nemotron 3.5 Super VL d’hier (26). En dehors de la Chine, seuls le Muse Spark Open et le K2 Horizon des Émirats arabes unis (31) ont des scores plus élevés.
➤ Efficace en termes de tokens pour sa performance : Beam utilise environ 26 000 tokens de sortie par tâche d’Indice d’Intelligence, contre K2 Horizon qui en utilise deux fois plus (~52 000). Les modèles propriétaires restent encore les meilleurs, avec GPT-6 Astra (max) obtenant une note de 53 sur le même budget (~27 000).
➤ Forte en workflow agentique, moins forte dans le terminal : Beam obtient 48,5 % sur AutomationBench-AA, 11 points de plus que K2 Horizon (37,2 %) et à égalité avec Qwen3.8 27B (48,2 %). Terminal-Bench 4,0 est un point faible, où Beam obtient 3,0 %, en retard par rapport à Qwen3.8 27B (5,6 %) et Muse Spark Open (8,1 %)
➤ Plus de connaissances, plus d’hypothèses : sur AA-Omniscience, il répond correctement à 33 % des questions, bien en tête de K2 Horizon (18 %) et de Qwen3.8 27B (16 %). Mais son taux de hallucination est de 47 %, contre 26 % pour K2 Horizon et 30 % pour Qwen3.8 27B, ce qui donne à Beam un score d’indice net de 1,5, en tête des deux concurrents (−3,0 et −10,0).
Autres détails du modèle
Fenêtre de contexte : 1M tokens
Modalités : Texte
Paramètres : 501B / 23B