
L’interprétablence de l’IA est-elle proche d’un tournant ? Un nouvel essai met les chercheurs en désaccord
 Maximilian Schreiner
Voir le profil LinkedIn de Maximilian Schreiner
16 octobre 2026
 Nano Banana Pro demandé par THE DECODER
Selon Nick Cammarata, l’un des personnes impliquées dans l’hypothèse de la superposition, les réseaux neuronaux ne sont pas aussi complexes que les chercheurs le pensaient. Roon, de OpenAI, le qualifie de moment historique. Neel Nanda, chercheur chez Google DeepMind, avertit contre une surestimation de cette situation.
Dans un long essai intitulé « Les réseaux de neurones sont déjà propres », Nick Cammarata affirme que le fonctionnement interne des grands modèles d’IA est beaucoup plus facile à comprendre qu’on ne le pensait auparavant. Cammarata est chercheur au laboratoire d’interprétabilité Goodfire. Avec cet essai, il rejette une explication qu’il avait contribué à façonner des années auparavant.
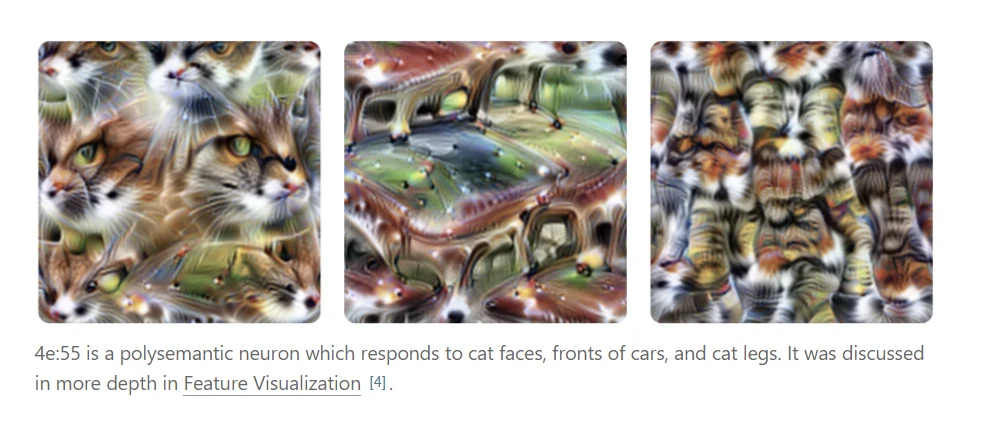
L’interprétabilité mécanique vise à faire plus que simplement observer les résultats produits par un modèle d’IA. Elle cherche à déterminer comment le modèle atteint ses réponses en interne. Idéalement, chacun des millions de neurones artificiels représenterait un concept identifiable. En pratique, de nombreux neurones semblent s’activer sur des sujets complètement distincts, ce que les chercheurs appellent la polysemantique. Un exemple ancien et célèbre est un neurone dans le modèle d’image InceptionV1, qui répondait à la fois aux visages de chat et aux phares des voitures. Cammarata l’a utilisé comme exemple dans ses recherches initiales.
L’explication standard était la superposition. La théorie veut que lorsqu’une réseau se termine de neurones, il regroupe des concepts indépendants dans les mêmes neurones, car ils rarement se contredisent. Le résultat ressemble à un nœud. C’est pourquoi de nombreux laboratoires entraînent un deuxième modèle, tel qu’un autoencodeur épars, afin de séparer les concepts. Ils étudient ensuite ce modèle plutôt que le modèle original.
Cammarata a joué un rôle majeur dans la formation de cette vision. Avec Chris Olah, il a co-écrit l’article “Zoom In”, qui a introduit le premier circuit de superposition. En 2023, il a initié un projet d’interprétabilité automatisée à OpenAI. À l’époque, seulement environ 1,7 % des neurones étaient considérés comme compréhensibles, même selon les critères les plus généreux.
Les preuves ont peut-être été mal lues
Cammarata pense maintenant que les exemples les plus célèbres ont été mal interprétés. Il affirme que le neurone cat-car est en réalité un détecteur de forme en V. Des formes pointues, comme les museaux des renards ou les flammes, activent cet neurone, tandis que des formes rondes, comme la lettre O, le font cesser d’être activé. Ainsi, il ne représente pas deux concepts complètement indépendants, tels que les visages de chat et les voitures, ce qui signifie qu’il ne constitue pas un exemple de superposition.
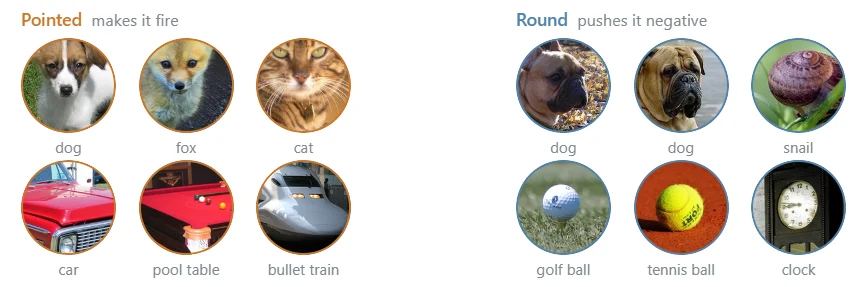
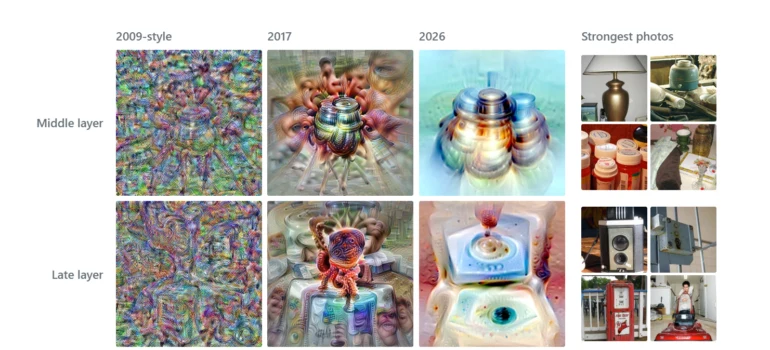
Il réinterprète également le circuit de superposition de « Zoom In », où une voiture semblait se cacher parmi les neurones du chien. Selon lui, il s’agit d’une généralisation ordinaire, et le circuit simplement regroupe les voitures et les chiens en fonction de la direction dont ils sont tournés vers la caméra. Il blâme la confusion dans les couches ultimes de InceptionV1 pour une architecture obsolète et des outils d’analyse faibles.
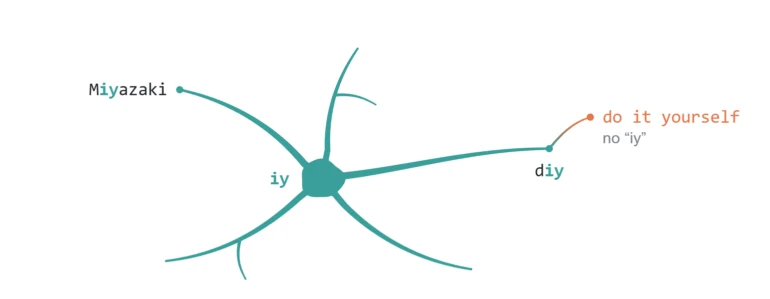
Cammarata explique l’ambiguïté restante à l’aide d’un modèle qu’il appelle « généralisation récursive ». Il dit qu’un neurone se développe comme une branche qui pousse de côtés. Un neurone qui a reconnu la séquence de lettres « iy » répond ensuite à « diy », puis finalement à « fais-le toi-même », qui ne contient pas du tout « iy ». Contrairement à la superposition, ces groupements permettent de comprendre quelque chose au sujet du réseau.
Pour les modèles de langage, il fournit des chiffres préliminaires. Dans Qwen3-32B, environ 90 % des pôles neuronaux ont une seule tâche principale, et environ 7 % en ont deux tâches liées. Seulement 2 à 4 % restent sans explication. Goodfire indique qu’il observe des résultats similaires dans les modèles comptant jusqu’à des trillions de paramètres. Les agents d’IA qui analysent les neurones en masse ont effectué la plupart du travail. Cammarata s’inspire de “Bitter Lesson” de Rich Sutton et conclut que, en termes d’interprétabilité, une investigation simple à grande échelle est supérieure aux méthodes de décomposition astucieuses.
Cammarata ne propose pas une méthode fondamentalement nouvelle. Il revient à l’approche originale du domaine : étudier les neurones directement, mais avec des outils plus performants, des modèles plus grands et des agents automatisés.
Les réseaux lisibles représenteront une grande victoire pour la sécurité de l’IA
Si Cammarata a raison, ce serait une bonne nouvelle, en particulier pour la sécurité de l’IA. Actuellement, en plus de surveiller les chaînes de pensée qui deviennent de moins en moins fiables, il y a peu de moyens de déterminer si un modèle trompe les gens ou se comporte de manière dangereuse. Cammarata doute que l’alignement, qui consiste à diriger l’IA vers des objectifs humains, puisse être résolu sans interprétabilité, car sinon, on ne sait pas ce qu’on construit. La tromperie n’a aucune raison de se cacher dans les circuits du modèle lui-même, écrit-il. Si les humains deviennent simplement un autre “lecteur” du réseau, ils peuvent également voir la tromperie, et les erreurs pourraient être corrigées de manière ciblée.
Roon, un employé d’OpenAI qui publie sous ce pseudonyme sur X et une voix influente dans le domaine de l’IA, était très enthousiaste. Il dit être proche ami de Cammarata et ne serait jamais arrivé à OpenAI sans lui. Ce travail « pourrait être considéré comme un moment important dans l’histoire scientifique ». Roon a écritIl a ajouté que les nouvelles sont si bonnes que même Eliezer Yudkowsky, l’une des voix les plus influentes qui avertissent de une catastrophe due à l’IA, devra diminuer ses estimations concernant les chances de désastre. Selon Roon, l’alignement des intérêts pourrait devenir une « science normale ».
Même Roon a quelques réserves. D’autres dans le domaine ont encore besoin de confirmer les résultats, et il soupçonne également que des progrès en termes d’interprétabilité feront progresser les capacités de l’IA. Le fait que ces progrès proviennent de l’extérieur ne est pas favorable pour les grands laboratoires, y compris OpenAI.
Nanda voit un outil utile, pas une percée
Neel Nanda est beaucoup plus mesuré. Il est considéré comme l’une des figures fondatrices de l’interprétabilité mécaniste et dirige l’équipe d’interprétabilité chez Google DeepMind. Avant cela, il a travaillé chez Anthropic et en tant que chercheur indépendant. Selon lui, ses opinions ont changé : depuis le milieu de 2024, il est devenu plus pessimiste concernant une interprétabilité ambitieuse et s’est tourné vers des approches pragmatiques. Son équipe a réduit la priorité aux recherches sur les autoencoders épars. Ils ne pensaient pas que la technique était inutile, mais cela ne semblait pas valoir l’effort que le domaine y mettait.
Le travail de Cammarata est intéressant, mais il ne change pas vraiment la situation globale, Nanda écrit. L’analyse basée sur des neurones pourrait aider dans des questions pratiques, comme expliquer pourquoi un modèle fait quelque chose de questionnable, et il est beaucoup plus facile d’appliquer cela aux modèles novateurs. Mais il ne croit pas que l’interprétabilité soit presque complètement résolue. Il suppose que l’analyse basée sur des neurones comporte des défauts sérieux et manque énormément de points importants.
Nanda pense toujours que la superposition est réelle. Il soutient que les modèles de langage stockent bien plus de faits que de neurones, et en particulier, les activations faibles contiennent probablement une grande partie de ces informations. Il doute que les résultats obtenus avec de petits modèles d’images se transposent à d’autres cas. Il est également d’avis que l’essai définit la monosemantique trop largement, mais il reconnaît à Cammarata le mérite de lui avoir vérifié son ancien travail avec des outils modernes.
Une partie de la dispute repose sur les définitions : Cammarata n’a aucun problème avec les modèles qui représentent plus de concepts que leurs dimensions, et Nanda le considère comme d’accord sur ce point. Ce que Cammarata conteste, c’est que les réseaux rassemblent arbitrairement des choses totalement indépendantes.
Le document technique de complément n’a pas encore été publié. En tant que société spécialisée dans l’interprétabilité, Goodfire a également un intérêt évident dans cette thèse. Si les conclusions de Cammarata sont valides, il pense que les chercheurs automatisés pourraient accomplir en quelques mois ce qui a pris près d’une décennie aux humains pour les modèles d’images. Il écrit qu’il peut ne pas rester beaucoup de temps pour cela.
Nouvelles sur l’IA sans hype – sélectionnées par des humains
S'abonner à THE DECODER pour une lecture sans publicités, un bulletin informatif sur l’IA semaine par semaine, notre rapport spécial « AI Radar » annuel six fois par an, un accès complet aux archives, et la possibilité d’interagir dans notre section de commentaires.
Lisez plus loin pour obtenir une vue complète.
Abonnez-vous pour une couverture sans hype.
- Accès complet à tous les articles sur THE DECODER
- Aucun publicité
- Rejoignez les commentaires et les discussions communautaires
- Résumé hebdomadaire des nouvelles sur l’IA par e-mail
- 6 fois par an : « AI Radar » – des analyses approfondies sur les sujets d’IA les plus importants
- Actualités sur l’IA quotidiennes, toujours à jour
- Nos archives complètes sur dix ans
- Couvert par une équipe ayant plus de 10 ans d’expérience en IA