

Le Gemini 4 Argon de Google est plus proche des frontières de l’IA que n’importe quel modèle Google en quelques mois
 Matthias Bastian
Voir le profil LinkedIn de Matthias Bastian
16 oct. 2026
 Google
 Deepmind est le deuxième grand laboratoire d’IA à obtenir 95 % sur le benchmark ARC-AGI-3. Cependant, les résultats dépendent fortement de la méthode d’évaluation, et Argon devance ses concurrents en mathématiques et en ingénierie logicielle, selon Epoch AI.
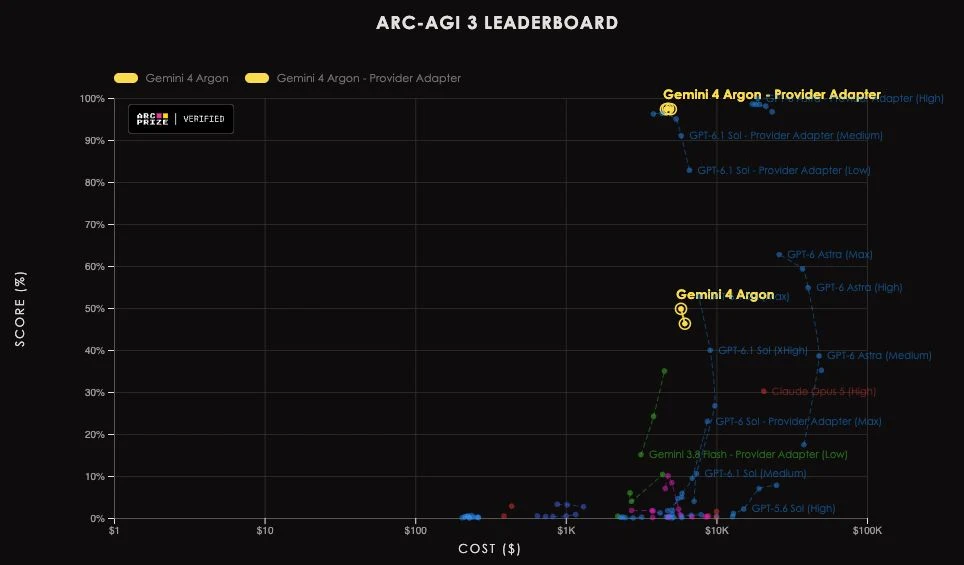
Le nouveau modèle Frontier de Google Deepmind, Gemini 4 Argon, a obtenu 97,5 % sur ARC-AGI-3, à un coût de 4 800 dollars, en utilisant l’« Adapter Harness Provider », une configuration d’essai qui met en œuvre des fonctionnalités spécifiques aux fournisseurs, telles que le raisonnement conservé et la compression du contexte. Selon le prix ARC, Google est désormais le deuxième laboratoire d’IA après OpenAI à avoir dépassé le score de 95 % sur ce qui est considéré comme le benchmark le plus difficile pour la résolution de problèmes généraux. Seul GPT-6 Astra atteint un score plus élevé, à 99,9 %.
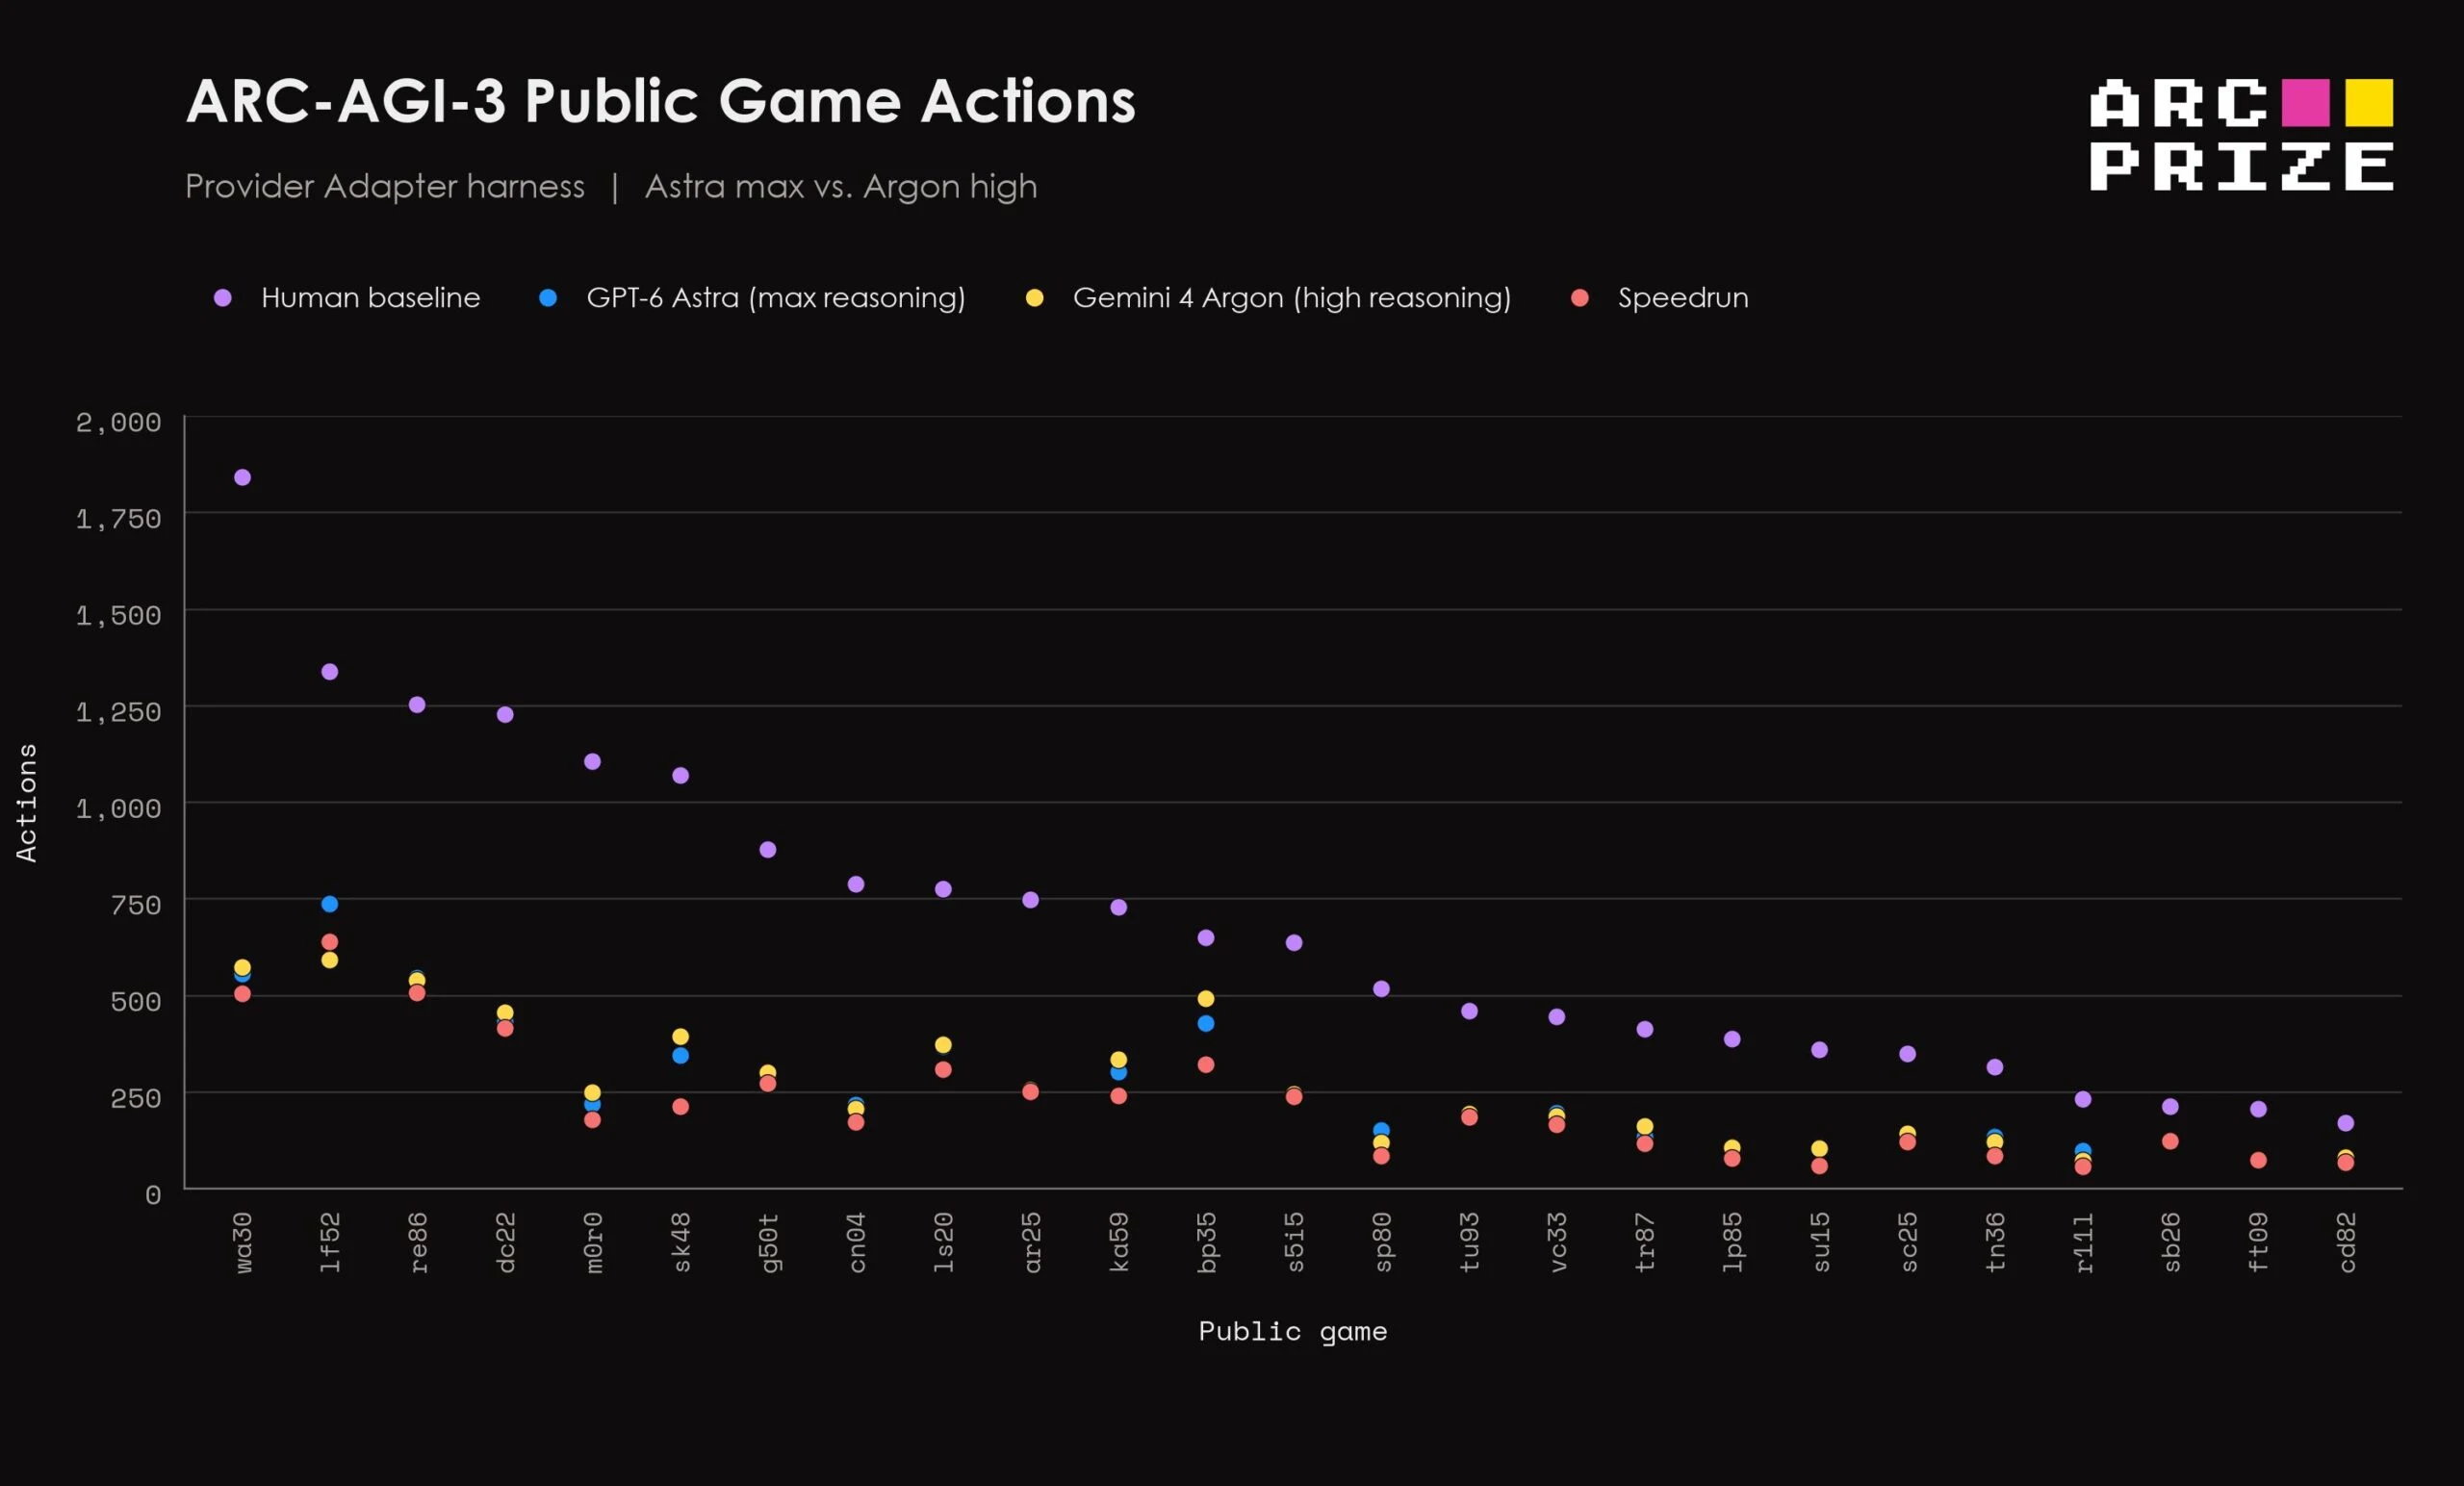
Comme Astra, Argon a nécessité 62 % moins d’actions que la norme humaine sur les 25 jeux publics. Il a égalé ou dépassé le record de speedrun dans trois jeux et est à 10 % du meilleur temps dans six autres. Sur les versions plus anciennes du benchmark, Argon a obtenu 91,3 % sur ARC-AGI-2 (0,32 $ par tâche) et 98,5 % sur ARC-AGI-1 (0,16 $ par tâche), en tenant compte du prix initial de 2 $ par million de tokens d’entrée et de 10 $ par million de tokens de sortie.
Résultats du benchmark dépendent fortement de la configuration d’essai
Dans le « Standard Harness », qui ne permet que des notes simples entre les tours, Argon tombe à 49,8 % en raison d’un raisonnement faible pour 5 800 $. Cette différence remonte à une dispute en juillet 2026, lorsque OpenAI’s GPT-5.6 Sol a battu Claude Opus 5 sur ARC-AGI-3 en utilisant deux paramètres API.
GPT-5.6 Sol n’a obtenu que 7,8 % dans l’environnement standard, car il abandonne le raisonnement interne après chaque action et utilise une interface ancienne dépourvue des fonctionnalités récentes de la API Claude. Cela signifie que Claude a été testé dans des conditions différentes de GPT-5.6. Lors du test avec l’API Responses d’OpenAI, y compris les fonctionnalités « Raisonnement conservé » et « Contexte intelligent » « Compaction », le modèle a atteint 38,3 % et a surpassé Opus 5 avec 30,2 %. OpenAI a soutenu que les critères de mesure mesurent également l’environnement technique. Francois Chollet, cofondateur du Prix ARC, a ensuite autorisé des paramètres d’API généralement disponibles au public.
Les problèmes d’API ont également empêché Argon de terminer toutes les 55 parties du Standard Harness, selon les testeurs. À faible niveau de raisonnement, le système a terminé 42 parties (49,8 %), à niveau moyen 46 parties (46,3 %). À niveau maximal, il n’a terminé que 19 parties, donc ARC Prize n’a pas publié de score. Les résultats rapportés couvrent toujours toutes les 55 parties, en incluant des points partiels pour les parties annulées.
Argon comble l’écart mais tarde en mathématiques et en codage
Le institut de recherche Epoch AI a également suivi les progrès de Google. Argon a obtenu 165 points sur l’Indice de Capacités Epoch (ECI), égalant Fable 5.1 et se classant juste après Opus 5.5 (167) ainsi que GPT-6 Astra (166). L’ECI combine plus de 50 critères de mesure dans une seule échelle de capacités, de la même manière que l’Analyse Artificielle établit son score principal.
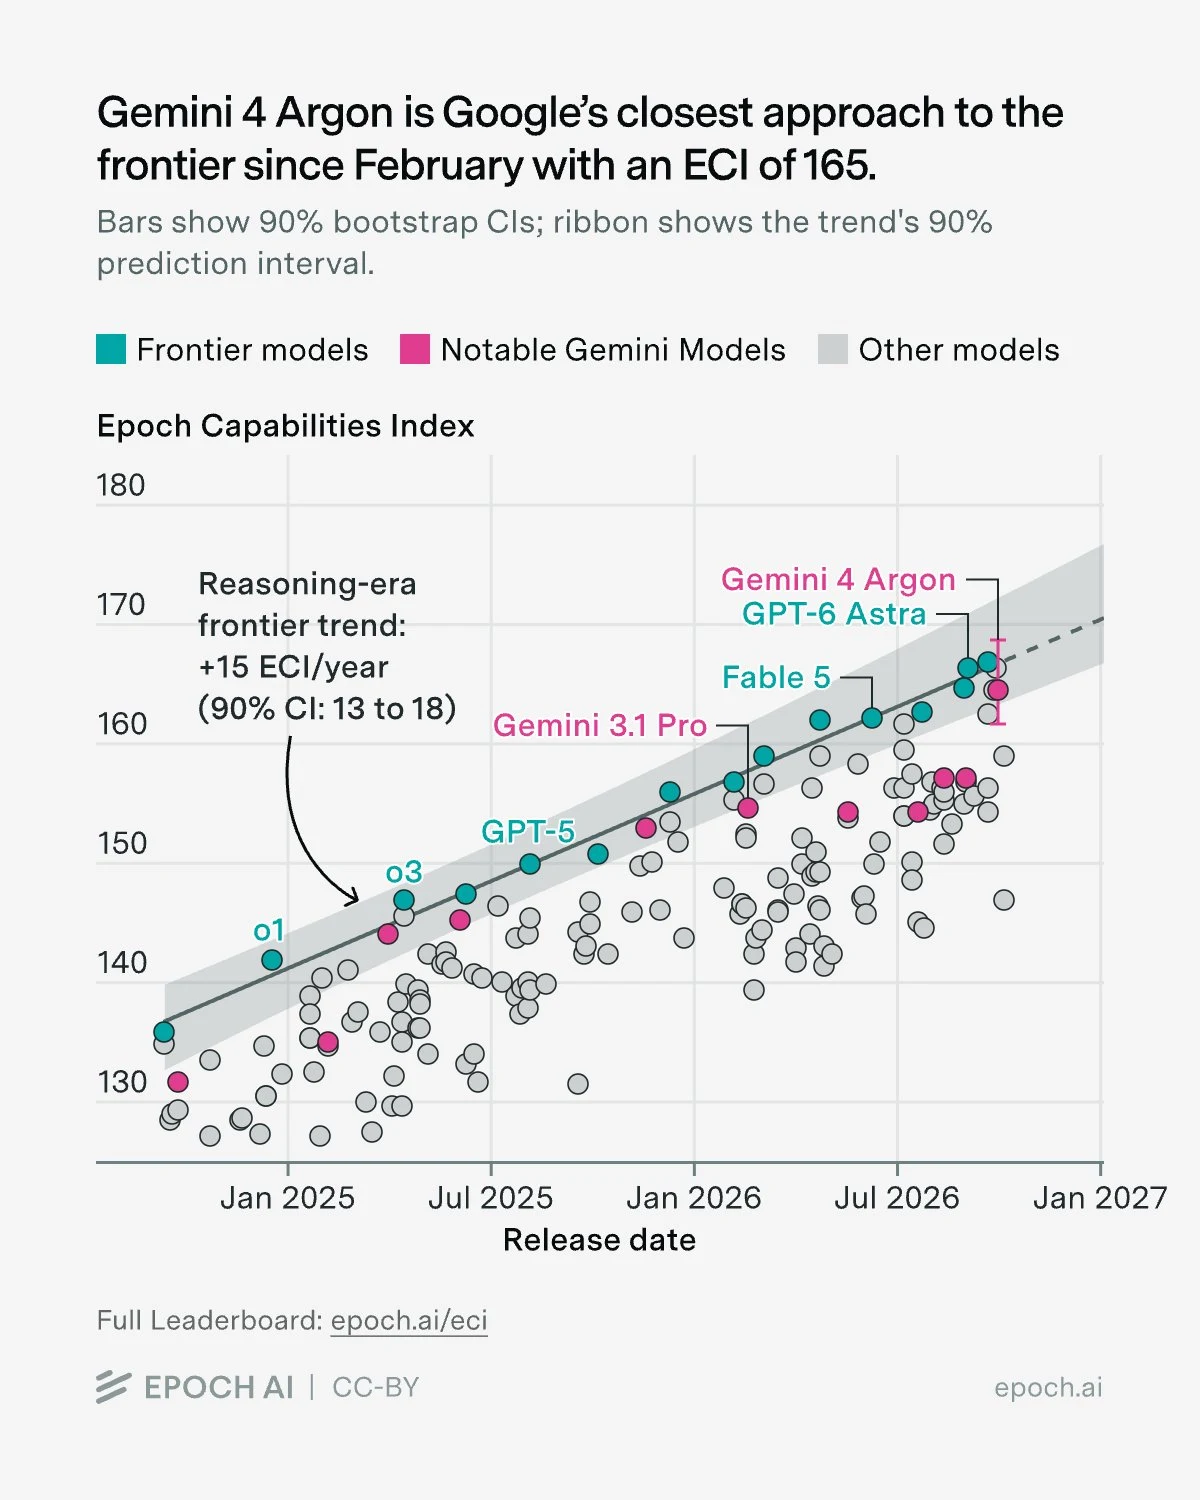
Argon se place bien devant Gemini 3.8 Flash (157 points) et rapproche Google du sommet plus que jamais depuis Gemini 3.1 Pro en février. Artificial Analysis et Vals.ai ont confirmé cette tendance auparavant.
Les performances varient selon le domaine. Selon Epoch AI, Argon se classe parmi plusieurs benchmarks de connaissances, d’agents et de vision, mais les estimations initiales le placent à la huitième place sur l’ECI de mathématiques et à la sixième place sur l’indice d’ingénierie logicielle (SWE ECI).
Nouvelles sur l’IA sans hype – sélectionnées par des humains
S’abonner à THE DECODER pour une lecture sans publicités, un bulletin informatique sur l’IA hebdomadaire, notre rapport spécial « AI Radar » en six fois par an, un accès complet aux archives, et la possibilité de commenter.
Source : EpochAI | ARC Prize