
Reflection AI a présenté Beam, un modèle à poids ouverts pour le codage agentique et les tâches à long horizon telles que la maintenance de code, l'utilisation d'outils, l'interprétation des résultats et l'accomplissement de workflows en plusieurs étapes. Cette version à poids ouverts donne aux développeurs et aux chercheurs le contrôle sur l'exécution, l'environnement de déploiement et le processus de personnalisation.
Dans cette publication, nous expliquons la vision de Reflection et montrons comment vous pouvez déployer Beam sur AWS. Commencez avec un point de terminaison temps réel Amazon SageMaker JumpStart pour une voie entièrement gérée. Lorsque vous avez besoin d'un contrôle natif de Kubernetes sur l'infrastructure GPU distribuée, utilisez Amazon SageMaker HyperPod Inference avec JumpStart, SGLang ou vLLM. Nous expliquons également comment les 501 milliards de paramètres totaux de Beam influencent le stockage des checkpoints, la mémoire des poids, le partitionnement (sharding) et le parallélisme, tandis que ses 23 milliards de paramètres actifs influencent le calcul par jeton.
Au lancement, Beam est disponible dans Amazon SageMaker JumpStart dans les régions US East (N. Virginia) et US East (Ohio).
La vision de Reflection pour une intelligence ouverte
La mission de Reflection est de rendre l'intelligence ouverte et accessible à tous grâce à des poids de modèles ouverts, à des recherches publiées et à des logiciels open source. Sa pile IA complète couvre les modèles, les logiciels fondamentaux, l'infrastructure de production et les applications. Beam apporte cette approche aux développeurs qui construisent des systèmes d'ingénierie logicielle et des systèmes agentiques.
À propos de Reflection Beam
Beam est un modèle sparse mixture-of-experts (mélange d'experts) conçu pour résoudre des problèmes logiciels, modifier du code, appeler des outils et agir sur des résultats intermédiaires. Il compte 501 milliards de paramètres totaux et 23 milliards de paramètres actifs, et Reflection fait état d'une longueur de contexte effective de 1 million de jetons.
Reflection publie les poids de Beam via Hugging Face sous la licence Apache 2.0. Beam 1.0 est disponible en variantes de checkpoints BF16, FP8 et NVFP4. Ces formats offrent différentes empreintes mémoire et différentes compatibilités matérielles. Vous pouvez déployer le modèle avec la configuration de conteneur gérée JumpStart d'AWS, ou inspecter et personnaliser le modèle avec SGLang ou vLLM dans votre environnement AWS.
Comprendre l'architecture de déploiement
Choisissez la voie de service qui répond à vos exigences de contrôle et de mise à l'échelle.
- Commencez avec un point de terminaison temps réel SageMaker JumpStart lorsque vous souhaitez un package de modèle, un point de terminaison et une API d'invocation gérés par AWS sans exploiter Kubernetes.
- Utilisez JumpStart sur HyperPod Inference lorsque vous souhaitez le conteneur et la configuration de modèle gérés par AWS sur un cluster HyperPod orchestré par Amazon Elastic Kubernetes Service (Amazon EKS).
- Utilisez SGLang ou vLLM sur HyperPod Inference lorsque vous devez contrôler l'image de service, les arguments d'exécution, la quantification ou l'exécution distribuée.
- Dimensionnez le déploiement en fonction du stockage des checkpoints, de la mémoire des poids, du cache KV, de la longueur du contexte, du batching, de la surcharge d'exécution et du parallélisme pris en charge.
- Définissez les objectifs attendus de concurrence et de latence, puis configurez les réplicas, la mise en cache, le routage et l'autoscaling à partir du comportement mesuré de la charge de travail.
La voie temps réel de JumpStart empaquète le modèle, le conteneur et le point de terminaison derrière un workflow de déploiement géré. La voie HyperPod expose le cluster et le runtime de service afin que vous puissiez contrôler l'exécution distribuée, la mise en cache, le routage et la mise à l'échelle.
Le schéma suivant montre les composants utilisés par le chemin HyperPod. Beam peut être obtenu via SageMaker JumpStart, Hugging Face Hub ou un miroir Amazon Simple Storage Service (Amazon S3) facultatif. Les travailleurs distribués utilisent le conteneur JumpStart géré par AWS ou un runtime SGLang ou vLLM personnalisé.
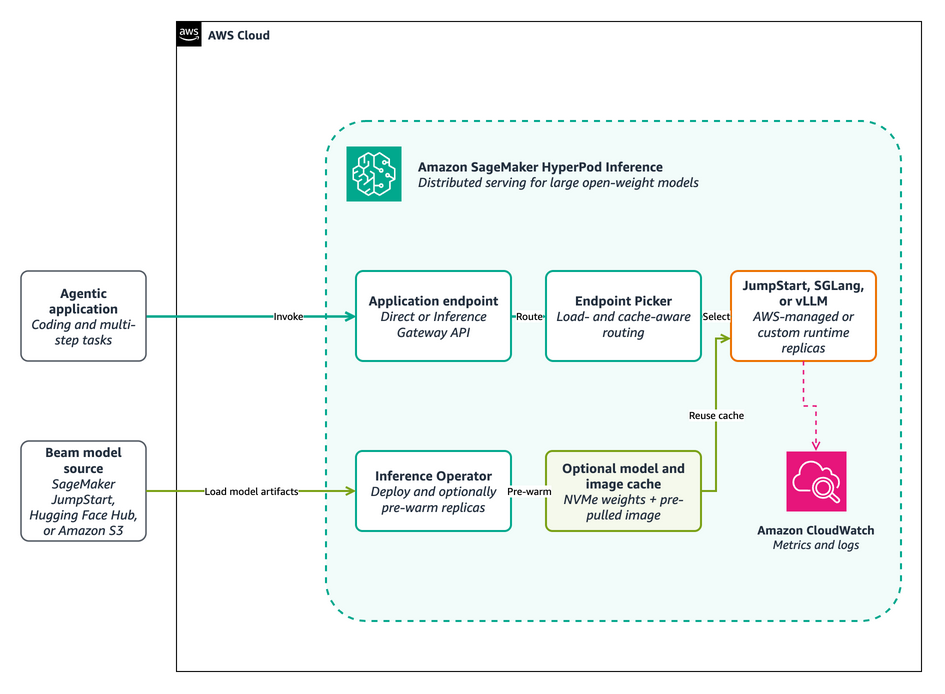
Figure 1 : Déploiement distribué de Beam avec Amazon SageMaker HyperPod Inference
Prérequis
Vous avez besoin de :
- Un compte AWS avec des autorisations pour le chemin de déploiement SageMaker sélectionné et ses ressources AWS Identity and Access Management (IAM), de mise en réseau et de stockage associées.
- Un accès à Beam via SageMaker JumpStart ou l'un des dépôts de checkpoints Beam 1.0 sur Hugging Face.
- L'acceptation des conditions du modèle, l'AWS Command Line Interface (AWS CLI) et Python 3.11 ou une version ultérieure.
- Un quota et une capacité GPU pour une configuration Beam prise en charge.
Planifier et obtenir la capacité GPU
Les 501 milliards de paramètres totaux de Beam nécessitent un déploiement multi-GPU. BF16 a le besoin de mémoire pour les poids le plus important, planifiez donc une configuration multi-nœuds avec suffisamment de mémoire GPU agrégée pour les poids et la surcharge d'exécution. Pour FP8, utilisez ml.p5.48xlarge avec des GPU NVIDIA H100 ou ml.p5e.48xlarge et ml.p5en.48xlarge avec des GPU H200. Pour NVFP4, utilisez ml.p6-b200.48xlarge avec des GPU NVIDIA B200. Confirmez que le checkpoint publié, le runtime et la disposition parallèle prennent en charge le type d'instance sélectionné.
- Calculez la mémoire pour les poids, le KV cache et la surcharge d'exécution d'un réplica, puis confirmez l'estimation avec un test de charge.
- Choisissez une Région AWS qui prend en charge l'instance accélérée requise.
- Vérifiez le quota de service et la capacité disponible pour le type d'instance sélectionné. Utilisez une capacité à la demande lorsque disponible, ou utilisez un plan de formation SageMaker comme réservation à court terme pour un travail planifié.
- Laissez le temps nécessaire pour le transfert de l'image, le téléchargement des poids, le chargement des shards et l'initialisation du runtime.
Chemin 1 : Démarrer avec un endpoint temps réel SageMaker JumpStart
Utilisez d'abord un endpoint temps réel JumpStart lorsque vous souhaitez le chemin le plus court du catalogue de modèles à un endpoint HTTPS géré. L'exemple prend en charge les IDs de modèles BF16, FP8 et NVFP4 via une seule commande sensible à la variante. Son README et son fichier Python font foi des types d'instances pris en charge, du schéma de requête, de la commande de déploiement et de la commande de nettoyage.
- Clonez le dépôt de l'exemple.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Accédez au répertoire de l'exemple de déploiement SageMaker JumpStart.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Créez et activez un environnement virtuel Python.
python3 -m venv .venv source .venv/bin/activate - Installez la dépendance de l'exemple.
python -m pip install -r requirements.txt - Exécutez le cycle de vie limité de déploiement, d'invocation et de nettoyage pour FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
La commande déploie l'endpoint FP8, envoie une courte requête, affiche la réponse et nettoie l'endpoint. Utilisez
bf16ounvfp4pour sélectionner une autre variante de checkpoint ; NVFP4 est la valeur par défaut si vous omettez--variant. Utilisez les fonctions Python du README lorsque vous devez maintenir un endpoint en cours d'exécution.
Chemin 2 : Déployer avec SageMaker HyperPod Inference
Utilisez HyperPod Inference lorsque vous avez besoin d'un contrôle natif Kubernetes sur une infrastructure GPU distribuée. Vous pouvez utiliser la configuration de conteneur JumpStart gérée par AWS ou déployer Beam avec SGLang ou vLLM. Le README de l'exemple de déploiement HyperPod Inference et ses fichiers de configuration font foi des manifestes publiés, des identifiants de modèle et d'image, des versions de runtime prises en charge et des commandes.
Avant de commencer, configurez kubectl l'accès à un cluster HyperPod orchestré par EKS avec l'HyperPod Inference Operator et les add-ons requis. Vous avez également besoin du virtual private cloud (VPC) du cluster, des sous-réseaux, des groupes de sécurité, de l'accès aux artefacts Beam et runtime sélectionnés, et d'une capacité NVMe locale si vous activez la mise en cache des modèles. Utilisez un jeton d'accès Hugging Face isolé si le dépôt sélectionné nécessite une authentification.
Déployez une révision épinglée de Beam depuis Hugging Face Hub pour le développement et l'expérimentation. Pour les déploiements de production et la mise en cache des modèles, copiez le checkpoint vers Amazon S3 ou Amazon FSx. La mise en cache de modèles et d'images HyperPod peut précharger les poids sur le stockage NVMe local des nœuds et pré-télécharger l'image de service.
La HyperPod Inference Gateway fournit une interface compatible OpenAI et achemine les requêtes entre les réplicas. HyperPod Inference prend également en charge la mise en cache KV hiérarchisée gérée et le routage intelligent. Ce sont là quelques-unes des capacités Amazon SageMaker Inference introduites en 2026.
Le schéma suivant détaille le flux de préparation des modèles et de requêtes au runtime. Lorsque la mise en cache des modèles est activée, l'Inference Operator préchaarge les nœuds éligibles avec les poids et l'image de service sélectionnés. Au runtime, l'Inference Gateway et l'Endpoint Picker peuvent diriger chaque requête vers un réplica JumpStart géré, SGLang ou vLLM approprié.
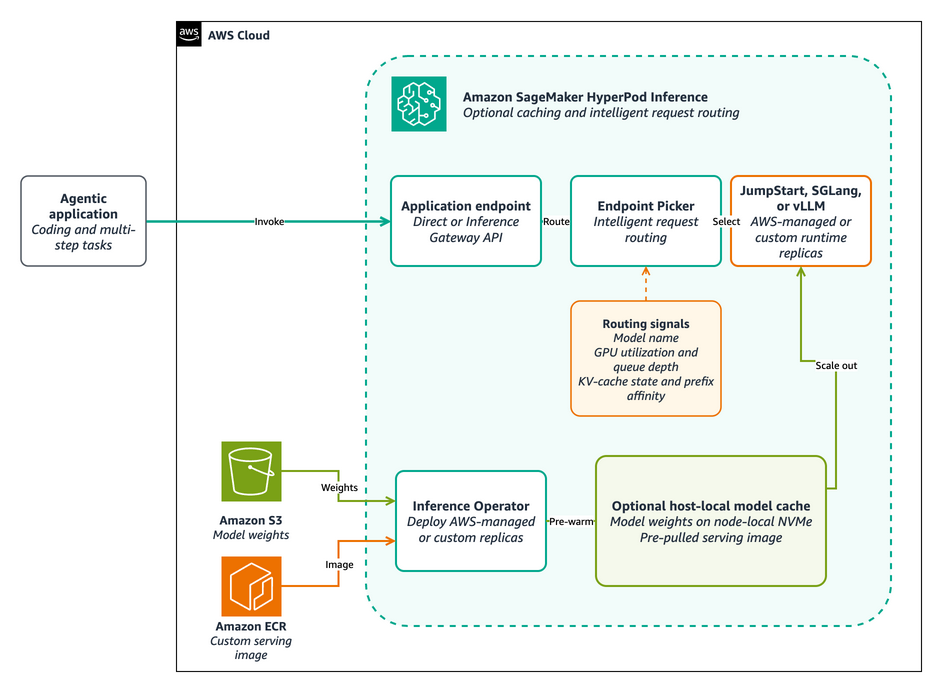
Figure 2 : mise en cache des modèles HyperPod et routage des requêtes
Préparer les artefacts de déploiement
Utilisez des entrées immuables afin de pouvoir reproduire les résultats de déploiement et de performance.
- Utilisez la version du modèle JumpStart enregistrée dans l'exemple de déploiement.
- Choisissez le checkpoint BF16, FP8 ou NVFP4 pour un runtime personnalisé.
- Pour un runtime personnalisé, conservez le SHA de commit public de Beam et le digest de l'image dans la configuration de version de l'exemple.
- Répliquez l'image publiée dans un dépôt Amazon Elastic Container Registry (Amazon ECR) privé uniquement si votre cluster ne peut pas extraire l'image en amont ou si votre organisation exige un registre approuvé.
- Ne placez pas dans le dépôt les jetons, les secrets générés, les identifiants de modèle privés, les informations d'identification du registre et les résultats non publiés.
Choisir un chemin de service
Commencez avec SageMaker JumpStart, sauf si votre charge de travail nécessite un runtime d'inférence ou une configuration spécifique.
| Chemin de service | Quand l'utiliser | Ce que vous gérez |
| SageMaker JumpStart | Vous souhaitez un conteneur et une configuration de modèle gérés par AWS avec moins de maintenance du runtime. | Sélectionnez la version du modèle Beam, le type d'instance pris en charge, la configuration du point de terminaison et la politique de mise à l'échelle. |
| SGLang ou vLLM | Vous avez besoin d'un runtime d'inférence ou d'une configuration spécifique, tels que des arguments de runtime personnalisés, des parseurs, la quantification ou le parallélisme. | Épinglez l'image de runtime prise en charge, la révision du modèle, la configuration du parseur et les paramètres d'exécution distribuée. |
Déployer avec SageMaker JumpStart
SageMaker JumpStart réduit le travail d'intégration des conteneurs tandis que HyperPod conserve le contrôle de la capacité du cluster, de la mise à l'échelle et de l'observabilité.
- Dans SageMaker Studio, ouvrez le catalogue de modèles JumpStart.
- Sous All public models, choisissez Beam.
- Choisissez SageMaker HyperPod comme cible de déploiement.
- Sélectionnez le cluster et l'espace de noms Kubernetes.
- Saisissez un nom de point de terminaison, puis choisissez Deploy.
- Confirmez le statut du déploiement avant d'invoquer le point de terminaison avec le schéma de requête JumpStart publié.
Pour un flux de travail d'infrastructure sous forme de code, utilisez la configuration JumpStart publiée dans l'exemple HyperPod. Vous pouvez inspecter le modèle de manifeste reflection-beam-jumpstart.yaml avant de configurer le déploiement.
- Clonez le dépôt d'exemple et entrez dans le répertoire HyperPod Beam.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Créez les fichiers de configuration locaux décrits dans le README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validez la configuration JumpStart avant de modifier le cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Déployez la configuration JumpStart.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
L'outil auxiliaire génère et applique la ressource JumpStartModel publiée sans écrire les valeurs de release renseignées sur le disque.
Déployer avec SGLang ou vLLM
Choisissez SGLang ou vLLM lorsque vous avez besoin d'un contrôle direct sur le runtime de service. Avant de configurer le déploiement, inspectez le modèle de manifeste reflection-beam-sglang.yaml ou le modèle de manifeste reflection-beam-vllm.yaml. Le README de l'exemple demeure la source de vérité pour les valeurs et commandes publiées.
- Clonez le dépôt d'exemple.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Accédez au répertoire HyperPod Beam.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Créez les fichiers de configuration locaux décrits dans le README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validez la configuration sélectionnée avant de modifier le cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Déployez Beam, puis attendez un état de déploiement terminal.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
Remplacez
sglangparvllmpour utiliser vLLM. L'utilitaire valide les paramètres sélectionnés, applique le manifeste généré sans écrire les valeurs de release sur le disque, attend avec un délai fixe et affiche des informations de diagnostic si le déploiement échoue.
Invoquez Beam
Invoquez des endpoints JumpStart avec le schéma de requête du modèle publié. Pour SGLang ou vLLM, utilisez le test de fumée limité inclus dans l'exemple HyperPod.
Invoquez l'endpoint déployé
- Installez la dépendance du client d'exemple.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Exécutez une vérification de santé privée et une courte requête avec les paramètres d'échantillonnage de démarrage recommandés.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
Remplacez
sglangparvllmpour un déploiement vLLM. L'utilitaire sélectionne un worker prêt, ouvre un port-forward temporaire, vérifie la santé de l'endpoint, envoie la requête et ferme le port-forward.
La réponse ressemble à ceci :
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
Pour une Inference Gateway authentifiée, utilisez la procédure de jeton porteur dans le README de l'exemple HyperPod. Ne conservez pas les identifiants dans le code source, les manifestes ni l'historique des commandes.
Mesurer et ajuster les performances
- Testez chaque chemin de service avec des requêtes répétées et représentatives de codage et d'utilisation d'outils à la concurrence attendue.
- Enregistrez la version du modèle Beam, le digest de l'image, le type d'instance, la précision, la longueur du contexte, le parallélisme, les arguments de service, l'état du cache et le nombre de répétitions du test.
- Mesurez le taux de réussite des requêtes, le temps jusqu'au premier token p50 et p95, le temps par token de sortie, la latence de bout en bout et le nombre total de tokens de sortie par seconde.
- Ajustez la taille de lot, l'allocation du cache KV, le nombre de réplicas, l'autoscaling ainsi que la mise en cache du modèle et de l'image à partir de ces résultats.
- Revérifiez la qualité des sorties après avoir modifié la précision ou la quantification.
Nettoyage
Supprimez les ressources lorsque vous avez terminé les tests pour éviter des frais continus.
- Pour un endpoint temps réel SageMaker JumpStart, suivez les instructions de nettoyage dans le README de l'exemple de déploiement SageMaker JumpStart.
- Pour JumpStart, SGLang ou vLLM sur Amazon SageMaker HyperPod Inference, suivez les instructions de nettoyage dans le README de l'exemple de déploiement HyperPod Inference.
- Supprimez un cluster HyperPod ou Amazon EKS dédié créé pour la procédure.
- Supprimez les poids en cache inutilisés, les artefacts en miroir, les répartiteurs de charge, les groupes de journaux, les rôles IAM temporaires et les données d'inférence capturées.
Conclusion
Reflection Beam offre aux développeurs un modèle à poids ouverts conçu pour le codage agentique et les tâches multi-étapes. Commencez avec un endpoint temps réel SageMaker JumpStart pour un déploiement entièrement géré. Utilisez SageMaker HyperPod Inference avec JumpStart lorsque vous avez besoin d'un contrôle d'infrastructure natif Kubernetes sans gérer le conteneur de service, ou choisissez SGLang ou vLLM lorsque vous avez besoin d'un runtime personnalisé.
Utilisez l' exemple de déploiement SageMaker JumpStart ou l' exemple de déploiement HyperPod Inference, puis suivez les instructions.
Pour en savoir plus sur Reflection AI et sa vision d'une intelligence ouverte, visitez Reflection AI et lisez Introducing Beam.
Ressources
- Variantes de checkpoint Reflection Beam : BF16, FP8, et NVFP4
- Exemple de déploiement SageMaker JumpStart
- Exemples de déploiement HyperPod Inference avec JumpStart, vLLM et SGLang
- Déployer des modèles de fondation de SageMaker JumpStart vers HyperPod Inference
- Bilan des lancements d'Amazon SageMaker Inference depuis le début de l'année 2026