
01 Premier du classement sur les trois benchmarks : Thinker-WM décroche trois premières places
Récemment, Thinker-WM d'UBTECH a obtenu la première place sur les trois benchmarks reconnus de modèles du monde embarqués, établissant un nouveau record dans le secteur :
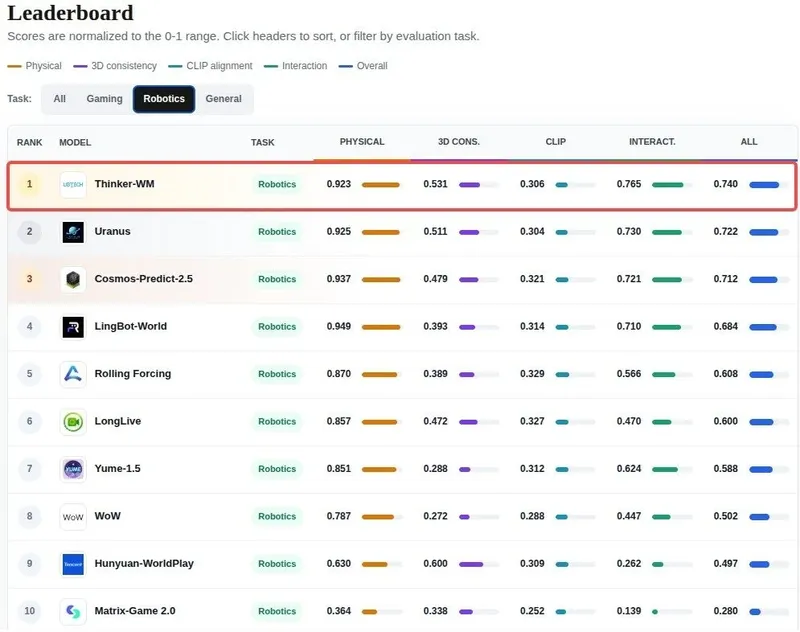
WorldOlympiad:
Thinker‑WM obtient un score global de 0.740 et se classe en tête. Ce benchmark est construit à partir d'une grande quantité de données d'interaction robotiques réelles, couvrant plus de dix types de robots différents et plusieurs configurations de caméras, et évalue principalement la capacité de généralisation du modèle à travers différentes morphologies de robots et différents points de vue. Le modèle atteint une cohérence 3D de 0.531 et une fidélité d'interaction de 0.765, deux indicateurs individuels classés premiers parmi tous les modèles participants, démontrant sa capacité de modélisation précise des structures géométriques tridimensionnelles et des processus d'interaction robotiques.
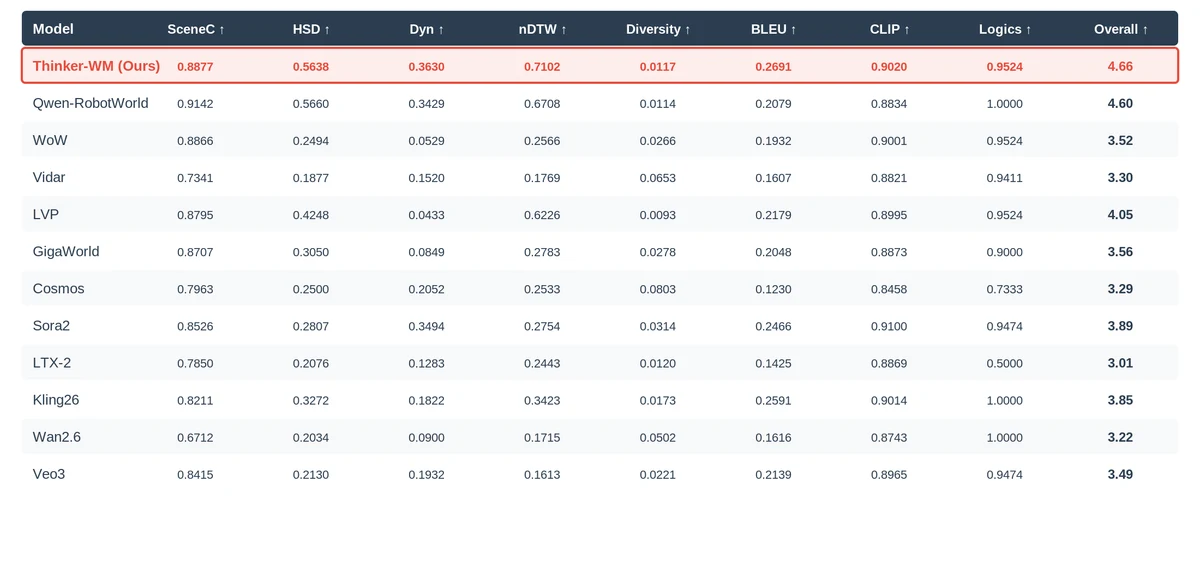
EWMBench :
Thinker‑WM obtient un score global de 4.66, dépassant les modèles de référence tels que Qwen‑RobotWorld et Sora2. EWMBench évalue intégralement trois dimensions de capacités : la cohérence des scènes, la justesse du mouvement des effecteurs robotiques et l'alignement sémantique des instructions. Grâce à la modélisation conjointe multimodale au niveau de la représentation, Thinker‑WM est en tête sur les indicateurs clés du mouvement robotique tels que le nDTW (Normalised Dynamic Time Warping, qui reflète l'adéquation spatio-temporelle des trajectoires du robot) et le Dyn (cohérence dynamique, qui représente la plausibilité de la vitesse et de l'accélération du mouvement).
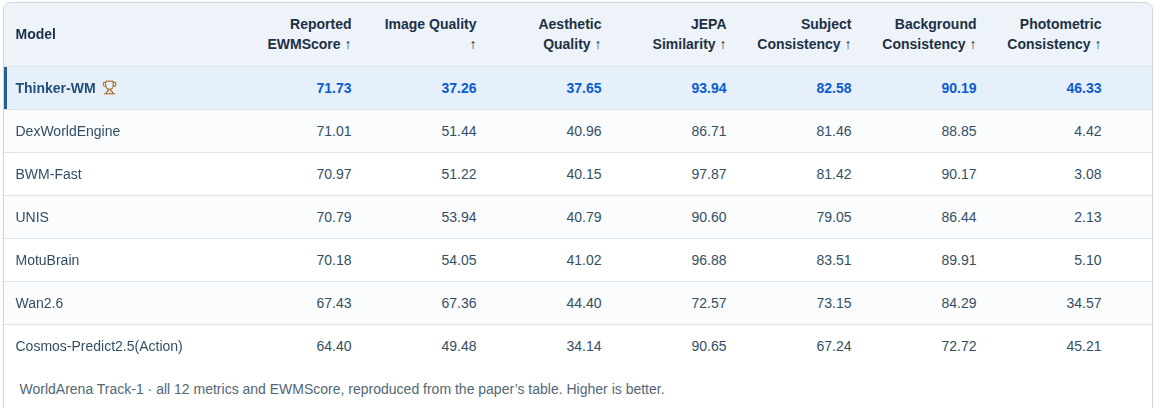
WorldArena1.0 Track-1 :
Sur le benchmark en environnement simulé WorldArena Track‑1, Thinker‑WM est globalement en tête sur 12 dimensions d'évaluation clés telles que la qualité visuelle, la cohérence du contenu, la plausibilité physique, la précision géométrique 3D et le suivi des instructions, alliant qualité de génération visuelle et crédibilité des interactions physiques en environnement simulé. Thinker‑WM s'appuie sur son Unified Dynamic Transformer (UDT), une couche de représentation unifiée, pour faire évoluer conjointement les images RGB, la profondeur métrique et les actions du robot au sein d'un même espace de représentation dynamique partagé, réalisant ainsi en un seul modèle la génération conjointe vidéo-action, la prédiction du monde, le raisonnement de politique, la conversion vidéo-action, la dynamique inverse et bien d'autres capacités, fournissant un nouveau socle fondamental de modèle du monde pour l'intelligence embarquée.
02 Percées techniques de Thinker-WM : une unification multimodale de la vision, de la géométrie et de l'action au niveau de la représentation
Pour qu'un robot travaille réellement dans le monde réel, la difficulté ne réside pas dans la reconnaissance des objets devant lui, mais dans l'anticipation des changements à venir de l'environnement. C'est précisément là la valeur et la raison d'être d'un modèle du monde. Or, les modèles du monde passés adoptaient généralement une approche « par assemblage » : la génération vidéo s'occupait des images, le réseau de politique des actions, et la prédiction géométrique des informations spatiales ; les modules calculaient indépendamment, puis leurs sorties étaient assemblées via des interfaces.
Le problème de cette architecture technique réside dans le fait que l'action modifie l'environnement, que l'environnement contraint l'action, et que la structure géométrique influence les deux à la fois ; des signaux étroitement couplés physiquement sont ainsi séparés entre différents modules, perdant leurs liens causaux intrinsèques.
Prenons un exemple : « une tasse est poussée du bout de la table » est, en langage, une phrase descriptive ; en action, une série de commandes articulaires ; en vidéo, un mouvement d'objet traversant l'image ; en profondeur, un champ de distances variant continûment. Quatre représentations pointent vers le même événement, et non vers quatre objets différents. Demander au modèle de générer l'une ou l'autre de ces formes revient donc, en substance, à interroger le même processus.
Mais ce recouvrement est incomplet. L'action ne porte ni l'apparence ni le contexte : les mêmes commandes articulaires n'ont pas du tout le même sens sur une table vide que sur une table encombrée. Le langage ne porte pas non plus les détails spatio-temporels : la phrase « la tasse est poussée du bout de la table » ne précise ni de quel côté pousser, ni avec quelle force, ni à quelle vitesse, ni la trajectoire exacte de la main, ni le nombre de tours que fait la tasse, ni l'endroit où elle finit par tomber. La vidéo ne porte ni géométrie explicite ni mesures : elle n'est qu'une suite de pixels, ignorant aussi bien la taille de la tasse que sa distance. La profondeur ne porte ni apparence, ni sémantique de dénomination, ni intention : elle indique où se trouve la surface, comment elle s'oc culte et comment elle entre en contact, mais ne vous dit pas s'il s'agit d'une tasse ou d'une nappe, et encore moins pourquoi on la pousse.
Face à ce problème, l'équipe Thinker d'UBTECH propose une solution inédite : ne pas se contenter d'une simple fusion au niveau des interfaces, mais réaliser l'unification multimodale au niveau de la représentation. Thinker-WM (Thinker World Model), modèle du monde multimodal unifié développé en interne par UBTECH, encode les vidéos RGB, la profondeur et les actions du robot dans un même espace de représentation intermédiaire, évoluant conjointement grâce à un ensemble de paramètres partagés. L'apparence, la géométrie et l'action ne sont plus trois pipelines indépendants, mais trois formes d'expression du même processus d'évolution du monde. Autrement dit, la logique de conception sous-jacente de Thinker-WM peut se résumer ainsi : les différentes modalités sont des formulations différentes d'un même processus ; le modèle les aligne dans un espace de représentation partagé et effectue son raisonnement sur cette représentation partagée, plutôt que de combiner des conditions au niveau des interfaces entre modalités.
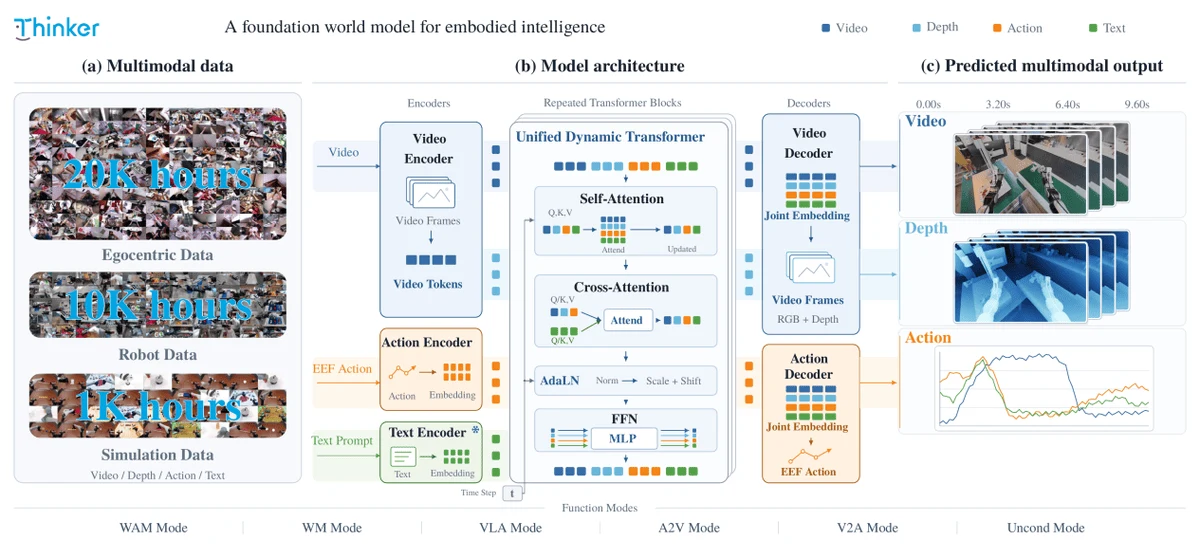
Thinker-WM : un cadre de modélisation unifié de la vision, de la géométrie et de l'action
Concrètement, les images RGB, les informations de profondeur et les actions du robot sont respectivement mappées par leurs propres encodeurs vers un espace latent unifié, puis envoyées dans l'Unified Dynamics Transformer (UDT) partagé pour une modélisation temporelle conjointe, avant que leurs décodeurs respectifs ne restituent les vidéos, les cartes de profondeur et les actions exécutables du robot. Cela signifie que les interactions multimodales se produisent à l'intérieur du Transformer : les tokens visuels, géométriques et d'action échangent directement des informations via un même mécanisme d'attention, au lieu d'une simple concaténation superficielle aux couches d'entrée ou de sortie.
L'information géométrique n'est plus non plus un simple signal de supervision auxiliaire. Thinker-WM traite la profondeur comme une modalité générative native, partageant avec la vidéo la même topologie latente et la même organisation spatio-temporelle. La supervision par la profondeur façonne directement la représentation partagée, faisant de la structure de l'espace physique la « langue maternelle » du modèle du monde plutôt qu'un module complémentaire ajouté après coup, aidant ainsi les robots humanoïdes à comprendre plus précisément l'espace physique. La valeur de cette modélisation unifiée se manifeste aussi dans les performances d'exécution réelles du robot. Dans les expériences d'ablation en tâche unique sur RoboTwin, l'introduction de la modalité de profondeur a amélioré le taux de réussite des opérations de 15 points de pourcentagepar rapport à la ligne de base sans profondeur, montrant que l'information géométrique spatiale aide non seulement le modèle à comprendre la scène, mais améliore aussi la génération d'actions et l'exécution des tâches.
03 3万 heures de données hétérogènes : un seul modèle, six capacités débloquées
Grâce à la représentation multimodale unifiée, où toutes les modalités partagent le même ensemble de paramètres, Thinker-WM peut prendre en charge six modes de capacités en basculant librement entre modalités de conditionnement et modalités génératives.
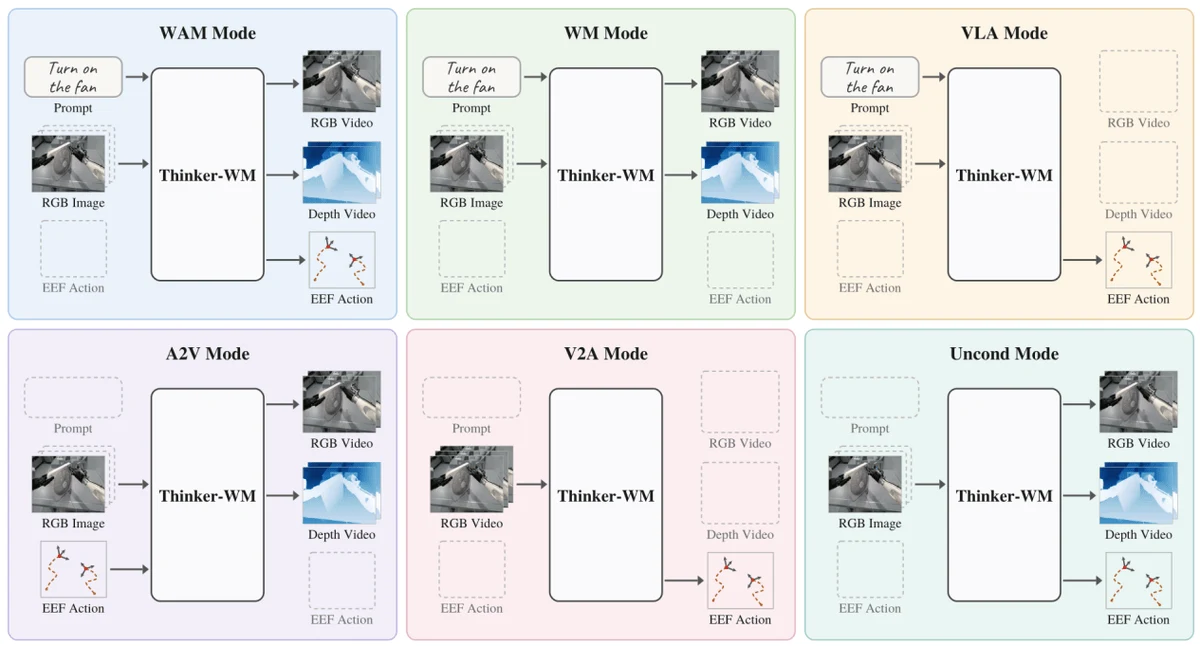
Un seul et même jeu de poids permet à la fois d'anticiper et d'imaginer des images futures, de déduire à rebours les trajectoires d'exécution du robot, et d'extraire des informations d'action des vidéos : c'est là le principal bénéfice technique apporté par la représentation unifiée.
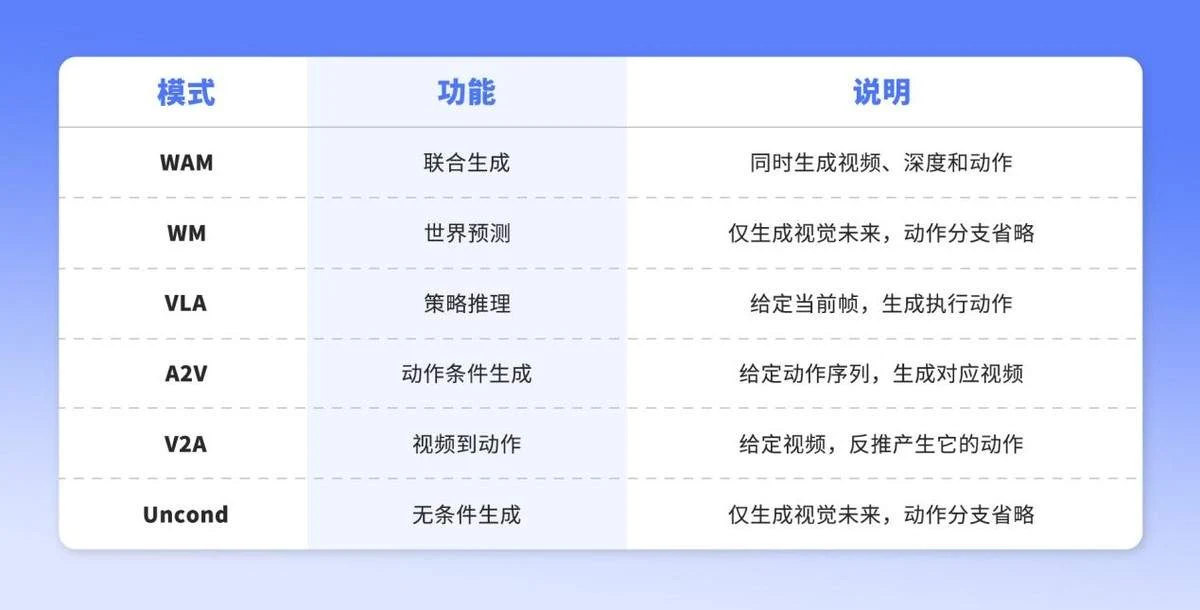
04 3万 heures de données hétérogènes : le socle d'un modèle du monde généraliste
Derrière cette capacité de représentation unifiée se trouvent des données d'entraînement abondantes et diversifiées fournies par UBTECH. Le corpus d'entraînement de Thinker-WM atteint un volume considérable dans le domaine de l'intelligence embarquée :
- environ 2万 heures de vidéos humaines en première personne: couvrant des scènes domestiques, commerciales, de vente au détail et industrielles, elles compensent la difficulté d'acquérir à faible coût par téléopération la diversité des tâches, des objets et des scènes, accompagnées d'environ 1千 heures de données de profondeur alignées.
- environ 1万 heures de données robotiques réelles: provenant de plusieurs robots de morphologies différentes, elles fournissent une supervision appariée entre observations visuelles et actions exécutables, dont environ 3千 heures accompagnées d'annotations de profondeur alignées.
- environ 1千 heures de données de simulation: fournir des signaux de supervision géométriques et physiques de haute précision.
Les espaces d'action, les systèmes de coordonnées et les protocoles de contrôle des différents robots présentent d'énormes différences. L'approche unifiée de Thinker-WM s'applique non seulement à l'architecture du modèle, mais aussi à la sélection des données. Ce modèle utilise uniformément la pose de l'effecteur terminal pour représenter les actions de tous les robots, tout en intégrant dans les tokens des étiquettes propres à chaque robot. Ainsi, des robots de morphologies différentes peuvent partager un même espace génératif tout en conservant des capacités précises de contrôle proprioceptif.
05 Data Infra : permettre à des masses de données hétérogènes de soutenir efficacement l'entraînement d'un modèle unifié
Pour transformer des masses de données en capacités du modèle, une infrastructure de données stable et efficace est indispensable. Face aux différences de format, de modalité et d'annotation entre les données de différents robots, les vidéos humaines et les données de simulation, l'équipe Thinker d'UBTECH a construit le Data Factory, qui découple la gestion des données de l'échantillonnage pour l'entraînement, permettant de combiner flexiblement des données multi-sources selon les besoins du modèle.
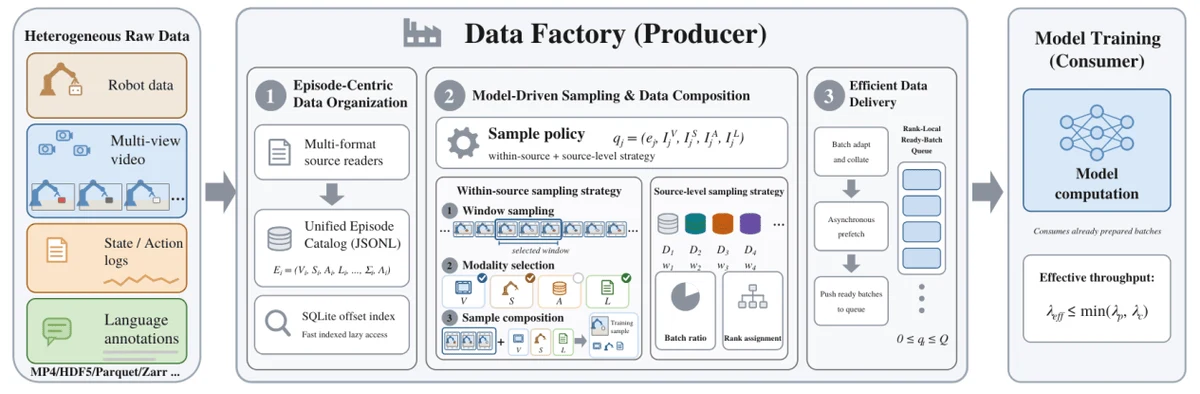
Data Factory : de données multi-sources hétérogènes à l'entraînement d'un modèle unifié
Data Factory soutient l'entraînement autour de trois maillons clés :l'organisation unifiéedes informations vidéo, d'état, d'action et de langage, générant à la demande les échantillons nécessaires aux différents modes d'entraînement ; viaun contrôle qualité hiérarchiséfiltrer les segments anormaux et vérifier l'alignement entre profondeur et vidéo, afin de garantir la fiabilité des signaux d'entraînement ; viala prélecture asynchrone et la réutilisation de l'encodagepréparer à l'avance les données d'entraînement, réduisant l'attente et les calculs redondants.
Cette infrastructure de données permet d'organiser, de mobiliser avec souplesse et de fournir efficacement des données hétérogènes de sources multiples, offrant un support d'ingénierie pour l'entraînement conjoint et l'itération continue des six modes de capacités de Thinker-WM.
06 Grâce à une conception expérimentale par Motion Probe, une expérience légère : vérifier le véritable couplage des représentations multimodales
Unifier les modalités au niveau de la représentation semble être une innovation architecturale, mais une question centrale se pose : le modèle apprend-il réellement, dans un espace partagé, les relations de couplage entre vision, géométrie et action, ou se contente-t-il de traiter en parallèle plusieurs flux d'informations en juxtaposant simplement les différentes modalités ?
Pour répondre à cette question, l'équipe Thinker d'UBTECH a conçu une expérience de validation légère : le Motion Probe (sonde de mouvement). L'équipe de recherche a attaché une minuscule tête de prédiction de mouvement aux représentations visuelles gelées de l'UDT, en n'entraînant que cette tête, pour voir si le déplacement de l'exécuteur terminal pouvait être reconstitué à partir des seules représentations visuelles.
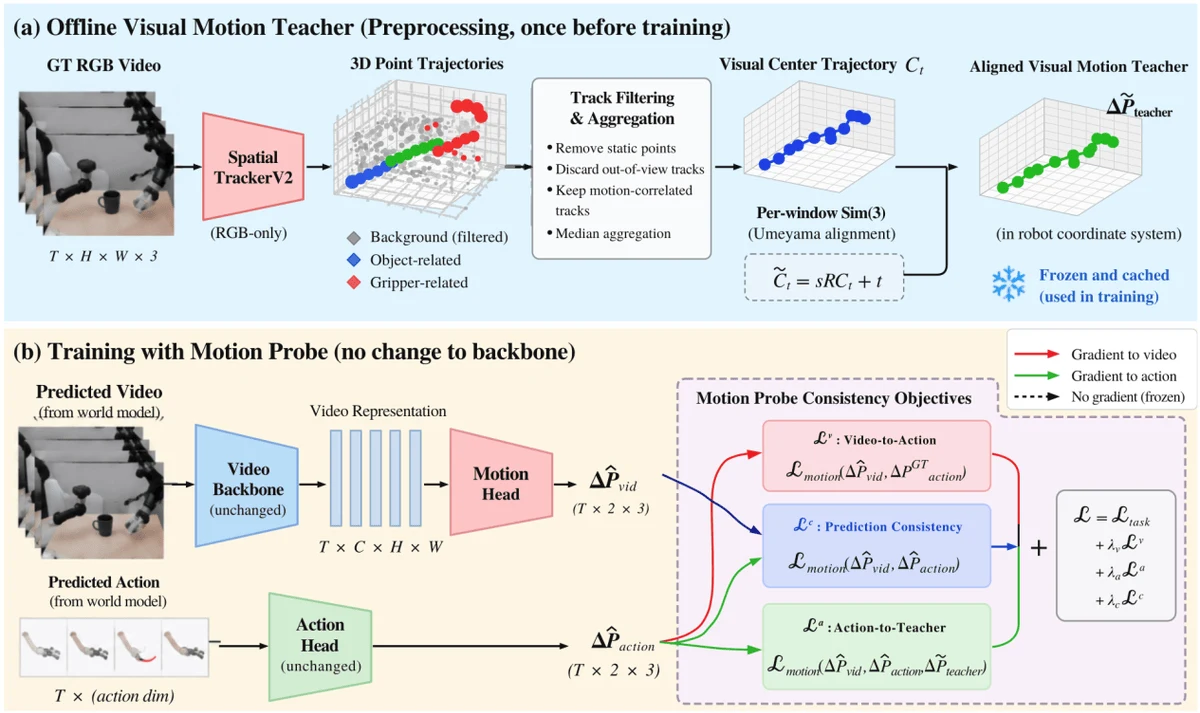
Schéma du Motion Probe
Les résultats expérimentaux confirment l'hypothèse : l'erreur de prédiction de la sonde est très faible. Même sans supervision d'action, les représentations visuelles encodent déjà des informations de mouvement liées à l'action. Ce résultat prouve directement que l'unification multimodale au niveau de la représentation fonctionne réellement : la perception visuelle et la planification d'action ne sont pas deux chaînes indépendantes, mais réalisent un couplage profond dans un espace latent partagé.
07 Qu'est-ce que cela signifie
Cela montre en outre que la valeur de la percée technologique de Thinker-WM va bien au-delà d'un simple résultat en tête des classements. Elle indique un nouveau paradigme fondamental pour les modèles de monde incarnés :
le modèle de monde de l'intelligence incarnée ne devrait pas être une simple combinaison « générateur vidéo + tête de stratégie », mais un processus génératif complet et unifié — l'observation visuelle, la structure spatiale et la planification d'action sont différentes expressions d'un même processus du monde physique.
Lorsqu'un robot peut dérouler simultanément, dans un même espace de représentation, l'évolution des images, la structure spatiale et les trajectoires d'action, sa compréhension de la logique causale du monde physique franchit un grand pas. C'est là la transition clé permettant au robot de passer de « capable d'exécuter des tâches » à « capable de comprendre le monde réel ».
Thinker-WM a achevé son déploiement et sa validation sur la plateforme robotique d'UBTECH, et les technologies associées continueront de doter les systèmes d'intelligence incarnée de nouvelle génération.
L'exploration de Thinker-WM ne s'arrête pas à cette publication. Le rapport technique du modèle et ses versions itératives ultérieures seront mis à jour en continu sur Thinker Cosmos, la communauté officielle des développeurs en intelligence incarnée d'UBTECH ; le programme d'ouverture des capacités de développement secondaire du modèle de monde ainsi que l'annonce des lives d'explication technique seront également communiqués aux développeurs dans les meilleurs délais. Rejoignez Thinker Cosmos (https://thinkercosmos.ubtrobot.com/) pour construire ensemble l'écosystème de l'intelligence incarnée.
Lien du projet
Lien de l'article : https://arxiv.org/abs/2610.18447
Adresse du projet : https://thinkercosmos.ubtrobot.com/thinker-wm
Github : https://github.com/UBTECH-Robot/Thinker-WM
Huggingface : https://huggingface.co/UBTECH-Robotics/Thinker-WM
Cet article est fourni par UBTECH et reposté par QbitAI avec autorisation ; les opinions appartiennent à l'auteur original.