
Jin Lei, depuis Shenzhen
Quantum Bit | Chaîne publique QbitAI
La peur est une manière très mauvaise de prendre des décisions.
Lorsque les entreprises craignent de manquer la fenêtre d’adaptation à l’IA, le CTO d’Amazon Werner VogelsRemarque : plus vous êtes pressé, plus il est nécessaire de réfléchir clairement : quelle problème l’entreprise doit-elle résoudre et en quoi l’IA peut-elle aider.
Aujourd’hui, de nouveaux modèles apparaissent chaque semaine. Plus on les regarde, plus on devient anxieux, craignant que chaque pas soit lent. Le désir d’améliorer l’efficacité et d’innover devient de plus en plus urgent, mais on ne se soucie pas vraiment de savoir ce que la technologie peut faire réellement.
Lors d’une réunion à Shenzhen, il a déclaré ouvertement que les entreprises ne fermeraient pas immédiatement parce qu’elles n’utilisent pas l’IA pour l’instant. Par conséquent, avant de prendre une décision, les entreprises doivent permettre aux ingénieurs et aux managers d’apprendre pleinement et de comprendre la capacité technologique.
Mais ces mots prononcés par Werner ont un peu quelque chose de contradictoire.
Après tout, cet ancien technicien à la tête du CTO d’Amazon depuis plus de vingt ans ne veut jamais accepter l’impossible. Lorsqu’il parle des histoires cachées du cloud computing, il cite spécialement une phrase de la pionnière informatique Grace Hopper pour rappeler aux développeurs de rester vigilant face à cette affirmation : « Nous avons toujours fait cela ».
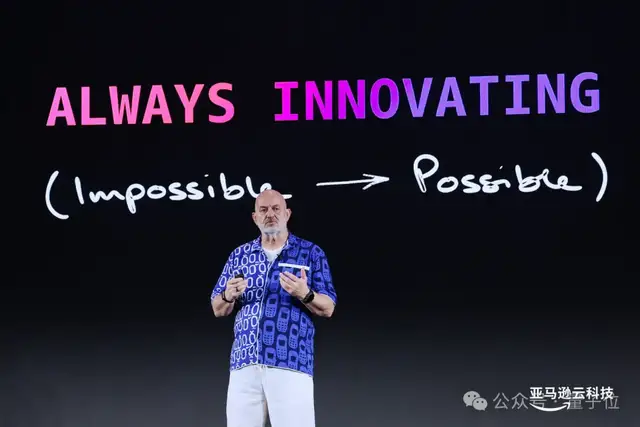
Une personne qui encourage constamment les ingénieurs à briser les conventions, pourquoi, avec l’IA, ils demandent-ils d’abord à se reposer un peu ?
L’incident de base de données dont il parle pourrait expliquer cette attitude apparemment contradictoire.
Les problèmes rencontrés avec la base de données, l’IA doit-elle les rencontrer à nouveau ?
Le 12 décembre 2004, Amazon se trouvait au point clé de la saison de shopping Noël. À l’époque, les clients pouvaient bénéficier d’un livraison gratuite pour chaque achat de 25 dollars, mais le transport prenait du temps. Si l’achat était effectué plus tard, le colis risquait de ne pas arriver à temps pour Noël.
C’est justement ce jour-là que le disque partagé derrière la base de données client a rencontré un problème, les utilisateurs ne pouvaient pas se connecter ni passer une commande. Selon les souvenirs de Werner, ce dysfonctionnement a duréplus de douze heures, entraînant pour Amazonune perte de plusieurs millions de dollars.
Le fournisseur de bases de données est ensuite venu à la maison. Werner pensait que l’autre partie se excuserait sérieusement, mais ce qu’il a entendu, c’est « Vous devriez faire des tests appropriés ».
Quand un problème survient sur le produit de notre propre entreprise, pourquoi blâmer les clients ?
Werner était bien en colère, mais il a ensuite réalisé que l’envergure d’Amazon dépassait vraiment les limites du logiciel commercial conçu pour cela. Continuer à discuter avec les fournisseurs ne résoudrait pas le prochain problème.
Ainsi, l’équipe a commencé à enquêter sur une question plus fondamentale. Comment Amazon utilise-t-il les bases de données ?
Les résultats de l’enquête montrent que environ 70 % des scénarios d’utilisation de bases de données relationnelles nécessitent uniquement une accès par clé-valeur.
Pour ce qui est du panier de commande, le système a généralement besoin de récupérer le panier correspondant en fonction de l’identifiant utilisateur. Amazon n’a pas besoin de charger tous les paniers de commande des utilisateurs pour effectuer une requête complexe.
Comme la demande est telle, le groupe pourrait-il choisir une autre méthode de réalisation ? En pensant en fonction des vrais modes d’accès, ils ont créé un système de stockage de clés-valeurs Dynamo, qui est le prédécesseur de DynamoDB.
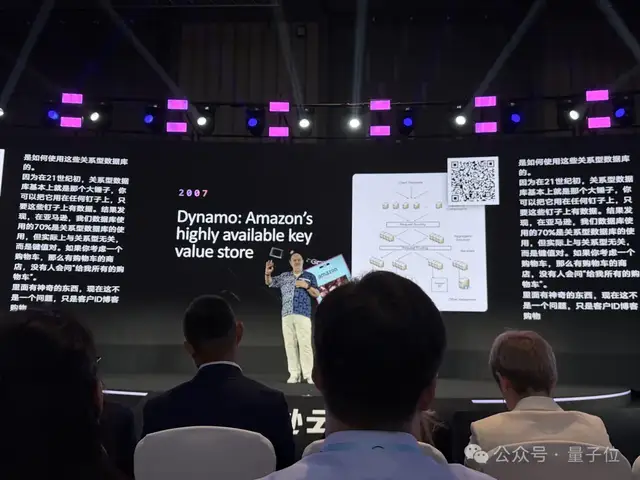
Cette expérience, aujourd’hui, donne une impression de déjà-vu. À l’époque, tout le monde utilisait un grand marteau en base de données relationnelles pour résoudre divers problèmes de données, et aujourd’hui, les grands modèles de langage deviennent également un outil très pratique.
En ce qui concerne l’utilisation de l’IA par les entreprises, c’est une question similaire que Werner a répété plusieurs fois. Quel est exactement l’objectif des entreprises ? L’IA est-elle adaptée ? La génération actuelle d’IA est-elle appropriée ?
Il rappelle que dans les domaines tels que la reconnaissance d’images, le traitement de la voix et la prédiction, de nombreuses méthodes efficaces ont déjà été accumulées. Avant de choisir une technologie, l’entreprise doit d’abord examiner le travail en question. Même avec de grandes modèles, il n’est pas nécessaire de se battre pour être le premier sur la liste.
Werner est réservé quant aux tests de référence, car il y a encore une distance entre les tests artificiels et le fonctionnement réel d’une entreprise. Si un modèle suffit à accomplir la tâche, l’entreprise doit réévaluer les bénéfices pour continuer à payer pour une meilleure position.
Et Werner calcule ce compte.J'ai calculé cela depuis plus de vingt ans。
Lorsque le sujet de conversation se tourne vers les changements fondamentaux apportés par le cloud computing, il accorde une grande importance aux changements dans le modèle économique.
Autrefois, lors de l’achat de logiciels d’entreprise, les entreprises devaient signer des contrats de cinq ou dix ans. Les dirigeants avaient du mal à prévoir les besoins de l’année suivante, mais ils devaient payer d’abord. Werner estimait que c’était comme un client qui dépose mille dollars dans un restaurant sans finir son repas et sans obtenir un remboursement.
Le cloud computing relie la consommation de ressources et les paiements, ce qui donne également un sens réel à l’autolimitation. Lorsque moins d’utilisateurs sont actifs la nuit, les entreprises peuvent éteindre les ressources inutiles. Les coûts peuvent enfin faire partie du débat sur l’architecture, et les départements opérationnels doivent également répondre à la question de savoir combien d’argent il est justifié de consacrer pour une certaine capacité.
À l’ère de l’IA, cette affaire comporte désormais de nouveaux projets.
Par exemple, lorsque Qubit demande : « Pourquoi le oubli même devient-il un problème important de développement ? », Werner déclare ouvertement que si l’agent doit scanner tout ce qu’il connaît avant chaque travail, les coûts système seront élevés ; les développeurs doivent trouver un moyen de lui permettre de conserver uniquement les informations qui sont vraiment importantes pour la tâche.
Il a également mentionné que lors de la redémarrage de certains outils de programmation, le contenu du projet est chargé à nouveau. Les utilisateurs ont déjà payé pour ces préparatifs hier, et aujourd’hui, ils doivent payer à nouveau. La mémoire transversale de Kiro entre sessions vise justement à réduire ce travail répétitif.
Donc, en plus du fait que le modèle est intelligent, les développeurs doivent se demander combien de travail inutile il a effectué à plusieurs reprises pour accomplir une tâche.
Cela explique également pourquoi Werner est prêt à discuter de modèles plus petits, ainsi que des modèles à poids ouvert tels que DeepSeek, Tongyi Qianwen et Kimi. Selon ses observations, certains clients, après des expériences continues, ont constaté que des modèles plus petits peuvent déjà répondre aux besoins, et les coûts d’utilisation sont également beaucoup moins élevés.
Quel outil utiliser, comment l’utiliser, combien de temps est nécessaire, ces vieux problèmes, les entreprises ne peuvent toujours pas les éviter avec l’IA.
Qui prendra la responsabilité des erreurs commises par l’Agent ?
Même si l'entreprise a calculé les coûts, il y a une autre problème qui attend l'équipe de développement.
Le robot de conversation fournit un texte que l’utilisateur peut lire avant de décider quoi faire. L’agent, quant à lui, prend des actions au nom de l’utilisateur : il modifie le planning, appelle des outils ou exécute des programmes. Dès que le modèle donne une mauvaise réponse, l’erreur peut se transformer en conséquences réelles au cours du processus d’exécution.
Werner a déclaré durant la conversation que lui était agréable de faire appel à l’Agent pour modifier le billet, mais il avait également des exigences précises. Le système doit savoir comment procéder, mémoriser ses préférences, et en même temps être limité.
Et cette obsession pour les frontières est déjà mentionnée dans l’histoire de Nitro qu’il raconte.
Les premiers services cloud dépendaient de la virtualisation, permettant de partager un serveur physique entre plusieurs utilisateurs ; mais les logiciels qui gèrent les machines virtuelles, ainsi que ceux qui traitent des accès réseau et de stockage, consomment également des ressources. Avec l’augmentation du nombre de machines virtuelles, la gestion devient potentiellement un obstacle.
AWS a ensuite développé Nitro, qui délocalise une grande quantité de fonctionnalités telles que les réseaux et le stockage sur du matériel dédié, et a supprimé l’ancien environnement de gestion Linux complet dom0. L’équipe a réduit les goulots d’étranglement en performance, et a également diminué considérablement la surface d’attaque.
Nitro dispose également d’un design intéressant appelé « communication passive ». Selon les explications de Werner, le moniteur de machine virtuelle attend que le contrôleur Nitro envoie des commandes. Si, au contraire, il prend l’initiative de contacter le contrôleur, cela entraîne un comportement inapproprié dans le processus normal, et la plateforme peut alors mettre en service abandonner les systèmes concernés et lancer une enquête.
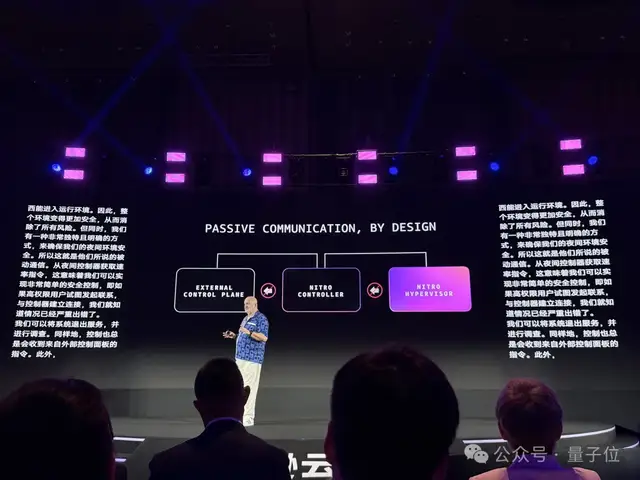
Dans cette logique, il est facile de comprendre les exigences de Werner envers l’Agent. Ce que le système est autorisé à faire par les utilisateurs doit être clairement indiqué à l’avance. Il a donné un exemple simple : les utilisateurs peuvent définir que l’Agent ne doit pas dépenser plus de 100 dollars par jour ; si cela est dépassé, une intervention humaine est nécessaire pour prendre une décision.
Selon sa présentation, Amazon a conçu un mécanisme d’exécution des règles pour l’Agent, qui vérifie les opérations telles que l’accès aux outils et l’exécution de scripts par l’Agent, afin de limiter ses actions dans la plage autorisée explicitement par le client.
L’autorisation donnée par l’utilisateur pour agir librement détermine les limites spécifiques. Même si le modèle juge qu’une action est valable, le système d’exécution doit vérifier s’il dispose du pouvoir pour la réaliser.
Mais ces contraintes, ne entraveront-elles pas l’efficacité de l’Agent ? Face à cette question, Werner a d’abord abordé laresponsabilité.
Si vous le construisez, vous en êtes responsable. (Si vous le construisez, vous en êtes propriétaire.)
De son point de vue, les développeurs d’Agent doivent être en mesure de le contrôler. Quelles actions le système entreprend et si les limites sont dépassées, cela reste toujours la responsabilité des humains.
Werner a également remis sa confiance en l’IA dans l’expérience des systèmes distribués. Les ingénieurs ne peuvent jamais supposer que chaque composant est toujours fiable, c’est pourquoi il est nécessaire de reproduire, d’isoler et d’utiliser divers mécanismes de fiabilité. Le groupe doit rester vigilant envers chaque composant individuel afin de bâtir une confiance dans l’ensemble du système.
Cependant, les ingénieurs doivent rendre ces mécanismes de protection accessibles pour le client et sans perturber significativement les tâches, ce qui implique de faire de nombreuses décisions difficiles. Lambda a déjà rencontré des problèmes similaires.
Dans les débuts, WeTransfer devait maintenir une série d’instances de calcul en marche pour traiter les fichiers téléchargés dans S3, en attendant l’arrivée de nouveaux fichiers. Les clients devaient donc entretenir tout un ensemble d’infrastructures uniquement pour attendre cet événement.
AWS souhaite prendre en charge ces tâches, permettant aux clients de soumettre du code et de payer en fonction du temps d'exécution et de l'utilisation de la mémoire. L’équipe a bien réfléchi à la manière de facturer et à la façon d’implémenter efficacement les aspects fondamentaux, mais cela reste encore une énigme.
Pour isoler les différents clients, les machines virtuelles utilisées initialement dans Lambda étaient trop grandes pour les tâches de fonction et coûtaient beaucoup d’argent. Plus tard, l’équipe a transformé les unités d’isolation en micro-machines virtuelles plus légères grâce à Firecracker, ce qui a permis d’améliorer l’utilisation des ressources.
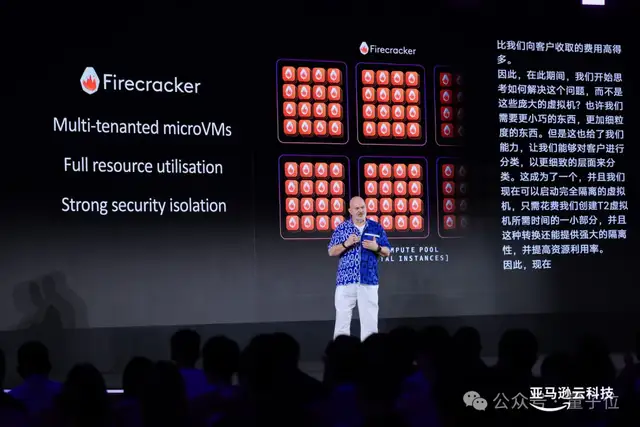
Après la résolution du problème d’isolement, l’équipe doit encore gérer le démarrage froid. Avant que la fonction ne soit réellement exécutée, le système doit préparer l’environnement de fonctionnement, le code et les dépendances. SnapStart, en conservant une capture d’écran de l’environnement initialisé, réduit cette partie de la préparation et améliore le temps de démarrage.
Ce que le client voit, c’est peut-être simplement une appel de fonction linéaire. En revanche, l’équipe de projet doit continuer à affiner en arrière-plan les mécanismes d’isolation, la répartition des ressources, le démarrage et les réseaux.
Werner appelle ces travaux « l’innovation en ingénierie invisible » (Invisible Engineering).
Agent doit entrer dans les activités réelles, et l’équipe de développement a également besoin de ces détails. Après que la démonstration se passe correctement, l’équipe doit continuer à définir clairement comment limiter les droits, gérer les exceptions, et jusqu’à quel point les utilisateurs sont prêts à lui confier des tâches.
L’expérience n’a pas de algorithme de compression
Lorsque l’agent commence à écrire du code, ces problèmes reviennent à l’équipe de développement elle-même.
En ce qui concerne l’emploi des ingénieurs débutants, Werner a répondu que le nombre d’ingénieurs débutants recrutés par Amazon reste identique à celui de l’époque. Ensuite, il a déplacé le sujet vers l’apprentissage des nouveaux membres après leur intégration dans l’équipe.
Un diplômé qui rejoint l'équipe S3 peut se retrouver face à des codes d'il y a vingt ans. Il est difficile pour l'école de lui apprendre à temps comment comprendre un tel système, ainsi que la manière de collaborer avec les personnes qui le maintiennent.
Par conséquent, Werner valorise la curiosité, les capacités d’apprentissage et l’expérience avec des projets open source. Le fait qu’un nouveaux arrivants ait participé à une collaboration open source signifie que son code a été examiné par d’autres personnes, et il doit également résoudre les problèmes en collaboration avec eux.
L’IA peut aider les nouveaux employés à expliquer les règles de l’équipe, permettant ainsi aux ingénieurs expérimentés d’économiser du temps en ne répétant pas les explications. Lorsque Werner présente Kiro, il souligne également l’importance de la documentation des spécifications. Les développeurs doivent d’abord clarifier les besoins, l’architecture et les règles de développement, avant que le système ne puisse fonctionner.
Cependant, la vitesse avec laquelle l’IA génère le code s’est accrue, et la vitesse avec laquelle l’équipe comprend et vérifie le code ne sera pas nécessairement en même temps.
Werner a mentionné un concept qui mérite que l'équipe de développement se penche dessus : la validation des dettes.
Autrefois, afin de accélérer le projet, les développeurs ont pris des raccourcis et noté que cela devait être corrigé par la suite. Cela a engendré une dette technique. Aujourd’hui, dans les codes générés par l’IA, certaines parties n’ont pas encore été vérifiées, et l’équipe a donc accumulé une autre dette.
Un élément d’interface a dévié de quelques millimètres, comparé à un code qui pourrait divulguer des informations clients, les conséquences sont très différentes. L’équipe de développement doit effectuer des vérifications en fonction du risque, et concentrer ses efforts sur les parties où la validation est nécessaire.
Selon la pensée de Werner, il est facile pour l’équipe d’augmenter la production de code, mais il faut également mesurer si elle comprend ces codes et assume les conséquences qui en découlent. Sinon, le temps économisé par les développeurs aujourd’hui pourrait être perdu à l’avenir lors des vérifications et des retravaux.
C’est aussi pourquoi Werner insiste pour que les ingénieurs débutants lisent le code, et que les ingénieurs expérimentés l’examinent et en discutent ensemble. Les outils peuvent expliquer les connaissances, mais le jugement nécessaire face à des problèmes concrets reste à accumuler petit à petit.
Il n’existe pas d’algorithme de compression pour l’expérience.
Ces mots de Werner répondent de manière appropriée aux inquiétudes des développeurs.
Cependant, en parlant du voyage en Chine, il a donné un exemple qui le rend plus optimiste quant aux applications de l’IA. Il a passé beaucoup de temps à raconter ses expériences lors des visites au « riz et au millet ».
Cette institution propose des services d’intervention pour les enfants ayant besoin de soutien développemental lié à l’autisme, au trouble du déficit de l’attention avec hyperactivité, etc. Selon Werner, l’institution utilise l’analyse de données par IA pour examiner les enregistrements pédagogiques et observer les progrès des enfants, avant de fournir des suggestions aux thérapeutes. Ces derniers, en combinant leur jugement professionnel, décident quel type de conseils adopter.
Ce qui l’a impressionné, c’est que l’IA a aidé les professionnels à réduire les tâches administratives, leur permettant ainsi de consacrer plus de temps à leurs enfants et à leur famille.
En parlant de cela, l’optimisme de Werner a un objet concret. Quelles personnes peuvent se débarrasser d’un fardeau moindre grâce à la technologie, et quelles personnes, qui avaient autrefois du mal à obtenir du soutien, peuvent être aidées ? Ces applications concrètes lui ont montré la valeur de l’IA.
Revenant sur cette phrase « d’abord appuyer sur la touche pause », les choses que l’entreprise doit arrêter pour réfléchir deviennent plus concrètes. La question de savoir si la tâche est adaptée à l’IA, si les coûts sont supportables, comment définir la portée des actions, et qui vérifie les résultats, tout le groupe de développement doit y répondre point par point.
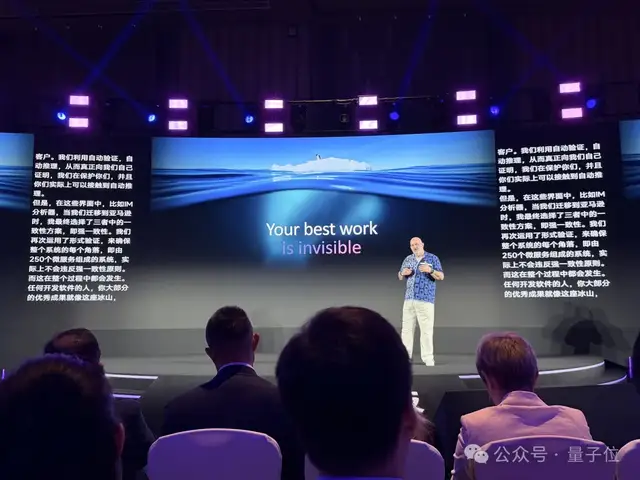
Werner a dit que le travail le plus remarquable des développeurs se trouve souvent là où les autres ne peuvent pas le voir.
L’IA a écrit un code en plus pour les gens, et les ingénieurs doivent savoir ce qui se passera après le lancement de ce code.