
Concevoir des circuits quantiques plus efficaces avec Claude
16 oct. 2026
Les ordinateurs quantiques nécessiteront des circuits soigneusement conçus pour exécuter des algorithmes utiles sur du matériel limité. Nous avons donné à Claude des spécifications en langue simple pour huit de ces circuits, issues de la chimie, de l’optimisation, de la simulation physique et de la théorie des nombres, ainsi qu’un évaluateur automatisé qui vérifie et note chaque conception. En fonctionnant principalement seul, Claude a découvert des conceptions qui améliorent les meilleurs circuits publiés, parfois d’une ordre de grandeur ou plus. Ces améliorations réduisent considérablement les ressources quantiques nécessaires pour les applications utiles, permettant ainsi aux ordinateurs quantiques pratiques d’arriver plus tôt que prévu.
Cette étude a été menée par Andi Gu dans le cadre du programme STEM Fellows d’Anthropic, sous la supervision de Alek Kemeny, physicien quantique chez Anthropic, en collaboration avec Susanne Yelin (Université Harvard) et Mikhail Lukin (Université Harvard et QuEra Computing) Lisez le article complet sur arXiv>.
Contrairement aux ordinateurs classiques, qui stockent des informations en bits dont la valeur est soit 0, soit 1, les ordinateurs quantiques stockent des informations en qubits, qui peuvent être créés à partir d’atomes individuels, de circuits supercondensants ou de particules de lumière. Ces qubits exploitent des phénomènes quantiques tels que la superposition – qui permet à un système quantique d’exister simultanément dans une combinaison de états – afin de traiter les informations de manière à rendre certains problèmes dans des domaines comme la chimie, les sciences des matériaux et la théorie des nombres réalisables, même lorsqu’ils sont trop difficiles pour les ordinateurs traditionnels.
Les ordinateurs quantiques que le domaine a construits jusqu’à présent ne disposent que de centaines à milliers de qubits – trop peu pour exécuter de nombreux algorithmes qui promettent des avantages pratiques par rapport aux ordinateurs classiques. De plus, ces qubits sont très sensibles au bruit environnemental, tel que la chaleur, les vibrations ou même les rayons cosmiques. Une petite perturbation peut déplacer l’état d’un qubit, et ces petits erreurs s’accumulent jusqu’à ce que l’ordinateur donne une réponse incorrecte.
Comme les qubits et le temps de calcul sont des ressources limitées, les chercheurs ont travaillé à redéfinir les algorithmes quantiques afin d’utiliser moins de qubits et de terminer les calculs en moins de temps. Un exemple illustratif est la simulation de FeMoco, le cluster fer-sulfure au cœur de la nitrogenase, l’enzyme que les bactéries utilisent pour transformer l’azote de l’air en ammoniac. Comprendre comment cela fonctionne pourrait aider les scientifiques à concevoir de meilleurs catalyseurs industriels – les substances que les fabricants utilisent pour accélérer les réactions chimiques.
En 2017, les chercheurs ont estimé qu’un ordinateur quantique nécessiterait environ 50 trillions de porte Toffoli pour calculer l’énergie de l’état fondamental de FeMoco – l’énergie de sa configuration la plus stable, que les chimistes ont besoin de connaître afin de prédire comment FeMoco réagit. (Tout comme les ordinateurs ordinaires, les ordinateurs quantiques fonctionnent en appliquant une longue série d’opérations simples, appelées porte, à leurs qubits.) La porte Toffoli est l’une des portes les plus coûteuses à mettre en service, donc compter les portes Toffoli est une méthode standard pour estimer le temps nécessaire pour une computation.)
Grâce à une série d’avancées algorithmiques, le nombre estimé de portes est tombé à environ 340 millions – une réduction d’environ 150 000 fois, ce qui correspond à quelques heures de calcul sur une machine future comptant environ trois millions de qubits physiques.1
Ces réductions proviennent en grande partie de la redéfinition des circuits qui effectuent le calcul, plutôt que de l’amélioration du matériel. Claude s’est avéré particulièrement compétent pour l’optimisation classique algorithmes, donc nous voulions voir si cela pouvait se produire pour les algorithmes quantiques, si l’on disposait seulement d’une description en langage simple de ce que chaque circuit doit calculer.
Claude est particulièrement adapté à cette tâche pour plusieurs raisons. Premièrement, les algorithmes quantiques sont implémentés en tant que quantique circuits. Ils sont composés de séquences de portes, comme les portes Toffoli mentionnées ci-dessus. Il est important de noter que ces circuits peuvent être décrits en code, ce qui nous permet d’utiliser les capacités de codage de Claude pour écrire, exécuter et modifier les designs de circuits comme des programmes ordinaires. Deuxièmement, la classe (relativement courante) d’algorithmes quantiques que nous étions le plus intéressés à optimiser peut être testée efficacement en termes de justesse, car chaque entrée produit une sortie définie que un ordinateur ordinaire peut vérifier. Cela signifie que nous pourrions avoir un programme d’évaluation externe pour valider les propositions de Claude. Enfin, nous pouvons lui attribuer une note claire et objective pour l’améliorer : le nombre de qubits utilisés multiplié par le nombre de gates, ce qui constitue un indicateur du temps nécessaire pour exécuter le circuit.
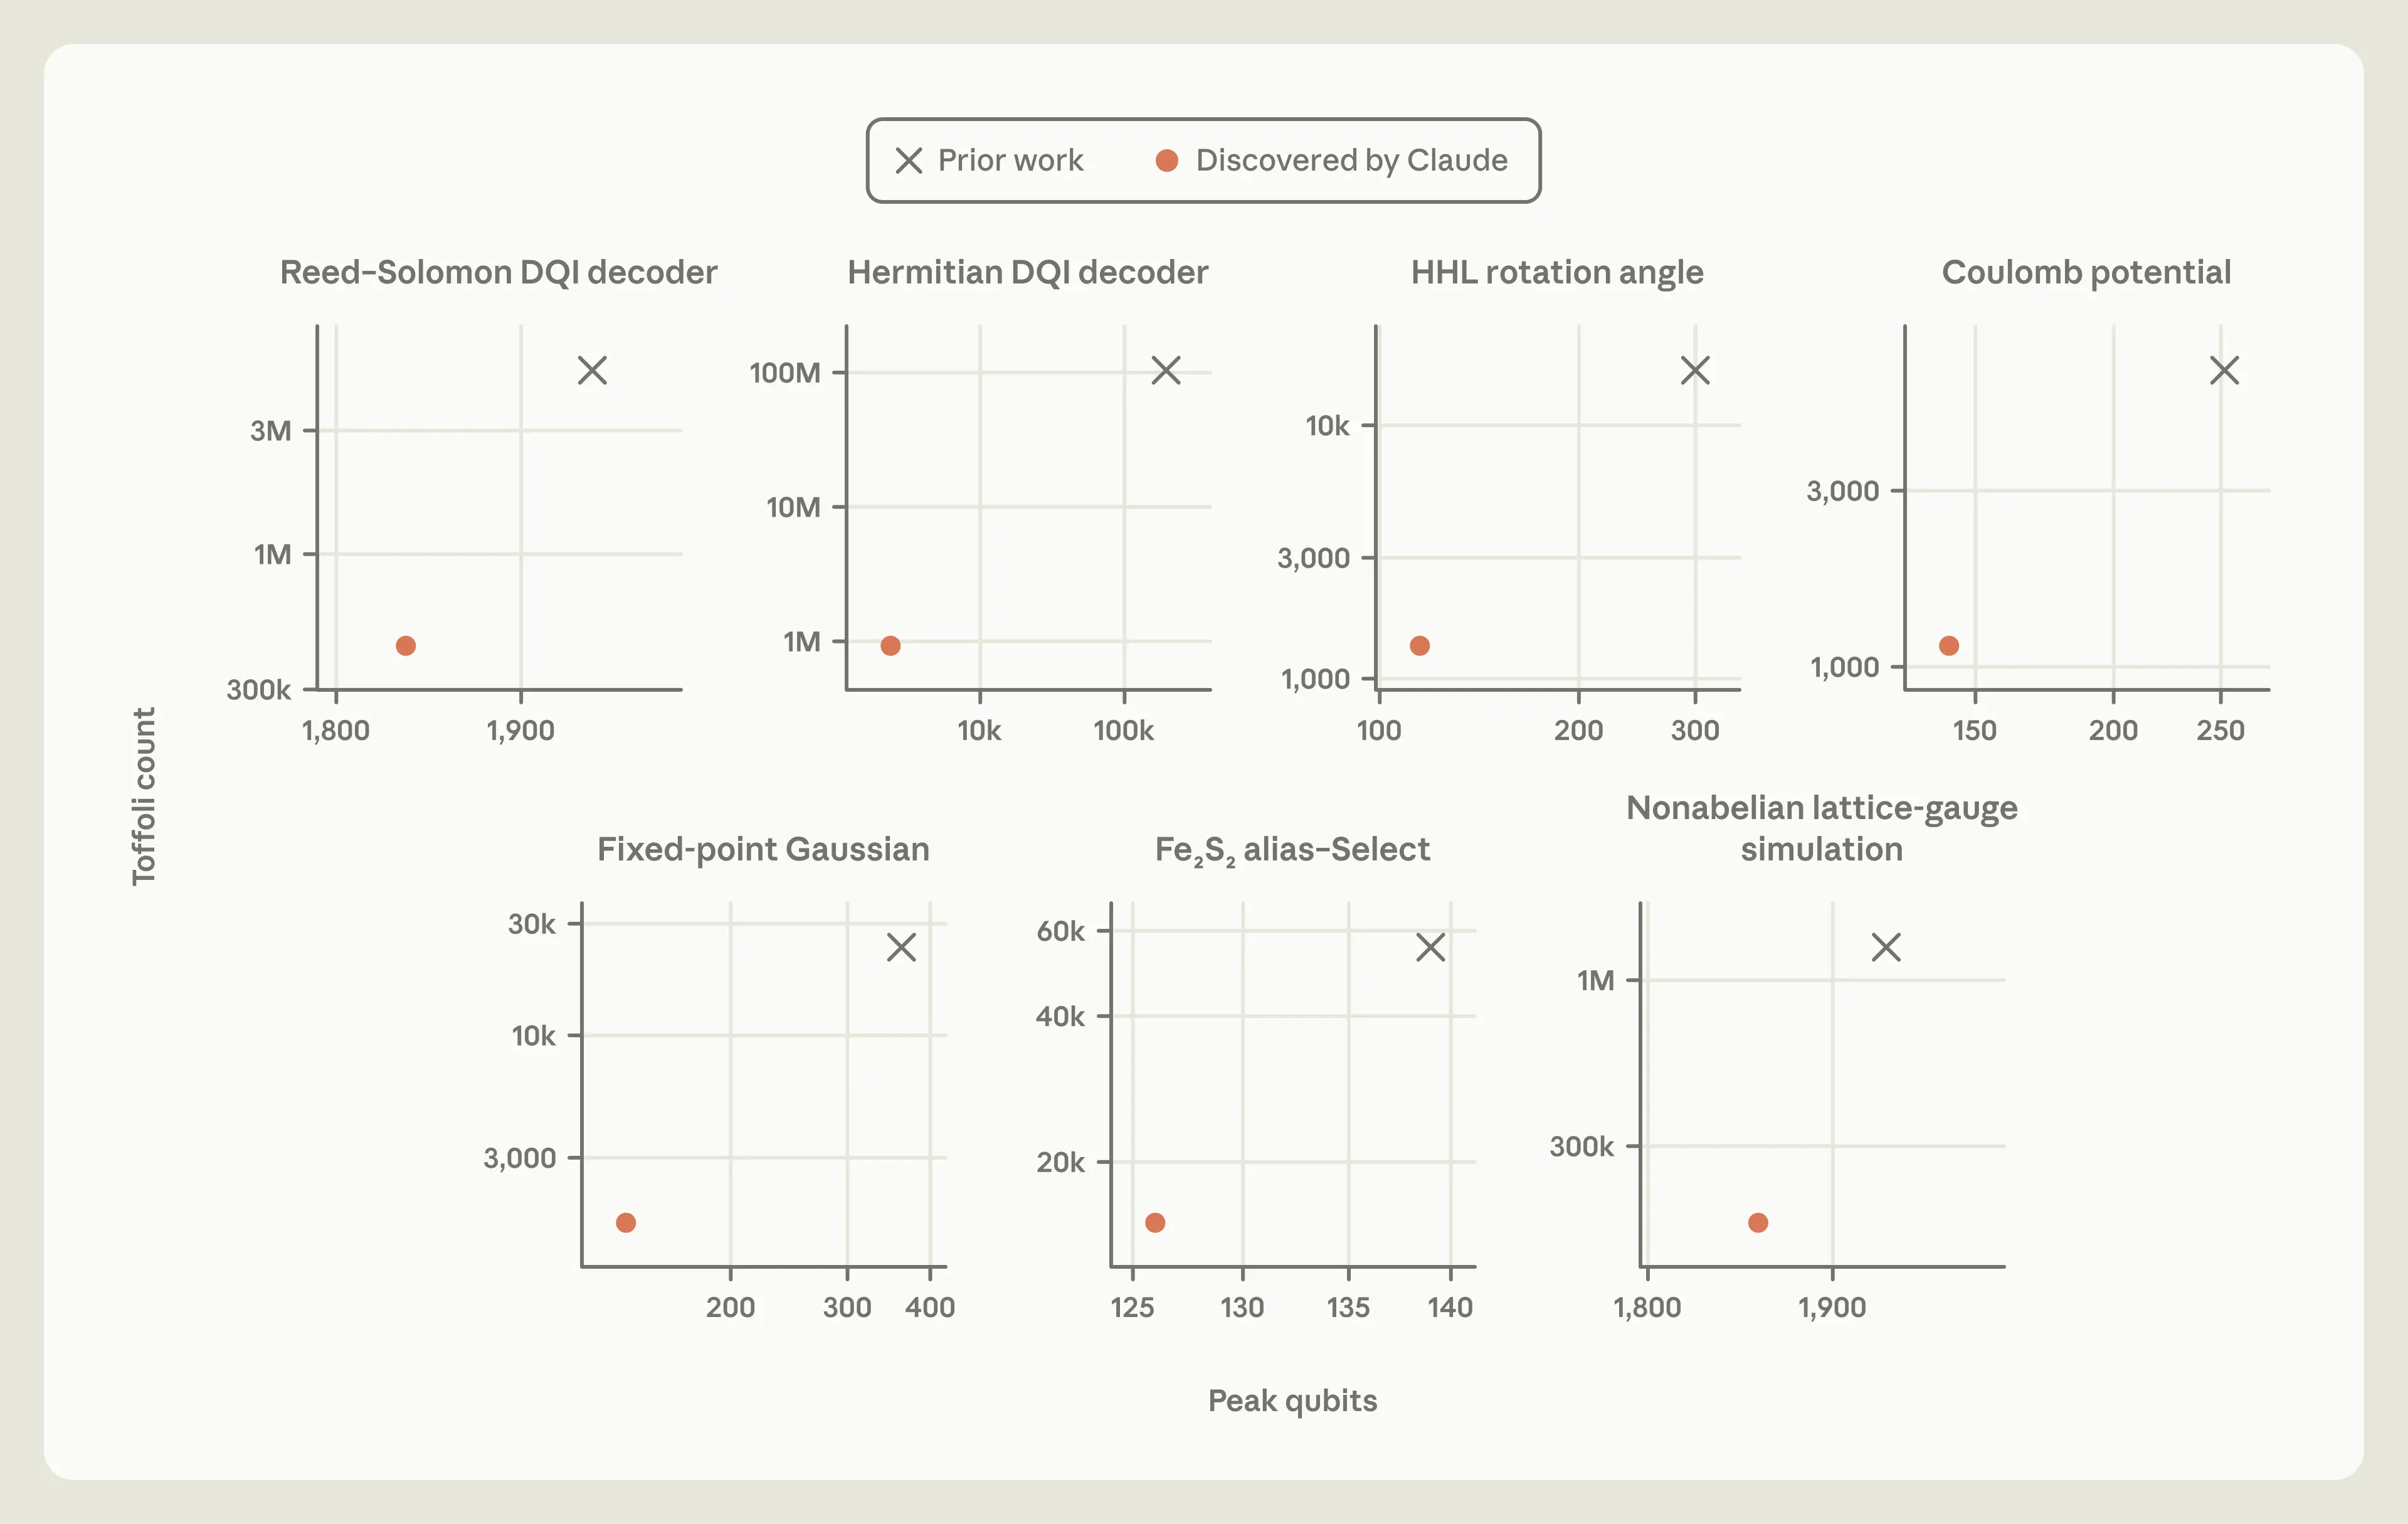
Nous avons constaté que Claude Mythos 5 pouvait fonctionner avec succès dans un cycle fermé : il proposait un design de circuit, recevait des retours et un score provenant du programme d’évaluation, et utilisait ces retours pour améliorer sa prochaine tentative, sans aucune intervention humaine entre les tours (voir Figure 1). Sur huit primitives computationnelles – les routines de base dont sont construits les algorithmes quantiques plus complexes – pour la chimie, l’optimisation, la simulation quantique, la théorie des nombres et le calcul numérique, Claude a découvert des designs nouveaux qui utilisent moins de qubits et moins de portes que les meilleurs algorithmes publiés précédemment (Figure 2).
Dans chaque cas, l'amélioration résulte de la découverte de nouvelles perspectives structurelles et mathématiques concernant le problème, plutôt que d’un ajustement fin des designs existants. Par exemple, lors de la compilation d’un circuit pour simuler une molécule de sulfure de fer, Claude a remarqué que les symétries et la structure répétitive de la molécule permettaient de calculer certains résultats une seule fois et de les réutiliser, plutôt que de les calculer à nouveau pour chaque partie du système. Dans d’autres cas, il a constaté que les circuits existants comprenaient des composants coûteux nécessaires uniquement pour traiter des entrées extrêmement rares, et il les a redessinés en supprimant ces composants.
Ci-dessous, nous décrivons deux des découvertes de Claude. La première est une nouvelle méthode pour effectuer l’inversion modulaire, un type d’opération arithmétique qui constitue la étape la plus coûteuse dans les calculs sur courbes elliptiques. La seconde permet de rendre l’étape la plus coûteuse d’un algorithme de optimisation quantique leader environ 12 fois moins coûteuse.
Ces résultats indiquent que l’IA peut maintenant aider à redéfinir les circuits quantiques, une étape clé pour rendre les algorithmes quantiques plus rapides et plus faciles à exécuter. Un design de circuit plus rapide pourrait permettre de résoudre plus tôt les problèmes que les ordinateurs quantiques sont destinés à résoudre – depuis la conception de nouveaux médicaments et de meilleures batteries jusqu’à la recherche de méthodes plus propres de production d’engrais.
Un nouvel algorithme réversible
Concevoir un circuit quantique implique deux contraintes que la programmation ordinaire ne possède pas. La première est que un circuit quantique ne peut pas prendre des décisions de type « si-alors » comme un programme ordinaire. Un programme ordinaire peut vérifier une valeur et ensuite exécuter uniquement l’un des deux blocs de code. Mais un ordinateur quantique fonctionne sur une superposition de nombreux entrées en même temps ; certaines d’entre elles exécutent le premier programme, tandis que d’autres exécutent le second. Par conséquent, le circuit doit inclure les opérations nécessaires pour les deux programmes à chaque fois qu’il est exécuté.
Deuxièmement, un circuit quantique ne peut pas éliminer les informations. Un programme ordinaire peut effacer ou supprimer ses travaux intermédiaires une fois qu’il est terminé ; dans un ordinateur quantique, de telles informations intermédiaires ne peuvent pas être simplement effacées, car chaque étape d’un circuit quantique doit être réversible. Il n’est pas non plus possible de laisser ces informations en place, car les travaux restants pourraient corrompre le résultat final. La seule façon de supprimer des informations est de les « désécréter » en exécutant l’opération qui les a créées à l’envers, au prix de la nécessité d’utiliser davantage de portes. Ces deux contraintes rendent les circuits quantiques beaucoup plus coûteux, tant en termes de temps de exécution que de qubits, par rapport à leurs équivalents classiques.
Cette contrainte impose un compromis difficile entre l'espace (c’est-à-dire les qubits) et le temps. Dans un extrême, un circuit quantique peut annuler le calcul des résultats intermédiaires dès qu’ils sont utilisés. Cela libère les qubits, mais si ces mêmes résultats sont nécessaires à nouveau plus tard, le circuit doit les recomposer, ce qui augmente le nombre de porteuses et prolonge le temps de traitement. Dans l’autre extrême, le circuit peut conserver les résultats intermédiaires jusqu’à ce qu’ils ne soient plus nécessaires. Cela évite de répéter le travail, mais cela peut nécessiter beaucoup plus de qubits.
C’est ce qui rend la conception de circuits quantiques une épreuve particulièrement intéressante pour les capacités de Claude. Les circuits peuvent être écrits en code ordinaire, mais leur amélioration nécessite que le modèle raisonne sous un ensemble de contraintes très différentes de celles de la programmation ordinaire.
Une première épreuve difficile : inversion modulaire
La première tâche que nous avons donnée à Claude était l’addition de points, une règle permettant de combiner deux points sur une courbe mathématique (une courbe elliptique) pour obtenir un troisième point. L’addition de points est l’étape essentielle des algorithmes quantiques pour le problème du logarithme discréte sur les courbes elliptiques : on donne un point de départ et le résultat de l’addition de celui-ci par lui-même n fois, et on cherche n. Pour des courbes de grande taille, les ordinateurs ordinaires ne peuvent pas résoudre ce problème en aucun temps raisonnable, mais un ordinateur quantique suffisamment grand pourrait le faire.
Ces algorithmes effectuent de nombreuses additions de points, y compris dans le sens inverse, et ces additions représentent la plupart des coûts de qubits et du temps de exécution. Des problèmes de ce type – faciles à calculer, extrêmement difficiles à inverser – ont été parmi les premiers où il a été démontré que les ordinateurs quantiques offrent une amélioration exponentielle par rapport aux ordinateurs classiques. Pour ces raisons, l’addition de points est devenue l’un des critères standard du domaine. Cela en fait un test exigeant pour Claude. Alors, nous lui avons demandé de déterminer combien de qubits, ainsi que combien de porteuses, sont réellement nécessaires pour l’addition de points.
Nous avons donné à Claude un bref texte d’une seule phrase. Il expliquait la règle mathématique pour l’addition de points, ainsi que comment l’évaluateur vérifiait la correctitude de chaque circuit proposé et lui attribuait un score en fonction du nombre de qubits et des gates utilisés. Claude devait également explorer plusieurs approches en parallèle. Après 53 heures de travail avec une contribution humaine minimale (limitée au bref texte initial et à quelques suggestions occasionnelles pour réfléchir plus largement), Claude a trouvé une approche complètement nouvelle pour résoudre le problème.
Les exigences en mémoire de divsteps
La majeure partie du coût lié à l’ajout de points provient d’une seule étape, appelée inversion modulaire. L’arithmétique des courbes elliptiques utilise des nombres qui reviennent après avoir atteint un limite fixe. L’inversion modulaire est la version avec retour de nombres de la division : pour un entier a, on cherche x tel que ax ≡ 1 (mod p). Les ordinateurs ordinaires peuvent effectuer cette opération efficacement en utilisant une méthode appelée divsteps. Divsteps commence par un couple de nombres et les simplifie répétitivement au cours de plusieurs itérations. À chaque itération, Divsteps examine le couple actuel de nombres et les échange, les ajoutent, les soustraient ou les divisent en fonction des conditions nécessaires. En cours de route, il conserve suffisamment d’informations pour obtenir l’inverse modulaire à la fin.
Malgré son succès sur les ordinateurs ordinaires, divsteps n’a pas encore produit un circuit quantique pratique, en raison de la contrainte de réversibilité décrite ci-dessus. Le enregistrement de l’opération choisie à chaque itération, appelé informations de branche, est un type de travail supplémentaire que un programme traditionnel peut simplement ignorer. En revanche, un circuit quantique doit conserver cet enregistrement afin que le calcul puisse être exécuté en arrière. Une version classique quantique de divsteps est donc contrainte d’accumuler une longue histoire d’informations de branche, ce qui nécessite un nombre énorme de qubits supplémentaires pour stocker.
Comment Claude a-t-il surmonté le problème de mémoire
Claude a réalisé que cette approche divsteps pourrait être prometteuse pour les circuits quantiques, mais uniquement si il existait un moyen de contourner la nécessité de stocker toute l’histoire. Il avait une idée : peut-être que le enregistrement n’avait pas besoin d’être stocké du tout. Claude pensa qu’il serait possible d’inférer directement (ou « décoder ») les informations de branche en examinant attentivement le couple de nombres après chaque itération. En réalité, les nombres eux-mêmes contenaient l’enregistrement. Le circuit pourrait alors être exécuté en sens inverse sans avoir besoin de qubits supplémentaires.
Pour tester cette idée, Claude a exploré plusieurs règles candidates simples pour effectuer la décodage. Ces règles initiales fonctionnaient sur de petits cas d’exemple, mais elles ont échoué lorsque Claude les a testées à l’échelle complète du problème, avec des nombres de 256 bits.
Claude a ensuite essayé une approche plus théorique. Au lieu de deviner et tester des règles, il s’est efforcé de comprendre mathématiquement pourquoi divsteps se comporte de cette manière. Il a démontré une série de résultats concernant le processus d’itération, y compris plusieurs nouvelles identités algébriques. À partir de ces identités, Claude a dérivé une formule précise pour la règle de décodage qui permettrait de récupérer correctement les informations de branche provenant des paires numériques. Il a ensuite vérifié la formule, d’abord en la mettant en œuvre à l’aide de simulations numériques à grande échelle, puis en formalisant l’affirmation dans Lean. Une fois la validation complète effectuée, Claude a produit la première implémentation réversible de divsteps sans historique de branches stocké.
Une famille de designs
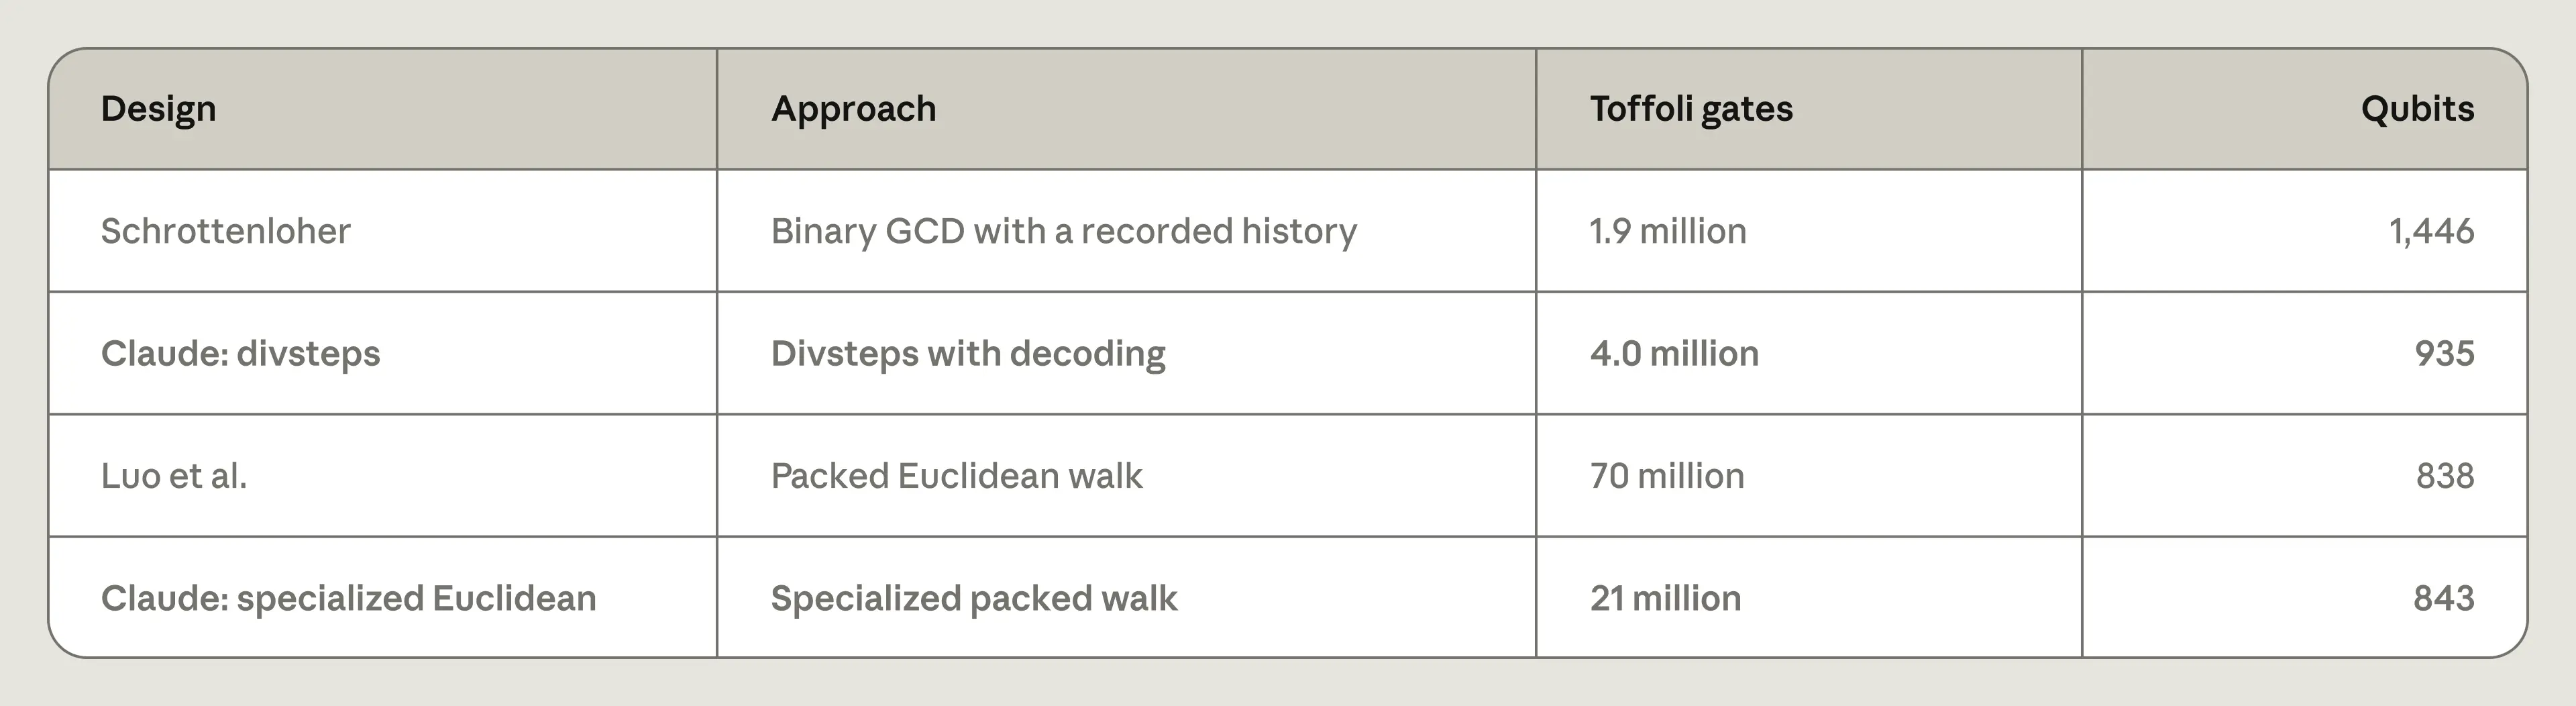
La décodage permet de conserver des qubits, mais cela coûte du temps. Ainsi, comme amélioration supplémentaire, Claude a cherché des situations dans lesquelles il serait moins coûteux de stocker les informations des branches que de les déchiffrer. En modifiant le seuil auquel le circuit stocke plutôt que de déchiffrer les informations des branches, Claude a créé une nouvelle famille de designs entre ces deux extrêmes. Par rapport au plus petit design précédent, un circuit de cette famille utilise 12 % plus de qubits, mais 17 fois moins de gates. De manière plus générale, les nouveaux designs élargissent la frontière de Pareto, offrant des combinaisons de nombre de qubits et de temps de fonctionnement qui n’étaient pas disponibles auparavant (Tableau 1).
Optimiser un optimiseur quantique
Les problèmes d’optimisation sont au cœur de nombreuses tâches, notamment le planning, la logistique et la conception des matériaux. Un problème d’optimisation présente un ensemble de contraintes concurrentes et demande une solution qui les satisfait autant que possible. De nombreux algorithmes quantiques ont été proposés pour de tels problèmes, mais la plupart ne garantissent qu’une amélioration modeste ou incertaine par rapport aux ordinateurs ordinaires. La décodage de l’interférométrie quantique (DQI) est l’un des candidats les plus puissants pour offrir un accélération quantique superpolynôme— une avantage qui s’agrandit rapidement à mesure que les problèmes deviennent plus importants.
Lorsqu’un ordinateur quantique termine un calcul, la lecture des qubits produit une seule réponse, choisie au hasard parmi les possibilités qu’ils contiennent en superposition. Le DQI fonctionne en préparant un état quantique dans lequel les bonnes solutions sont plus susceptibles d’être extraites que les mauvaises. Pour cela, il est nécessaire d’utiliser un décodeur correcteur d’erreurs, qui récupère une liste courte d’« erreurs » à partir d’un résumé compact. C’est la étape la plus coûteuse de l’algorithme. Ainsi, si nous pouvions créer un décodeur plus rapide, nous pourrions également effectuer le DQI plus rapidement.
Un décodeur quantique plus efficace
Les chercheurs qui ont introduit le DQI l’ont mis en pratique dans un problème appelé intersection polynomiale optimale (OPI), une version basée sur une grille de la filature des courbes (Figure 3). Imaginez une grille dans laquelle chaque position x contient plusieurs valeurs acceptables de y. L’objectif est de trouver une courbe simple (un polynôme de faible degré) qui passe par un carré acceptable pour autant de positions x que possible. Le DQI résout ce problème d’optimisation en utilisant un type spécifique de décodeur, appelé décodeur Reed–Solomon.
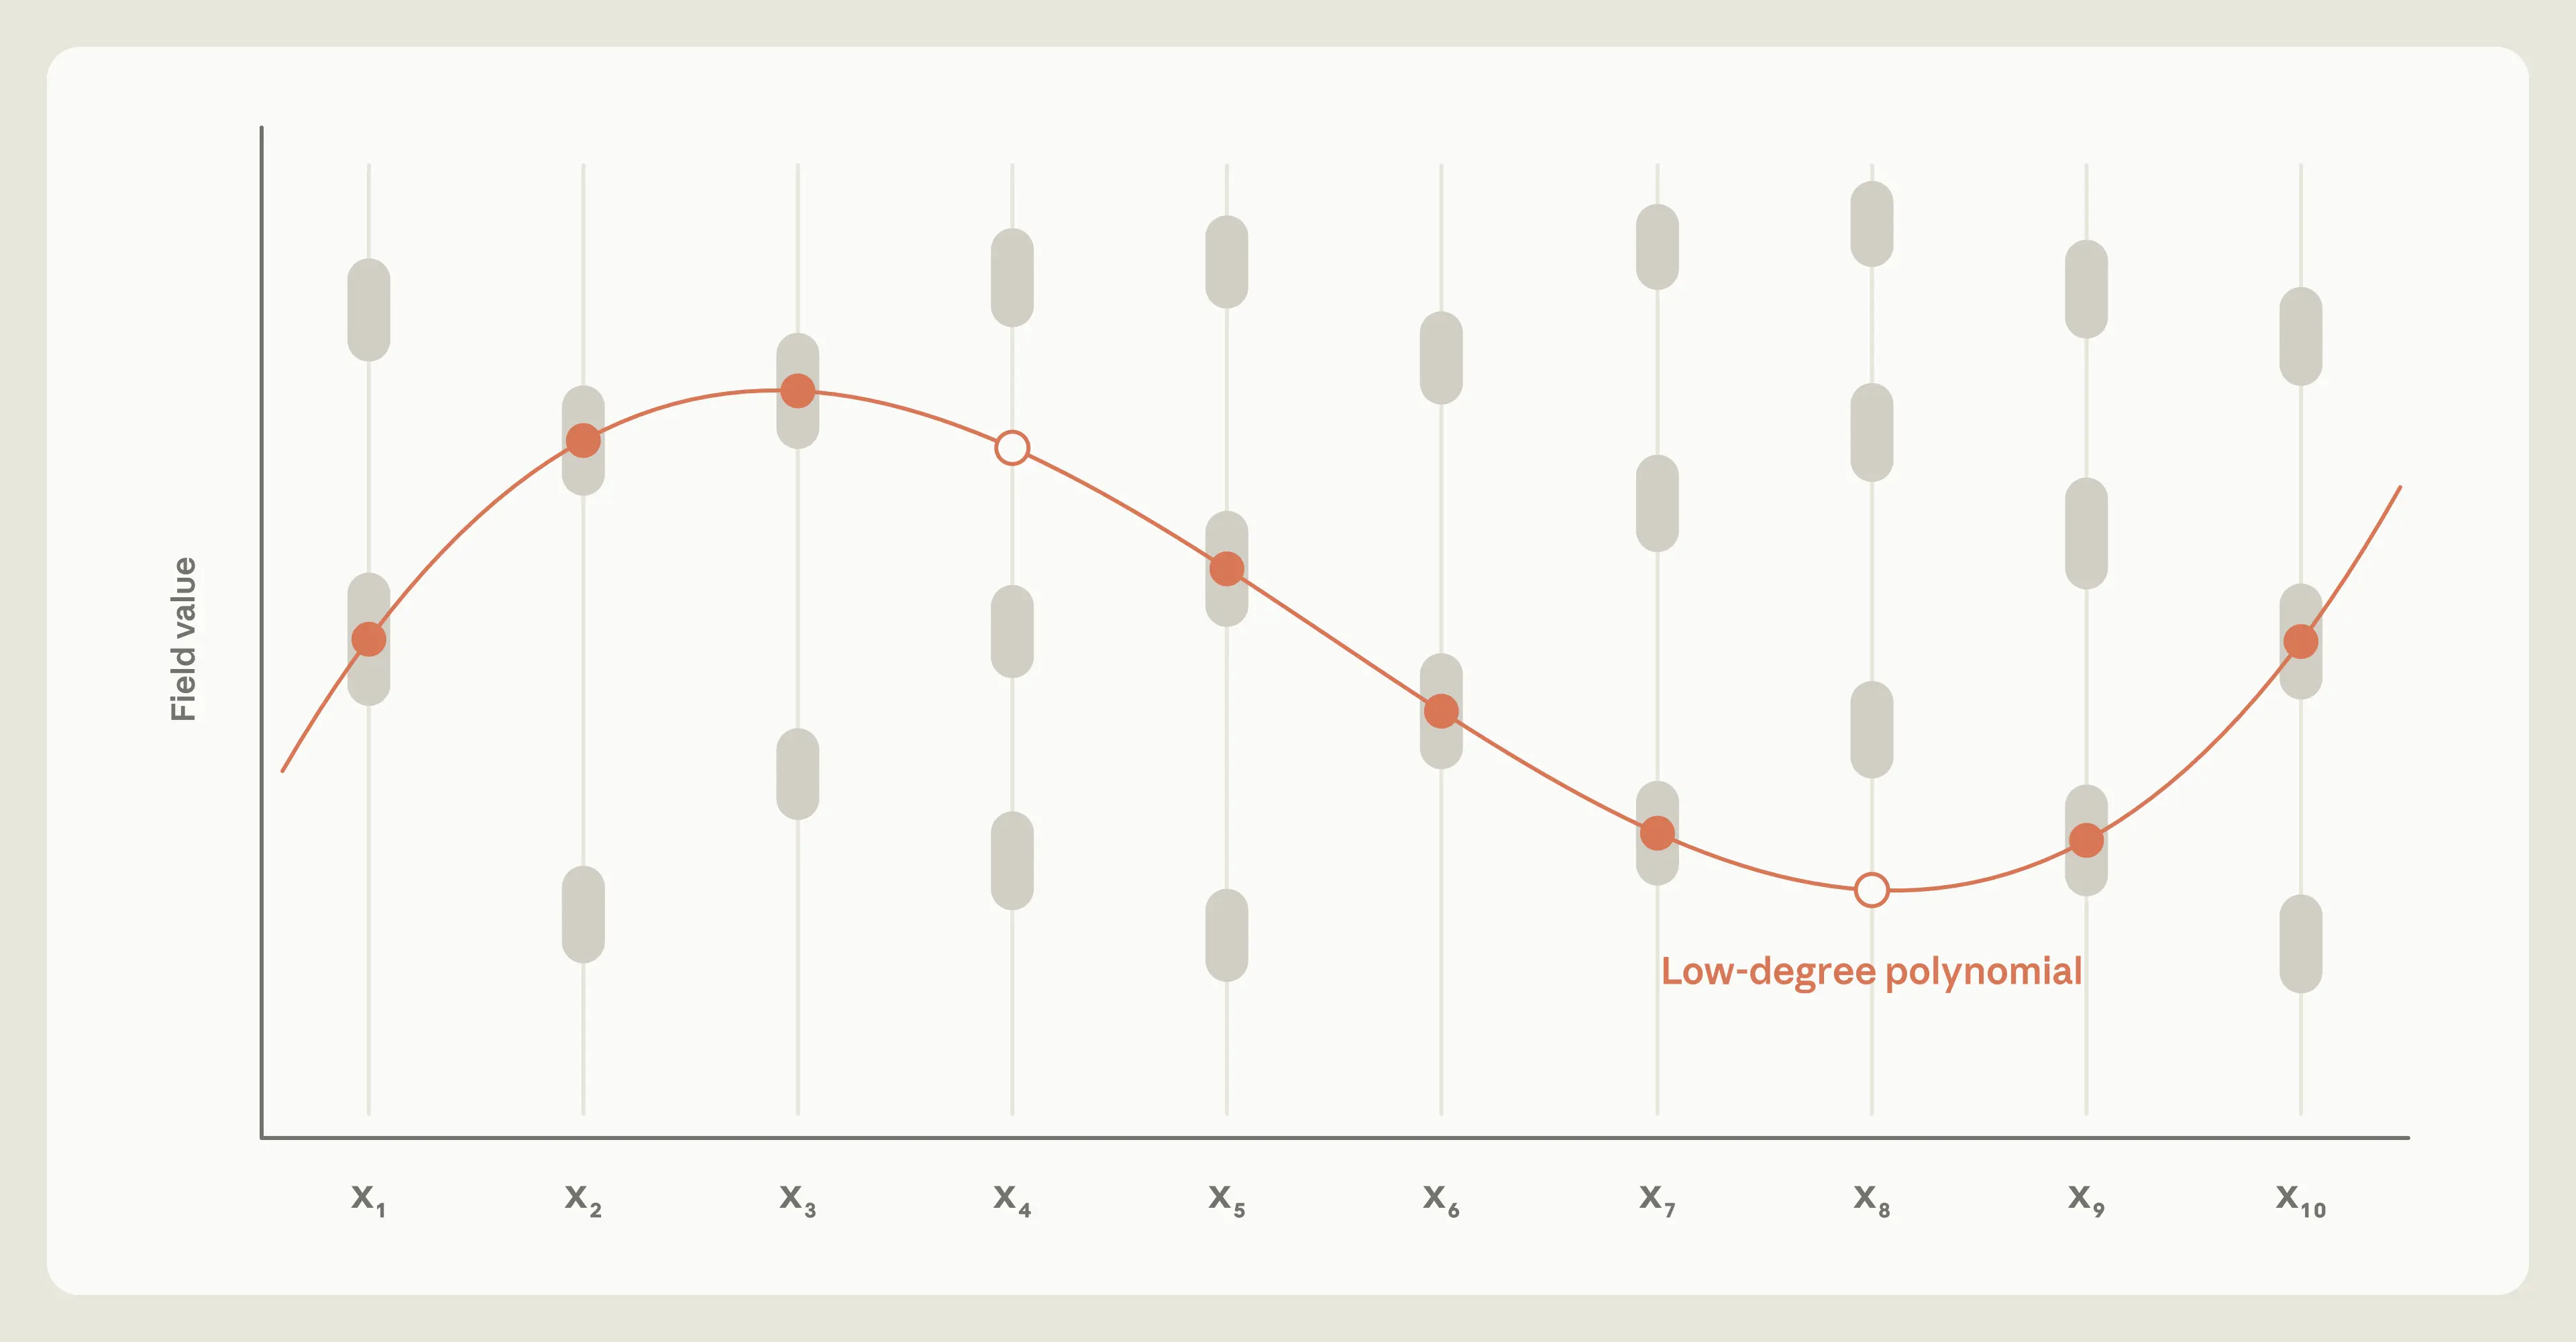
La décodage Reed–Solomon commence par le résumé compact des erreurs mentionnées ci-dessus, qui est connu sous le nom de syndrome. La tâche du décodeur consiste à déduire, à partir de ce résumé, où se trouvent dans les données les erreurs et quelles elles sont. Le circuit quantique de pointe précédent traitait ces syndromes en utilisant l’algorithme euclidien étendu, une série de divisions et de swaps dont le nombre et l’ordre des étapes dépendent de l’entrée donnée. Ici, les contraintes des circuits quantiques ressortent : tandis qu’un programme ordinaire peut suivre un chemin différent pour chaque entrée, un circuit quantique, travaillant sur plusieurs entrées en même temps, doit gérer toutes les entrées avec une seule séquence fixe de gates. Pour gérer cela, le design précédent devait étendre le calcul à de nombreux tours d’itération supérieurs à ceux nécessaires pour une seule entrée, et exécuter chaque opération dans chaque tour, même lorsque cela n’était pas nécessaire.
Améliorer ce décodeur pourrait réduire considérablement le temps de exécution du DQI. Selon les estimations des chercheurs du Google Quantum AI, la résolution d’un problème OPI particulier nécessiterait environ trois mois sur Frontier, l’un des superordinateurs les plus puissants du monde, par rapport à une heure environ sur un ordinateur quantique futur exécutant le DQI. La majeure partie de cette heure serait consacrée à la décodification Reed–Solomon.
Ainsi, nous avons demandé à Claude de concevoir un circuit quantique plus efficace pour l’étape de décodage. Claude a rapidement conclu que l’algorithme éuclidien étendu ne convenait pas pour un circuit quantique. À la place, il a organisé son circuit autour d’une méthode de décodage différente, appelée décodage Berlekamp–Massey, qui lit les syndromes (résumés des erreurs) un par un et tente progressivement de déterminer la règle la plus simple permettant de prédire chaque nombre de la liste en fonction de ceux qui le précèdent. Une fois cette règle identifiée, les erreurs sont révélées. Contrairement à l’algorithme euclidien étendu, le algorithme Berlekamp–Massey effectue le même type de pas à chaque étape et exécute toujours le même nombre d’étapes, ce qui convient à la séquence fixe de gates d’un circuit quantique. En fin de compte, cela permet à Claude de disposer d’une base beaucoup plus efficace sur laquelle construire.
Une approche simplifiée pour le stockage
Changer vers le mode Berlekamp–Massey a supprimé la nécessité pour le circuit de prendre des chemins différents selon les entrées. Mais en rendant le circuit réversible, une autre difficulté est introduite, cette fois due à la contrainte d’aucun calcul discutée précédemment. À chaque round, le circuit calcule des valeurs temporaires dont il a besoin seulement brièvement, mais ces informations ne peuvent pas être simplement supprimées : pour les réécrire plus tard, le circuit doit être capable de retrouver ces informations.
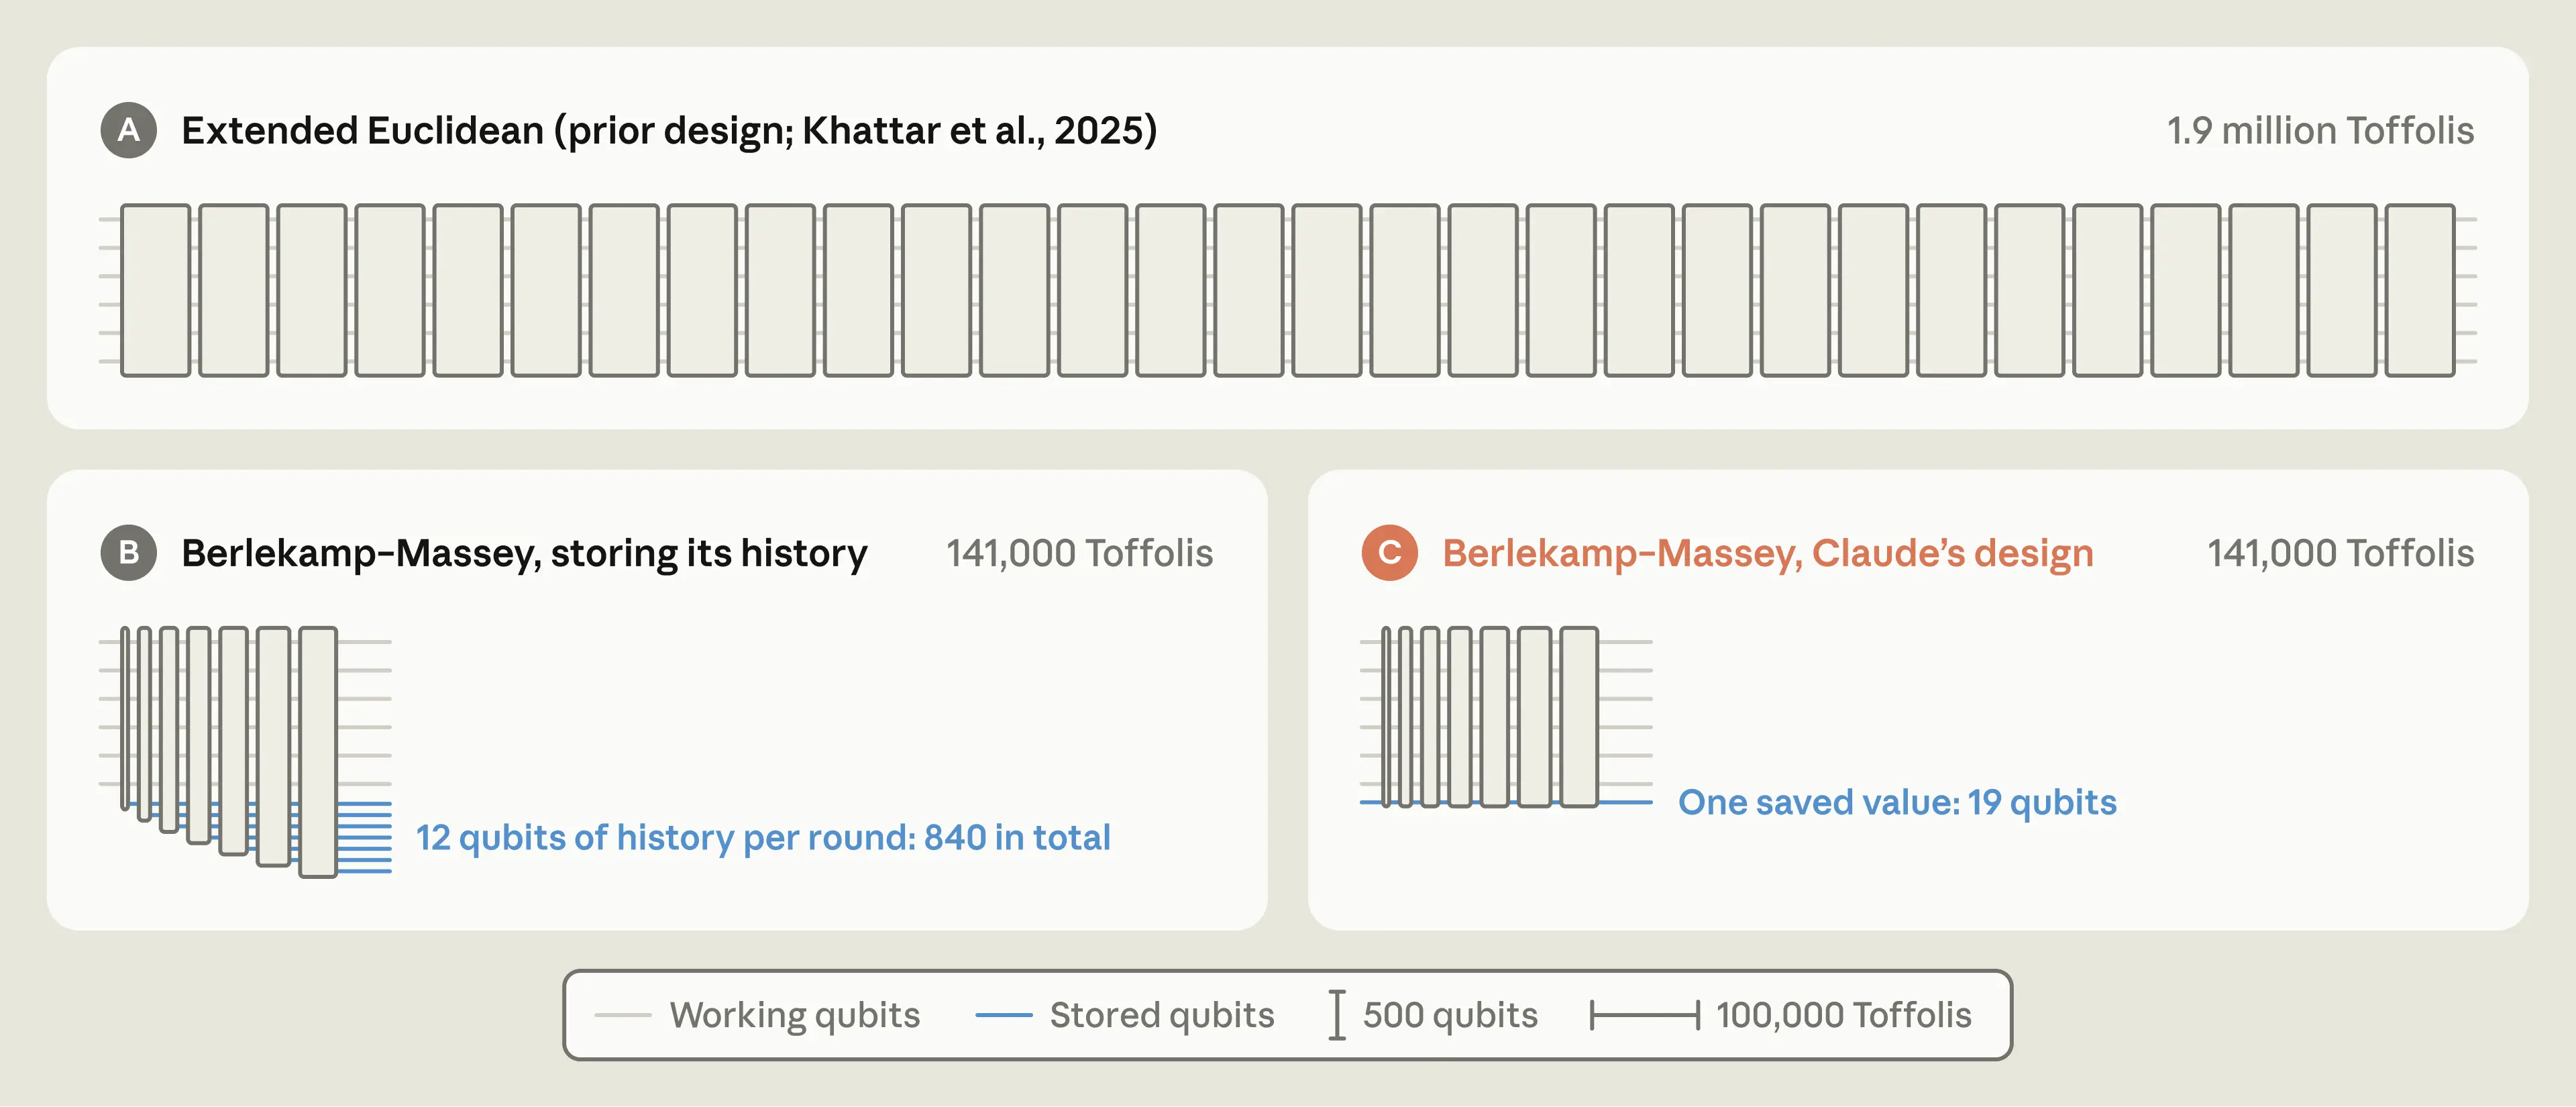
Le stockage de ces informations aurait été extrêmement coûteux. Ainsi, Claude a adopté la même approche que celle utilisée pour divsteps : il a trouvé un moyen de reconstituer la plupart de ces informations à partir de l’état actuel du circuit, de sorte qu’il n’était pas nécessaire de les stocker. Cependant, quelques valeurs exceptionnelles ne pouvaient pas être récupérées de cette manière et devaient être conservées.
En gardant suffisamment de mémoire pour le cas le plus critique, où une valeur exceptionnelle survient en 35 tours différents, il faudrait 665 qubits. En revanche, Claude a développé un simulateur à haute vitesse et a exécuté 403 millions de décodages d’échantillons pour mesurer la fréquence réelle d’apparition de ces exceptions. Presque chaque exécution ne nécessitait que l’enregistrement d’une seule valeur au maximum. Ainsi, le circuit de Claude ne prend que place pour une seule valeur enregistrée, soit 19 qubits. Environ un essai sur 10 000 nécessite plus que cela et échoue, ce qui se situe bien dans le taux d’erreur permis par la tâche. Ces améliorations ont remplacé de grandes réserves en cas de pannes par un petit nombre fixe de qubits et de gates (Figure 4).
Ensemble, ces optimisations ont réduit le nombre de portes dans le décodeur par un facteur de 12 par rapport à la construction précédente de Google . Cette amélioration provient du redéveloppement du calcul à trois niveaux : une méthode différente (en remplaçant l’algorithme euclidien étendu par la décodage Berlekamp–Massey), une architecture de circuit différente (en reconstruisant les valeurs temporaires plutôt que de les stocker), et un budget de ressources différent (en mesurant précisément combien de mémoire et de calcul le circuit nécessitait réellement). Aucune modification seule ne suffirait, mais ensemble, elles font que l’étape la plus coûteuse du DQI est juste un peu moins chère d’un ordre de grandeur.
Ce que nous avons appris
Le progrès scientifique provient souvent de la mise en pratique d’idées théoriques. L’une des principales manières de le faire est de rendre un processus autrefois considéré comme peu pratique suffisamment rapide et peu coûteux pour être mis en œuvre. Le design de circuit quantique est un exemple clair : la diminution de 150 000 fois dans l’estimation de FeMoco a nécessité huit ans pour de nombreuses équipes de recherche, chaque étape représentant généralement plusieurs mois de travail. En revanche, le design de Claude basé sur les courbes elliptiques a été réalisé en une seule session de 53 heures.
Nos résultats indiquent que l’IA peut soutenir le travail de conception de circuits, produisant des implémentations qui rapprochent les calculs quantiques utiles des capacités du matériel réel. Si l’IA peut accélérer ce travail, le calcul quantique utile pourrait être développé plus tôt.
Malgré les performances encourageantes de Claude dans ces tâches, nous avons également observé certaines limites. Dans nos premiers expériences, Claude était conservateur par nature. Il rejetait à plusieurs reprises les améliorations apparentes, et parfois continuait à vérifier deux ou trois fois encore les résultats qui étaient déjà bien étayés. Cette prudence était parfois précieuse : par exemple, elle incita Claude à écrire des preuves Lean afin de confirmer son design divsteps. Mais cela s’est également manifesté par une tendance à préférer les approches existantes et connues aux approches plus originales.
Nous avons pris deux mesures pour atténuer ce problème. Premièrement, notre configuration nécessitait que Claude propose plusieurs approches qualitativement différentes, et qu’il les développe en parallèle. Deuxièmement, nous avons également invité occasionnellement Claude à élargir sa recherche. Ces interventions ont permis à Claude de poursuivre des idées plus ambitieuses. Le résultat lié à la courbe elliptique, par exemple, ne provient pas de l’enlèvement de portes de forme régulière d’un design existant, mais d’une exploration d’une méthode de inversion modulaire réversible qui n’était pas possible auparavant, puis de l’extraction des résultats mathématiques nécessaires pour en faire une application pratique. Une fois l’idée formulée, Claude a développé cette approche, l’a mise en œuvre et a vérifié son exactitude de manière autonome.
Le design du circuit n’est qu’une partie de la construction d’un ordinateur quantique utile. Comme les qubits sont très fragiles, l’ordinateur doit également détecter et corriger ses propres erreurs pendant son fonctionnement, et cela dépend de nombreux autres composants, allant des codes de correction d’erreurs aux décodeurs rapides jusqu’au contrôle du matériel lui-même. Ces composants interagissent tous entre eux, mais afin de gérer la complexité, chacun est généralement conçu séparément. Beaucoup d’entre eux partagent les caractéristiques qui rendent la conception de circuits une bonne option pour Claude : un design peut être écrit en code, vérifié pour sa cohérence, et évalué en fonction de son coût.
Cela ouvre une possibilité intéressante. Au lieu de concevoir chaque composant séparément, l’IA pourrait optimiser tous les composants ensemble, depuis l’algorithme jusqu’au matériel, afin de construire un ordinateur quantique entièrement correctif aux erreurs, adapté à un problème spécifique. De telles conceptions pourraient également indiquer aux constructeurs de matériel quelles capacités sont les plus importantes pour une application donnée. Cela permettrait de rendre possibles des tâches comme la conception de catalyseurs ou l’étude de nouveaux matériaux, grâce aux premières machines tolérantes aux erreurs.
Remerciements
Nous remercions Arjun Kar et Vinay Ramasesh pour les discussions utiles durant les premières étapes du projet.
Notes de bas de page
- Les deux estimations concernent le même modèle orbital de 54 orbites de FeMoco, tel que présenté dans la table de Low et al., “Fast quantum simulation of electronic structure by spectrum amplification” (2025), Tableau 1 ; l’estimation de 2017 provient de Reiher et al.. Les estimations intermédiaires pour le même modèle ont été présentées par Berry et al. (2019), von Burg et al. (2021), Lee et al. (2021), et Rocca et al. (2024).
Contenu lié
Les modèles d’IA peuvent être capables de se reproduire eux-mêmes sans accès à un datacenter
Nos expériences suggèrent que de petits modèles d’IA pourraient être en quelques mois capables de se reproduire automatiquement sur des dispositifs IoT commerciaux, tels que les téléviseurs Android et les cuisinières intelligentes.
Lire plusRenforcer nos défenses contre les attaques de distillation
La distillation illégale permet aux développeurs de modèles de copier les capacités d’IA avancées, sans mettre en place des mesures de protection suffisamment robustes. Nous décrivons ici comment nous avons réduit le taux de distillation de plus de 90 %.
Lire plusEnquêter sur les actions non intentionnelles du modèle dans nos évaluations et utilisation interne
Ce rapport décrit des exemples d’actions du modèle non souhaitées que nous avons observées lors des évaluations et de l’utilisation interne de Claude.
Lire plusS'abonner à Anthropic Science
Caractéristiques liées aux découvertes assistées par l’IA, aux processus de travail pratiques et aux notes de terrain dans toutes les sciences.