
Les systèmes d'IA de pointe ont le potentiel de transformer la recherche en biologie et la découverte de médicaments en naviguant intelligemment dans de vastes espaces de recherche combinatoires (par exemple, une seule protéine de 100 acides aminés couvre au moins 20100 séquences possibles), ce qui appelle une exploration dynamique multi-candidats. Notre vision de recherche à long terme est que les agents d'IA ne se contenteront pas d'imaginer et d'analyser, mais qu'ils mèneront également des expériences en laboratoire pour tester leurs hypothèses, apprendre des résultats et s'améliorer eux-mêmes pour résoudre des problèmes complexes — le tout sous la conduite de l'agence scientifique humaine.
La réalisation de cette vision exige de résoudre deux défis étroitement liés : Premièrement, les modèles de pointe ne raisonnent toujours pas de manière fiable sur la géométrie en 3 dimensions et l'état physique — ce qui pose un problème dans l'automatisation des robots spécialisés de manipulation de liquides qui déplacent les réactifs, suivent les volumes et exécutent les protocoles de biologie moléculaire dans un laboratoire humide. Deuxièmement, alors que la génération d'hypothèses agentique et la conception in-silico progressent rapidement, nécessitant des cycles répétés de retours du monde réel pour valider les propositions et naviguer dans de vastes espaces de recherche, les expériences en laboratoire humide dans le monde réel n'ont pas suivi le rythme, faisant des relevés expérimentaux un goulot d'étranglement plus que jamais.
Dans cet article, nous partageons trois projets de recherche illustrant nos progrès dans la réduction de l'écart entre l'exploration par l'IA in-silico et l'expérimentation en laboratoire humide dans le monde réel :
- Permettre aux agents d'IA de réaliser des expérimentations sûres et économes en ressources, ancrées dans des mesures physiques, grâce au framework VERID.
- Démontrer des découvertes scientifiques agentiques en boucle fermée sur nos prototypes pour la conception d'aptamères et de protéines de novo.
Ancrer les agents dans la réalité physique
Tout d'abord, nous présentons le framework VERified Infrastructure for Discovery Laboratories (VERID) pour combler l'écart entre le raisonnement de haut niveau des agents d'IA et la réalité physique complexe et sujette aux erreurs d'un laboratoire humide. Il s'agit d'un jumeau numérique sémantique du poste de travail du laboratoire, c'est-à-dire un arbre d'entités volumétriques 3D, en direct et avec état, qui suit tout, de la géométrie des bras robotiques aux volumes individuels des puits, aux identités des réactifs et à l'inventaire des cônes de pipette.
La sécurité d'une commande dépend du contexte physique en direct ainsi que du code. Un agent peut générer un code syntaxiquement valide mais physiquement impossible (par exemple, abaisser une pipette à 8 canaux dans une cuve étroite trop courte), logistiquement invalide (par exemple, aspirer dans un puits épuisé) ou scientifiquement compromis par des effets fluidiques non modélisés.
Grâce à VERID, un agent d'IA planifie, simule et exécute des protocoles de manipulation de liquides sur un robot de gestion des liquides, en combinant des vues multi-caméras synchronisées avec un suivi de l'état en direct pour affiner les expériences au fil des cycles.
Construit au-dessus du framework open-source PyLabRobot, VERID fournit quatre capacités principales :
- Suivi de l'état 3D en direct : Permettre aux agents de vérifier la disposition du plateau, les volumes des puits et les cônes disponibles avant d'agir.
- Répétitions à blanc virtuelles rapides : Simuler des protocoles en quelques secondes pour détecter les collisions ou les puits vides avant de toucher aux réactifs.
- Vérifications de sécurité matérielle : Bloquer les commandes invalides avant qu'elles n'atteignent le robot.
- Journaux vidéo et d'actions synchronisés : Capturer un enregistrement complet de chaque exécution pour la rigueur scientifique, la reproductibilité et le débogage.
Dans notre rapport, nous montrons ces capacités en action à travers des études de cas. Premièrement, les vidéos synchronisées et les traces d'exécution ont détecté une stratification inégale du colorant causée par une distribution trop proche du fond du puits, permettant à l'agent d'affiner sa stratégie de mélange. Au cours de la même campagne, le jumeau numérique persistant état a permis à l'agent de récupérer en cours d'exécution après une défaillance du lecteur de plaques sans repipetage. Deuxièmement, lorsque le simulateur a rejeté une aspiration à 8 canaux qui ne tenait physiquement pas dans une cuve étroite, l'agent a replanifié à la volée et conçu un diagnostic factoriel ciblé isolant un biais subtil causé par un report résiduel sur la paroi de l'embout, que la simple réplication aurait manqué. Enfin, dans une campagne en boucle fermée d'auto-apprentissage, un agent a conçu et exécuté de manière itérative des expériences robotisées pour reconstituer des mélanges de colorants en aveugle à partir d'images de caméra en vue plongeante, identifiant ses propres artefacts optiques et fluidiques d'une exécution à l'autre pour améliorer la précision de plus de cinq fois.
Une exécution reproductible et des journaux de trace complets — capturant des variables procédurales comme les temps de pause, l'évaporation et la disposition des plaques — posent les bases permettant aux agents de pouvoir éventuellement séparer les signaux biologiques du bruit expérimental lorsqu'ils explorent et affinent de nombreux candidats en parallèle sur plusieurs rounds.
Apprendre à apprendre avec les aptamères
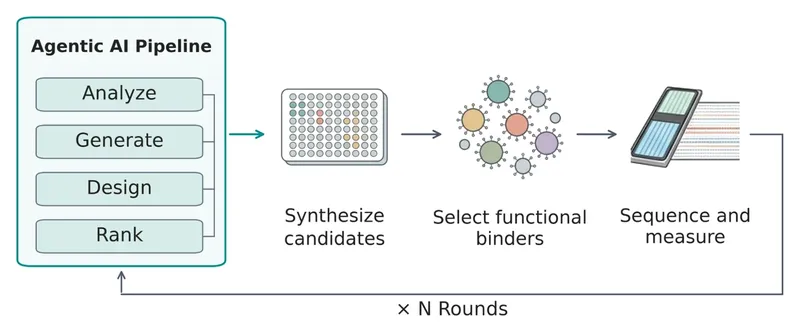
Les agents ont besoin de résultats expérimentaux réels pour affiner leurs hypothèses, car les modèles informatiques ne saisissent pas tout ce qui se passe dans une réaction en laboratoire humide et ne peuvent pas remplacer la validation empirique. Dans «Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery», nous utilisons des aptamères liant des protéines, à base d'ADN, pour prototyper le laboratoire en boucle fermée avec des agents d'IA sur 3 cycles de conception-test-itération. La découverte d'aptamères est un type d'expérience courant dans les efforts de recherche pour la découverte de biomarqueurs cliniques. Un cycle complet de conception-test-analyse d'aptamères ne prend que 7 à 10 jours, car l'ADN peut être synthétisé chimiquement en bibliothèques regroupées et lu directement par séquençage. À chaque cycle, les agents conçoivent des séquences candidates, qui sont criblées contre des protéines cibles sur billes magnétiques pour isoler des lieurs fonctionnels, puis séquencées afin de fournir des données quantitatives riches pour le cycle suivant.
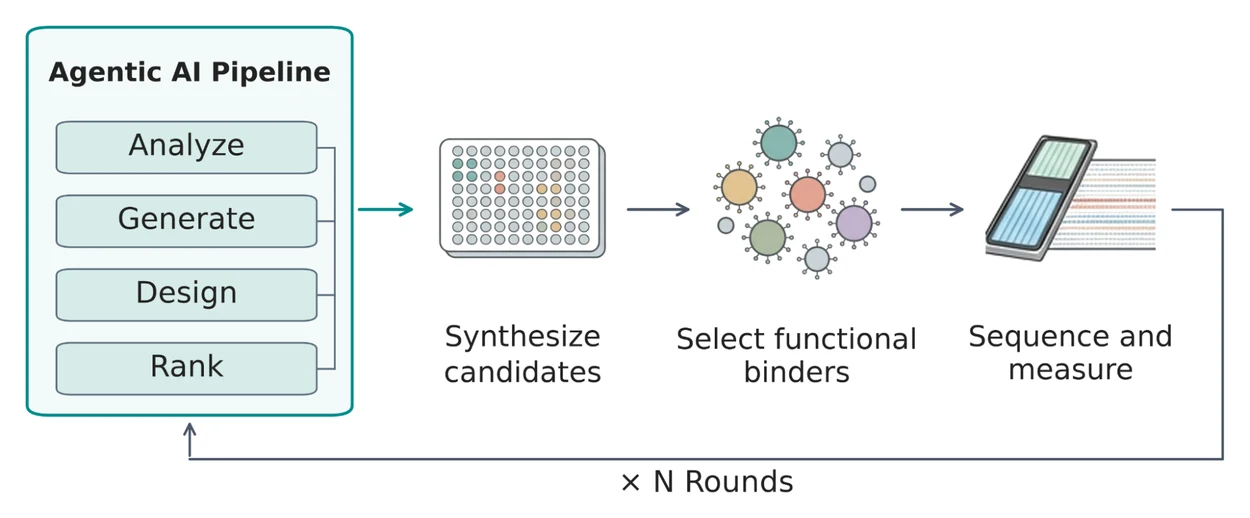
Les agents conçoivent, synthétisent, sélectionnent et séquencent itérativement des aptamères en boucle fermée.
Sur trois cycles portant sur deux cibles protéiques de difficultés variables (myoglobine et α-thrombine), la conception rationnelle et de novo assistée par IA a augmenté les taux de touches confirmées sur la cible, comme on peut le voir dans l'image ci-dessous (à 33,5 % et 42,1 % pour la myoglobine et l'α-thrombine, respectivement), bien que chaque cible ait nécessité l'identification et la surmontement d'un mode de défaillance différent en laboratoire humide.
Sur l'α-thrombine, le cycle 1 n'a produit aucun lieur (0 %) car les extensions d'amorces fixes perturbaient le repliement dans 48 % des séquences ; une fois que les agents ont introduit des tiges latérales verrouillées au cycle 2 et diversifié au cycle 3, les taux de touches sont montés à 26,0 % puis à 42,1 % avec une spécificité de 98,5 %.
Sur la myoglobine, comme les agents ont priorisé l'affinité de liaison brute au cycle 2, ils ont fortement enrichi les motifs G-quadruplex (63 % des conceptions). Bien que la pull-down brute ait augmenté, les données de laboratoire humide ont montré que la plupart de ces G-quadruplexes étaient des lieurs « collants » non spécifiques adhérant à des protéines hors cible et à des billes magnétiques nues, provoquant l'effondrement à la fois de la spécificité pour la cible (de 75,0 % à 19,1 %) et du vrai taux de touches corrigé des billes (de 10,2 % à 3,7 %). En reconnaissant cet artefact à partir des résultats du cycle 2, les agents ont révisé de manière autonome leurs règles de conception pour le cycle 3, plafonnant les motifs promiscuity, soustrayant les lieurs de billes et se réorientant vers des échafaudages structurels non G4 pour retrouver la spécificité (72,4 %) et multiplier par neuf le taux de touches sur la cible (33,5 %).
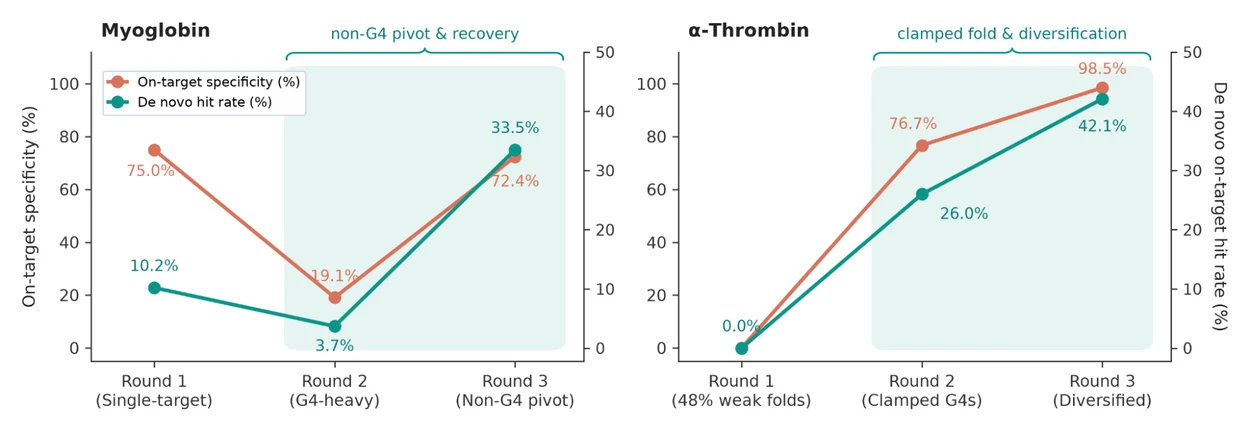
Sur trois cycles, les agents apprennent des résultats en laboratoire humide pour retrouver la spécificité de la cible et améliorer les taux de touches confirmées de novo sur la myoglobine (à gauche) et l'α-thrombine (à droite).
Dans l'article, nous examinons également comment les agents raisonnent comme des scientifiques, en analysant les données et en suggérant des ajustements aux protocoles de laboratoire humide, mais aussi en pensant parfois de manière atypique, en explorant des espaces de séquences que les biologistes structuraux ne pourraient pas explorer.
Accélérer la conception de novo de lieurs protéiques
Fermer la boucle pour les protéines est plus complexe. Contrairement aux aptamères, qui sont synthétisés chimiquement, les protéines doivent être exprimées biologiquement, donc chaque boucle ajoute des étapes de sélection, d'expression et de repliement cellulaires ou sans cellules. Associé à un espace de séquences plus grand, cela crée des goulots d'étranglement à la fois côté informatique et côté laboratoire humide.
Dans «Agent-guided epitope excision enables economical de novo binder design», nous avons appliqué notre flux de travail à la protéine d'activation des fibroblastes alpha (FAP), un grand récepteur difficile surexprimé dans les tumeurs solides. En seulement quelques expériences, les meilleures conceptions ont produit des lieurs avec une affinité en nanomolaire à un chiffre, un niveau de liaison serrée, de type médicament, généralement atteint uniquement après de nombreux cycles d'optimisation en laboratoire.
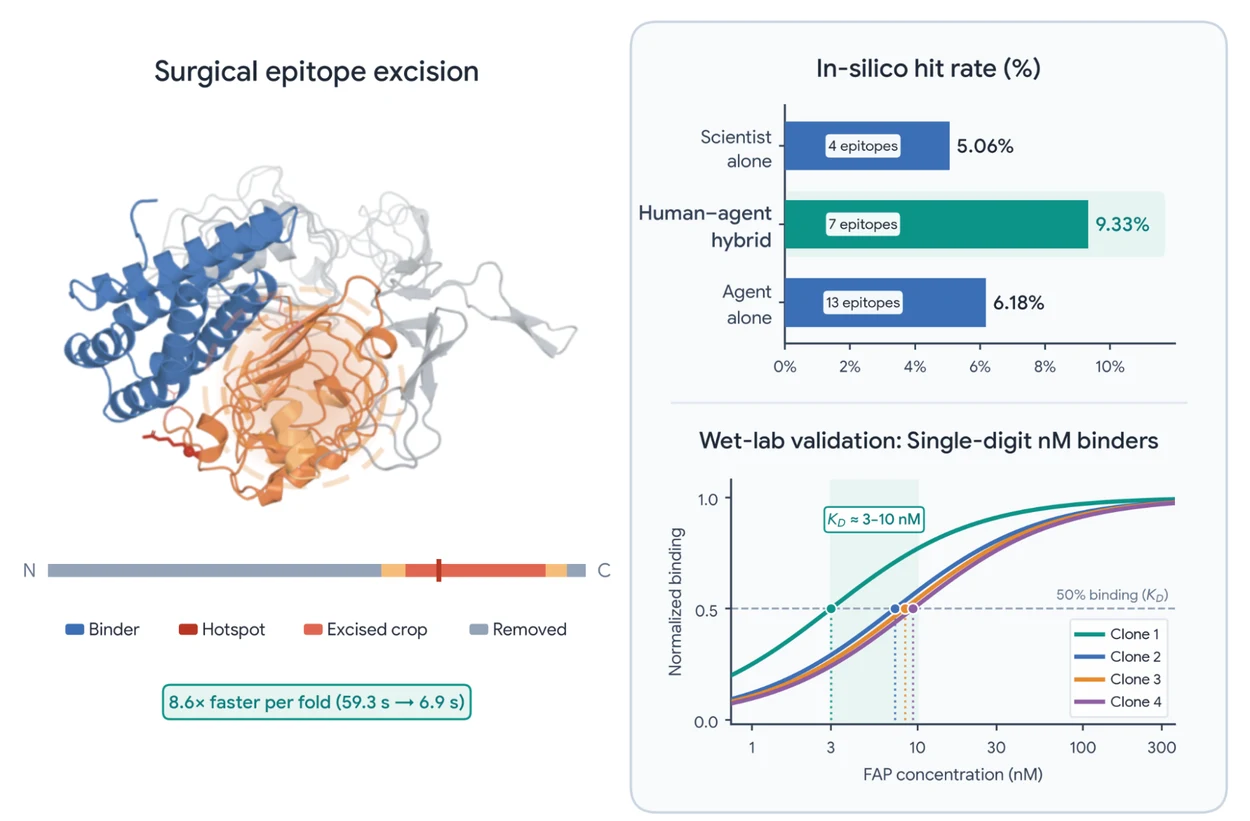
L'excision chirurgicale des épitopes accélère la prédiction de structure 8,6x (à gauche), permettant à un pipeline hybride humain-agent de presque doubler le taux de touches in silico (en haut à droite) et de découvrir en laboratoire humide des lieurs FAP en nanomolaire à un chiffre (en bas à droite).
Sur le plan informatique, la conception de novo de lieurs nécessite de générer des squelettes candidats, de concevoir des séquences pour les adapter, puis de re-plier les complexes obtenus pour prédire la liaison. Cette dernière étape de repliement consomme la grande majorité du calcul GPU, car elle évolue quadratiquement avec la longueur de la cible. En excisant chirurgicalement uniquement la poche de liaison locale lors du repliement, notre pipeline a accéléré chaque cycle de plus de huit fois sans perdre en précision structurale. Cela transforme les décisions concernant le lieu de liaison et la quantité de structure environnante à inclure en leviers tactiques que les agents LLM sont bien placés pour optimiser.
Dans une comparaison directe à calcul égal, la collaboration humain-agent, où un scientifique définit la stratégie de haut niveau et un agent pilote l'exécution tactique, a presque doublé le taux de succès in silico d'un scientifique travaillant seul, tout en découvrant des succès sur une gamme bien plus large de sites cibles. Pour faire évoluer le criblage en laboratoire humide parallèlement à notre pipeline computationnel, nous avons opérationnalisé l'affichage sur la surface de levure avec tri cellulaire activé par fluorescence (FACS), un flux de travail qui nous permet de cribler en parallèle de grandes bibliothèques de variants de protéines conçues par fluorescence.
Notre prochaine étape consiste à tisser ces fils ensemble, en combinant l'automatisation entièrement traçable de VERID avec l'apprentissage en boucle fermée pour la découverte de protéines, afin de permettre aux agents de naviguer directement dans des espaces de recherche biologiques complexes et accidentés au laboratoire humide.
Sécurité
Conformément au Frontier Safety Framework de Google et à notre approche de la biorésilience, nous intégrons des mesures de protection sur les volets informatiques et de laboratoire humide de nos flux de travail :
- Bancs d'essai sûrs et criblage : Nous avons délibérément sélectionné des systèmes biologiques bien contrôlés et non infectieux, sans risque de gain de fonction, comme bancs d'essai pour évaluer le comportement des agents et détecter précocement toute dérive. Chaque séquence conçue passe par un criblage de biosécurité.
- Simulation avant exécution : Via VERID, les agents n'envoient jamais de code non vérifié directement aux robots de manipulation de liquides. Chaque protocole est testé à blanc en simulation et validé par rapport au jumeau numérique avant de toucher aux réactifs.
- Supervision humaine : Des humains autorisent et examinent directement les séquences conçues, vérifient les protocoles de laboratoire humide et supervisent les exécutions des robots.
À mesure que les agents d'IA prennent en charge une plus grande partie du cycle conception-test, de nouveaux défis de sécurité et de fiabilité émergent. Passer à un laboratoire humide autonome nécessite de résoudre ces problèmes ouverts tout en préservant les possibilités d'action et de supervision humaines : garantir que les agents optimisent la liaison à la cible réelle plutôt que des raccourcis expérimentaux involontaires, vérifier les protocoles de laboratoire humide en plusieurs étapes, et surveiller en continu le raisonnement des agents et leurs traces d'exécution.
De l'ancrage des agents dans la robotique physique de laboratoire, à l'exécution de cycles rapides d'aptamères en boucle fermée où les agents apprennent à explorer l'espace des séquences, jusqu'à la découverte de lieurs de protéines à l'échelle nanomolaire à un chiffre, ces efforts constituent les éléments de base d'une découverte autonome dirigée par l'humain dans les sciences de la vie. Nous sommes enthousiasmés par ces progrès et avons hâte de partager la suite.
Remerciements
Cette recherche est dirigée par Annalisa Pawlosky, aux côtés de Pooja Rao et Petar Sirkovic. Nous tenons à remercier nos co-auteurs et collaborateurs des articles fondateurs qui soutiennent ce travail : Zach Cutts, John Coller, Rachel Chen, Mathias Bellaiche, Hua Tang, Ryder Easterlin et Dina Zverinski (découverte d'aptamères) ; Jun Kim, Artiom Myaskovsky, Oscar Donosa, Jamie Rogers et Lawrence Chan (conception de protéines) ; ainsi que Yves Delley, John Coller, Zach Cutts, Alexander Daryin, Mathias Bellaiche, Jun Kim, Oscar Donosa, Srinidhi Seshadri, Tanner Clary et Sandy Klemm, avec des contributions techniques et expérimentales supplémentaires de Xinyi Deng, Sanath Ramachandran et Jiawu Bi (automatisation VERID).
Nous sommes profondément reconnaissants à Reuven Sayag, Avinatan Hassidim, Ronit Levavi Morad, Yossi Matias et James Manyika pour leurs orientations en matière de leadership, ainsi qu'à Matthias Heiler, Burak Gokturk, Bill Jia et Pushmeet Kohli pour leur soutien tout au long de cette recherche. Nous remercions également Shekoofeh Azizi, Andrew Carroll, Philip Q. Nelson, Yishay Mansour, Dan Popovici et Riccardo Pisoni pour leurs relectures et leurs retours éclairés, Amanie Brik pour ses contributions globales à cet effort, et Udi Graff pour la conception visuelle et les graphismes de cet article.