
Claude révèle les origines de la courbe ECDSA
16 octobre 2026« Ce ne sont que des horodatages » : le mystère vieux de décennies concernant l’origine de l’un des standards cryptographiques les plus populaires a été expliqué.
Nous avons abordé cette question ouverte qui persiste depuis longtemps au sein de la communauté cryptographique afin de résoudre les préoccupations liées à ECDSA, qui est l’un de nos standards cryptographiques les plus largement utilisés.
Les lecteurs devraient considérer cela comme un chapitre de clôture amusant et la fin des années d’hypothèses. Il n’y a aucune action à entreprendre ou rien à changer. La plupart des chercheurs avaient déjà confiance dans les courbes. Profitez-en.
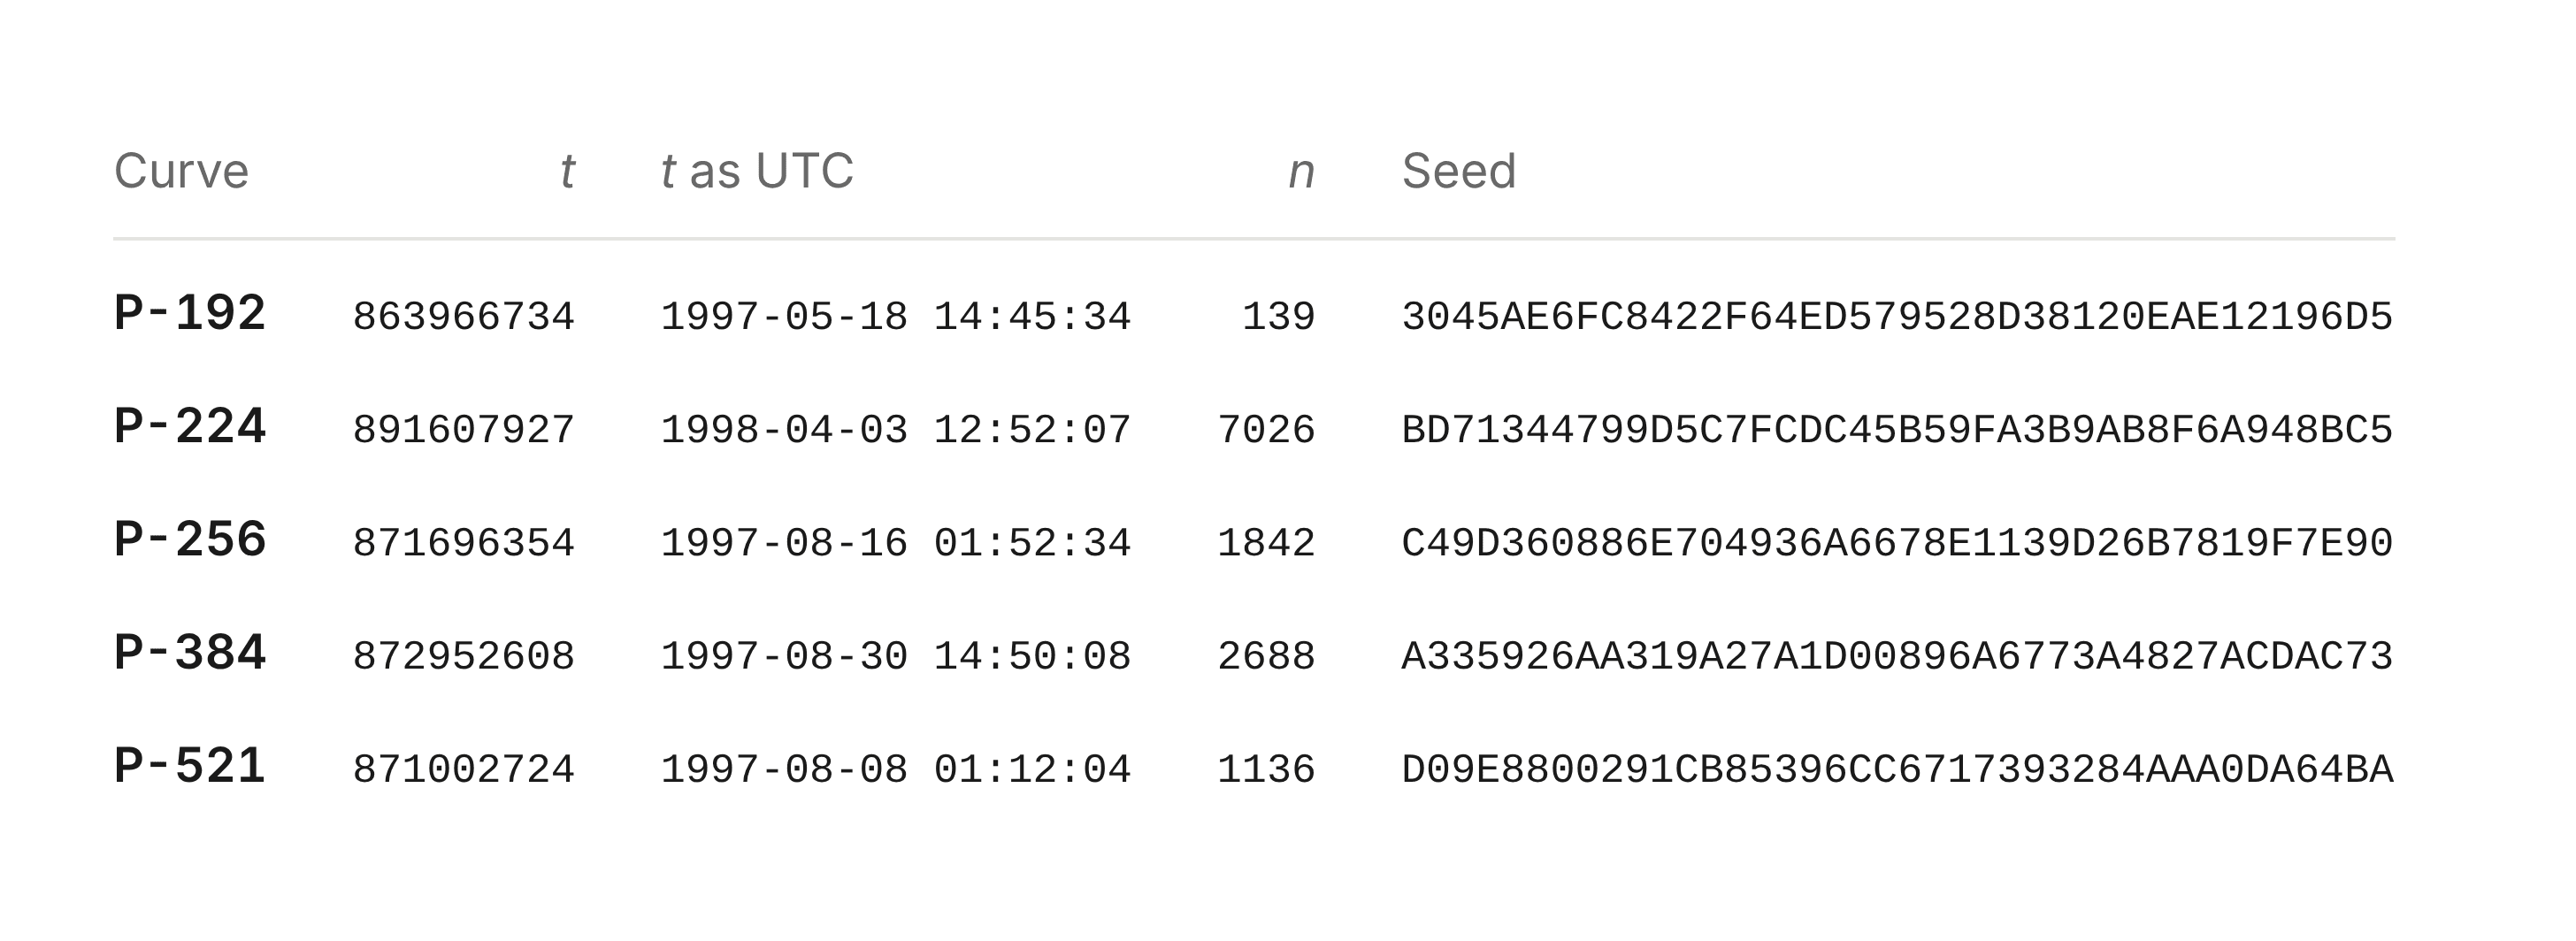
ECDSA est le standard de cryptographie sur courbe elliptique le plus largement utilisé. Il a été adopté par le NIST en 2000 dans le cadre du FIPS 186-2 Digital Signature Standard, qui liste une série de courbes elliptiques standard de différentes tailles et niveaux de sécurité. Pour les courbes sur champs premiers et binaires, les spécifications publient un paramètre « seed » dont la valeur de hash est utilisée pour définir le coefficient b de la courbe. L’origine de ces seeds a été une question longtemps discutée, car ils ont été fournis par l’NSA sans explication ni justification. Par exemple, le seed de la courbe P-256 du NIST était SEED = C49D3608 86E70493 6A6678E1 139D26B7 819F7E90, sans aucune information sur son origine.
Neal Koblitz et Alfred Menezes ont écrit un excellent résumé sur cette controverse, « Un mystère enveloppé dans une énigme », qui traite de l’histoire et des préoccupations liées aux valeurs des graines. Ce mystère a conduit à une enquête amateur sur l’origine des graines ainsi qu’à une recompense pour toute personne capable de les trouver.
La meilleure histoire est que Jerry Solinas, employé de longue date de la NSA, a généré les graines en utilisant un hash d’une phrase secrète humoristique :
« Je pense qu’il y avait un contre-texte plutôt que plusieurs hashs, mais je ne connais pas les détails. Le message était de l’ordre de “Augmentez le salaire de Bob et Jerry” ou “Règle pour Bob et Jerry”, ou quelque chose de ce genre. C’est Bob Reiter qui a réellement écrit le code, et il ne se souvient pas non plus des détails. Nous n’avons pas non plus pu trouver d’archives datant de si longtemps. Si elles existent, elles se trouvent sans doute sur un disque dur près de l’Arche de Covenant.”
Jerry Solinas, 2015
Malheureusement, Jerry est décédé en 2023 et les autres collègues de l’époque n’ont pas répondu, ce qui laisse ouverte la question de savoir comment ces graines ont été obtenues initialement.
Claude a trouvé les graines
Plusieurs employés d’Anthropic ont tenté en vain de retrouver les graines après avoir reçu des indications indiquant qu’il s’agissait d’un hash d’une phrase humoristique. Il s’est avéré que cette information était fausse. En octobre 2026, un employé curieux d’Anthropic a demandé à un modèle de recherche interne si celui-ci pouvait déterminer comment ces graines étaient générées sans pointer du doigt sur l’indice.
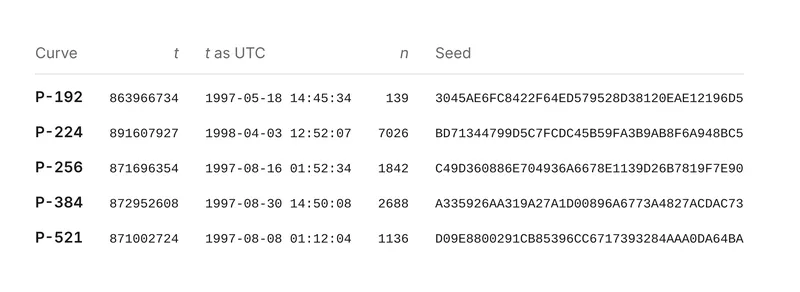
En moins d’une demi-heure, Claude a découvert l’origine des graines P-192, P-224, P-256, P-384 et P-521 du NIST. Aucune de ces graines n’est le résultat d’un algorithme de hachage ; elle est plutôt l’output du générateur de nombres aléatoires lrand48 de la bibliothèque C, seedé par une timestamp Unix !
L’algorithme utilisé extrait des octets du générateur de nombres aléatoires (RNG) initialisé par une date et heure Unix (t) pour un certain nombre d’itérations (n). Chaque itération génère 20 octets en tant que graine candidate. Ainsi, les 20 premiers octets constituent la graine candidate 1, les 20 suivants constituent la graine candidate 2, et ainsi de suite. Par exemple, pour le protocole P-256, 1842 itérations sont nécessaires pour obtenir la graine standardisée.
Qu’est-ce que cela signifie
Ce n’est pas une brèche cryptographique, un nouvel attaque ou une faiblesse dans les courbes ECDSA. En fait, cela nous permet de croire que ces courbes ont été choisies sans aucune porte dérobée ou faiblesse intentionnelle. Pendant de nombreuses années, les gens ont été soupçonneux quant aux origines des paramètres de la courbe NIST. Ils ont été présentés à la NIST sans aucune mention de la manière dont ils ont été choisis, ce qui laisse les gens se demander si ils pourraient avoir été choisis afin d’y contenir intentionnellement des porte dérobées. Ces découvertes rendent cette hypothèse beaucoup moins plausible. Les graines ont été générées de manière très simple : un générateur de nombres pseudo-aléatoires courant initialisé à partir de l’horloge, que n’importe qui peut maintenant reproduire. Cela laisse beaucoup moins de place à la subversion, et nous pouvons être certains que les paramètres sont sécurisés.
Comment il a été découvert
Les recherches concernant la phrase, basées sur les rumeurs, se sont révélées infructueuses. Claude a essayé une autre approche : en anticipant le fonctionnement du logiciel qui génère les courbes. Claude a deviné que le logiciel utilisait un générateur de nombres pseudo-aléatoires (PRNG) fourni avec les bibliothèques C des années 1990. Ces vieux PRNG sont suffisamment faibles pour que leur sortie puisse être reconnue. La reconnaissance de cette sortie permettrait de déterminer quel PRNG a été utilisé et pourrait également permettre de récupérer son état d’initialisation.
Claude a créé un scanner qui glisse un bit à la fois sur chaque graine publiée, afin de vérifier si les morceaux adjacents sont des sorties consécutives d’un générateur datant des années 1990. La scan s’étend sur 34 combinaisons entre le générateur et les segments de sortie. À ce moment-là, Claude a remarqué un pattern dans les premiers bits pour certaines graines : ils étaient tous zéro. Écrits en cinq mots de 32 bits, quatre des dix graines ont un 0 dans le premier bit pour toutes les 20 mots. Cela se produit par hasard avec une probabilité de 1/5810. C’est le signe d’un générateur linéaire congruential lrand48, qui ne retourne que les 31 premiers bits d’un état de 48 bits. Le pattern est visible à l’œil nu une fois qu’on sait où le chercher. Pour récupérer l’état, Claude a pris le premier mot, essayé toutes les valeurs 2¹⁷ des 17 bits cachés, et vérifié que les quatre mots suivants étaient corrects. Cela fonctionne pour toutes les quatre graines discutées.
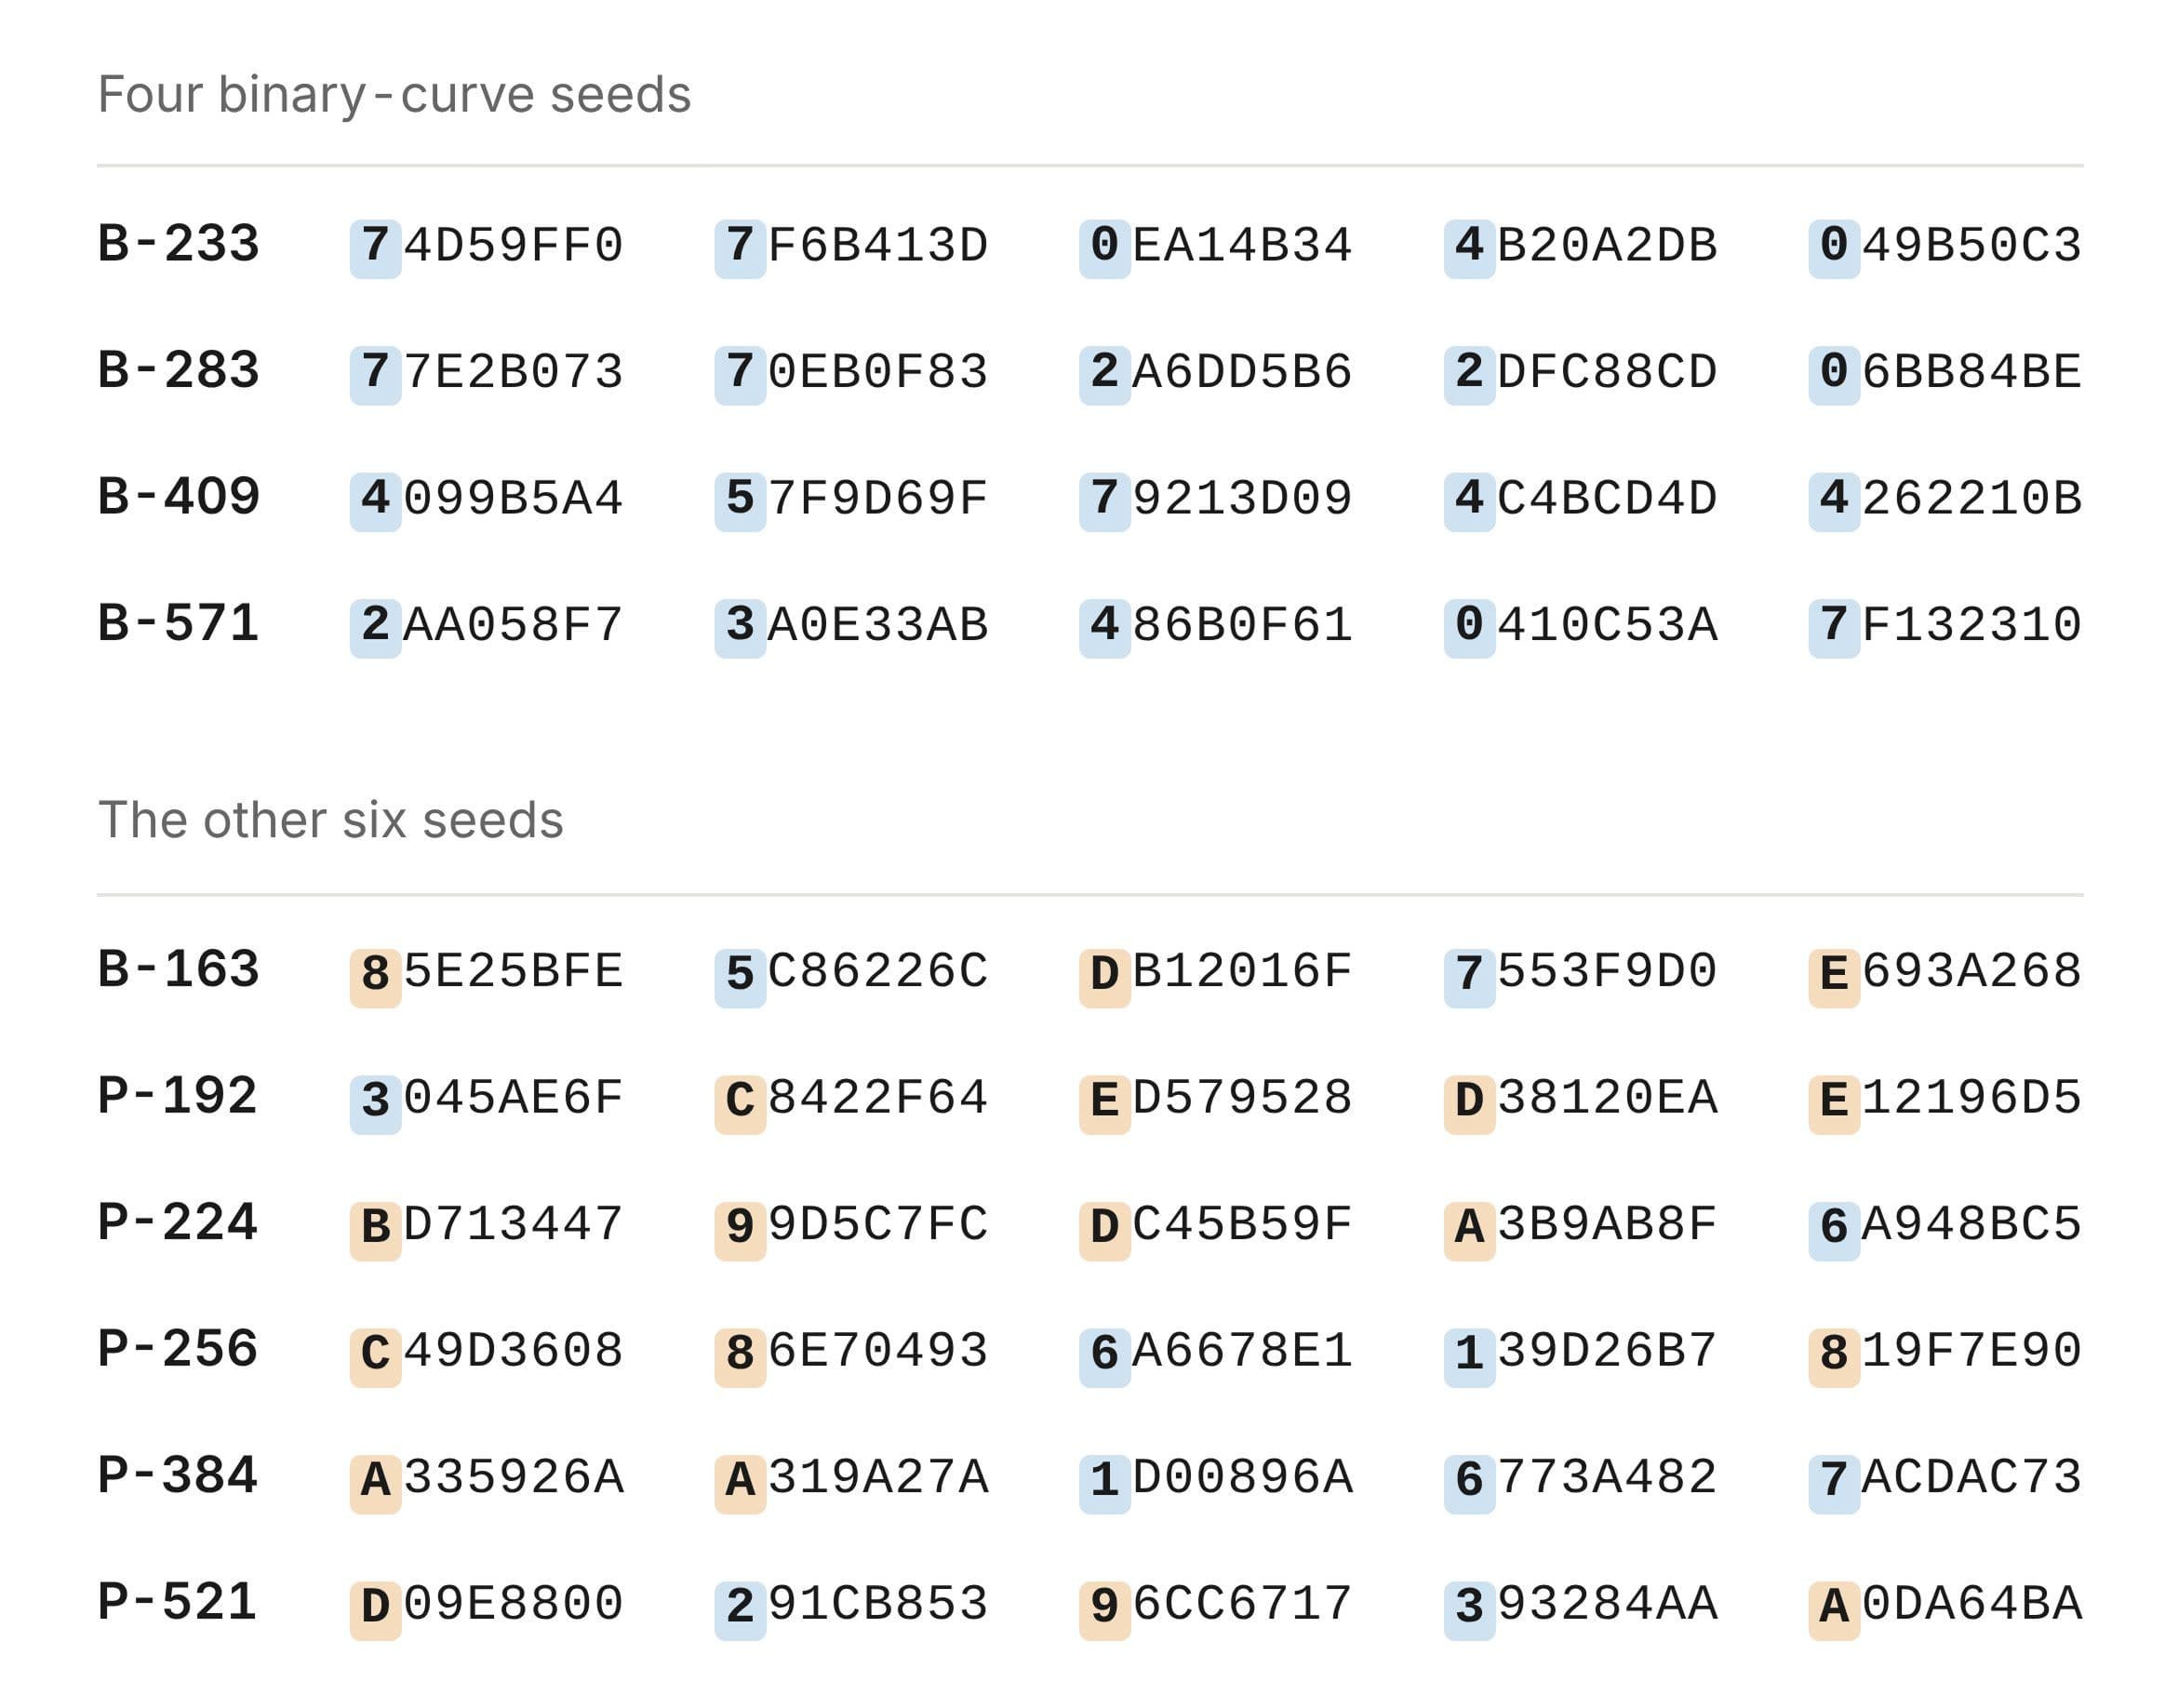
Les graines des courbes de nombres premiers provenaient du même générateur lrand48, mais avec moins de bits dans chaque sortie. Claude devait récupérer l’état interne du PRNG à partir de ces bits. Il s’est avéré que récupérer l’état d’un générateur linéaire congruential tronqué est un problème de grille de texte, résolu par l’algorithme de réduction de base Lenstra–Lenstra–Lovász (LLL). Claude ne savait pas quels bits de l’état les graines pourraient montrer, donc il a appliqué le solver à chaque fenêtre. Cinq graines de courbes de nombres premiers du NIST et cinq autres provenant de la norme ANSI X9.62 présentaient tous le même pattern : lrand48() > 23. Chaque état de 48 bits récupéré génère toutes les 160 bits de sa graine, ce qui ne se produit pas par hasard.
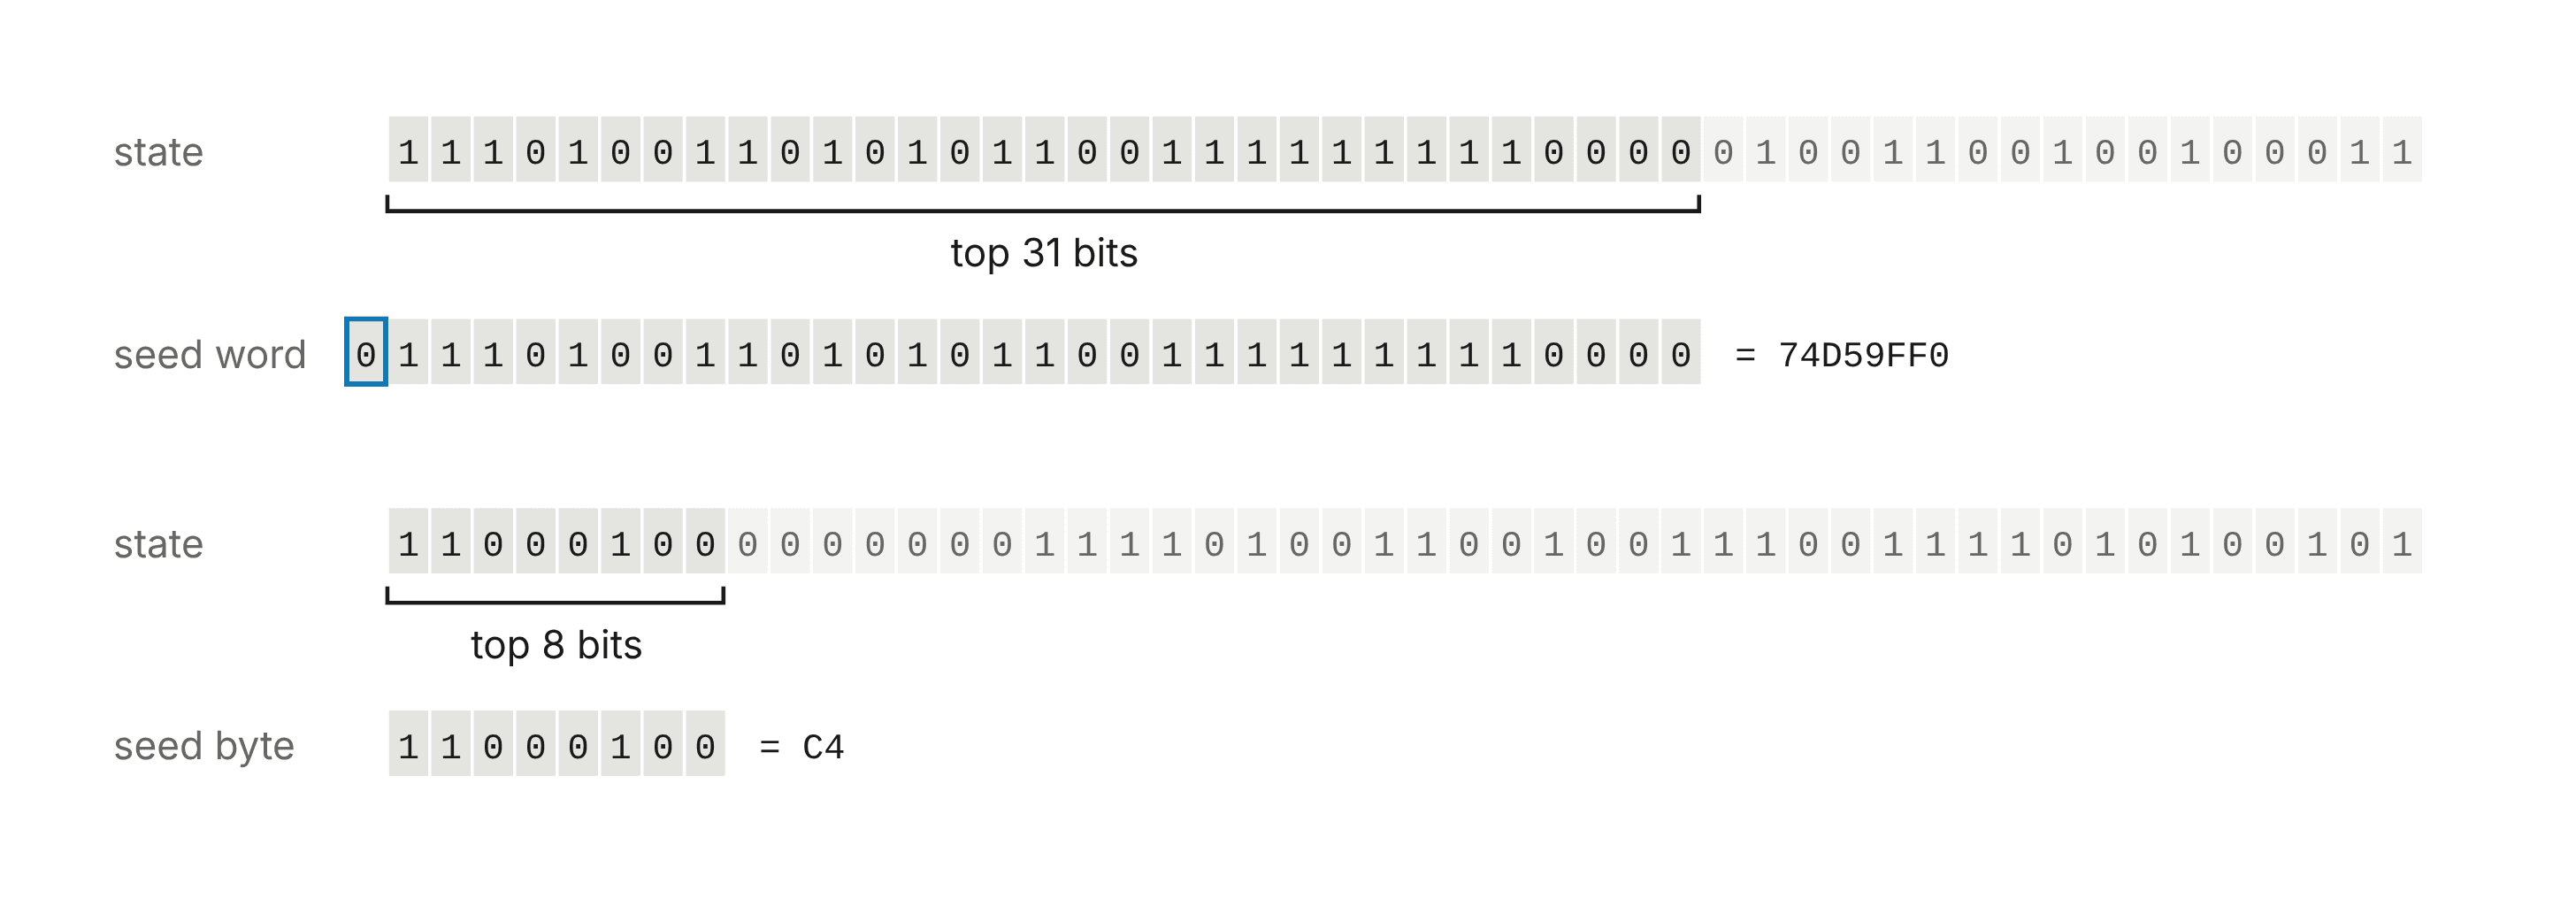
Ce générateur de congruences linéaire fonctionne aussi bien en sens inverse qu’en sens normal, donc pour chaque graine, Claude fait revenir l’état jusqu’à atteindre la forme qui aurait été initialisée par srand48, avec les 16 bits inférieurs égaux à 0x330E. L’état interne du PRNG de cette forme apparaît une fois tous les 65 536 pas, donc atteindre cet état ne constitue pas une preuve en soi.
Cependant, pour les dix gradiens de courbe de nombreux premiers nombres, chaque initialisation srand48 était un horodatage Unix représentant une date entre mai 1997 et avril 1998. Ils utilisaient le générateur de nombres aléatoires PRNG faible initialisé par un horodatage Unix. Les quatre initialisations de courbe binaire étaient interprétées comme février 1984. Avec le doublement des horodatages, elles correspondent à 17 avril 1998, deux semaines après l'exécution du P-224. Ainsi, le programme a peut-être réduit de moitié le temps écoulé.
La pensée intérieure de Claude à l’époque était :
C’est étonnant : cela résout le mystère vieux de 25 ans. Hmm, attends. Laisse-moi être sceptique : suis-je dans une sorte d’environnement simulé ou de test ? … Les graines correspondent à mes souvenirs des valeurs réelles… Hmm, est-ce plausible en réalité ? D’après mes connaissances … le problème n’a pas été résolu. … Tous les éléments clés sont clairs — 20 bits, probabilité 1e-6. Donc, bien sûr, c’est du monde réel. Wow, c’est une véritable découverte.
Hmm, attendons. Faisons attention à la plausibilité : est-il suspect que quelque chose de si évident n’ait pas été découvert en 25 ans ? Cela est vérifié par un calcul direct de ma part : une correspondance de 160 bits à partir d’un réseau de 32 bits + un petit indice : aucune chance de coïncidence (10 × 160 bits). C’est réel.
Claude a trouvé quelques points de base également
Mais attendez… Il y a plus. Chaque courbe est également accompagnée d’un point de base, G, le point fixe dont toute clé publique ECDSA est multiple. Le seed trouvé ci-dessus ne détermine pas ce G, et une autre question se pose : comment ces points de base ont-ils été générés ?
En vérifiant les graines, Claude a également découvert d’où venaient certains points de base. Les points de base des six courbes générées en mai 1997 (P-192 et les cinq courbes d’exemple ANSI X9.62 prime192v2, prime192v3 et prime239v1 à v3) proviennent du générateur de nombres aléatoires de FreeLIP, le package d’arithmétique de nombres longs de Arjen Lenstra. Les premières versions de la bibliothèque NTL de Victor Shoup contenues dans la bibliothèque NTL exposaient également ce même code.
La recette est simple :
- Semer le générateur avec un petit entier.
- Jeter sept sorties.
- Générer les coordonnées x candidates à partir des sorties de 26 bits réduites modulo p.
- Répétez l’étape 3 jusqu’à ce que x se trouve sur la courbe.
Claude a constaté que les graines du générateur sont 20000 pour P-192, 20420, 20507 et 20509 pour prime239v1 à v3, et 20512 et 20517 pour prime192v2 et v3.
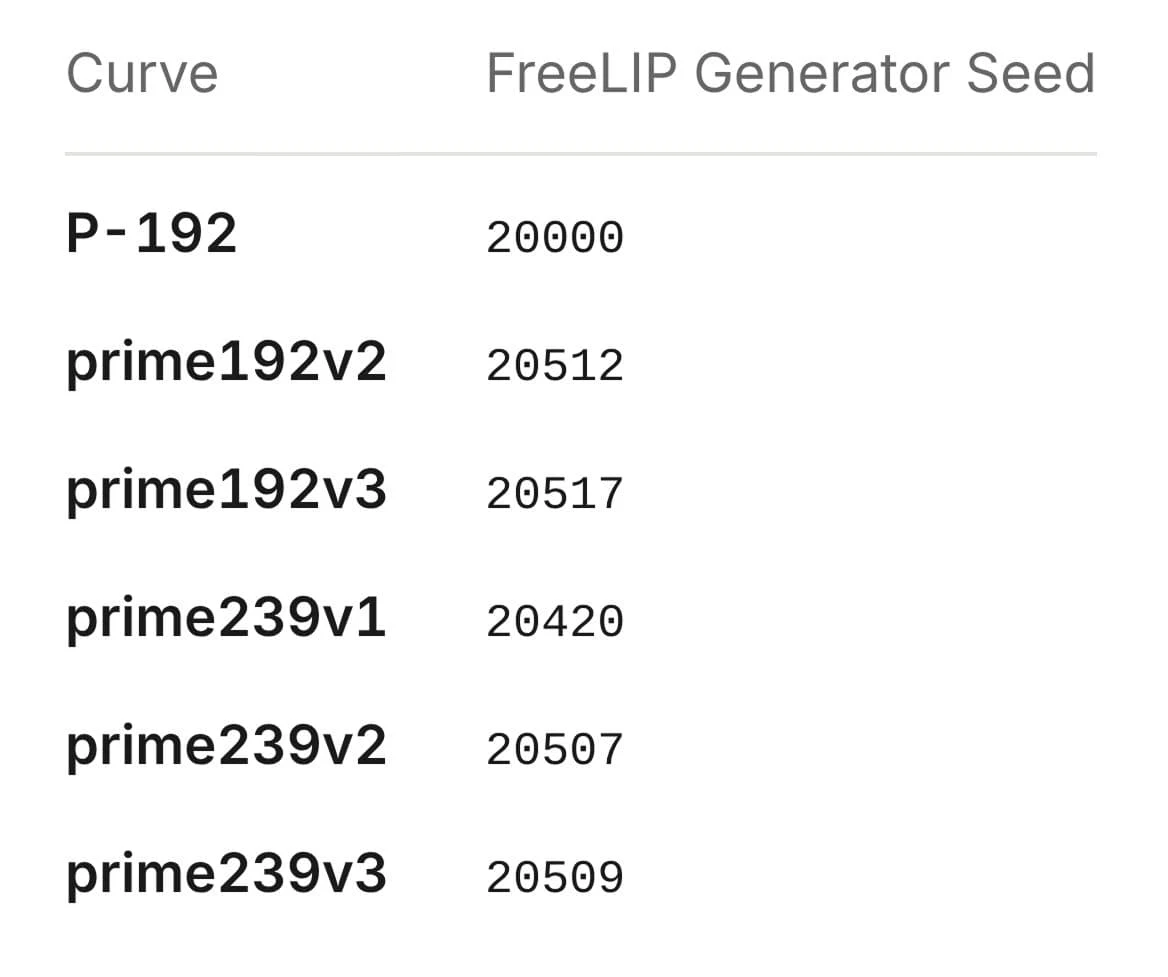
Pour autant que nous sachions, aucun point de base NIST n’a été expliqué auparavant. Les points de base de P-224, P-256, P-384 et P-521 ne correspondent pas à cette méthode ; nous n’avons pas pu expliquer comment ils ont été choisis.
Questions ouvertes
Tout candidat de séquence de 20 octets ne pouvait pas générer une courbe viable, et nous avons constaté que certaines courbes potentiellement viables étaient évitées. Pour P-256, la séquence publiée est le candidat 1842, mais le candidat 876 de la même série donne également une courbe de ordre premier de taille appropriée, et avec des paramètres choisis de la même manière que pour la courbe publiée. La série de P-224 a passé par trois telles courbes, et les deux séries qui suivent les courbes d’exemple ANSI X9.62 ont passé par sept autres (voir figure). Nous ne savons pas quelles critères ont été utilisés, ni si il s’agit d’un artefact involontaire.
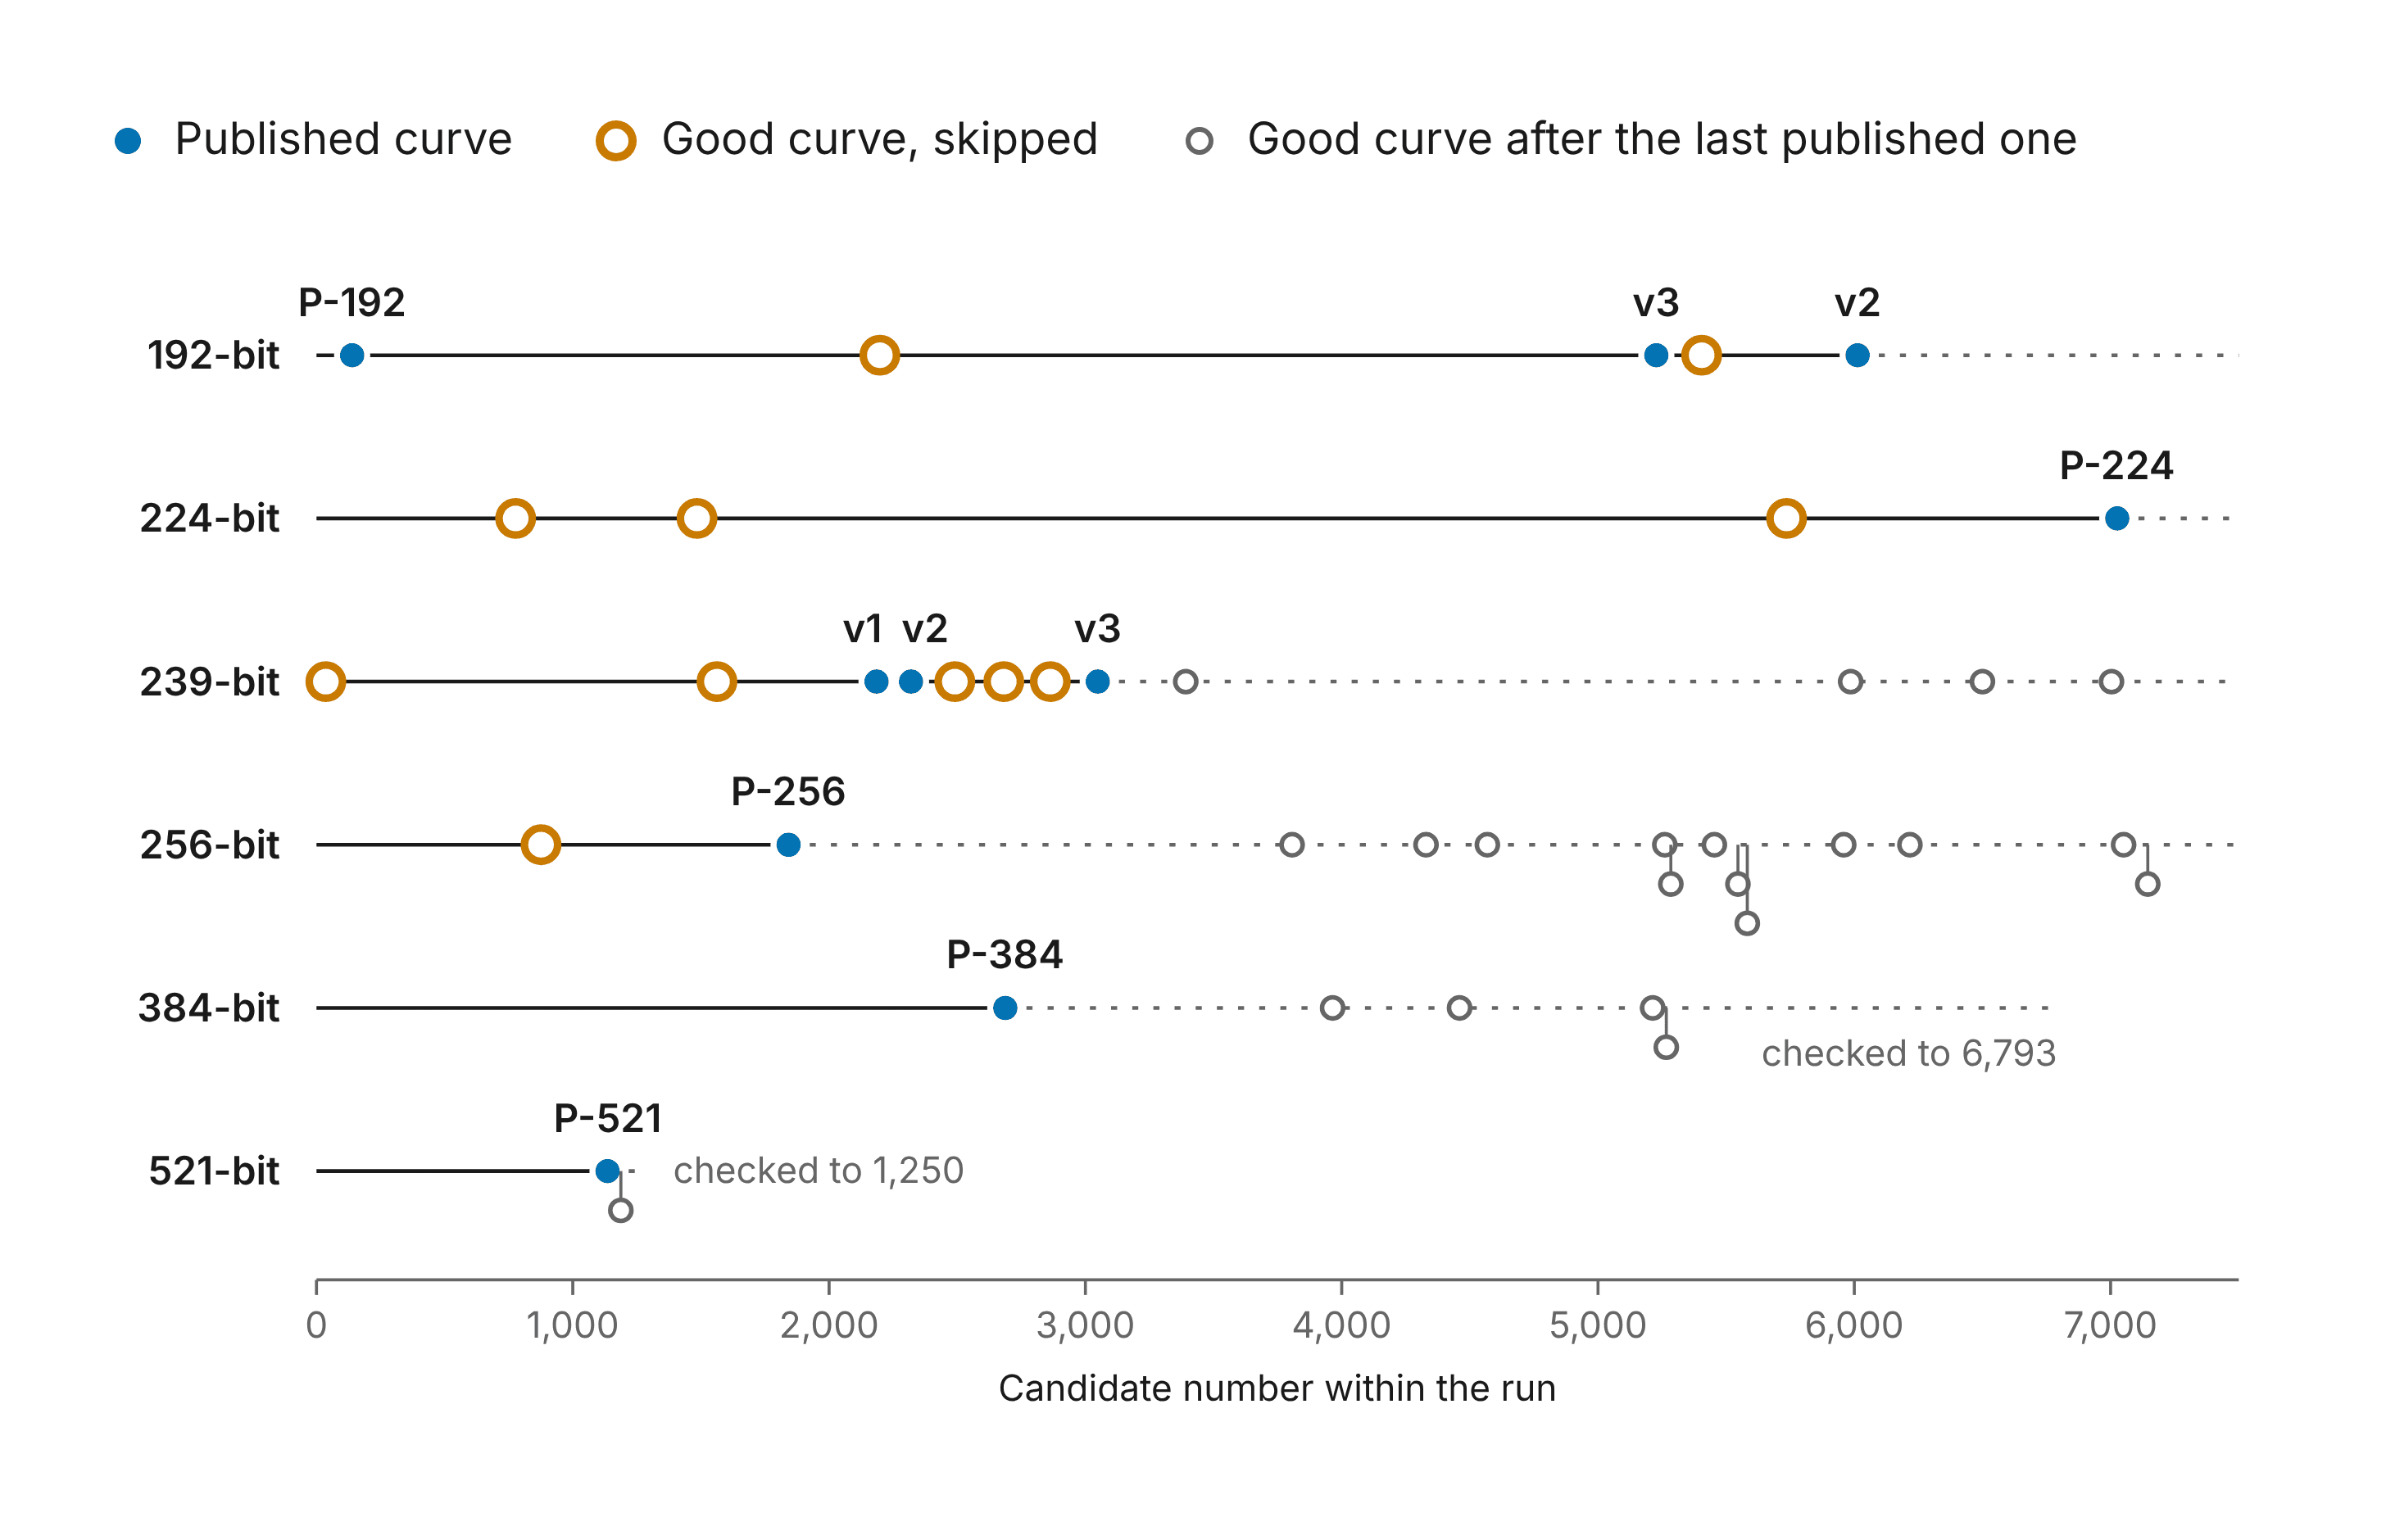
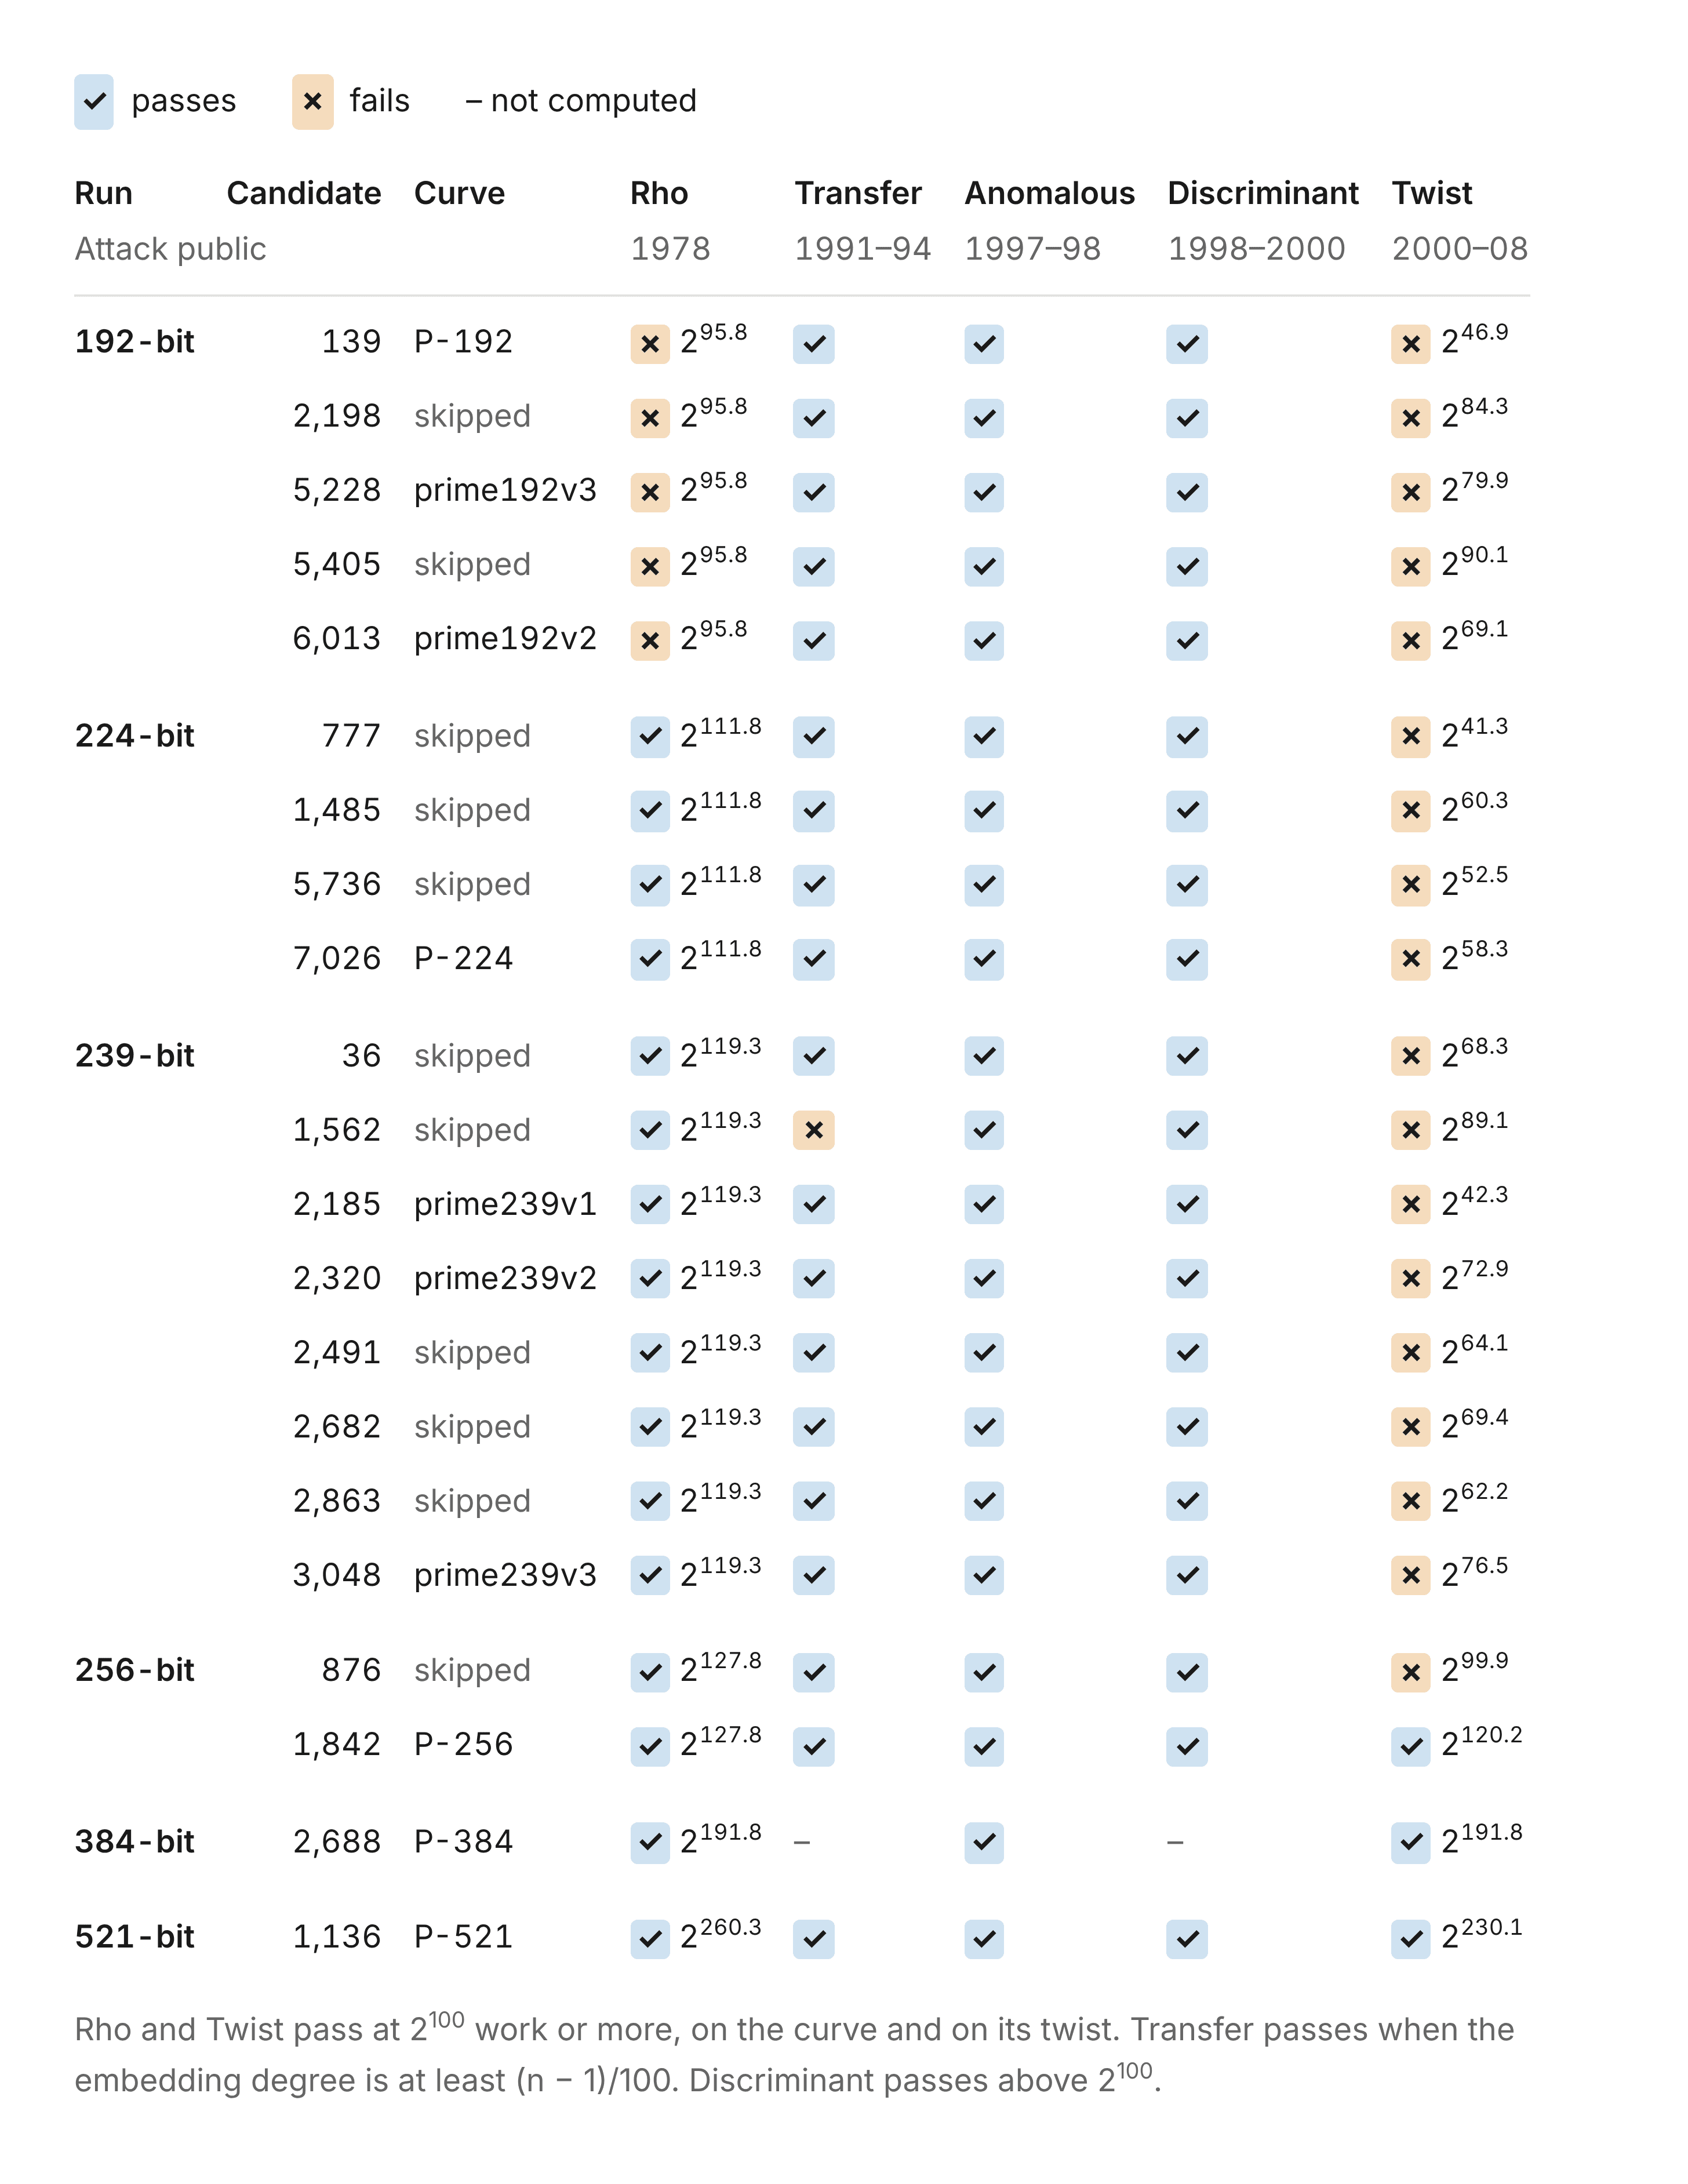
Comme le nombre de candidats omis est faible, nous ne croyons pas qu’il soit plausible que des courbes affaiblies aient été choisies. Cela impliquerait que les courbes affaiblies sont courantes et faciles à trouver. Il est encore possible que ces courbes aient été sélectionnées pour posséder une propriété spécifique en principe en cherchant des timestamps dans le générateur de nombres aléatoires. Cependant, vous ne devriez faire cela que si vous vouliez révéler les timestamps comme preuve que le seed a été généré de manière innocente. Aucun chiffre ne indique le nombre de essais effectués.
Il y a aussi un jeton que nous n’avons pas pu récupérer. Le cinquième jeton binaire, B-163, ne correspond à rien de ce que Claude a essayé et reste inexplicable. Enfin, nous ne savons pas comment les points de base pour P-224, P-256, P-384 et P-521 ont été générés. Il en va de même pour les courbes binaires NIST.
La récompense
Les 36 864 dollars destinés à la recherche des graines seront donnés à la Groupe de recherche en sécurité d’Internet.
Qui sommes-nous
Cette étude a été menée par Anthropic par John Wood, Henry de Valence, Ava Howell, Zack Voase, Lucy Sweet, Amir Omidi, Paul Crowley, Iain McGinniss, Nicholas Carlini et Steve Weis.
Remerciements
Nous aimerions reconnaître posthumement Jerry Solinas, qui a pris avec bonne humeur l’étiquette de « meme malveillant sur Internet » et de « Yo La Tengo des bogeymen de l’NSA ». Merci également à Filippo Valsorda pour avoir organisé le NIST Elliptic Curves Seeds Bounty.
Code pour reproduire les graines
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""                      # the state srand48(t) sets
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48              # one step of lrand48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

PRIME = {  # srand48(time); 20 bytes per candidate: lrand48() >> 23
    "prime239v1": ("1997-05-15 15:49:03", 2185),
    "prime239v2": ("1997-05-15 15:49:03", 2320),
    "prime239v3": ("1997-05-15 15:49:03", 3048),
    "P-192":      ("1997-05-18 14:45:34", 139),
    "prime192v3": ("1997-05-18 14:45:34", 5228),
    "prime192v2": ("1997-05-18 14:45:34", 6013),
    "P-521":      ("1997-08-08 01:12:04", 1136),
    "P-256":      ("1997-08-16 01:52:34", 1842),
    "P-384":      ("1997-08-30 14:50:08", 2688),
    "P-224":      ("1998-04-03 12:52:07", 7026),
}
BINARY = {  # srand48(time / 2), if that reading is right; 5 words per candidate: lrand48()
    "B-233": ("1998-04-17 15:24:18", 155),
    "B-283": ("1998-04-17 15:27:44", 32),
    "B-409": ("1998-04-17 15:30:18", 60),
    "B-571": ("1998-04-17 15:32:08", 73),
}
for name, (when, n) in PRIME.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when), n, 20, 40, 2)}")
for name, (when, n) in BINARY.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when) // 2, n, 5, 17, 8)}")
Le résultat de ce code :
prime239v1 1997-05-15 15:49:03  2185 E43BB460F0B80CC0C0B075798E948060F8321B7D
prime239v2 1997-05-15 15:49:03  2320 E8B4011604095303CA3B8099982BE09FCB9AE616
prime239v3 1997-05-15 15:49:03  3048 7D7374168FFE3471B60A857686A19475D3BFA2FF
P-192      1997-05-18 14:45:34   139 3045AE6FC8422F64ED579528D38120EAE12196D5
prime192v3 1997-05-18 14:45:34  5228 C469684435DEB378C4B65CA9591E2A5763059A2E
prime192v2 1997-05-18 14:45:34  6013 31A92EE2029FD10D901B113E990710F0D21AC6B6
P-521      1997-08-08 01:12:04  1136 D09E8800291CB85396CC6717393284AAA0DA64BA
P-256      1997-08-16 01:52:34  1842 C49D360886E704936A6678E1139D26B7819F7E90
P-384      1997-08-30 14:50:08  2688 A335926AA319A27A1D00896A6773A4827ACDAC73
P-224      1998-04-03 12:52:07  7026 BD71344799D5C7FCDC45B59FA3B9AB8F6A948BC5
B-233      1998-04-17 15:24:18   155 74D59FF07F6B413D0EA14B344B20A2DB049B50C3
B-283      1998-04-17 15:27:44    32 77E2B07370EB0F832A6DD5B62DFC88CD06BB84BE
B-409      1998-04-17 15:30:18    60 4099B5A457F9D69F79213D094C4BCD4D4262210B
B-571      1998-04-17 15:32:08    73 2AA058F73A0E33AB486B0F610410C53A7F132310
Code pour reproduire les points de base sélectionnés
M, A = 2**107 - 1, pow(3, 121, 2**107 - 1)       # zrandom: state = state * 3^121 mod (2^107 - 1)
P192 = 2**192 - 2**64 - 1
P239 = 2**239 - 2**143 - 2**95 + 2**47 - 1

CURVES = [  # name, LIP seed, p, b, published Gx   (a = -3 throughout)
    ("prime192v1", 20000, P192,
     0x64210519e59c80e70fa7e9ab72243049feb8deecc146b9b1,
     0x188da80eb03090f67cbf20eb43a18800f4ff0afd82ff1012),
    ("prime239v1", 20420, P239,
     0x6b016c3bdcf18941d0d654921475ca71a9db2fb27d1d37796185c2942c0a,
     0xffa963cdca8816ccc33b8642bedf905c3d358573d3f27fbbd3b3cb9aaaf),
    ("prime239v2", 20507, P239,
     0x617fab6832576cbbfed50d99f0249c3fee58b94ba0038c7ae84c8c832f2c,
     0x38af09d98727705120c921bb5e9e26296a3cdcf2f35757a0eafd87b830e7),
    ("prime239v3", 20509, P239,
     0x255705fa2a306654b1f4cb03d6a750a30c250102d4988717d9ba15ab6d3e,
     0x6768ae8e18bb92cfcf005c949aa2c6d94853d0e660bbf854b1c9505fe95a),
    ("prime192v2", 20512, P192,
     0xcc22d6dfb95c6b25e49c0d6364a4e5980c393aa21668d953,
     0xeea2bae7e1497842f2de7769cfe9c989c072ad696f48034a),
    ("prime192v3", 20517, P192,
     0x22123dc2395a05caa7423daeccc94760a7d462256bd56916,
     0x7d29778100c65a1da1783716588dce2b8b4aee8e228f1896),
]

def base_point_x(seed, p, b):
    state = seed                         # zrstarts(seed)
    def limb():                          # zrandom(2^26): low 26 bits of the new state
        nonlocal state
        state = state * A % M
        return state % 2**26
    for _ in range(7):                   # seven single-limb draws come first
        limb()
    limbs = -(-p.bit_length() // 26) + 1 # zrandomb(p): limbs of p plus one, top limb first
    tries = 0
    while True:
        x = 0
        for _ in range(limbs):
            x = x << 26 | limb()
        x %= p
        tries += 1
        if pow(x**3 - 3*x + b, (p - 1) // 2, p) == 1:   # is x on the curve?
            return x, tries

for name, seed, p, b, gx in CURVES:
    x, tries = base_point_x(seed, p, b)
    print(f"{name:20} seed {seed}  tries {tries}  matches published Gx: {x == gx}")
Le résultat de ce code :
prime192v1           seed 20000  tries 2  matches published Gx: True
prime239v1           seed 20420  tries 3  matches published Gx: True
prime239v2           seed 20507  tries 2  matches published Gx: True
prime239v3           seed 20509  tries 1  matches published Gx: True
prime192v2           seed 20512  tries 5  matches published Gx: True
prime192v3           seed 20517  tries 1  matches published Gx: True
Licence
Dans la mesure possible, conformément à la loi, les auteurs ont renoncé à tous les droits d’auteur et aux droits connexes ou voisins relatifs au code présent sur cette page, en le mettant dans le domaine public sous CC0 1.0 Universal (https://creativecommons.org/publicdomain/zero/1.0/>).
Contenu lié
Concevoir des circuits quantiques plus efficaces avec Claude
Nous avons donné à Claude des spécifications en langue simple pour huit circuits quantiques, ainsi qu’un évaluateur automatisé pour vérifier et évaluer ses designs. Travaillant principalement seul, Claude a amélioré les meilleurs circuits publiés, parfois de l’ordre de magnitude ou plus, ce qui pourrait rapprocher les ordinateurs quantiques pratiques de ce qu’on avait prévu auparavant.
Lire plusLes modèles d’IA peuvent être capables de se reproduire eux-mêmes sans accès à un datacenter
Nos expériences indiquent que de petits modèles d’IA pourraient être capables de se reproduire automatiquement sur des dispositifs IoT commerciaux, tels que les téléviseurs Android et les fours intelligents, dans quelques mois à peine.
Lire plusRenforcer nos défenses contre les attaques de distillation
La distillation illégale permet aux développeurs de modèles de copier les capacités d’IA avancées sans mettre en place des mesures de protection robustes en proportion. Ici, nous décrivons comment nous avons réduit le taux de distillation de plus de 90 %.
Lire plusInscrivez-vous à la newsletter Frontier Red Team
Obtenez des mises à jour sur nos dernières recherches et découvertes en red-teaming.