
L'étoile polaire
Toute organisation qui se lance dans le déploiement d'agents d'IA affronte la même prise de conscience : un agent impressionnant en démonstration peut se dégrader discrètement en production, et au moment où un humain le remarque, la confiance est déjà rompue. Là où les logiciels traditionnels échouent bruyamment, les agents échouent en silence. Ils renvoient une réponse qui semble assurée, se lit avec fluidité, et est erronée. Lorsque cette réponse oriente une véritable décision commerciale, le coût n'est pas une fonctionnalité cassée. C'est une relation rompue avec l'utilisateur.
C'est là le cœur du problème de qualité. Le défi n'est donc pas de construire des agents qui fonctionnent une fois, mais de prouver qu'ils continuent de fonctionner, à l'échelle, à travers chaque sous-agent, chaque flux de travail et chaque version. Les équipes qui triompheront de l'ère des agents seront celles qui traiteront la qualité non pas comme une étape finale d'assurance qualité, mais comme le système d'exploitation de l'agent lui-même : mesurée en continu, défendue automatiquement et améliorée à chaque interaction. Dans cet article, nous montrons comment nous avons construit une boucle de qualité continue pour des solutions agentiques prêtes pour la production, à grande échelle, à l'aide d'Amazon Bedrock AgentCore.
Problème métier
La solution utilise Amazon Bedrock AgentCore et d'autres services AWS pour un usage interne, permettant ainsi aux vendeurs et aux responsables commerciaux de poser des questions métier en langage courant depuis Amazon Quick. Derrière cette expérience unique, plusieurs sous-agents spécialisés travaillent ensemble : le Performance Insights Agent pour les revenus et performances par territoire, le Customer Insights Agent pour l'intelligence client, le Data Insights Agent pour le text-to-SQL sur les jeux de données fondamentaux, et un accès direct aux tableaux de bord. Les réponses sont limitées au territoire de chaque utilisateur et à la sécurité au niveau du rôle. Les équipes de terrain utilisent ces réponses pour aider à planifier la stratégie des comptes et à préparer les réunions clients, de sorte que les chiffres doivent être exacts. La défaillance la plus dommageable n'est pas un plantage. C'est une réponse fluide et assurée qui est discrètement erronée. Avant le lancement, lorsque nous avons évalué le Customer Insights Agent, nous avons trouvé exactement cela :
- Il a rapporté 410,08 $ du revenu trimestriel d'un client sur un service comme « 410,08 Millions de dollars ».
- Il a rapporté le Chiffre d'affaires ventes étiqueté comme Chiffre d'affaires ventes hors ajustements.
- Il a proposé une estimation du revenu annuel récurrent qui n'apparaissait nulle part dans les données.
- Il a présenté ses propres calculs comme des faits sourcés.
Au fil des différentes exécutions, la surveillance est restée au vert. Elle nous indiquait que le système avait répondu, mais pas si la réponse était correcte.
Si ces erreurs avaient été livrées sans être détectées, le terrain en aurait payé le prix. Un vendeur qui répète un chiffre gonflé peut perdre sa crédibilité auprès du client. C'est précisément pourquoi nous l'avons détecté avant le lancement. Le risque ne s'arrête pas au lancement : il grandit avec chaque nouvel agent et chaque modification des données, des invites, du code ou des modèles. Il croît également sans aucune version publiée, car les pipelines amont actualisent les données chaque semaine. Les versions coordonnées introduisent un risque connexe : lorsqu'un changement de données, un changement d'outil et une mise à jour d'invite appariée sont censés être livrés ensemble mais arrivent séparément, le système fonctionne en incohérence jusqu'à ce que tous les changements se rattrapent. Lors d'un test de pré-production, cette fenêtre d'incohérence à elle seule a fait chuter le taux de réussite de 78 pour cent à 38 pour cent. Pour détecter de telles défaillances, avant chaque version et en continu en production, nous avons besoin d'un cadre capable de montrer si les réponses sont fondées et correctes, et de remonter chaque défaillance à sa cause première dans les données, l'invite ou le code de l'agent.
Chez AWS, l'équipe Sales, Marketing, and Global Services (SMGS) Operations a développé un système multi-agents de production au service des équipes AWS Field Sales dans le monde entier. Il sert deux publics distincts. Pour les équipes de vente de terrain, il remplace des heures d'analyse manuelle des données par une intelligence conversationnelle à la demande, aidant les vendeurs à comprendre la santé de leur activité, à faire remonter les risques et les opportunités, et à agir plus rapidement. Pour les dirigeants, il alimente les cadences de gestion d'entreprise, y compris les Weekly Business Reviews (WBR), en faisant remonter les signaux qui comptent à travers le portefeuille sans nécessiter de préparation manuelle de rapports. Le même système agentique sert à la fois le vendeur de première ligne et le dirigeant qui évalue les performances à grande échelle.
Le système agentique orchestre un portefeuille croissant de sous-agents spécialisés, chacun possédant un domaine de capacité distinct. Parmi eux : le Performance Insights Agent génère des narratifs d'intelligence d'affaires en langage naturel à partir de données de vente complexes, transformant les métriques brutes en informations exploitables pour les vendeurs. Le Customer Insights Agent assemble une vue à 360 degrés de chaque client en synthétisant les signaux provenant de l'utilisation des produits, de l'historique du support, du statut des contrats et des données d'engagement, aidant ainsi les vendeurs à comprendre où en est un client dans son parcours et ce dont il a besoin ensuite. Le Data Insights Agent est un agent text-to-SQL que les équipes de comptes utilisent pour interroger des données analytiques structurées en langage courant sans écrire une seule ligne de SQL. Ces trois agents sont ceux référencés dans le reste de cet article.
La coordination fiable de ces agents à grande échelle a rendu une chose évidente : la qualité agentique n'était pas une préoccupation opérationnelle à gérer plus tard. C'était le prérequis pour opérer. Un seul sous-agent dégradé peut corrompre silencieusement chaque réponse en aval, et la surveillance traditionnelle ne le détectera pas. Cette réalité a rendu un cadre d'évaluation complet du cycle de vie non pas optionnel mais nécessaire. AgentCore Evaluations, une capacité d'Amazon Bedrock AgentCore, est le tissu conjonctif qui l'alimente, aux côtés d'Amazon Bedrock Guardrails (sécurité), d'Amazon CloudWatch (métriques, alarmes, traçage), d'Amazon Simple Storage Service (Amazon S3) et d'Amazon Redshift (persistance des évaluations), d'Amazon Quick (tableaux de bord) et d'AWS Lambda (évaluateurs personnalisés).
Dans cet article, nous partageons comment nous avons relevé les défis opérationnels les plus difficiles dans l'exécution d'agents d'IA à l'échelle de l'entreprise, et comment Amazon Bedrock AgentCore Evaluations est devenu l'épine dorsale de la qualité des agents. Plus précisément, nous couvrons :
- Les agents jouent selon des règles différentes – Pourquoi les agents exigent une discipline opérationnelle différente, et pourquoi la surveillance traditionnelle (latence, taux d'erreur, disponibilité) vous laisse aveugle face aux défaillances qui comptent le plus.
- Une carte pour l'ensemble du parcours – Le cadre d'évaluation en neuf étapes que nous avons construit sur AgentCore Evaluations, couvrant chaque phase du cycle de vie du développement des agents, du premier commit à la production.
- De la théorie à la pratique – Des modèles concrets (gates de régression en intégration continue et livraison continue (CI/CD), notation canary, détection de dérive et boucles de rétroaction automatisées) et exactement comment AgentCore Evaluations alimente chacun d'eux.
- Des métriques qui comptent vraiment – L'impact mesurable sur la confiance de déploiement, la prévention des régressions et la vitesse d'itération sur l'ensemble de notre portefeuille d'agents.
Pourquoi les agents ont besoin d'un cadre d'évaluation structuré
Les logiciels traditionnels sont déterministes : la même entrée produit la même sortie. Les modèles de machine learning (ML) ont introduit des sorties probabilistes, et le MLOps est apparu pour gérer leur entraînement, leur versionnage, leur surveillance et leur réentraînement. Les agents d'IA ajoutent une troisième couche de complexité opérationnelle : le raisonnement autonome en plusieurs étapes, où la question passe de « est-ce que quelque chose s'est cassé ? » à « l'agent prend-il des décisions judicieuses sur l'ensemble de sa chaîne de raisonnement ? »
Les agents héritent des problèmes difficiles de leurs deux prédécesseurs et en introduisent de nouveaux. Ils sont non déterministes, suivant des chemins de raisonnement différents pour des entrées identiques. Ils prennent des décisions en cascade à travers le routage, la sélection d'outils et la synthèse, où une seule étape peut échouer silencieusement et corrompre tout ce qui est en aval. Plus critique encore, ils se dégradent silencieusement : la latence reste faible, les taux d'erreur restent stables, mais la qualité des réponses de l'agent s'érode, parce que l'agent continue de répondre. Il répond simplement de travers.
L'évaluation des agents est la pratique qui consiste à détecter exactement cela. Elle couvre cinq dimensions : la sécurité (se comporte-t-elle dans les limites définies ?), la qualité (l'agent produit-il des réponses correctes, cohérentes et ancrées ?), la performance (est-il assez rapide et fiable ?), le coût (fonctionne-t-il efficacement à grande échelle ?) et le contrôle opérationnel (pouvons-nous détecter, diagnostiquer et remédier rapidement aux problèmes ?). Une pratique d'évaluation mature traite ces cinq dimensions en continu, tout au long du cycle de vie complet de l'agent.
Dans cet article, nous partageons comment nous opérationnalisons les cinq dimensions d'évaluation dans un système multi-agents en production. La sûreté et la sécurité sont notre première priorité. Aucun agent n'est déployé, et aucun agent ne continue de fonctionner, s'il ne peut pas atteindre son seuil de sécurité. La qualité occupe la plus grande place dans cet article parce que c'est la plus difficile des cinq à maîtriser et celle qui bénéficie le plus d'un cadre dédié, mais elle ne prime pas sur la sûreté. La performance, le coût et le contrôle opérationnel sont intégrés à chaque étape du cycle de vie aux côtés des deux autres. De manière cruciale, ce cadre s'applique à chaque niveau de la hiérarchie des agents. Au niveau de l'outil, chaque capacité (un outil de désambiguïsation client, un outil de récupération de graphe) possède son propre contrat d'évaluation. Au niveau de l'agent, chaque sous-agent est évalué de bout en bout. Au niveau multi-agents, les chemins d'orchestration sont évalués pour leur cohérence, leur routage correct et l'exactitude de la synthèse à travers les frontières entre agents.
Les neuf étapes s'appliquent simultanément à trois niveaux, et cette hiérarchie n'est pas spécifique à ce produit. C'est le bon modèle mental lorsque nous construisons ou intégrons de nouveaux agents de production. La plupart des équipes commencent par évaluer au niveau de l'agent et s'arrêtent là. Mais la qualité au niveau de l'agent n'est aussi bonne que les outils sur lesquels elle s'appuie, et les systèmes multi-agents introduisent une troisième surface de défaillance qu'aucun de ces niveaux ne peut percevoir seul. Une pratique d'évaluation robuste couvre les trois, chaque niveau exécutant son propre jeu de référence (golden set), ses propres évaluateurs et ses propres critères de promotion à travers les neuf étapes.
Le cadre d'évaluation des agents : neuf étapes, une boucle fermée
Ces neuf étapes tracent le cycle de vie de l'agent, du premier commit à la production en direct, et chacune répond à une question à laquelle les équipes sont confrontées à mesure que leurs agents mûrissent.
Le cycle de vie de l'agent et les neuf questions courantes
Chaque équipe construisant des agents de production rencontre les questions suivantes à mesure que son agent mûrit :
Étape 1 : La Fondation : « À quoi ressemble la qualité ? »
Étape 2 : L'Expérience : « Quelle version est la meilleure ? »
Étape 3 : La Fusion (CI) : « Ai-je cassé quelque chose ? »
Étape 4 : Le Passage (CD) : « Est-il sûr pour la production ? »
Étape 5 : Le Canary : « Quelque chose s'est-il cassé silencieusement ? »
Étape 6 : L'Adversaire : « Et si quelqu'un essayait de le casser ? »
Étape 7 : La Dérive : « La qualité dérive-t-elle en production ? »
Étape 8 : Le Pouls : « Comment savons-nous que cela fonctionne en ce moment ? »
Étape 9 : La Boucle de Rétroaction : « Comment s'améliore-t-il automatiquement ? »
Nous construisons un cadre unique pour chaque étape du cycle de vie de l'agent en utilisant AgentCore Evaluations. Les neuf étapes ne sont pas des outils distincts assemblés après coup. Ce sont neuf points sur une seule et même surface d'évaluation continue, propulsée par AgentCore Evaluations du premier commit jusqu'à la réponse en production, comme illustré dans Figure 1.
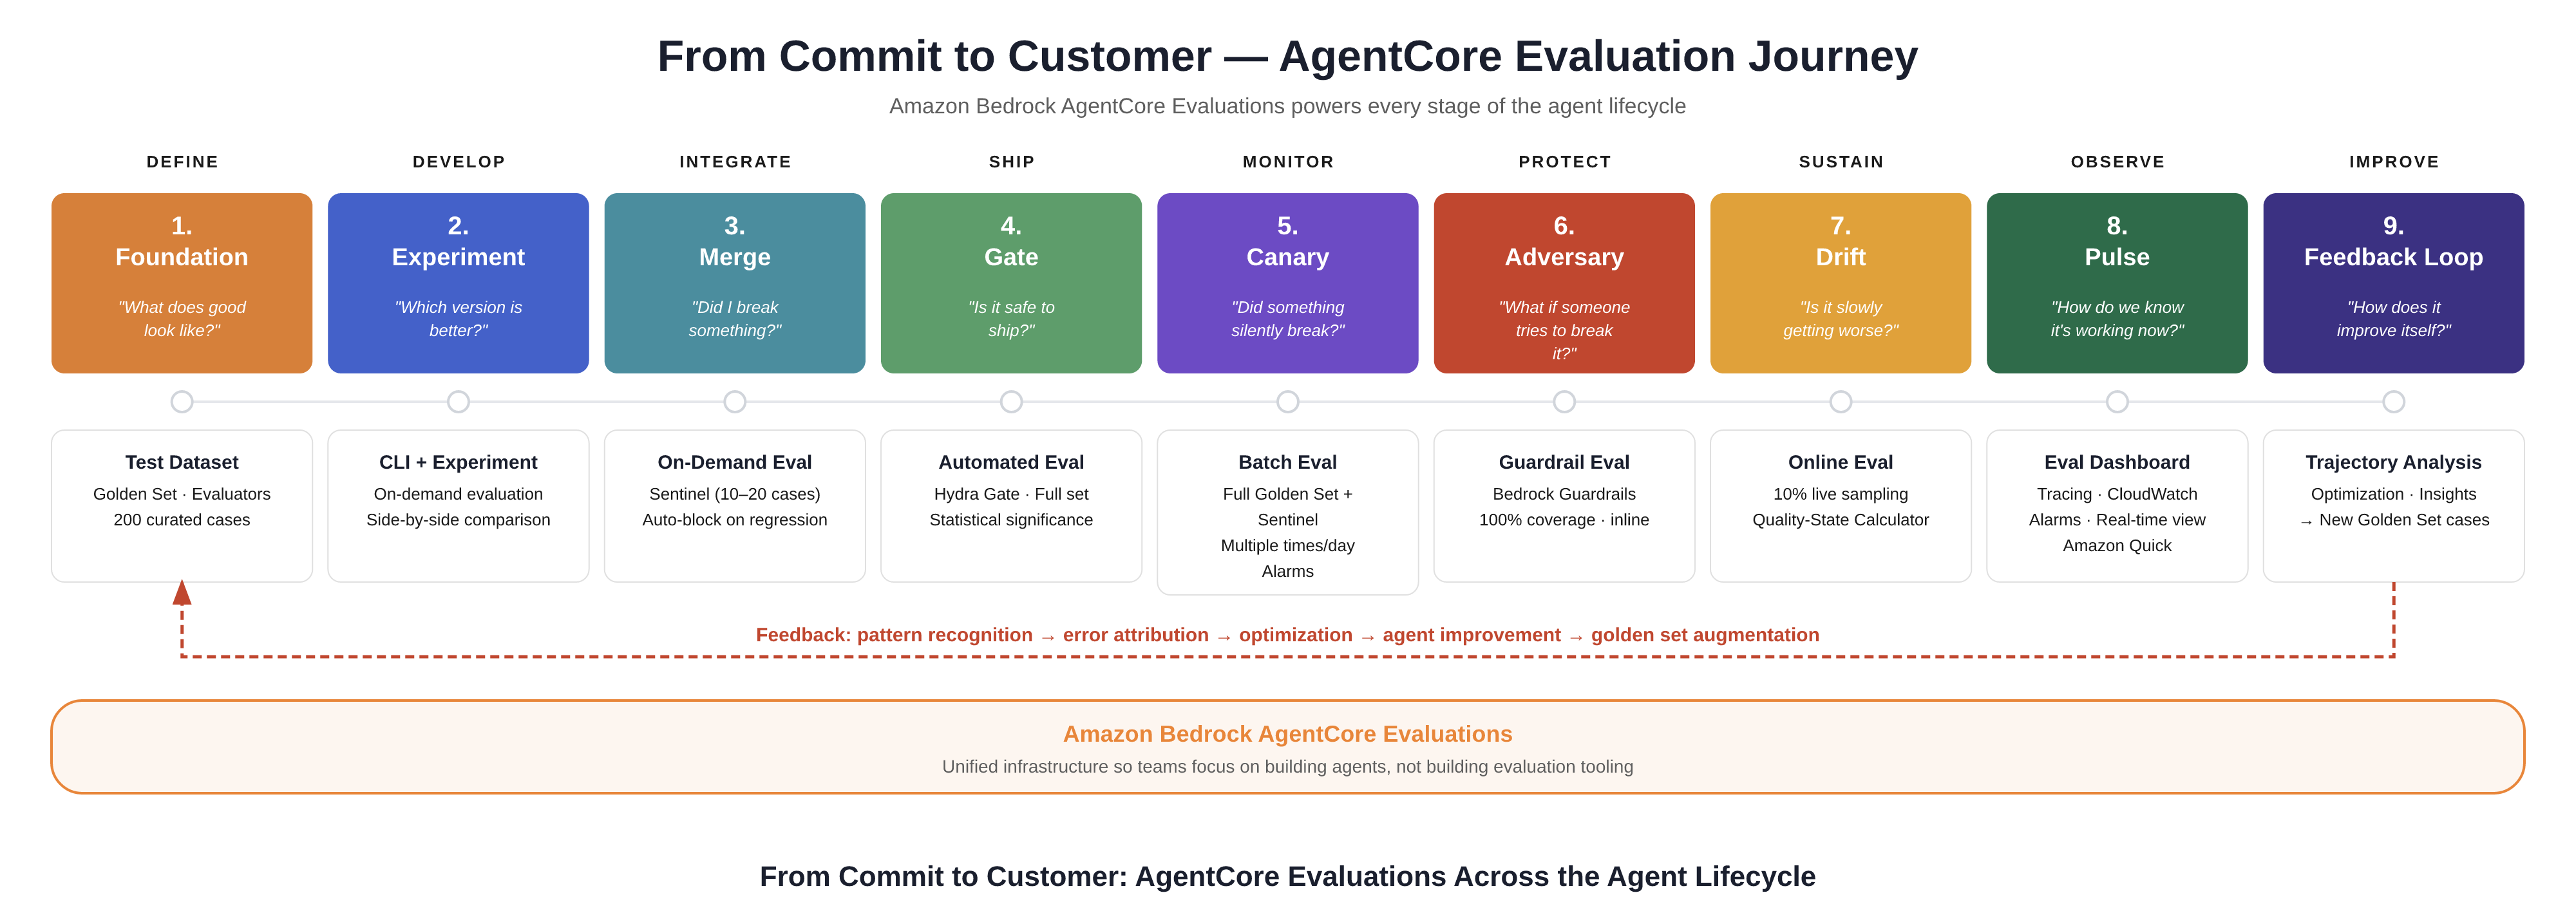
Figure 1 : Le parcours AgentCore Evaluations en neuf étapes, de Define à Improve
Voici comment nous abordons chacune d'elles : le schéma qui fonctionne, les services AgentCore qui le soutiennent, et ce à quoi cela ressemble en production, avec l'architecture système montrée dans la Figure 2.
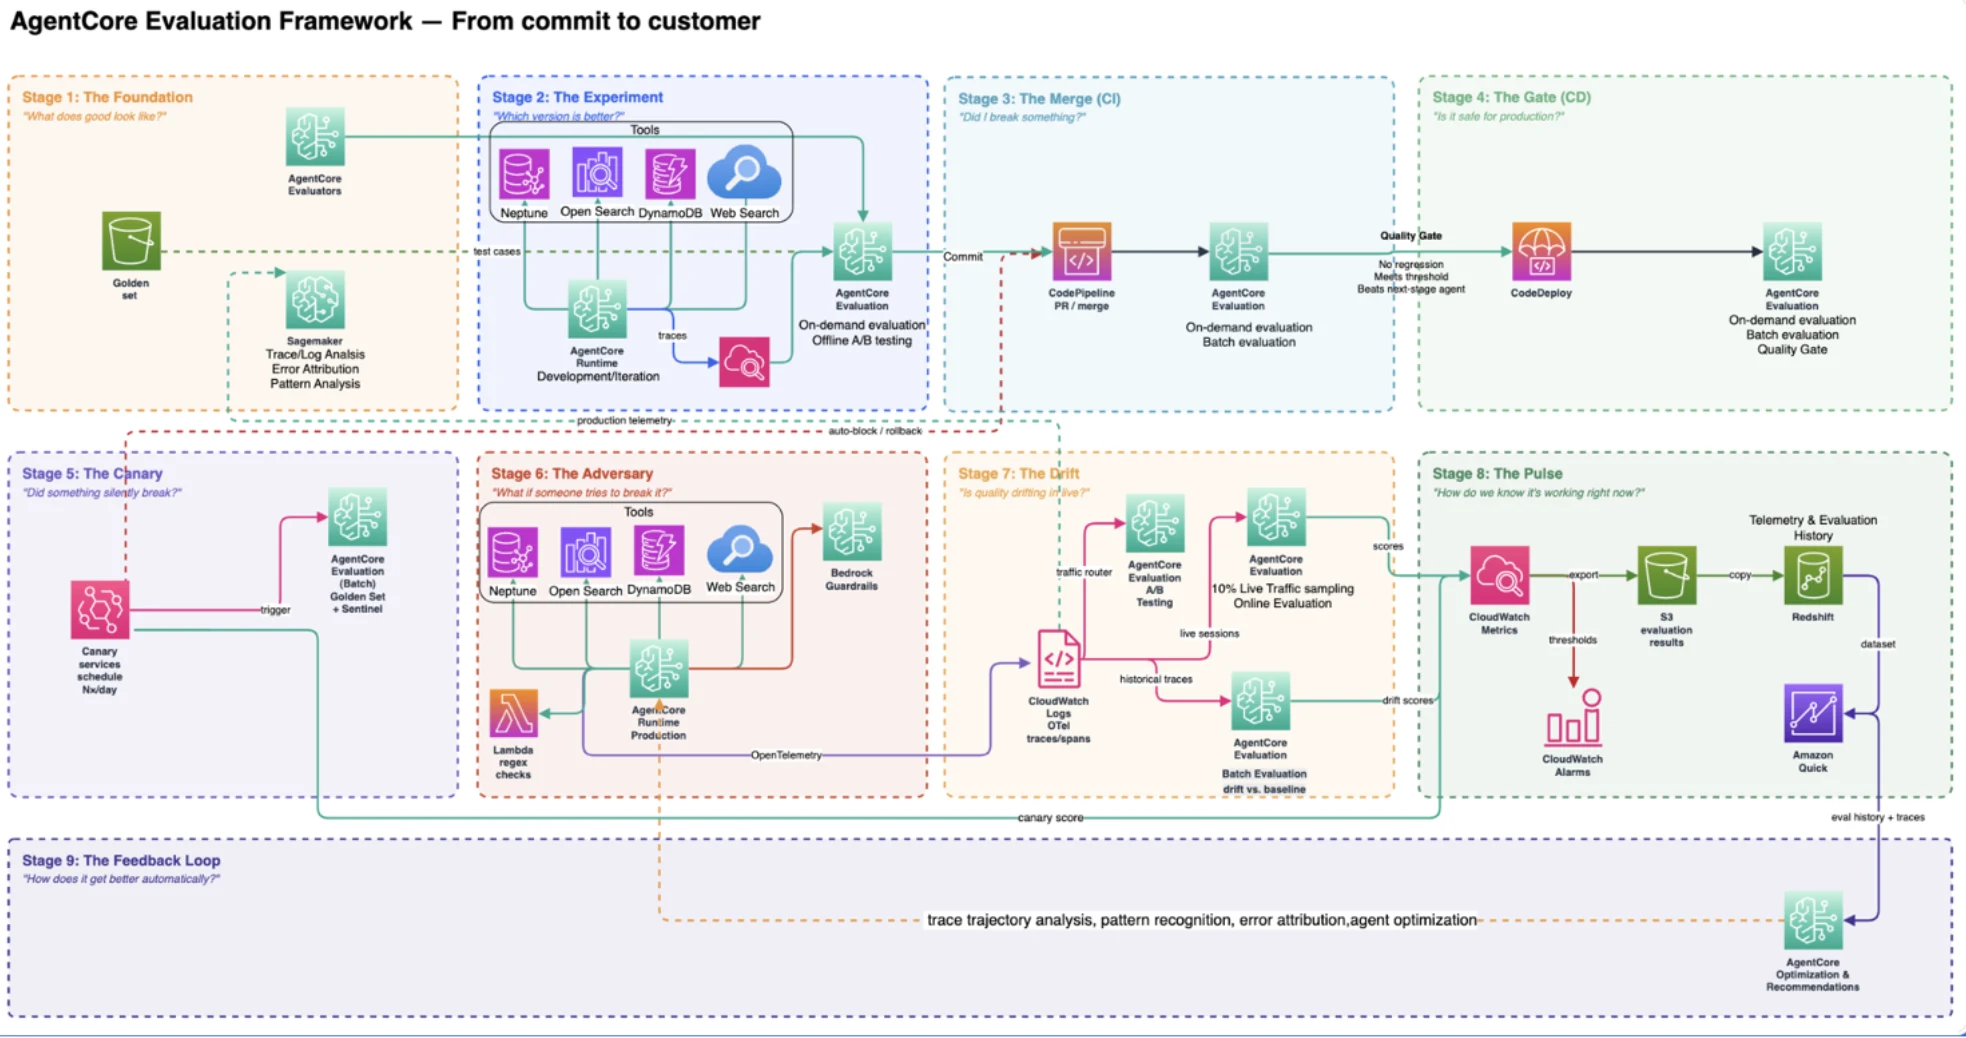
Figure 2 : Architecture système du cadre d'évaluation AgentCore
Étape 1 : La Fondation. Définir la qualité
La fondation de l'évaluation d'un agent ne consiste pas à choisir les bons outils. Elle consiste à poser la bonne question : à quoi ressemble le succès pour cet agent, et comment savons-nous qu'il échoue ? La réponse doit venir du client, pas du modèle. Il s'agit d'un processus itératif. Notre définition du succès s'est affinée à mesure que nous observions ce que l'agent fait réellement en production. Tout ce qui est défini ici (seuils d'échec, pile d'évaluateurs, jeu de référence, règles de sécurité, budgets de latence et objectifs de coûts) constitue le contrat que chaque étape suivante fait respecter. Si l'Étape 1 est vague, chaque barrière aval n'est que conjecture.
Étape 1.1 : Définissez d'abord vos indicateurs métier. Commencez par demander ce que l'agent existe pour délivrer. Les deux personas d'utilisateurs finaux définissent le succès différemment :
- Pour les vendeurs, le succès signifie entrer dans une conversation client avec une intelligence précise et actuelle, au bon niveau de détail et au bon moment.
- Pour la direction, le succès signifie des contributions fiables aux revues hebdomadaires et inter-métiers sans longue préparation manuelle. Ce sont des résultats métier, pas des propriétés de modèle.
Étape 1.2 : Traduisez ces indicateurs métier en métriques d'évaluation. Pour chaque résultat, identifiez le signal qui confirme que l'agent l'a délivré. Chaque signal devient une métrique suivie avec un seuil explicite et une condition d'alarme. L'intelligence de compte précise correspond à la précision de résolution d'entités et au taux d'ancrage (grounding rate). La confiance des vendeurs correspond à la fidélité et au taux d'hallucination. L'action des vendeurs correspond à l'utilité et au respect du périmètre. La fiabilité des revues de direction correspond au taux de réussite en précision et à la couverture des réponses. Cette traduction doit couvrir cinq dimensions : en plus des seuils de qualité, définissez des politiques de garde-fous de sécurité, fixez des objectifs de latence p50, p90 et p99 par outil et par agent, établissez des budgets de coût par requête, et définissez les accords de niveau de service (SLA) qui déterminent quand une alarme se déclenche et quel runbook elle active.
Pour la précision spécifiquement, comme la solution informe directement les décisions de revenus, les stratégies de renouvellement et les revues de direction, la barre est haute. Une réponse fausse mais énoncée avec assurance ne fait pas seulement perdre du temps à un vendeur. Elle conduit à une mauvaise décision dans un vrai moment d'affaires. Nous définissons six types d'échec dérivés d'erreurs réelles de production, dont un seul suffit à marquer une réponse comme inexacte :
- Permutation de métrique : bon client et bonne période, mauvaise métrique retournée. Suivi en occurrences pour 100 réponses.
- Mauvaise période : des données d'une fenêtre temporelle sont étiquetées comme une autre, par exemple un chiffre d'une année sur l'autre (YoY) présenté au vendeur comme un chiffre d'un mois sur l'autre (MoM), ou l'inverse. Suivi en % citant la bonne fenêtre.
- Mauvaise entité : noms de comptes ou filiales confondus. Suivi en % de précision de résolution d'entités.
- Pure hallucination : chiffres non fondés sans source traçable. Suivi en % de taux d'ancrage (grounding rate).
- Mauvais symboles : bonne métrique, mauvais symbole de devise ou d'unité. Suivi en % de taux de respect du périmètre.
- Calcul non autorisé : chiffres dérivés non sanctionnés absents des données sources. Suivi en occurrences pour 100 réponses.
Le taux de réussite global en précision est la métrique phare. Le suivi par dimension est ce qui la rend exploitable. Au-delà de la précision, nous suivons également Pertinence de la réponse, Fidélité, Utilité, Suivi des instructions,Précision de la sélection d'outils. Une réponse correcte enfouie dans trois paragraphes, ou arrivant trop tard, a elle aussi échoué du point de vue du vendeur.
Étape 1.3 : Construire une pile d'évaluation qui reflète ces métriques. Aucun type d'évaluateur unique ne couvre les différents modes de défaillance possibles. Nous combinons quatre types :
- les évaluateurs intégrés d'AgentCore pour une couverture de référence large. La pertinence, la fidélité et l'utilité correspondent directement aux modèles d'évaluation disponibles nativement dans AgentCore Evaluations.
- Évaluateurs personnalisés, un par type de défaillance dans notre taxonomie : un évaluateur de permutation de métriques, un évaluateur de mauvaise période, un évaluateur de mauvais client, un évaluateur de pure hallucination, un évaluateur de mauvais symboles et un évaluateur de calcul non autorisé. Aucun des six n’est couvert par les modèles natifs. Ce sont des signaux spécifiques au domaine que nous avons construits au-dessus du framework AgentCore. Savoir à l’avance quelles métriques un modèle natif couvre déjà, et lesquelles nécessitent un évaluateur personnalisé, fait lui-même partie de la décision de conception.
- Évaluateurs tiers, nous avons déployé les évaluateurs gérés issus des bibliothèques open source tierces DeepEval et AutoEval.
- Évaluateurs déterministes pour les vérifications de vérité terrain lorsque la réponse correcte est connue exactement, comme le chiffre d’affaires, la date de renouvellement et le statut du contrat.
Là où la qualité du raisonnement et l’utilité n’ont pas de réponse unique correcte, nous utilisons plutôt des grilles LLM-as-judge, avec des grilles intégrées pour la pertinence, la fidélité et l’utilité, ainsi que la prise en charge de grilles entièrement personnalisées. AgentCore Evaluations fournit nativement à la fois l’évaluation par vérité terrain et le LLM-as-judge, ce qui nous a permis de mettre en place les deux voies d’évaluation sans construire nous-mêmes de moteur de notation. Le déterministe apporte la précision sur les faits. Le LLM-as-judge apporte l’étendue sur le raisonnement.
Étape 1.4 : Construire un ensemble de référence (golden set) pour exercer vos métriques d’évaluation. Au niveau de l’ outil, chaque outil critique possède ses propres paires déterministes de vérité terrain : l’identification du client doit résoudre vers l’entité canonique exacte ou échouer. Au niveau de l’ agent, l’analyse des sujets sur des requêtes réelles d’utilisateurs produit un jeu de données couvrant quatre types de questions (exhaustives, de reporting, de raisonnement et ambiguës), chacun nécessitant une stratégie d’évaluation différente, revue mensuellement. Au niveau multi-agents, les scénarios d’orchestration de bout en bout détectent les erreurs qui n’apparaissent que lorsque les agents interagissent. L’ensemble de référence n’est pas seulement un jeu de données de qualité. Il inclut également des cas de test de sécurité, des cas de référence de latence et des cas de référence de coût, afin que les Étapes 3 et 4 puissent vérifier cinq dimensions sur le même jeu de données organisé.
L’ensemble de référence est un document vivant, construit à partir de trois sources. Les cas issus de la production sont échantillonnés à partir de requêtes réelles de vendeurs et de dirigeants, y compris les sessions en direct à faible score promues à l’Étape 7. Les cas issus des défaillances proviennent de chaque régression détectée en staging ou en production, y compris les cas sentinelles promus à l’Étape 3 et les gardes de régression permanents promus à l’Étape 9. Les cas limites synthétiques sont délibérément construits pour garantir la couverture de scénarios dont nous savons qu’ils comptent mais que nous ne pouvons pas attendre de rencontrer dans la nature, comme les quatre types de questions ci-dessus et les cas de désambiguïsation société mère-filiale et de symbole boursier de l’Étape 4. L’ensemble est géré en version, revu et continuellement étendu à partir des trois sources.
Étape 2 : L’Expérience. Savoir quelle version gagne
Chaque changement (une mise à jour de prompt, un nouvel outil, une montée de version du modèle, un rafraîchissement de jeu de données) soulève la même question : cette version est-elle réellement meilleure ? Dans un système servant le terrain AWS à l’échelle mondiale, l’intuition n’est pas une réponse acceptable.
Avant la fusion d’un changement, nous exécutons une évaluation On-Demand d’AgentCore, notée sur le même ensemble de référence avec la même suite d’évaluateurs. L’équipe de développement utilise les métriques de qualité, de latence, de coût et les jetons de contexte pour organiser les comparaisons en aval, évaluées simultanément sur cinq dimensions, comme présenté côte à côte dans la Figure 3. Un modèle qui améliore la précision de 5 pour cent mais double la latence et triple le coût ne gagne pas automatiquement.
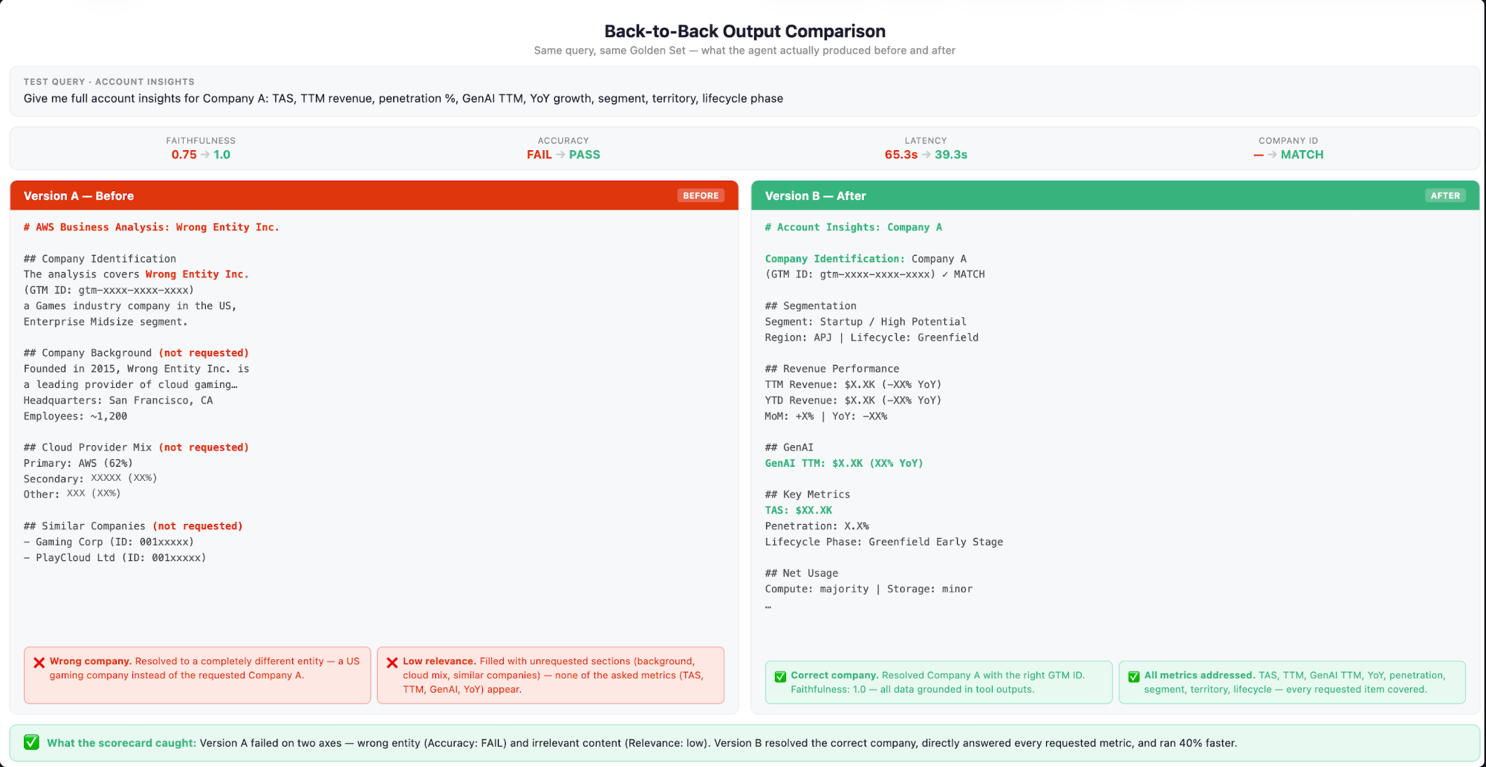
Figure 3 : Comparaison côte à côte de deux réponses candidates d’agent dans une évaluation On-Demand d’AgentCore selon la qualité, la latence et le coût. Les chiffres et valeurs de la figure sont illustratifs.
Nous suivons la qualité comme un tableau de bord complet, pas comme un chiffre unique. Un simple taux de réussite ne vous en dit pas assez. Chaque exécution d’évaluation produit une décomposition complète pour chaque catégorie de défaillance de notre taxonomie : non seulement si la qualité s’est améliorée, mais où et pourquoi, comme le reflète le tableau de bord de la Figure 4. Chaque évaluation est également entièrement enregistrée : les entrées, les sorties, le contexte récupéré, les scores et les motifs d’évaluation sont stockés dans S3 et notre lac de données, nous offrant une couche d’observabilité persistante pour remonter une défaillance à sa cause racine : ce que l’agent a vu, ce qu’il a généré et pourquoi cela s’est mal passé. En trois mois d’itération ciblée, ce tableau de bord a fait passer le taux de réussite de 93 pour cent à un stable 96 pour cent : les pures hallucinations sont passées de 138 à moins de 52 pour 10,000 réponses, les calculs non autorisés sont tombés de 59 à moins de 44, confirmant que la récupération était saine et que les gains provenaient de corrections en génération. Sans la décomposition par catégorie et les données de trace détaillées qui la sous-tendent, nous aurions itéré à l’aveugle.
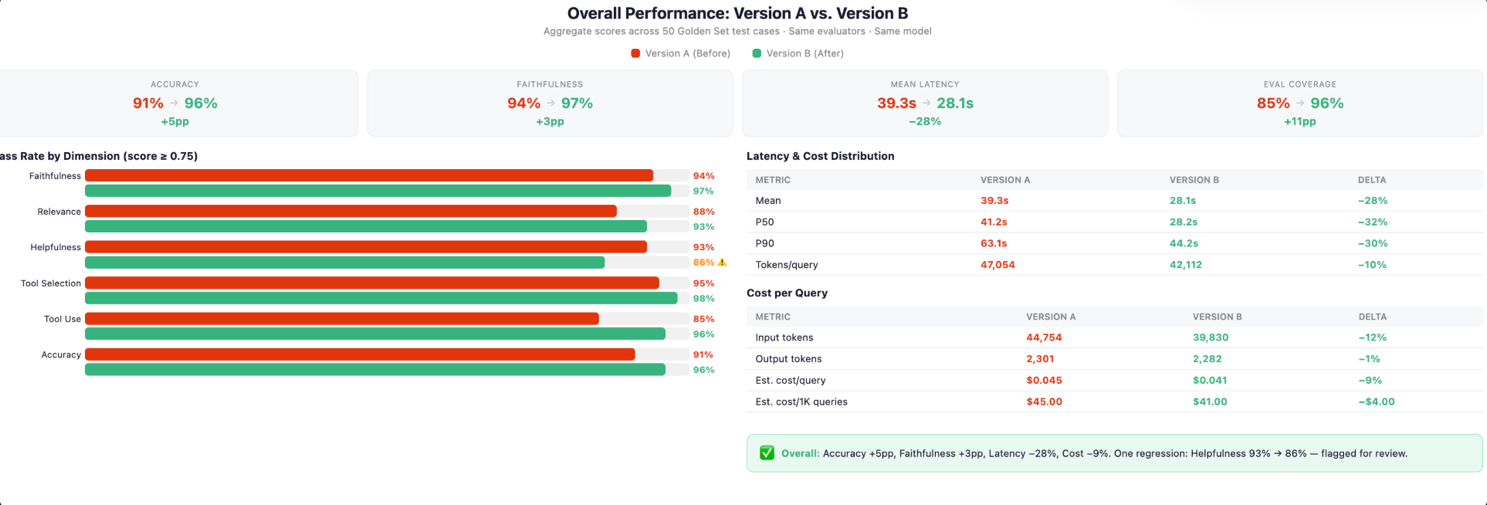
Figure 4 : Tableau de bord d’évaluation avec décomposition des défaillances par catégorie et tendance du taux de réussite. Les chiffres et valeurs de la figure sont illustratifs.
Étape 3 : La Fusion (CI). Prévenir la régression au moment de la fusion
L’Étape 3 est un garde-fou de pré-production. Elle s’exécute dans l’environnement de staging, déclenchée par des changements de code et de configuration, et son rôle est de bloquer un mauvais changement avant qu’il n’atteigne jamais la production. Si l’Étape 3 détecte une régression, rien n’est livré.
Les ingénieurs ou les scientifiques modifient le système de nombreuses manières : le prompt, les données sous-jacentes, les outils ou le modèle. Le changement semble propre localement, les tests passent, mais un prompt qui améliore les réponses pour les comptes du secteur technologique pourrait dégrader silencieusement les réponses pour les comptes des services financiers. Sans un garde-fou automatisé, cela part en production.
Notre évaluation CI est déclenchée automatiquement à chaque déploiement en staging grâce à AgentCore On-Demand Evaluation. Les ingénieurs n'ont pas besoin de penser à lancer une évaluation. Aucun déploiement ne peut passer silencieusement outre la barrière. L'exécution se termine en quelques minutes parce qu'elle n'évalue que l'ensemble sentinelle, et non l'ensemble doré complet. La rapidité est volontaire : la sentinelle est suffisamment restreinte pour s'exécuter à chaque déploiement, mais suffisamment représentative pour détecter les défaillances les plus importantes.
L'ensemble sentinelle est une sélection rigoureuse des scénarios les plus à risque selon cinq dimensions. Une régression de qualité au-delà de la tolérance bloque le déploiement. Une violation de limite de sécurité bloque tout aussi fermement. Une modification qui double la latence p90 n'avance pas sans une décision délibérée. Les pics de coût en tokens sont signalés avant de s'amplifier à grande échelle. Chaque exécution sentinelle publie ses scores dans CloudWatch sous forme de métriques personnalisées : les scores de qualité, la latence, le coût par requête et le taux de réussite en matière de sécurité sont tous émis après chaque exécution, et des alarmes CloudWatch sont configurées pour se déclencher si une métrique dépasse son seuil de la Stage 1. Chaque exécution est également consignée et stockée, alimentant la piste d'audit sur laquelle s'appuient la Stage 8 et la Stage 9. Nous maintenons une sentinelle distincte à chaque niveau : outil, agent et multi-agent. Une modification qui améliore la qualité au niveau de l'agent mais dégrade un outil critique bloque quand même. La sentinelle est révisée chaque mois, et une régression qui passe en production est immédiatement promue en cas permanent afin qu'elle n'atteigne pas les utilisateurs deux fois.
Un exemple de ce que cela permet de détecter. Après une mise à jour de normalisation des données, un outil de désambiguïsation a commencé à renvoyer des entités non résolues pour un sous-ensemble de formats de noms de comptes. L'agent, recevant une entité non résolue, a répondu avec une correspondance au mieux, renvoyant des données réelles pour le mauvais client. Notre sentinelle au niveau de l'outil inclut exactement cette classe de cas limites : le contrôle de la vérité terrain sur la résolution d'entités a échoué pour les formats de noms de comptes concernés, et le déploiement a été bloqué automatiquement. La modification n'est jamais parvenue en production.
Stage 4 : La barrière (CD). Livrer avec une confiance quantitative
La sentinelle couvre 15 cas. La production couvre des dizaines de milliers de modèles de requêtes à travers des centaines de types de comptes, de zones géographiques et de segments de vendeurs. Passer la sentinelle est nécessaire. Ce n'est pas suffisant.
Avant qu'un candidat ne soit livré, nous exécutons une AgentCore On-Demand Evaluation sur l'ensemble doré complet selon les dimensions de l'évaluateur. Nous appelons cela la Quality Gate. Elle remplace « ça semble correct » par une décision de livraison quantitative.
Exécution en bac à sable et simulation d'outils. Pensez-y comme à une relecture, pas à un appel en direct. À l'avance, nous figeons un jeu de données connu et versionné du comportement correct des outils. Chaque appel d'outil effectué par le candidat pendant la barrière est intercepté et répondu à partir de ce jeu de données figé plutôt que d'un système réel. Nous construisons ce jeu de données figé en deux étapes. D'abord, nous testons chaque outil isolément : nous lui envoyons un ensemble d'entrées réservé issu de notre ensemble doré dont la réponse correcte est déjà connue, et nous comparons ce qu'il renvoie réellement à cette réponse connue. Cela nous indique si l'outil lui-même fonctionne (résolution d'entités, récupération, génération SQL) avant même que l'agent n'entre en jeu. Ensuite, une fois les réponses d'un outil confirmées comme correctes, nous figeons ces mêmes réponses validées dans le jeu de relecture que l'agent voit pendant l'évaluation de la barrière. Cela signifie que l'agent est testé purement sur son propre raisonnement, et non sur la vitesse ou la disponibilité des outils en direct, et comme chaque candidat relit le même jeu de données figé, toute différence de score en confrontation porte sur l'agent, et non sur la variance des outils.
Scoration agrégée de bout en bout. La barrière exécute également une passe holistique : l'agent candidat complet répond à 200 questions réservées de bout en bout, évalué par une grille LLM-as-judge selon toutes les dimensions de l'évaluateur. L'une des trois conditions suivantes ferme automatiquement la barrière : le score agrégé régresse par rapport à la propre exécution précédente du candidat, il échoue à battre la ligne de base de production actuelle, ou plus d'un pourcentage défini des 200 questions tombe en dessous du seuil par question. Un candidat doit franchir les trois, ce qui détecte ce qu'une simple moyenne peut masquer : un modèle qui améliore la moyenne tout en échouant silencieusement sur une part plus importante des questions individuelles ne passe pas.
Un exemple de ce que cela permet de détecter. C'est là que la simulation teste le raisonnement propre de l'agent, et pas seulement les outils qui le sous-tendent. Notre ensemble doré comprend un cas de discordance de hiérarchie : le Customer Insights Agent et le Data Insights Agent renvoient des chiffres de revenus différents mais individuellement corrects pour le même client, l'un limité au compte parent, l'autre à une filiale. Aucun des deux chiffres n'est faux. Le cas teste si l'agent déduit la bonne portée à partir de la sémantique de la requête et du persona du demandeur (un vendeur souhaite probablement la filiale, tandis qu'une requête de la direction vise probablement le cumul du parent), plutôt que de prendre une valeur par défaut, de faire une moyenne ou de demander au vendeur de désambiguïser. Le candidat a échoué, renvoyant le chiffre au niveau parent pour une question limitée à la filiale. La vérité terrain de l'ensemble doré pour ce cas précise quelle portée la question attend, de sorte que la Quality Gate a signalé immédiatement la discordance : pas un chiffre faux, mais le bon chiffre pour la mauvaise portée.
Stage 5 : Le canari. Détecter les défaillances silencieuses après le déploiement
La Stage 5 est un moniteur post-production. Elle s'exécute en continu dans l'environnement de production sur le trafic réel et des cas d'évaluation synthétiques, et sa mission est de détecter les problèmes qu'aucune modification de code n'a déclenchés et que la Stage 3 n'a donc pas vus. La Stage 3 protège contre ce que les ingénieurs modifient. La Stage 5 protège contre tout le reste, comme les décalages de données en amont, l'évolution du comportement des modèles, les changements dans les dépendances tierces, ou d'autres conditions telles qu'une latence accrue ou des modèles de trafic changeants qui ne se manifestent que sous une charge réelle.
Le produit opère sur un patrimoine de données alimenté par des milliers de schémas et de pipelines de données en amont. Un jour donné, des dizaines de ces pipelines se rafraîchissent sans déclencher de déploiement ni de porte CI. Le code de l'agent est inchangé, le modèle est inchangé, mais les données sur lesquelles il raisonne ont changé, et la qualité peut se dégrader silencieusement en conséquence. Nous l'avons appris à nos dépens : un pipeline amont s'est rafraîchi avec un changement de schéma, l'agent s'est mis à citer des données de la mauvaise fenêtre temporelle, et le premier signal est arrivé par une demande d'un vendeur plutôt que par une alerte automatisée. La Stage 5 est la façon dont nous détectons cela dans la première fenêtre d'évaluation de 30 minutes.
Nous exécutons AgentCore Batch Evaluation selon deux calendriers complémentaires, et le choix de la cadence était délibéré.
Nous nous sommes arrêtés sur des cycles de 30 minutes après avoir appris dans les deux sens : 15 minutes généraient trop de fausses alertes ; 60 minutes laissaient passer deux heures avant qu'une dégradation réelle soit enregistrée. Nous appelons chaque cycle de 30 minutes une fenêtre d'évaluation. Trente minutes détectent une tendance réelle en 90 minutes (trois fenêtres consécutives) tout en filtrant le bruit des requêtes isolées. Chaque fenêtre évalue une sélection circulaire sur le jeu golden, offrant une couverture complète en 24 heures.
Les seuils sont délibérément inférieurs aux portes CI/CD. Un échec sur une seule fenêtre est un signal opérationnel, pas un incident. Nous ne paginons l'oncall qu'après trois fenêtres consécutives dépassant le seuil. Nous avons appris cette règle à nos dépens : le premier mois où nous avons utilisé un seuil à fenêtre unique, l'oncall a carrément cessé de faire confiance au système. Une fois par jour, le jeu golden complet s'exécute aux seuils de porte comme bilan quotidien faisant autorité. Les fenêtres de 30 minutes font émerger la tendance. L'exécution quotidienne la confirme et crée un ticket.
Chaque exécution publie dans CloudWatch (précision, taux d'hallucination, taux d'ancrage, latence et coût), avec une logique d'alarme qui distingue les deux cadences. Le canary s'exécute à trois niveaux : les scores au niveau des outils révèlent un outil de récupération dégradé avant qu'il ne corrompe les réponses au niveau de l'agent.
Un autre exemple de ce que cela permet de détecter. Après un rafraîchissement d'index en amont, un outil de récupération a commencé à renvoyer des fragments vaguement pertinents au lieu du contexte précis nécessaire pour répondre à la requête. La latence était nominale. Le taux d'erreur était nul. L'agent continuait de produire des réponses fluides et assurées en raisonnant sur un contexte faiblement ancré, produisant des réponses qui semblaient correctes mais citaient les mauvais chiffres. Aucune alarme d'infrastructure ne s'est déclenchée. Le canary l'a détecté dans la première fenêtre de 30 minutes : le taux d'ancrage et la précision de récupération ont chuté sur le sentinelle au niveau de l'outil, déclenchant une alarme CloudWatch avant que les vendeurs n'agissent sur les réponses dégradées. Le faible score de l'évaluateur a signalé la trace exacte responsable. À partir de là, l'ingénieur d'astreinte a ouvert cette trace dans AgentCore et a remonté le contexte dégradé jusqu'à l'outil de récupération en quelques minutes.
Stage 6 : L'Adversaire. Se protéger contre les usages abusifs
Toute mauvaise sortie ne provient pas d'un modèle dégradé. Les requêtes conçues pour extraire des données de compte non autorisées, et les injections de prompt dissimulées dans les documents récupérés, sont des schémas prévisibles dans un système servant des milliers d'utilisateurs sur des données commerciales sensibles.
La sécurité n'est pas une étape. Elle traverse les neuf étapes. Nous appliquons Amazon Bedrock Guardrails à deux points de chaque interaction. En entrée, nous validons la portée de la requête et filtrons les injections de prompt. En sortie, nous vérifions qu'aucune donnée sensible n'est exposée à des utilisateurs non autorisés et que l'agent n'a pas été manipulé pour violer une politique. Ces contrôles s'exécutent sur 100 pour cent du trafic, de manière synchrone, avant qu'une réponse n'atteigne l'utilisateur.
Nous configurons deux couches de guardrails, chacune couvrant une classe de menaces distincte :
Les filtres de contenu détectent et bloquent les contenus nuisibles ou inappropriés dans les entrées comme dans les sorties. Nous appliquons des filtres sur des catégories notamment VIOLENCE, HATE, SEXUAL, MISCONDUCT, et INSULTS. Une requête ou une réponse qui déclenche ces filtres est bloquée avant d'atteindre le vendeur ou d'être exposée à l'utilisateur.
Les filtres de sécurité de prompt protègent l'agent contre la manipulation adversariale sous une seule PROMPT_ATTACK catégorie de guardrail, couvrant trois sous-types : JAILBREAK (tentatives de contourner les instructions système de l'agent ou de franchir ses limites opérationnelles), PROMPT_INJECTION (instructions non voulues intégrées dans des documents récupérés, des sorties d'outils ou des requêtes utilisateur) et PROMPT_LEAKAGE (tentatives d'extraire le prompt système ou la configuration interne). Dans un système multi-agents qui utilise le Retrieval Augmented Generation (RAG), l'injection de prompt via le contenu récupéré est un risque réel. Un document non voulu dans les données de compte d'un vendeur pourrait tenter de rediriger le comportement de l'agent en plein raisonnement.
Les règles de sécurité sont définies à la Stage 1, vérifiées contre les régressions aux Stages 3 et 4, et appliquées en continu en production.
Stage 7 : La Dérive. Maintenir la qualité et valider avec le trafic réel
La qualité se dégrade de plusieurs directions : les données amont changent sans déclencher de déploiement, les modèles vieillissent, et les utilisateurs repoussent les limites avec des requêtes qu'aucun jeu golden n'anticipe pleinement. La Stage 7 le détecte avant les vendeurs, et valide les candidats contre le trafic réel des utilisateurs avant un déploiement complet.
Détection de dérive. À l'aide d'AgentCore Online Evaluation, nous échantillonnons 10 pour cent du trafic réel en continu via les différents évaluateurs définis à la Stage 1, de sorte que la dérive est immédiatement visible comme un écart par rapport aux lignes de base établies hors ligne. Les scores alimentent un Quality-State Calculator qui surveille la qualité, la latence et le coût dans la même fenêtre.
Un exemple concret de production. Notre golden set pour l'identification des clients a été construit à partir de cas limites synthétiques : variations de noms, recherches de filiales, abréviations. Il donnait de bons résultats hors ligne. Mais en trafic réel, les vendeurs interrogeaient avec des symboles boursiers (« qu'est-ce qui se passe avec AMZN ? »), des noms abrégés et des fautes de frappe que les cas synthétiques n'exerçaient pas. Le Quality-State Calculator a mis en évidence la dérive sur trois fenêtres consécutives de 30 minutes : 98 pour cent à 1:30 du matin, 81 pour cent à 2:00, 80 pour cent à 2:30. CloudWatch a pagé l'astreinte lorsque le seuil glissant a été franchi. L'ingénieur d'astreinte a interrogé l'agent : « Que s'est-il passé pour la précision de l'identification des clients entre 1 heure et 3 heures du matin ? » et a reçu un résumé de tendance désignant les recherches par symboles boursiers et les noms abrégés comme cause des défaillances. La trace de l'agent a rendu la cause racine immédiatement visible. La correction : enrichir le golden set avec les sessions réelles mal notées, et mettre à jour l'outil de désambiguïsation pour normaliser les formats d'entrée avant la résolution. La précision est revenue au niveau de référence au cycle d'évaluation suivant.
Le trafic réel alimente deux boucles d'amélioration continue : les sessions mal notées sont promues dans le golden set comme nouveaux cas limites, et les grappes de traces mal notées informent les révisions de prompts, les mises à jour d'outils et les ajustements de routage.
Tests A/B : Après qu'un candidat a franchi un quality gate, AgentCore Gateway, une capacité d'Amazon Bedrock AgentCore, route une part du trafic réel entre l'agent actuel et l'agent candidat. Le mode à la demande confirme l'absence de régression sur les cas connus. Le mode en ligne confirme qu'il résiste aux entrées de longue traîne et aux formulations inédites que seuls les vrais utilisateurs produisent. Un candidat doit gagner ou égaler sur toutes les dimensions des évaluateurs avant le déploiement complet.
Étape 8 : Le pouls. Visibilité de la qualité en temps réel
Un seul appel à l'agent peut toucher trois sous-agents, cinq outils et deux chemins de récupération. Lorsqu'une alarme qualité se déclenche, « quelque chose dans le pipeline de l'agent » n'est pas une procédure opérationnelle. L'étape 8 est le point où les signaux des étapes 5, 6 et 7 convergent vers une couche d'observabilité offrant une résolution suffisante pour agir.
AgentCore Observability, une capacité d'Amazon Bedrock AgentCore, en est le socle. Pour les agents hébergés sur le runtime AgentCore, une capacité d'Amazon Bedrock AgentCore, chaque exécution est instrumentée automatiquement via OpenTelemetry, émettant une télémétrie structurée pour chaque étape de raisonnement : outils appelés, ordre, entrées et sorties, latence et consommation de jetons, publiée directement dans CloudWatch sous forme de métriques et journaux personnalisés, une fois CloudWatch Transaction Search activé (une étape de configuration unique). Les scores des évaluateurs constituent un pipeline distinct : ils proviennent des configurations d'évaluation, et non de l'instrumentation d'exécution, et atterrissent dans leur propre groupe de journaux CloudWatch. Chaque exécution d'évaluation persiste également ses sorties complètes dans S3 et notre lac de données, alimentant deux tableaux de bord :
- Un tableau de bord conversationnel pour interroger les résultats d'évaluation et d'observabilité.
- Un tableau de bord Amazon Quick pour l'analyse des tendances, le suivi des scores et les comparaisons entre agents sur l'historique complet.
Des vues adaptées à chaque rôle se superposent. Les ingénieurs d'astreinte disposent d'une vue centrée sur les traces : en un clic d'une alarme CloudWatch vers la trace AgentCore Observability qui l'a déclenchée. La trace montre chaque outil appelé, dans quel ordre, avec la latence par étape, la consommation de jetons, le coût et le contexte de raisonnement complet : tout ce qu'il faut pour passer de « alarme déclenchée » à « cause racine identifiée » sans ouvrir un second outil, comme illustré à la Figure 5.
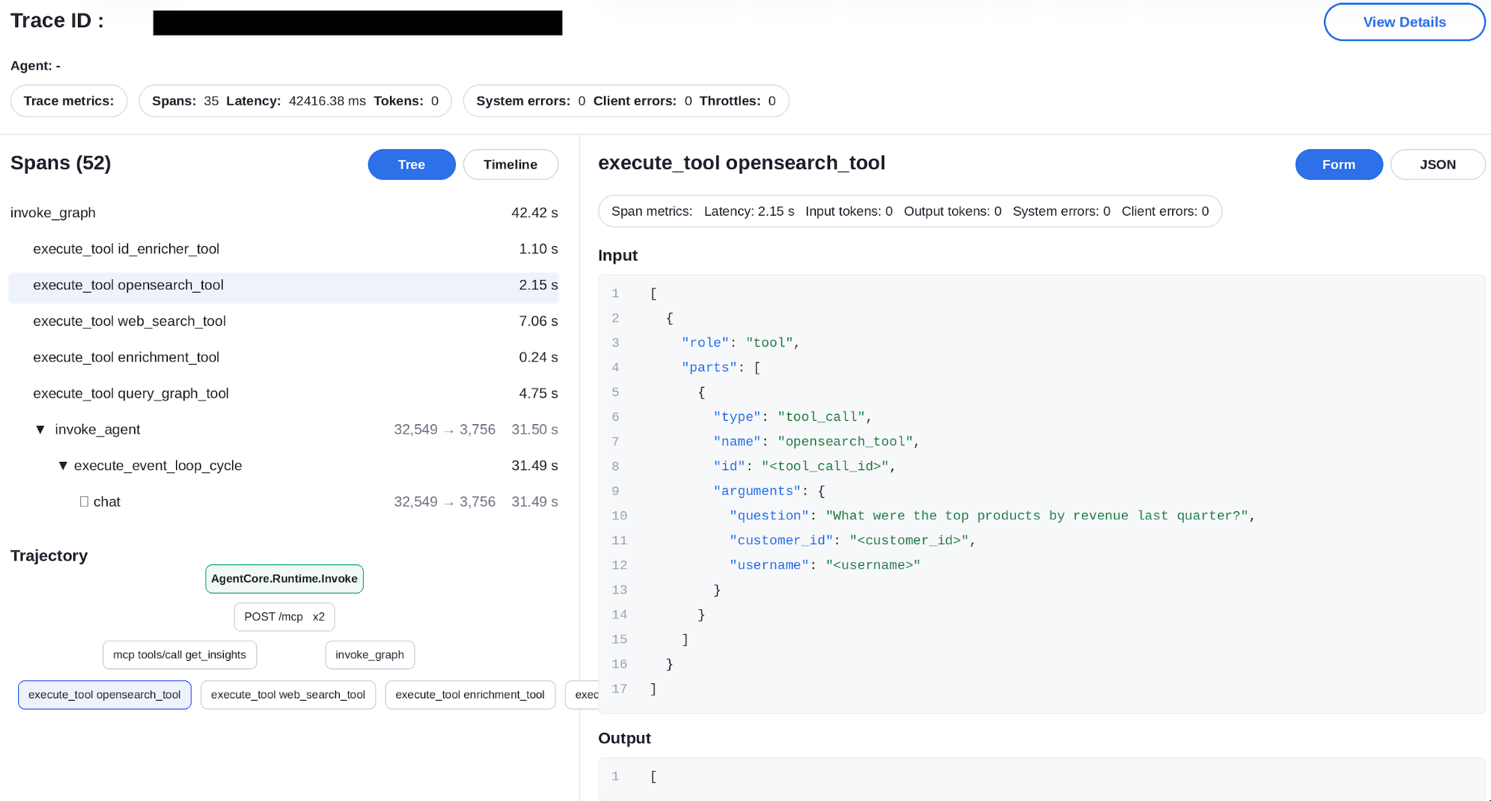
Figure 5 : Trace d'exécution AgentCore pour le Customer Insights Agent, montrant l'arborescence des spans, la trajectoire et les métriques au niveau des spans. Les chiffres et valeurs de la figure sont illustratifs.
Les chefs de produit obtiennent des tableaux de bord de tendances Amazon Quick : scores de qualité par sous-agent et par fonctionnalité, de version en version. La direction obtient un résumé de santé d'une seule page aligné sur les revues hebdomadaires et inter-métiers selon les cinq dimensions, une vérification d'une minute qui répond à « comment se portent nos agents ? »
La Figure 6 montre la vue globale de notre tableau de bord d'évaluation hebdomadaire : un taux de réussite combiné issu à la fois des évaluateurs personnalisés et des évaluateurs intégrés d'AgentCore, accompagné de la latence, pour la semaine écoulée. Les chiffres et valeurs de la figure sont illustratifs.
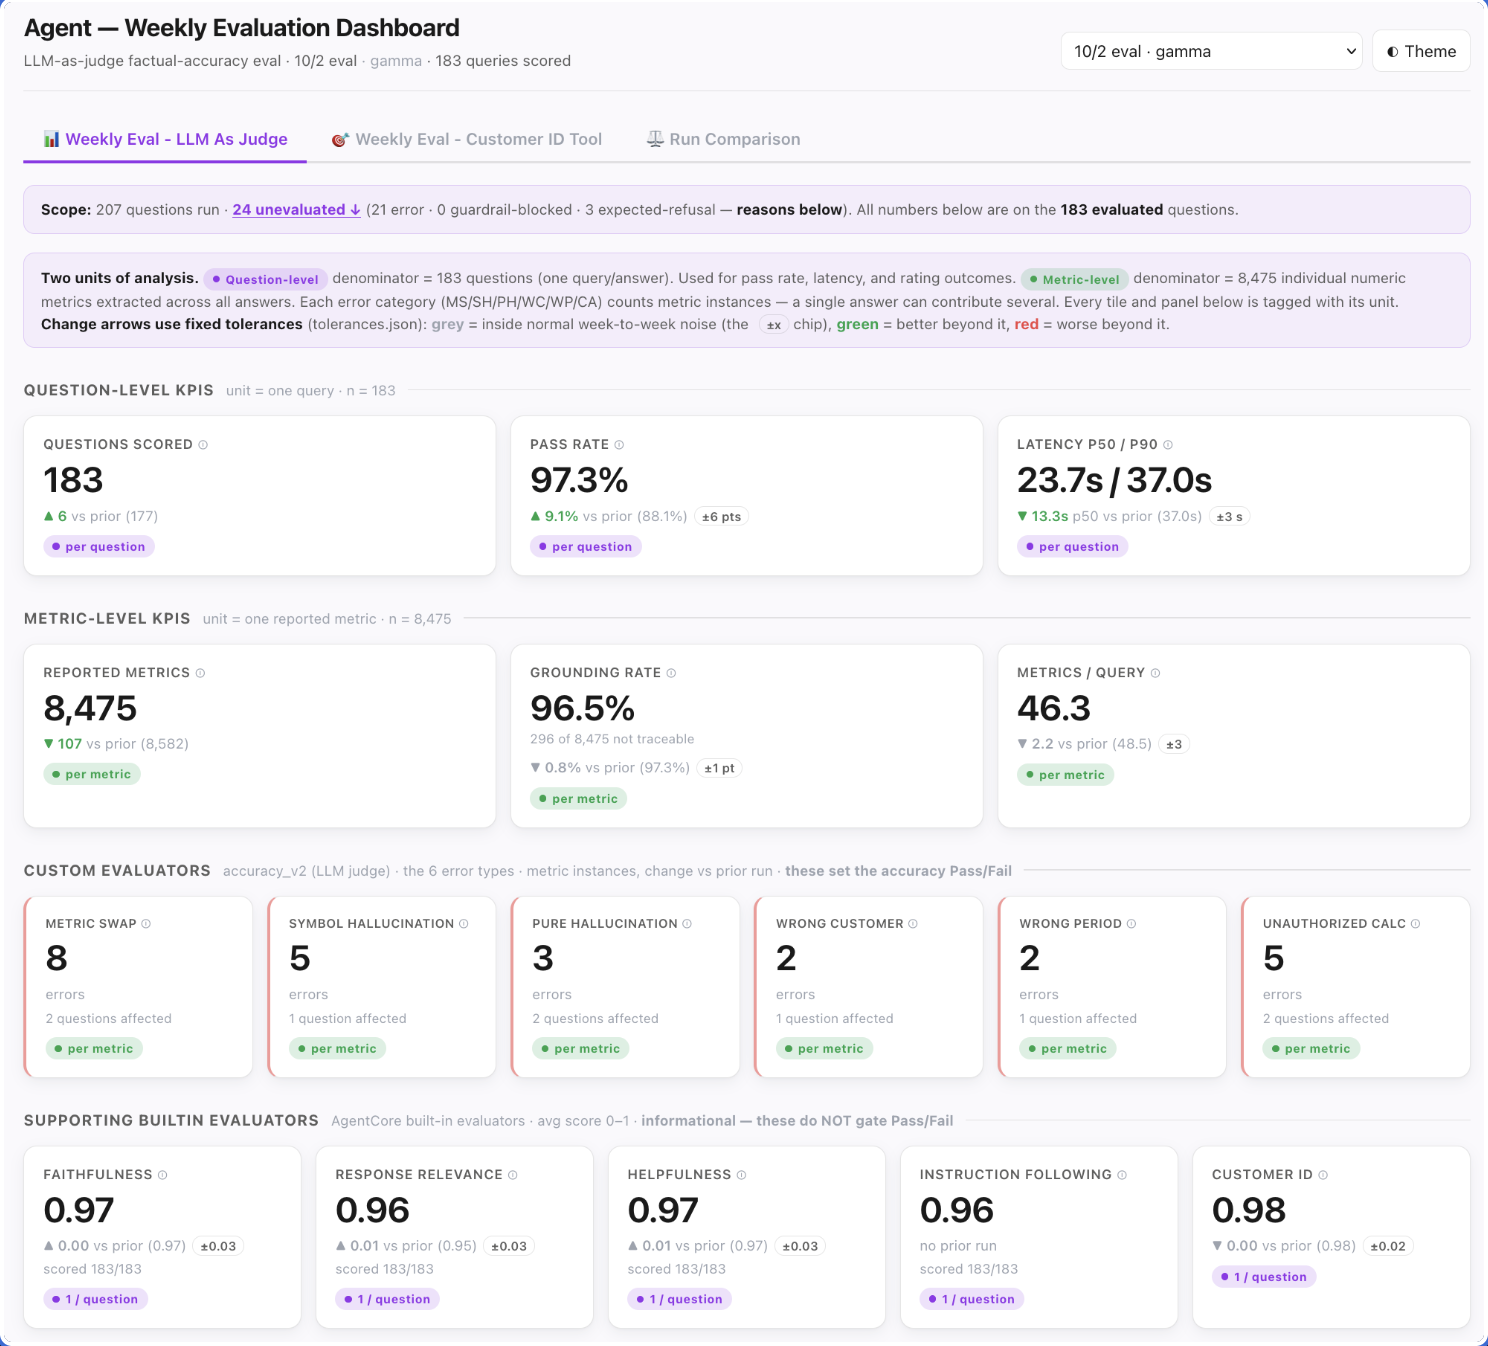
Figure 6 : Tableau de bord hebdomadaire global avec taux de réussite combiné et latence. Les chiffres et valeurs de la figure sont illustratifs.
La Figure 7 approfondit cette même exécution au niveau des évaluateurs personnalisés et des catégories de défaillances, en décomposant précisément quels types d'erreurs (échanges de métriques, hallucinations, échecs d'identification client, et autres) creusent l'écart et combien de questions chacun affecte. Les chiffres et valeurs de la figure sont illustratifs.
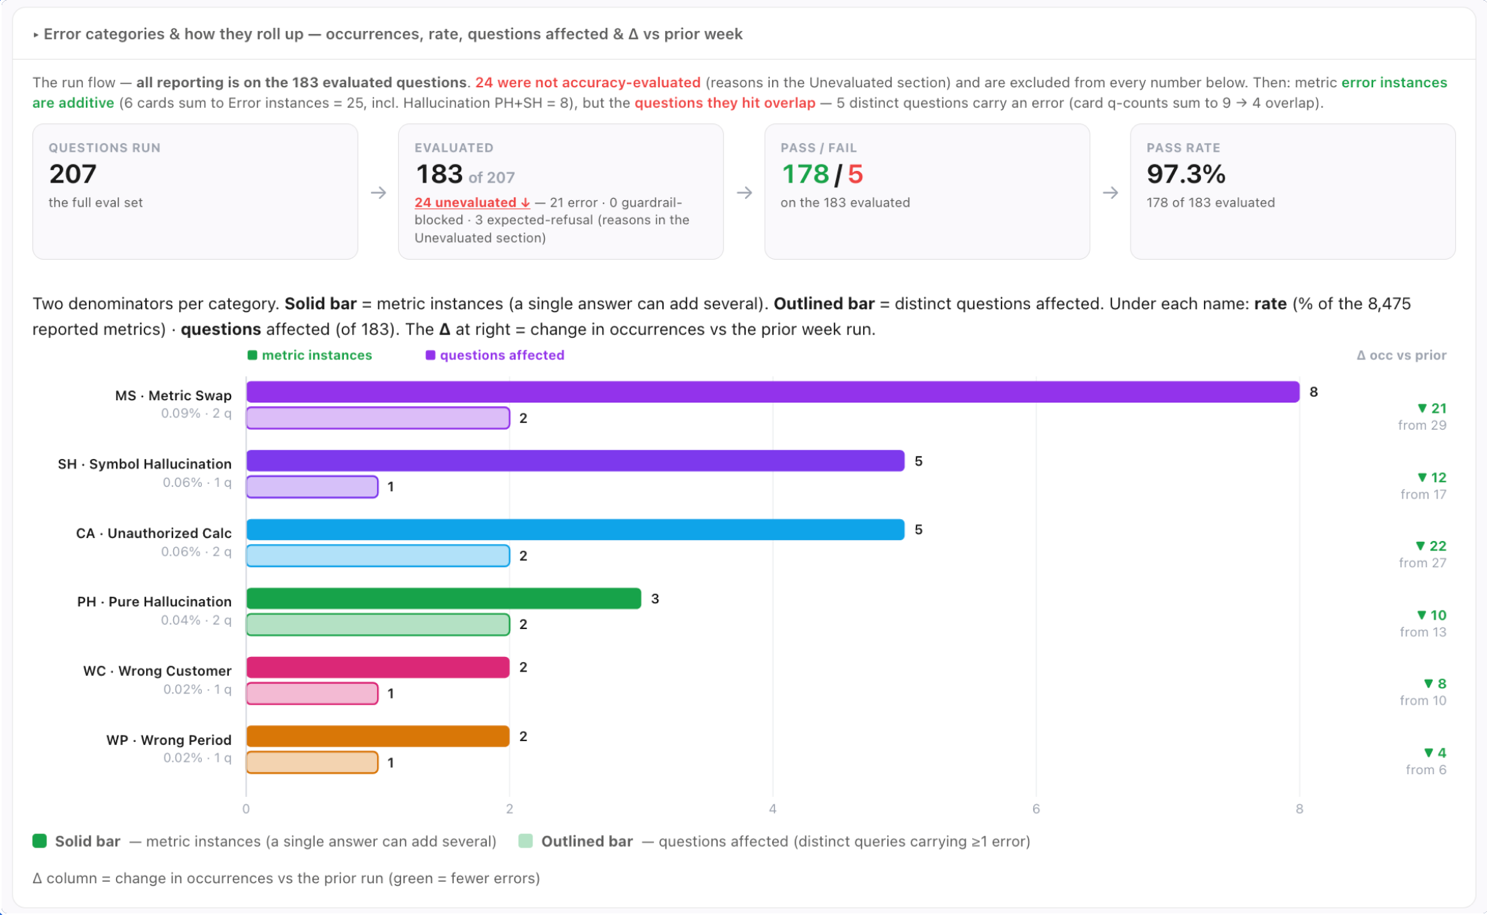
Figure 7 : Tableau de bord hebdomadaire de signalement des erreurs décomposant les défaillances par catégorie. Les chiffres et valeurs de la figure sont illustratifs.
Avant l'étape 8, le délai moyen de détection (MTTD) était de plusieurs jours à plusieurs semaines. Après l'étape 8, il est inférieur à quatre heures, et le premier signal est une alarme CloudWatch avec une trace AgentCore jointe.
Étape 9 : La boucle de rétroaction. Amélioration continue
Cette étape transforme les observations en actions. Le système compose la qualité au fil du temps. Nous utilisons AgentCore optimization, une capacité d'Amazon Bedrock AgentCore, pour fermer la boucle.
- Recommandation de prompt système : Analyse les traces de l'agent et génère un prompt système optimisé fondé sur les données qui améliore les performances sur l'évaluateur cible. La solution utilise les schémas de défaillance et ajoute des instructions comportementales spécifiques.
- Recommandation de description d'outil : Analyse les traces de l'agent et génère des descriptions d'outils affinées qui réduisent la confusion dans la sélection des outils. Particulièrement lorsqu'un agent sélectionne le mauvais outil pour des requêtes ambiguës.
Regardons un exemple :
AgentCore optimization en action
Sur quoi améliorer :
Évaluateur cible : hallucination: le modèle reproduisant verbatim des valeurs codées en dur provenant d'exemples few-shot dans des contextes sans rapport.Pourquoi cela s'est produit : Les exemples few-shot contiennent de vrais montants en dollars et de vrais noms de clients (par exemple, « $4.2M », « Acme Corp ») que le modèle mémorise et divulgue dans des requêtes sans rapport.
Comment corriger : Remplacer les valeurs codées en dur dans les exemples few-shot par des espaces réservés génériques (par exemple,
$[AMOUNT],[CUSTOMER_NAME]) afin que le modèle apprenne la structure des réponses sans mémoriser de points de données spécifiques.Impact et résultat : Correctif appliqué. Les occurrences de pure hallucination sont passées de 138 à moins de 52 pour 10,000 réponses, et le taux global d'ancrage s'est amélioré de 93 pour cent à 96 pour cent.
L'optimisation AgentCore utilise des recommandations pour produire des modifications du prompt système et des descriptions d'outils fondées sur des données, à partir de traces réelles d'agents et d'un évaluateur cible. L'optimisation AgentCore s'appuie sur AgentCore Evaluations . Les traces obtenant de faibles scores sont promues dans l'ensemble golden en tant que gardes de régression permanentes afin que chaque échec n'atteigne pas les utilisateurs deux fois.
Principales métriques d'évaluation des agents en un coup d'œil
Les métriques d'évaluation sont définies à l'étape 1, appliquées tout au long des neuf étapes et surveillées en continu en production. Cet ensemble n'est pas statique. À mesure que nous apprenons de l'agent en production, de nouveaux schémas d'échec apparaissent, de nouvelles dimensions deviennent mesurables et les métriques évoluent en conséquence. Voici ce par quoi nous avons commencé et ce que nous suivons aujourd'hui.
| Niveau | Métrique | Ce qu'elle mesure | Suivi comme |
| Qualité : Agent | Taux de réussite global en précision | % des réponses sans aucun échec de taxonomie | Métrique principale du tableau de bord |
| Qualité : Agent | Taux de permutation de métrique | Client et période corrects, mauvaise métrique renvoyée | Occurrences pour 100 réponses |
| Qualité : Agent | Taux de période erronée | Données provenant de la mauvaise fenêtre temporelle | % citant la bonne fenêtre temporelle |
| Qualité : Agent | Taux de client erroné | Noms de comptes ou filiales confondus | Précision de résolution d'entités en % |
| Qualité : Agent | Taux d'ancrage | Chiffres traçables à une source récupérée | % des chiffres rapportés et ancrés |
| Qualité : Agent | Taux de respect du périmètre | Réponses qui répondent à la question posée | % de réponses pertinentes |
| Qualité : Agent | Taux de calculs non autorisés | Chiffres dérivés non autorisés | Occurrences pour 100 réponses |
| Qualité : Agent | Pertinence / Fidélité / Utilité | Qualité des réponses selon les dimensions intégrées d'AgentCore | Score de l'évaluateur intégré d'AgentCore (0–1) |
| Qualité : Outil | Exactitude de l'identification du client | L'outil résout vers l'entité canonique exacte | % de résolutions correctes (déterministe) |
| Qualité : Outil | Exactitude de la sélection d'outil | L'agent sélectionne l'outil correct pour la requête | Score de l'évaluateur intégré d'AgentCore (0–1) |
| Qualité : Outil | Précision de la récupération | Le contexte récupéré contient les informations nécessaires | % de récupérations avec contexte pertinent |
| Qualité : Outil | Exactitude de la génération SQL | L'agent Data Insights génère un SQL correct | % de jeux de résultats corrects (déterministe) |
| Qualité : Outil | Taux de réussite des outils | % d'appels d'outils renvoyant une réponse valide | % de réussite par outil |
| Qualité : Multi-agents | Taux de réussite de l'exactitude de bout en bout | Le chemin d'orchestration complet produit une réponse correcte | % des scénarios passant tous les évaluateurs |
| Qualité : Multi-agent | Précision du routage | L'orchestrateur route vers le(s) bon(s) sous-agent(s) | % de routages corrects (déterministe) |
| Qualité : Multi-agent | Fidélité de la synthèse | Les sorties des sous-agents sont combinées sans distorsion | Score LLM-as-judge à travers les frontières entre agents |
| Qualité : Multi-agent | Précision de la propagation du contexte | Le contexte transmis entre les agents est correct et complet | % de traces sans perte de contexte |
| Sécurité | Taux de blocage des garde-fous | % des requêtes bloquées en entrée ou en sortie | Pour 1,000 requêtes |
| Sécurité | Taux de violation en entrée / sortie | % des requêtes ou réponses signalées comme violant les politiques | % du total des requêtes / réponses |
| Sécurité | Latence des garde-fous | Surcoût de latence ajouté par les vérifications des garde-fous | p99 (objectif : moins de 50ms) |
| Performance | Latence de bout en bout | De la réception de la requête à la livraison de la réponse | p50, p90, p99 |
| Performance | Latence par sous-agent / outil | Par sous-agent et par exécution d'outil | p50, p90, p99 indépendamment |
| Performance | Taux de régression de latence | Exécutions CI dépassant le seuil de latence de l'Étape 1 | % des exécutions CI |
| Coût | Coût par requête | Coût total en tokens par requête utilisateur de bout en bout | Tokens d'entrée + sortie × prix |
| Coût | Coût par réponse réussie | Coût par requête divisé par le taux de réussite | Pénalise les échecs coûteux |
| Coût | Appels d'outils moyens par requête | Efficacité du raisonnement. Une hausse des appels signale une dégradation | Moyenne par requête |
| Contrôle opérationnel | MTTD / MTTR | Temps de détection et de remédiation, par classe d'échec | Heures (objectif MTTD : moins de 4h) |
| Contrôle opérationnel | Taux de détection automatique | Incidents détectés par l'évaluation par rapport aux réclamations des utilisateurs | % (objectif : au-dessus de 95%) |
| Contrôle opérationnel | Taux de faux positifs des alarmes | Alarmes ne correspondant pas à une dégradation réelle | % du total des alarmes |
Conclusion
L'impact du cadre d'évaluation d'agents en neuf étapes a été concret et mesurable. Les régressions de qualité qui auparavant mettaient des jours ou des semaines à apparaître, et arrivaient généralement via une réclamation d'un vendeur, sont désormais détectées en moins de quatre heures par l'évaluation automatisée. Les décisions de déploiement qui reposaient autrefois sur un jugement subjectif exigent maintenant que chaque évaluateur franchisse un seuil quantitatif. Les cycles d'itération des prompts sont passés de jours à minutes. La sécurité est passée d'audits périodiques à une couverture de garde-fous de 100 pour cent sur chaque requête. Les régressions de latence sont détectées au niveau de la porte CI avant d'atteindre la production. Les surprises de coût qui n'apparaissaient autrefois que des semaines plus tard dans la facturation sont désormais évaluées à l'Étape deux et appliquées par la porte de qualité avant la mise en production d'un changement. Et « quelque chose dans le pipeline de l'agent » est devenu à un clic d'une alarme CloudWatch vers une trace d'exécution complète de l'agent avec chaque étape de raisonnement visible.
La leçon plus large est une leçon que l'industrie a déjà apprise. Le DevOps nous a appris que livrer du code sans tests automatisés est irresponsable. Le MLOps nous a appris que déployer des modèles sans supervision est dangereux. L'AgentOps nous enseigne la même chose au sujet des agents d'IA : les exploiter sans évaluation continue et multi-niveaux, c'est voler à l'aveugle.
Le cadre en neuf étapes décrit ici n'est pas propre aux agents d'intelligence commerciale. Les équipes déployant des systèmes multi-agents qui raisonnent, appellent des sous-agents, des outils et synthétisent des réponses seront confrontées aux mêmes questions tout au long du même cycle de vie. Votre taxonomie des échecs sera différente. Votre jeu de référence reflétera votre domaine. Votre pile d'évaluateurs sera ajustée à vos utilisateurs. Ce qui reste constant, c'est le principe : l'évaluation n'est pas une étape finale d'assurance qualité. C'est le système d'exploitation de l'agent lui-même, mesuré en continu, défendu automatiquement et amélioré à chaque interaction.
Si vous créez des agents de production et souhaitez apporter ce type de discipline d'évaluation à votre système, Amazon Bedrock AgentCore Evaluations vous offre la plateforme pour le faire : évaluation à la demande pour les expériences, évaluation par lots pour la surveillance continue, évaluation en ligne pour le trafic en direct, évaluateurs intégrés et personnalisés, évaluation de jeux de données (en préversion publique), intégration CloudWatch, ainsi que les fonctionnalités d'optimisation AgentCore — recommandations et tests A/B — pour boucler la boucle de rétroaction. Commencez par la première étape, définissez ce que « bon » signifie pour votre agent, et laissez le cadre faire le reste.
Prêt à commencer ? Consultez Evaluate agent performance dans la documentation Amazon Bedrock AgentCore. Et si vous créez des agents de production et souhaitez discuter de la manière d'appliquer ce cadre à votre système, nous serons ravis de vous aider. Contactez-nous directement ou via votre équipe de compte AWS.
Pour en savoir plus sur Amazon Bedrock AgentCore Evaluations, consultez Evaluate agent performance dans la documentation AWS. Pour une introduction technique, lisez Build reliable AI agents with AgentCore Evaluations. Pour voir comment nous avons créé l'agent Performance Insights, lisez Comment AWS SMGS utilise un assistant conversationnel propulsé par l'IA pour transformer la gestion d'entreprise avec Amazon Bedrock AgentCore. Pour en savoir plus sur les recommandations et l'optimisation d'AgentCore, lisez Optimisation d'AgentCore : Améliorer la boucle de qualité des agents grâce aux recommandations et aux tests A/B
Remerciements
Nous exprimons notre sincère gratitude à nos sponsors exécutifs et mentors dont la vision et les conseils ont rendu cette initiative possible : Damien Forthomme, Manager III, Applied Science ; Akhand Singh, responsable de l'ingénierie des données ; Sujit Narapareddy, directeur AWS Insights ; Monica Jain, Product Manager Senior – Tech et Norman Braddock, Senior Manager de la gestion de produits IA chez AWS ; Muhammad Umar Javed, Applied Scientist III, L6.