
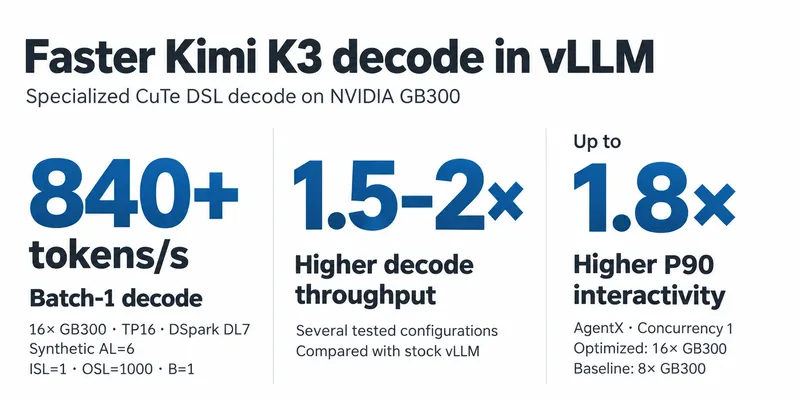
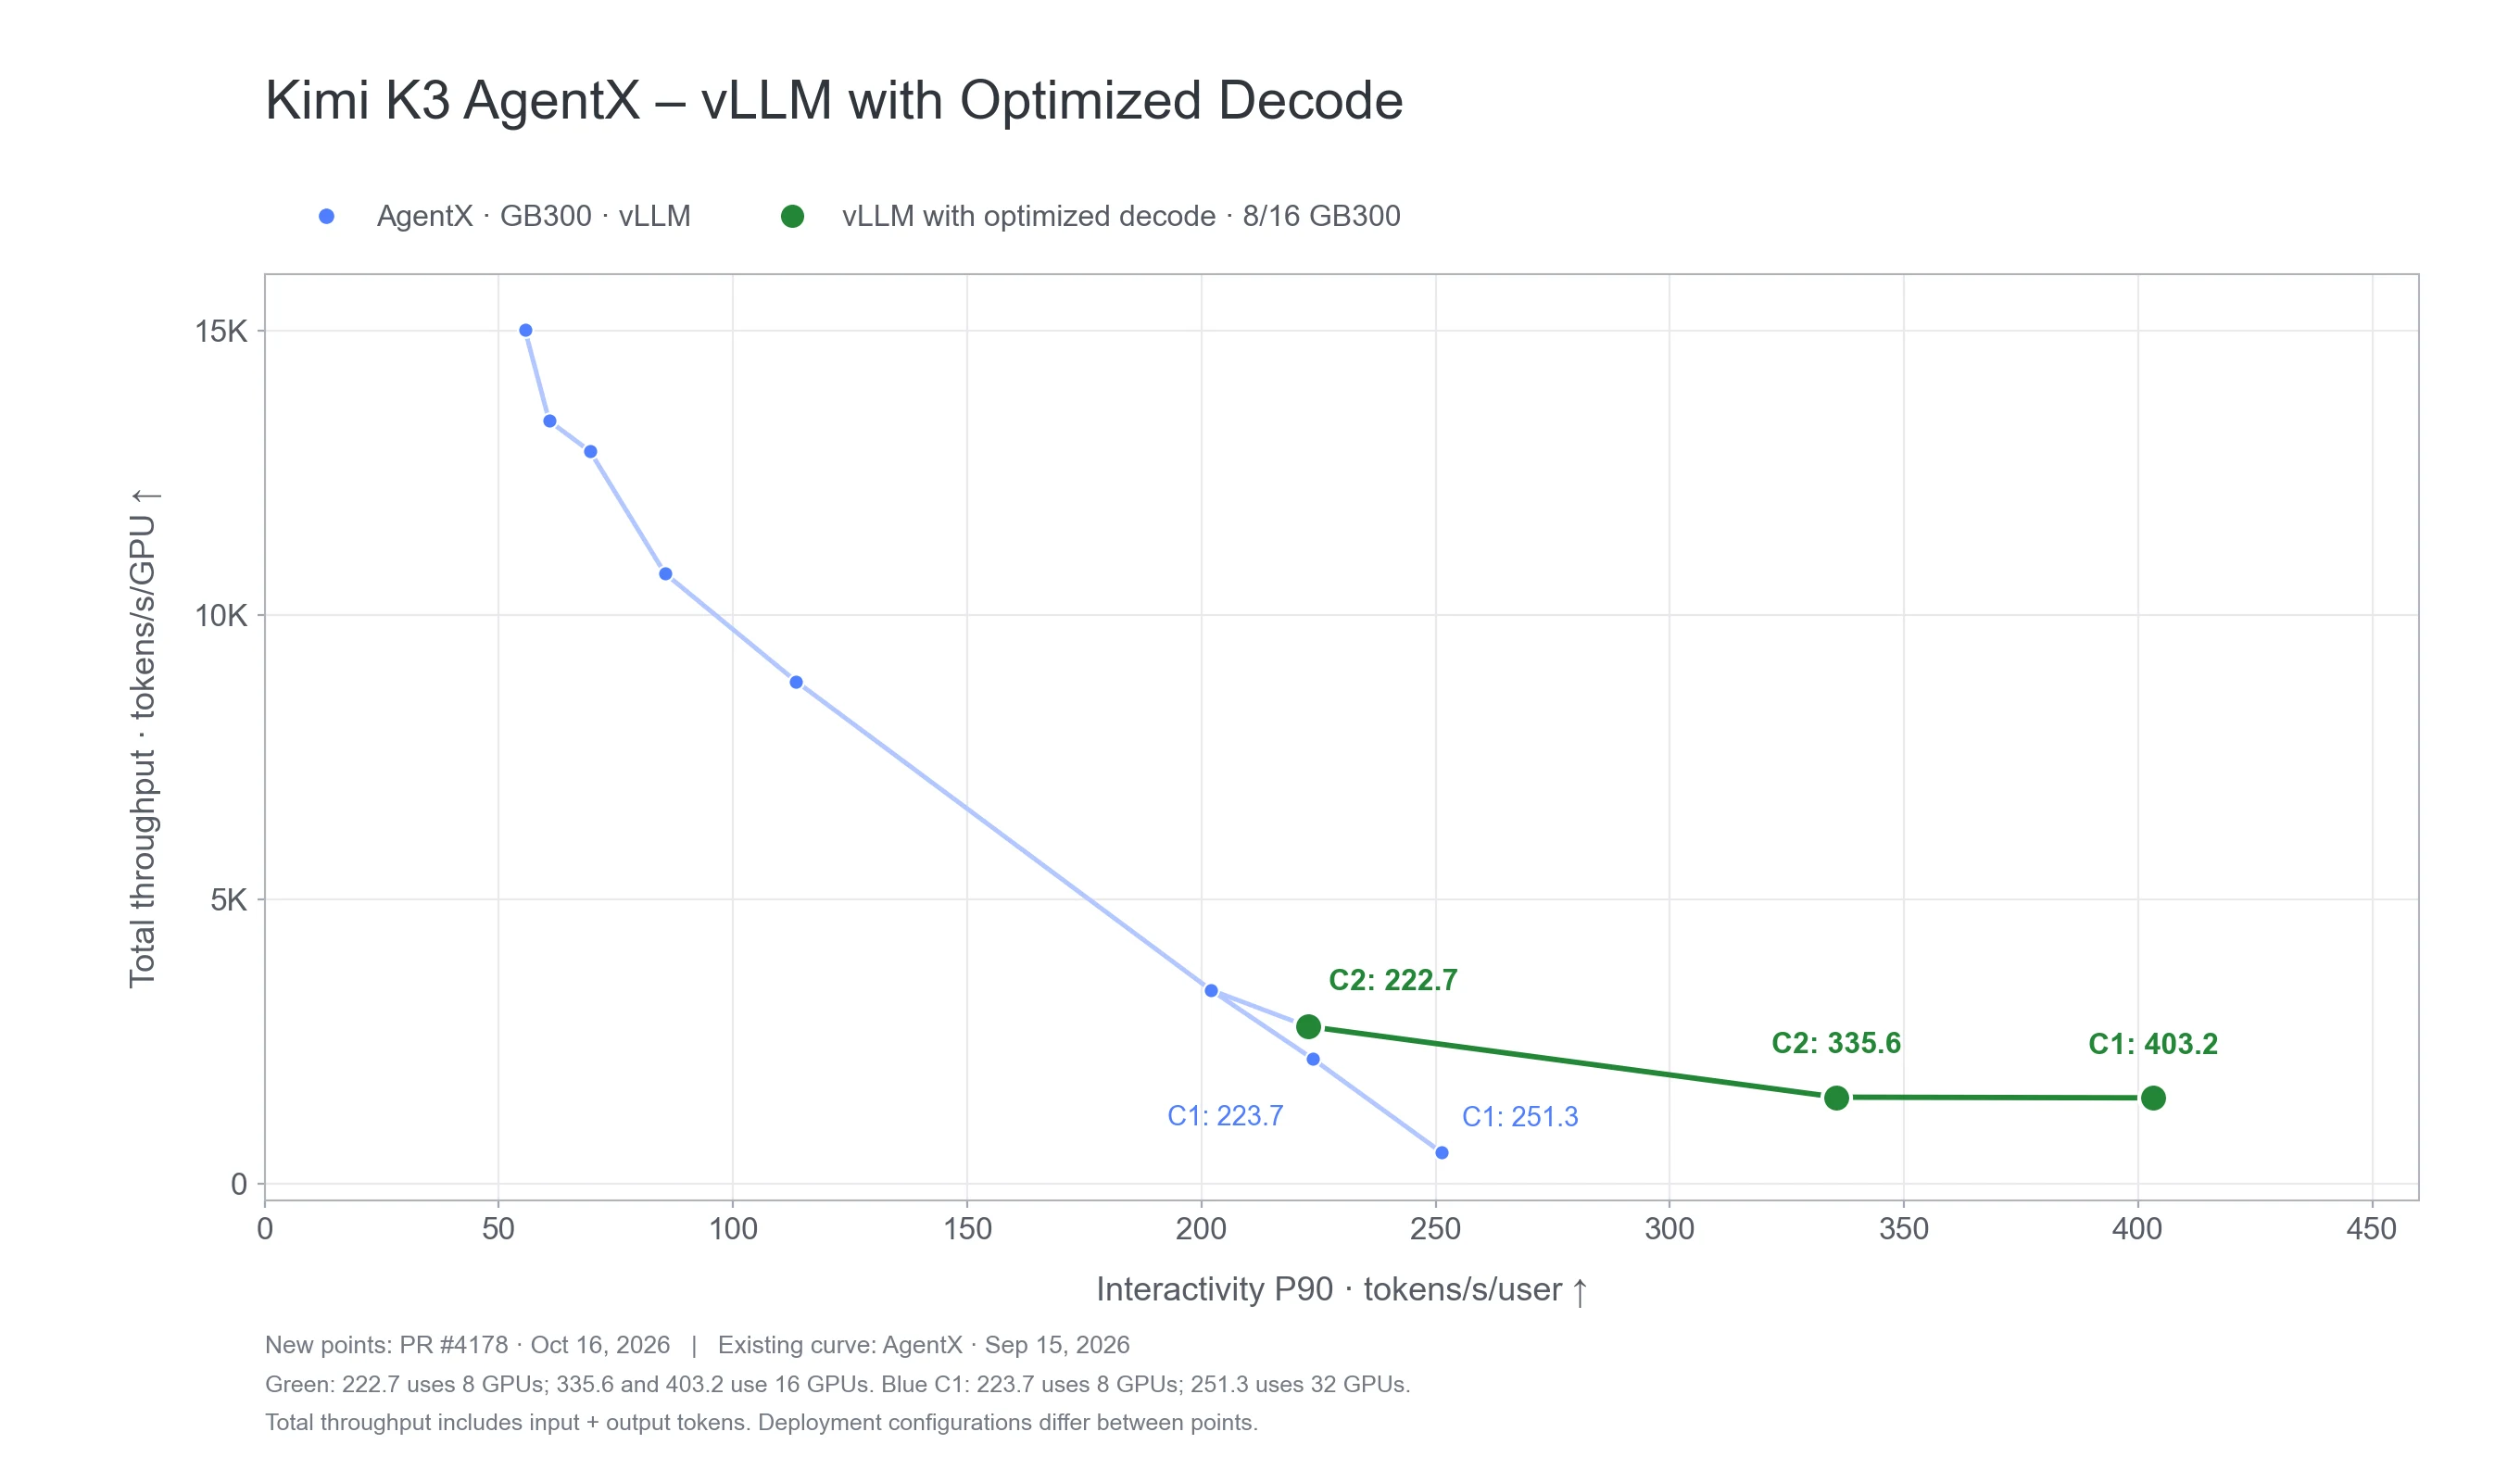
Les agents de codage peuvent désormais aider dans certaines des parties les plus difficiles de l’optimisation du modèle : écrire des noyaux GPU complexes, effectuer des fusion entre opérateurs, combiner calcul et communication, et ajuster l’exécution selon différents tailles de lot et configurations GPU. Pour Kimi K3, nous avons utilisé le développement assisté par agents pour construire une voie de décodage unifiée CuTe DSL sur le NVIDIA GB300, couvrant l’attention, le MoE et la communication entre 8 ou 16 GPU. Ces optimisations permettent plus de 840 tokens/s au lot 1 sur 16 GPU NVIDIA GB300 avec DSpark (AL synthétique = 6), un 1,5–2× plus de débit de décodage dans plusieurs configurations testées, et jusqu’à 1,8× plus d’interactivité P90 sur le travail de charge AgentX.
Le code d’inférence optimisé par l’agent dépasse le rythme de notre processus de revue et de maintenance. Le processus de revue manuelle, qui consiste à comprendre chaque ligne de chaque noyau, à identifier les problèmes potentiels et à tester toutes les configurations supportées, est un travail très long. D’un autre côté, si nous omettons ce travail, nous risquons de livrer du logiciel défectueux qui pourrait échouer en production.
Il existe une ligne de vue claire pour atteindre ces deux objectifs : nous devons changer la manière dont nous organisons le travail en performance. Parallèlement à l’optimisation agentique, nous devons concevoir des systèmes permettant une vérification automatique de la fiabilité et de la performance, et nous devons structurer le logiciel afin d’imposer l’isolement et la minimisation des risques par conception.
Le RFC d’optimisation du modèle à accélération rapide proposé fournit une base pour cette approche. Notre principe directeur est de réduire la charge de revue tout en gérant le risque. Pour y parvenir, nous :
- Isoler les modifications. Conserver les optimisations dans le code du modèle.
- Restreignez la portée pour conserver les fonctionnalités essentielles. Définissez le matériel et les charges de travail supportés, mais conservez les caractéristiques indispensables pour l’utilisation en LLM de production.
- Vérifiez la justesse de manière systématique. Exécutez un ensemble de tests de performance et de justesse pour garantir l'intégrité et la fiabilité, et assurez-vous qu’il y a une amélioration significative dans toutes les configurations supportées.
- Vérification de la échelle. Permettez aux contributeurs d’effectuer des évaluations standard sur leurs propres GPU et de partager des résultats reproductibles avant de solliciter l’attention du mainteneur.
Kimi K3 est notre première contribution suivant cette approche. Cet article décrit comment nous avons optimisé Kimi K3, comment nous avons construit la confiance nécessaire pour l’expédier et maintenir ces optimisations, ainsi que les résultats en performance.
Table des matières
- Partie 1 : Optimisation de Kimi K3
- Partie 2 : Se déplacer rapidement et de manière responsable
- Partie 3 : Détail approfondi sur les performances
- Quoi maintenant
- Remerciements
Partie 1 : Optimisation de Kimi K3
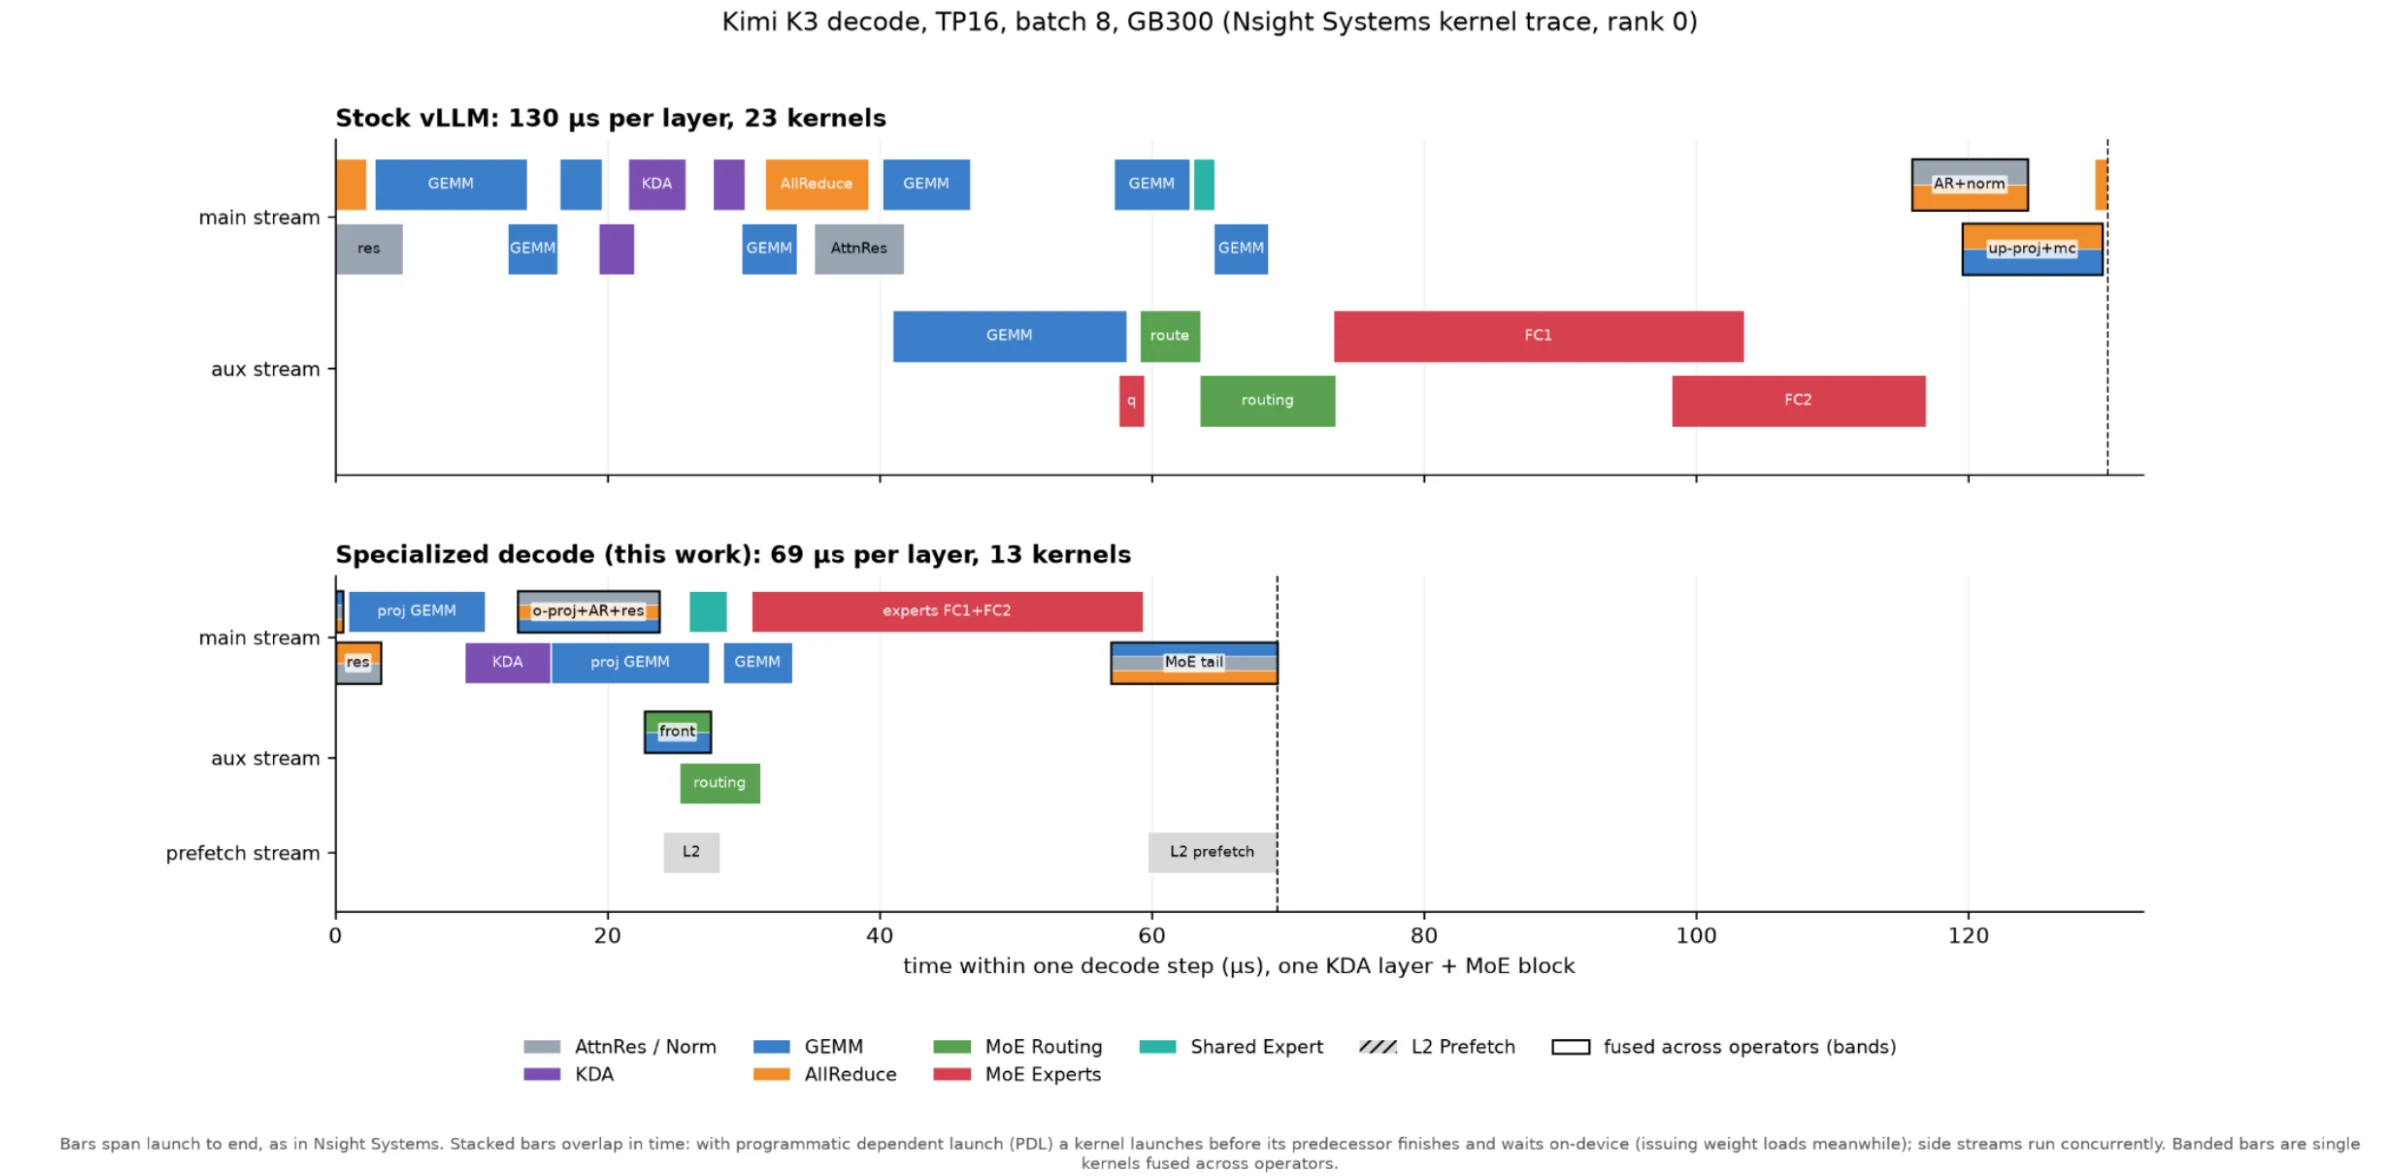
Cette contribution introduit une nouvelle voie de décodage pour Kimi K3, qui fusionne et remplace presque toutes les opérations grâce à des noyaux CuTe DSL personnalisés, adaptés à certains sous-problèmes. Elle cible les GPU NVIDIA Blackwell comprenant 8 ou 16 GPU, permet de décoder des lots allant de 1 à 64, et offre un parallélisme optionnel du contexte de décodage pour les contextes longs. Les GPU partagent un domaine NVLink avec un support multicast. Pour plus de détails, veuillez consulter le PR.
1. Ajustez les formes en fonction du travail à effectuer
Différentes tailles de lot nécessitent des choix de noyaux différents. Pour les projections d’entrée à attention, nous utilisons des noyaux de petite matrice spécialisés pour les tailles de lot de 1–2 et des noyaux split-K pour les lots plus grands, ce qui permet de répartir la multiplication de matrice entre plusieurs GPU. Toutes ces projections ont été ajustées avec soin pour activer des noyaux de taille adéquate, afin d’utiliser pleinement les ressources du GPU et d’optimiser autant que possible les lectures de mémoire, les communications et le travail de calcul.
KDA utilise également un noyau de décodage CuTe DSL optimisé, avec un programmation du temps de traitement adaptée au tamaillon et au nombre de têtes d’attention sur chaque GPU.
Pour des contextes longs, le décodage du parallélisme de contexte (DCP) divise la mémoire KV entre les GPU. Chaque GPU calcule l’attention sur sa partie locale, et un noyau fusionné adapté combine les résultats partiels avec v-proj et gating.
2. Coïncidence entre calcul et communication
Nous fusionnons la projection de l’attention sortante directement avec son all-reduce, ainsi que le calcul du résidu d’attention suivant. Les noyaux GPU publient des résultats partiels dans des buffers accessibles via NVLink, et les noyaux récepteurs les combinent pour poursuivre le calcul. Certaines configurations à petits lots fusionnent le producteur et le consommateur en un seul noyau. L’échange de données se fait avec une approche sans barrières, avec un surcoût minimal.
Avec des volumes plus importants, la mise en œuvre passe à une reduction en deux étapes : les GPU combinent d’abord les parties assignées de l’output, puis distribuent les résultats. Cela réduit les mouvements de données entre les GPUs.
3. Améliorer la planification du MoE et l’overlap
Bien que les experts utilisent déjà le parallélisme de tenseurs, la version de base calcule les scores complets du routage et la projection des entrées latentes sur chaque GPU. Nous répartissons ces calculs entre les rangs du TP et combinons la part de chaque rang en une multiplication matricielle. Les GPUs échangent les résultats via NVLink. Cela réduit les calculs répétés, les lectures de poids et les lancement de noyaux avant le début de l’exécution par l’expert.
L’expert partagé fonctionne sur un flux distinct. Son travail se chevauche avec la computation routeur ou expert routeur, en fonction de la configuration. Le planning contrôle le nombre de ressources GPU utilisées par chaque opération, et est ajusté avec soin pour garantir un parallélisme équilibré sans conflit. Les détails se trouvent dans experts_runtime.
4. Préchargement des poids à venir dans la mémoire cache
Dans les inférences à petite taille de lot, nous sommes souvent limités en mémoire : nous sommes réduits par la vitesse à laquelle nous pouvons charger les poids depuis la mémoire. Certaines phases ne peuvent pas utiliser pleinement la bande passante de la mémoire disponible, comme la communication : pendant que cet processus se déroule, nous pouvons exécuter un noyau dédié sur une flux secondaire afin de garantir que, une fois la communication terminée, les poids pour l’opération suivante auront une taux de mise à jour dans la cache beaucoup plus élevé.
Partie 2 : Se déplacer rapidement et de manière responsable
Kimi K3 n’est que l’un des premiers exemples. Nous croyons que la communauté peut travailler ensemble pour introduire davantage de modèles, de GPU et de charges de travail vers la vitesse de la lumière.
Divers contributeurs/agents trouveront différentes opportunités : un meilleur planning de communication, ou une fusion qui aide à une déploiement spécifique. Mais si chaque contribution arrive avec des hypothèses différentes, des tests incomplètes et un benchmark difficile à reproduire, le travail de validation et de maintenance devient rapidement un goulot d’étranglement, ou nous risquons de livrer du code défectueux. Nous avons besoin d’une méthode commune pour transformer ces idées en améliorations sur lesquelles les utilisateurs peuvent compter pour leurs cas d’usage de production à long terme.
Cela change ce que nous demandons aux agents de fournir. Nous devrions établir des attentes claires en matière de tests, de validations et de exigences pour le code que les agents produisent. Les agents élaboreront des tests, effectueront des évaluations et des benchmarks complets, examineront les échecs et documenteront les conditions dans lesquelles l’optimisation fonctionne. Les réviseurs humains continueront de juger du design et des preuves, mais ils pourront partir d’une abstraction de haut niveau, plutôt que d’une revue ligne par ligne du code.
En nous appuyant sur le RFC à déroulement rapide proposé, nous organisons ce travail autour de quatre principes.
1. Isoler les modifications
Conservez les optimisations spécifiques au modèle dans le code du modèle. Cela rend les chemins affectés plus faciles à identifier et réduit la portée de l’effet que les revues doivent prendre en compte.
L’isolation doit également être maintenue en temps de exécution. Les revues doivent pouvoir déterminer quand le chemin optimisé est choisi, quel état il change, et comment l’exécution retourne au chemin standard.
Cette contrainte exclut certaines optimisations : la préparation des entrées, le sampling et la gestion de la cache KV peuvent entraîner des surcoûts que l’isolation ne permet pas d’éviter. Cela est une conséquence du design et est en grande partie intentionnel : ces composants sont tous partagés dans la plupart des déploiements vLLM, et les modifications effectuées pour optimiser un travail spécifique risquent de perturber des dizaines d’autres configurations stables de vLLM. Les travaux sur ces composants sont importants, et devraient impliquer plus étroitement les mainteneurs principaux que ne le permettrait une procédure rapide.
2. Limité le champ d’application, mais conserve les fonctionnalités de l’utilisateur
Une optimisation n’a pas besoin d’améliorer chaque déploiement pour être utile. Elle peut cibler un GPU particulier, une configuration de parallélisme ou une gamme de tailles de batch. Des limites claires facilitent l’ajustement du travail et nous offrent un ensemble de configurations défini à valider.
Pour K3, la validation matérielle initiale couvre GB300 avec TP8 et TP16, décode des lots allant jusqu’à 64, décodage spéculatif avec diverses longueurs de projet, et décode des configurations parallèles en contexte dans un domaine NVLink.
Ces limites définissent les zones où l’optimisation s’applique, mais ne concernent pas la réduction de la couverture des fonctionnalités. La déploiement en production nécessite des fonctionnalités fondamentales qui rendent l’endpoint utile. Des fonctionnalités telles que la fourniture complète de contexte, le sampling de température et l’output structuré ne peuvent être « optimisées ou désactivées » ; elles font partie des fonctionnalités de service de première classe et appartiennent au plan de validation, ainsi que les formes du noyau et les vérifications numériques.
3. Vérifier la justesse
Les tests du noyau et les évaluations du modèle répondent à des questions différentes. Les tests du noyau vérifient les résultats numériques pour différentes formes et valeurs d’entrée. Les évaluations du modèle vérifient si l’ensemble du chemin d’exécution conserve les réponses du modèle. Nous avons besoin des deux.
Les tests doivent effectivement tester le code modifié. Une optimisation en petit nombre de lots nécessite une évaluation sur de petits lots. Un changement du noyau d’attention nécessite une couverture de contexte longue. Les tests qui utilisent silencieusement la voie standard ne fournissent peu de preuves concernant l’optimisation et constituent une pièce maîtresse fréquente.
Le développement de K3 montre pourquoi cela est important. Notre audit a révélé que le compilateur faisait effectuer les lectures d’activation avant l’attente de synchronisation. La correction a limité ce type de charge aux poids statiques. De tels erreurs peuvent résister à des vérifications fonctionnelles simples et nécessitent une investigation ciblée.
De plus, des évaluations de long contexte et de long génération telles que MRCR et AIME25 ont révélé des problèmes numériques sensibles dans les noyaux d’attention et de communication, qui ne pouvaient pas être reproduits dans des tests de noyau isolés en utilisant des entrées fictives et/ou des temps de démarrage cohérents.
4. Vérifier les performances de manière générale
Une accélération de titre est un point de départ. Il nous faut également savoir comment le changement se manifeste pour les charges de travail qu’il affecte. Cela inclut des tailles de lot variées, des longueurs de contexte et des configurations de parallélisation supportées. Les mesures MoE doivent inclure des prompts réels, car la sélection des experts influence les poids lus et la quantité de travail qui peut être réutilisé. Les résultats de décodage pur doivent également être distingués des charges de travail qui combinent précharge et décodage.
La validation fiable nécessite également du temps sur la GPU. Le RFC d’évaluation avec votre propre GPU propose des images d’évaluation standard que les contributeurs peuvent exécuter sur leur propre matériel. Les bundles de résultats reproductibles et les submissions liés aux PRs GitHub rendraient les preuves beaucoup plus accessibles. Différents niveaux d’évaluation et le calcul partagé par la communauté aideraient à étendre la couverture tout en gérant la demande de GPU et en réduisant la pression sur le CI financé par le projet.
Partie 3 : Analyse approfondie du performance
Performance de décodage avec DSpark
Avec DSpark, Kimi K3 atteint 842 tokens par seconde sur 16 GPU NVIDIA GB300 dans le benchmark AL=6 contrôlé. Cela représente 1,73× plus rapide que vLLM de base avec la même configuration de décodage spéculative. Cliquez sur le PR pour voir le tableau complet des résultats.
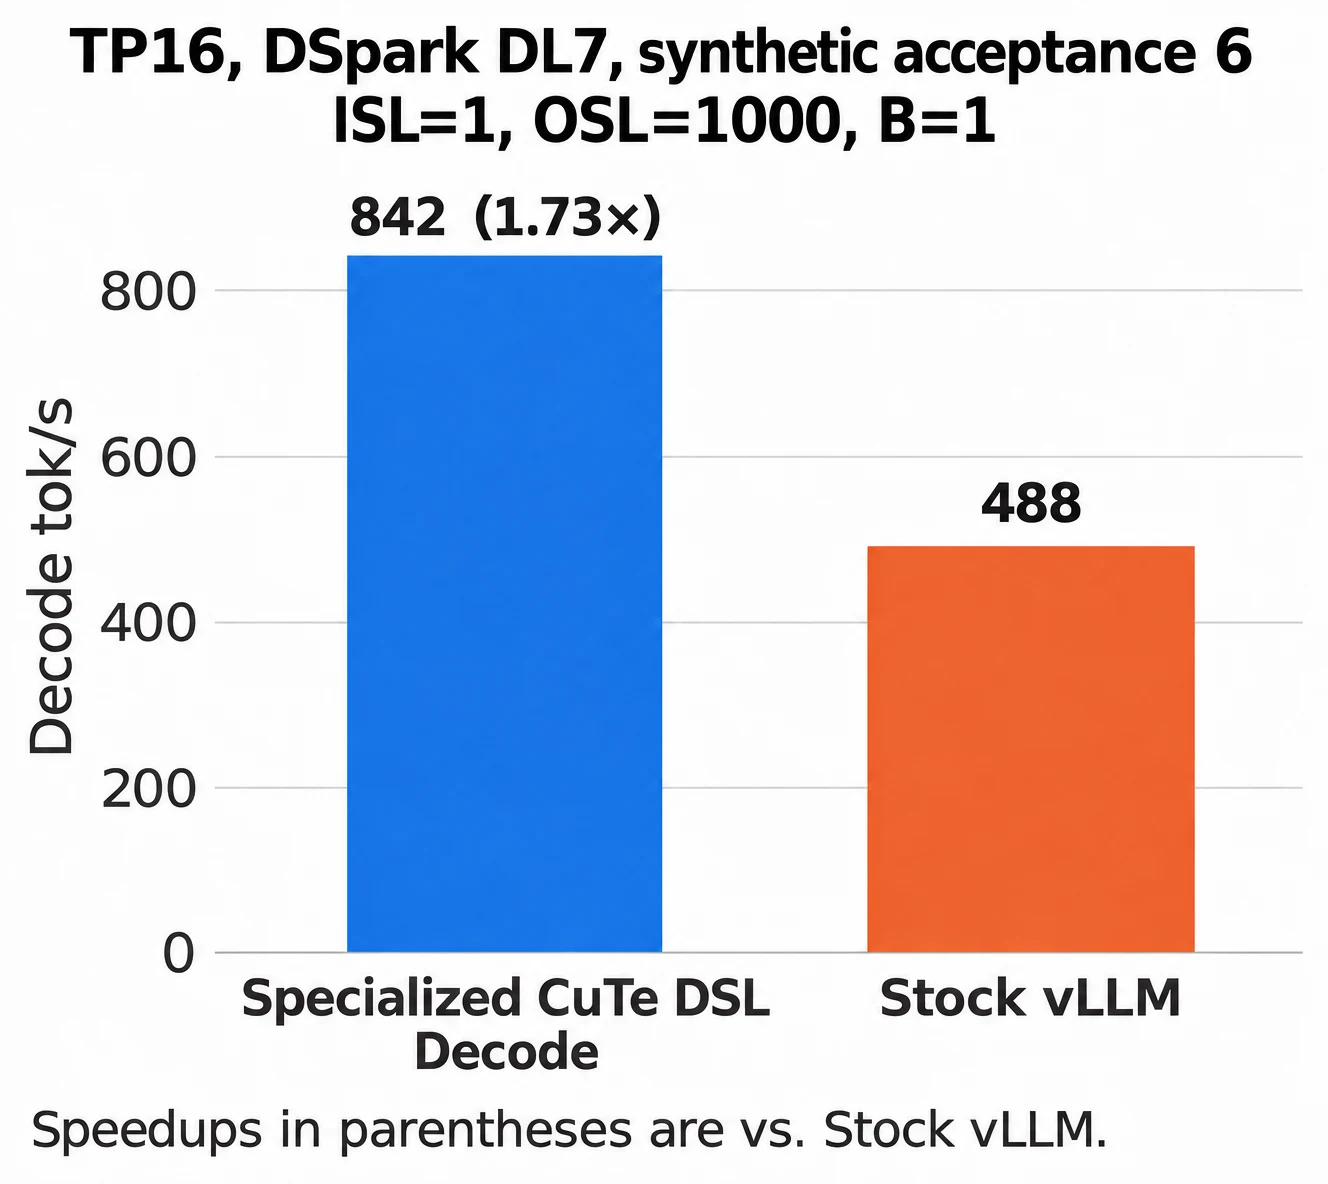
Configuration : TP16, DSpark avec sept tokens de rédaction, longueur de acceptation synthétique de 6, DL=7, ISL=1, OSL=1k, taille d’batch 1. Le TPS mesure le débit global de décodage et exclut le préremplissage.
Performance de décodage sans spéculation
Les améliorations se produisent sur toute la plage de lots testés. TP16 conserve un gain de 1,62 à 1,71× entre les lots 16 et 64, tandis que TP8 offre 1,31 à 1,43× sur cette même plage.
| Taille du lot | TP8 tokens/s | TP8 accélération | TP16 tokens/s | TP16 accélération |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
Aucun décodage spéculatif. Le taux de transfert concerne l’ensemble du groupe TP.
Amélioration sur AgentX
Notre implémentation optimisée de Kimi K3 offre également 1,8 fois plus d’interactivité P90 à une concurrence de 1 sur AgentX : 403,2 contre 223,7 tokens/s/utilisateur. Cela compare l’exécution optimisée sur des GPU 16 GB300 avec le résultat antérieur de vLLM sur des GPU 8 GB300.
AgentX répète les schémas de trafic provenant de sessions réelles d’agents de codage, y compris les contextes longs, les multiples turns de conversation, les pauses des outils, les sous-agents parallèles et la réutilisation de la mémoire KV. Il conserve ces schémas de charge de travail tout en remplaçant le contenu privé par du texte synthétique, afin de tester le système de service dans un trafic d’agent réaliste. Méthodologie AgentX.
Qu’est-ce qui va suivre
Pour DeepSeek-V4.1-Flash, #61868 suit les patterns de conception K3 : derrière le même switch opt-in decode_backend: latency_specialized, l’implémentation prend en charge jusqu’à 64 requêtes concurrentes, un fallback fluide pour les préfills et les lots mixtes, ainsi que la décodage spéculative. Au lieu de se concentrer sur un seul point d’intensité, cet exécuteur divise les noyaux et le travail sur l’hôte : il fusionne tous les éléments de type all-reduce + mHC à chaque frontière de sous-catégorie, remplace les MoE et GEMMs à gros lots par des noyaux CuTe DSL conçus pour une latence faible, déduplique et partage le travail de l’indexeur, et transmet le travail par étape à l’exécution actuelle de vLLM sur le CPU sous forme de graphe CUDA.
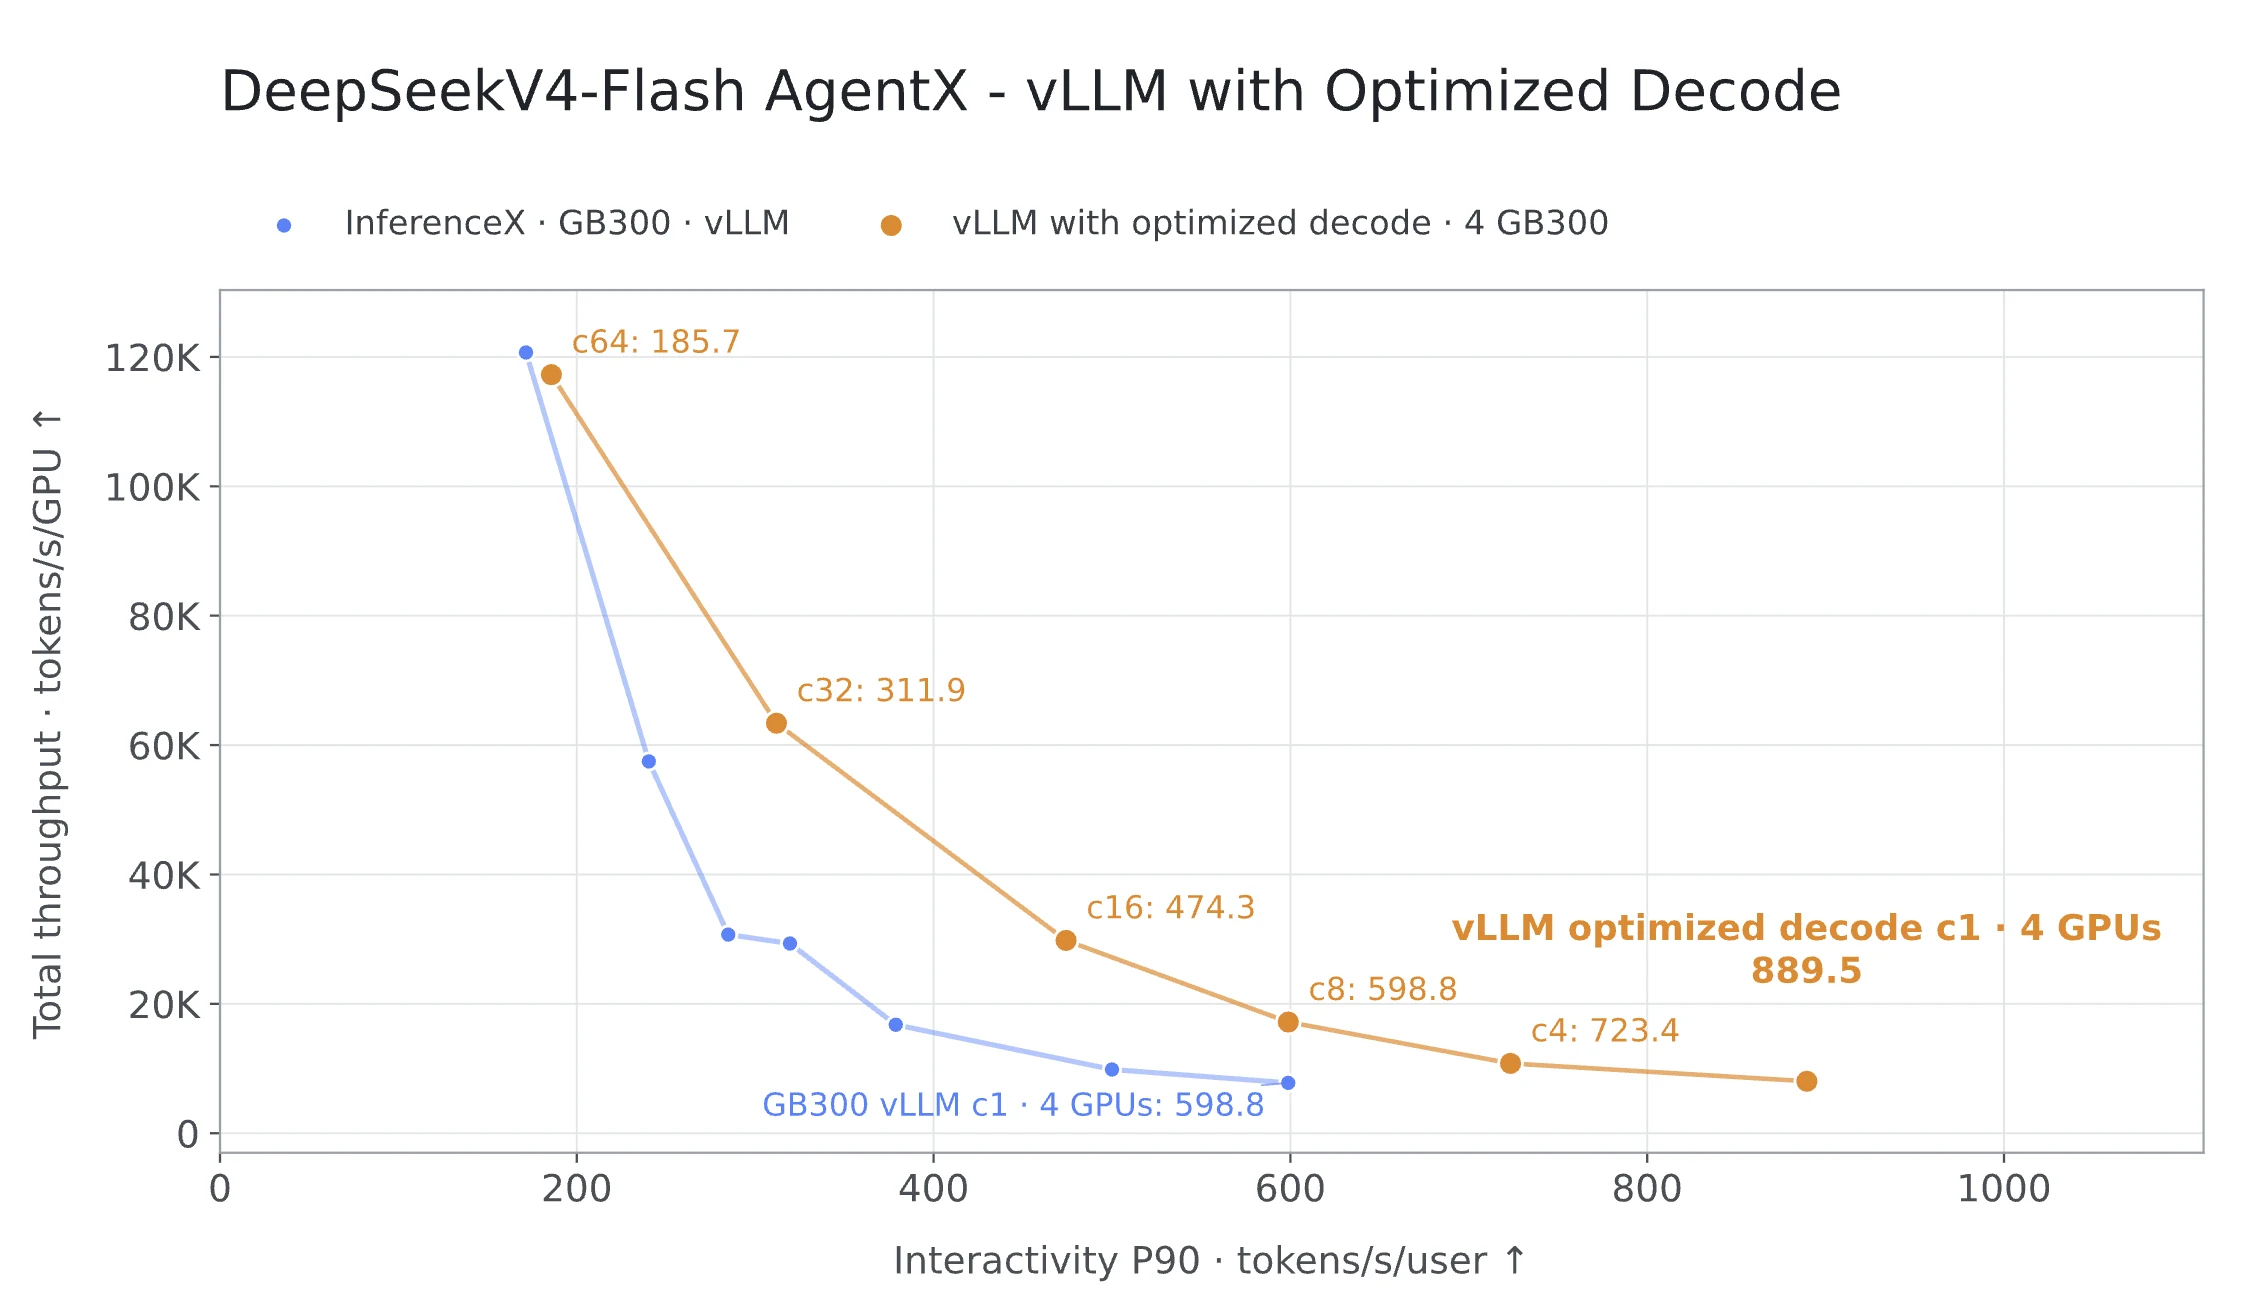
Dans deux jours après la sortie de Muse Spark Open de Meta, nos premiers résultats ont déjà dépassé 950 tokens par seconde par utilisateur, avec sept tokens de rédaction (K=7) et une longueur d’acceptation de six (AL=6). D’autres optimisations sont en cours.
Nous publions également un mécanisme similaire pour optimiser la latence de décodage pour GLM5.3 dans un scénario à faible concurrence. Nous partagerons les détails d’optimisation et les résultats de performance dans une suite.
Pour chaque contribution, nous continuerons à nous concentrer sur les gains de performance concrets, le soutien aux fonctionnalités de production, ainsi que les vérifications de la justesse et des performances reproductibles.
Remerciements
Nous souhaitons remercier Rohan Varma (NVIDIA) et Alex Steiner (NVIDIA) pour leurs contributions à ce travail.
Nous voulons également remercier Woosuk Kwon (Inferact), ainsi que Michael Goin et Lucas Wilkinson (Red Hat) pour le refactoring du modèle et les commentaires et soutien précieux.