

Deepseek V4.1 Flash 1017 bat des rivaux plus grands dans les tâches agentiques tout en réduisant encore massivement les coûts par tâche
 Matthias Bastian
Voir le profil LinkedIn de Matthias Bastian
17 octobre 2026
 Nano Banana Pro invité par THE DECODER
Points clés
- L'entreprise chinoise d'IA Deepseek a publié Deepseek-V4.1-Flash-1017 sur ses plateformes et comme modèle à poids ouverts sur Hugging Face et ModelScope.
- Entraîné par apprentissage par renforcement avec auto-retour, le modèle fonctionne plus vite, produit des sorties plus courtes et performe bien dans le développement logiciel de bout en bout et les tâches d'agent, selon l'entreprise.
- Dans ses tests de référence internes, la mise à jour bat des rivaux plus grands comme Claude Opus 5 et GPT 5.6-Sol sur les benchmarks de codage et d'agents. Deepseek ouvre également son moteur de recherche interne aux développeurs via de nouvelles API Search et Fetch.
L'entreprise chinoise d'IA Deepseek a livré une version mise à jour de son modèle Flash avec des gains majeurs dans les tâches agentiques et de codage. L'entreprise ouvre également son moteur de recherche interne aux développeurs extérieurs pour la première fois.
Deepseek-V4.1-Flash-1017 est disponible dès maintenant via le site web, l'application et l'API de l'entreprise. Deepseek a également publié les poids du modèle en open source sur Hugging Face et ModelScope. Comparé à son prédécesseur direct, le modèle affiche de meilleurs scores de référence, accomplit les tâches plus rapidement et produit des sorties plus courtes. L'entreprise qualifie cette mise à jour d'amélioration de Pareto dans le compromis entre performance et coût.
Pour construire des projets logiciels complets à partir de zéro, Deepseek utilise l'apprentissage par renforcement avec auto-retour (RLSF). Cette méthode de post-entraînement permet au modèle d'utiliser ses propres scores de confiance internes ou des critiques auto-générées comme signal de récompense. Cela supprime le besoin d'évaluateurs humains ou de modèles de récompense externes. Deepseek affirme que cette approche améliore le développement de projets de bout en bout pour des tâches allant de la programmation de jeux à la modélisation 3D et au travail de design. Le modèle peut également animer des vidéos explicatives compactes, similaires à la récemment publiée Opus 5.5.
Vidéo via FeiZPublicité
Le modèle a été optimisé pour des environnements de développement comme Deepseek Harness (version v0.2.1-rc.1 ou ultérieure recommandée), Tencent CodeBuddy et WorkBuddy.
Le modèle Flash, plus petit, bat des rivaux plus grands dans les tâches de codage et d'agents
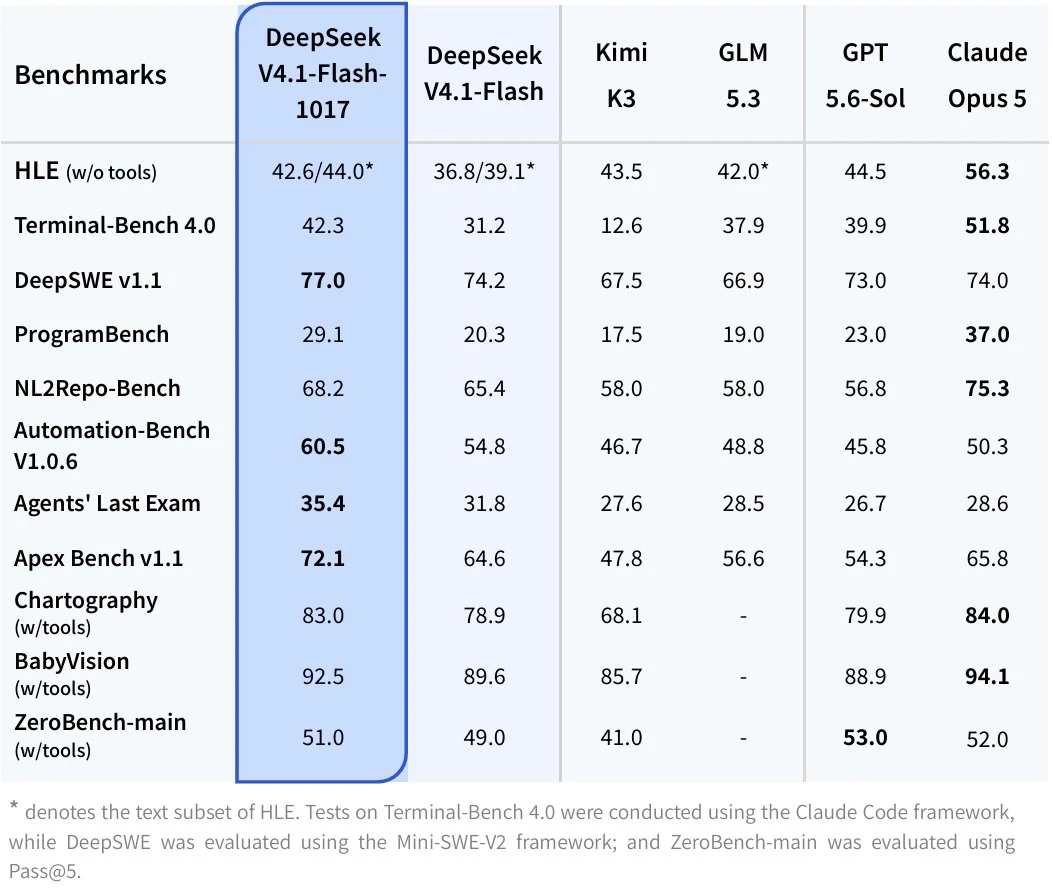
Dans ses propres benchmarks, Deepseek montre que V4.1-Flash-1017 surpasse son prédécesseur V4.1-Flash. Il bat aussi des modèles concurrents plus grands comme Claude Opus 5, GPT 5.6-Sol, Kimi K3 et GLM 5.3 dans plusieurs catégories de codage et d'agents IA.
Un graphique de coûts pour le benchmark DeepSWE montre à quel point les sorties plus courtes comptent pour l'efficacité. V4.1-Flash-1017 atteint un score maximal de 77.0 pour cent à un coût moyen d'un peu moins de 0,20 $ par tâche. En réglage bas, il dépasse encore 72 pour cent pour environ 0,10 $. Le prédécesseur avait obtenu 74.2 pour cent mais coûtait environ 0,50 $ par exécution.
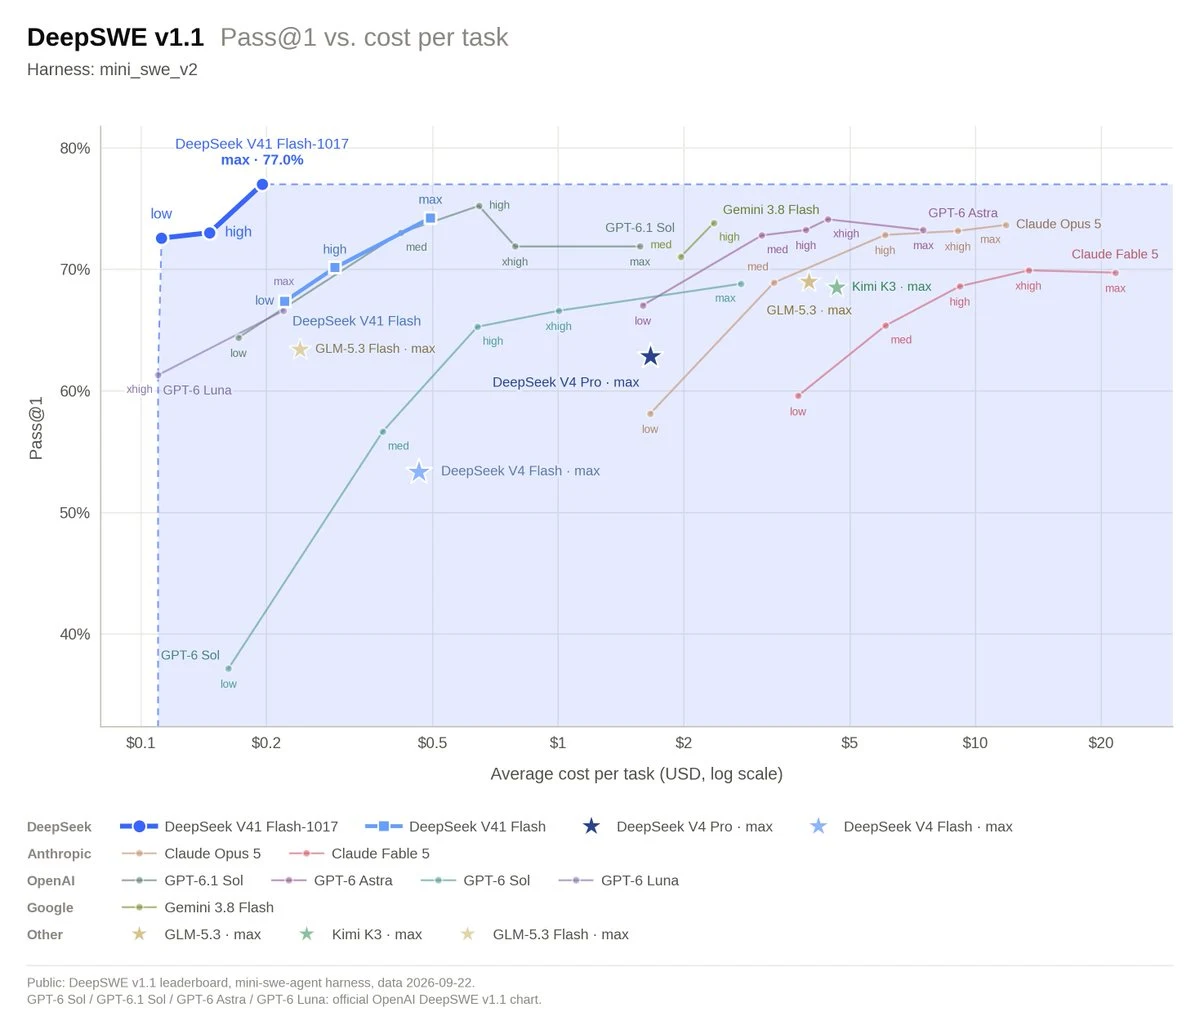
Dans ce graphique, des modèles concurrents comme GPT-6 Astra, Gemini 3.8 Flash et Claude Opus 5 se situent entre 2 $ et plus de 10 $ par tâche, et aucun d'entre eux n'atteint la précision du modèle Deepseek plus petit. Des benchmarks indépendants ne sont pas encore sortis, et de toute façon les benchmarks ne racontent qu'une moitié de l'histoire. Les impressions des développeurs sur la qualité du code, par exemple, peuvent différer considérablement des résultats des benchmarks.Ad
Deepseek transforme son moteur de recherche interne en une API publique
En plus du modèle de langage, Deepseek met ses outils de recherche web (API Search & Fetch) à la disposition de tous les développeurs. L'entreprise affirme que ces services fonctionnent sur un moteur de recherche qu'elle a construit en interne et qui traite déjà des centaines de millions de requêtes par jour dans le monde entier. Les détails de configuration se trouvent dans la documentation de l'API.
Chaque point de terminaison coûte 0.75 $ pour 1,000 appels. Les utilisateurs de l'API Deepseek peuvent accéder gratuitement aux fonctionnalités via des outils côté serveur dans Deepseek Harness, Claude Code et Codex jusqu'au 31 octobre 2026 (4:00 PM UTC).
Intégrer profondément des modèles d'IA chinois dans les flux de travail est toutefois devenu un peu moins attrayant hier. Le gouvernement chinois prévoit, selon des rapports, de durcir les règles concernant la publication de modèles à poids ouverts, voire de bloquer totalement leur sortie. L'un des facteurs décisifs est de savoir si un système donné figure parmi les 10 modèles les plus performants.
Actualités sur l'IA sans le battage – Curated by Humans
Abonnez-vous à THE DECODER pour une lecture sans publicité, une newsletter hebdomadaire sur l'IA, notre rapport exclusif « AI Radar » sur la frontière de l'IA six fois par an, un accès complet aux archives et l'accès à notre section de commentaires.
Source : Deepseek