
IT之家 Le 17 octobre : selon le média étranger Wccftech, le développeur abhi245y, en s'appuyant sur PS5LM (projet de portage de llama.cpp) de l'ingénieur IA expérimenté Mert Cobanov, a développé une application GPU native, PS5LM Plus, permettant à une console PS5 débridée d'exécuter localement des grands modèles de langage comme Qwen3.8-27B.
IT之家 a appris que les premières versions de PS5LM s'appuyaient principalement sur le CPU pour exécuter les modèles : avec un modèle à 27B de paramètres, seulement environ 1 token était généré par minute en moyenne. Pour améliorer les performances, le développeur abhi245y a porté le pilote AMD RADV du projet open source Mesa et, via l'interface de calcul Vulkan, a permis à llama.cpp de fonctionner en application native sur la PS5. Cette modification a porté la mémoire disponible d'environ 6GB à 11,4GB, permettant à la console d'exécuter le modèle Qwen3.8-27B fortement quantifié.
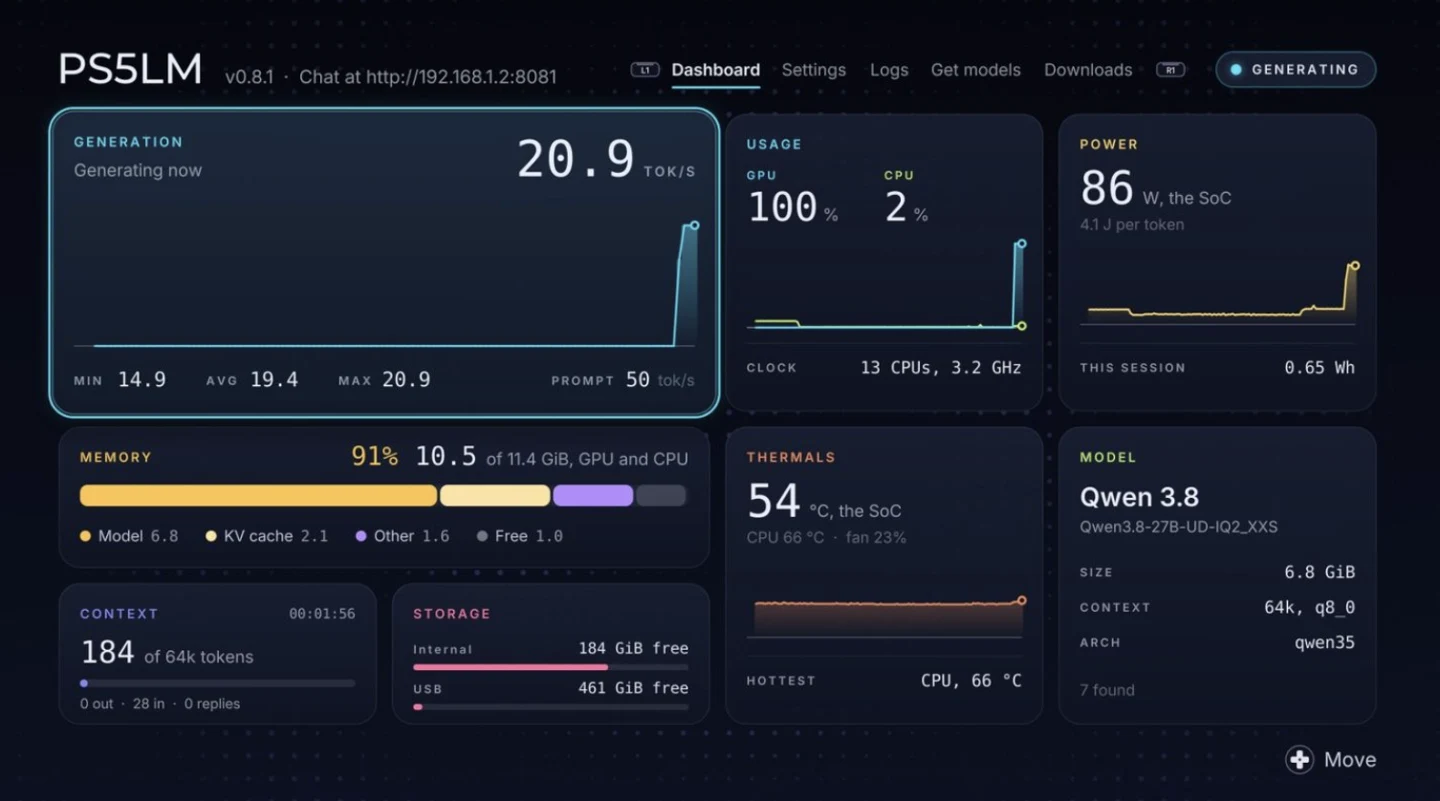
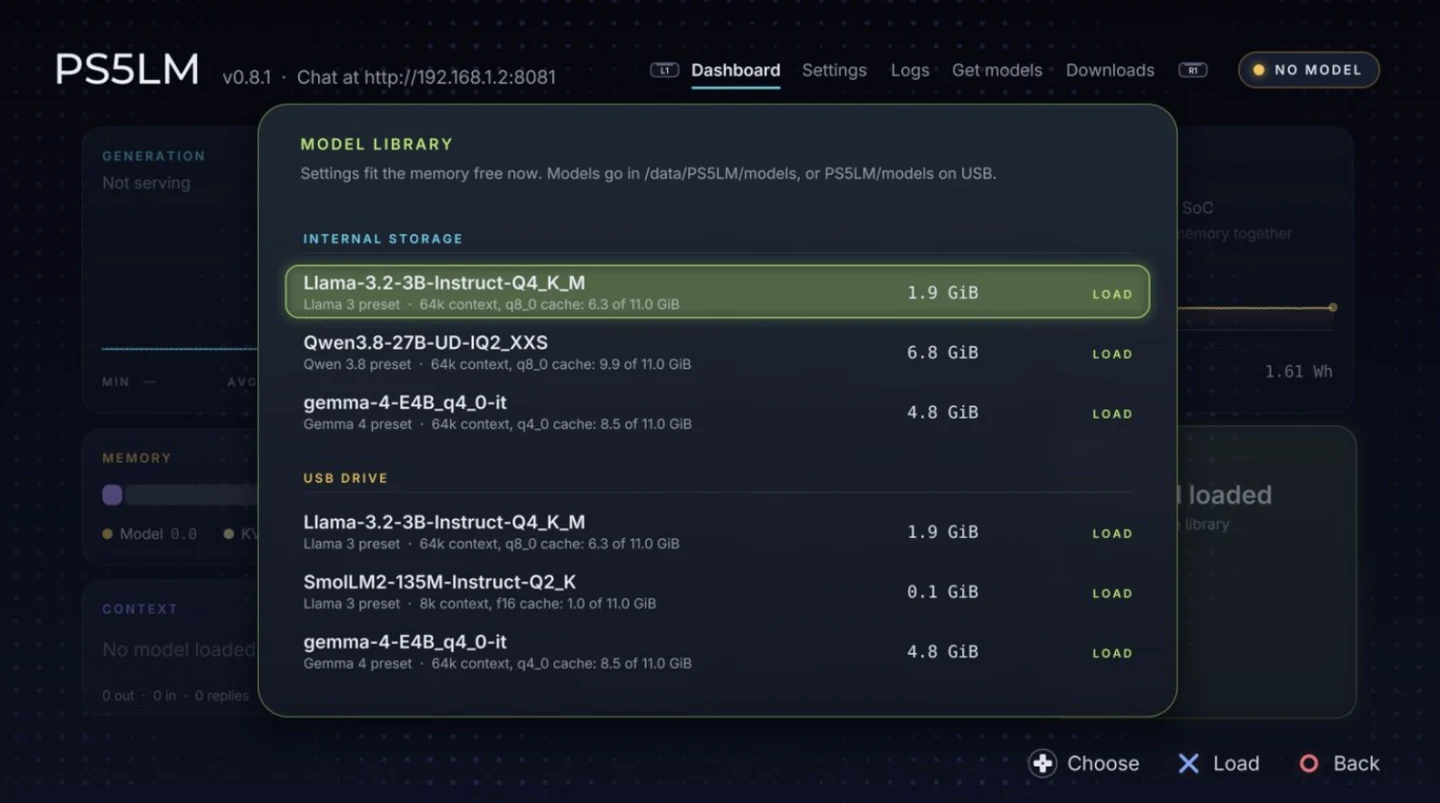
Grâce à la bande passante mémoire élevée de la PS5 (448 Go/s), la vitesse de génération de Qwen3.8-27B peut atteindre 20,9 tokens par seconde. Pendant les tests, l'utilisation du GPU a atteint 100 %, tandis que celle du CPU n'était que de 2 %. Pour les modèles de plus petite taille, la PS5 peut atteindre des vitesses de génération encore plus élevées : par exemple environ 61 tokens par seconde pour Gemma 4 E4B et jusqu'à 124 tokens par seconde pour Llama 3.2 3B.
En plus d'utiliser le GPU de la PS5 pour accélérer l'inférence des modèles, PS5LM Plus intègre une interface de chat web et peut fournir un service API via le port 8081 du réseau local ; les utilisateurs peuvent accéder à la page depuis d'autres appareils du même réseau pour dialoguer avec le modèle exécuté localement. Le projet est également compatible avec les API OpenAI et Anthropic, facilitant l'appel du modèle exécuté sur la PS5 par des outils comme opencode, Codex ou Claude Code.
Pour une console principalement conçue pour le jeu, la PS5 peut servir de serveur IA local, offrant une accélération GPU pour l'inférence des grands modèles, ce qui démontre le potentiel de son matériel au-delà du jeu. Cependant, sa mémoire unifiée de 16 Go de RAM limite encore le choix des modèles et la qualité d'exécution. De plus, l'exécution de la version native de llama.cpp nécessite d'abord de jailbreaker la PS5, ce qui peut entraîner des risques tels que le bannissement de la console ou du compte PSN.