
Par Yishui et Luyu depuis Aofeisi
QbitAI | Compte officiel QbitAI
Tout concorde, tout est confirmé.
Il y a deux jours, après la « panne puis les compensations » de DeepSeek, certains ont deviné que D aurait une nouvelle annonce à faire ? ?
Et effectivement, tout le monde a bien attendu pour rien de moins que ça——Le nouveau modèle DeepSeek-V4.1-Flash-1017 arrive à toute vitesse sur le devant de la scène。
Après le passage au nouveau modèle,la toute nouvelle version 0.2.1 de DeepSeek Harnessa également été renforcée. Voici ce qu'en dit l'éditeur :
Le nouveau modèle a été spécifiquement optimisé pour DeepSeek Harness lors de son entraînement, améliorant les performances sur les tâches tout en réduisant le temps d'exécution, la consommation de sortie et les coûts en tokens.
Eh ben dis donc,un travail plus rapide, plus économique, et en plus plus performant!!
Par ailleurs, en plein week-end, D a aussi profité pour offrir quelques avantages :
Les utilisateurs éligibles qui se connectent pour la première fois à DeepSeek Harness peuvent directement recevoir un crédit de 6 yuans, sans aucun dépôt requis, valable 7 jours après réception。
Point important : le montant est distribué en quantité limitée, jusqu'à épuisement des stocks (euh euh, je dois filer, j'ai un truc urgent~).
Des performances supérieures et, contre toute attente, des dépenses réduites
Après avoir récupéré l'offre, passons aux points forts de ce modèle (ceux qui se sont déjà connectés à Harness doivent d'abord se déconnecter avant de se reconnecter).
Actuellement, la version web officielle, l'APP et l'API ont toutes été synchronisées avec le nouveau modèle。
Par rapport à la version précédente V4.1 Flash, la version 1017 affiche des progrès quasi généralisés sur tous les benchmarks, avec des améliorations notables du code, des tâches Agent et d'autres capacités.
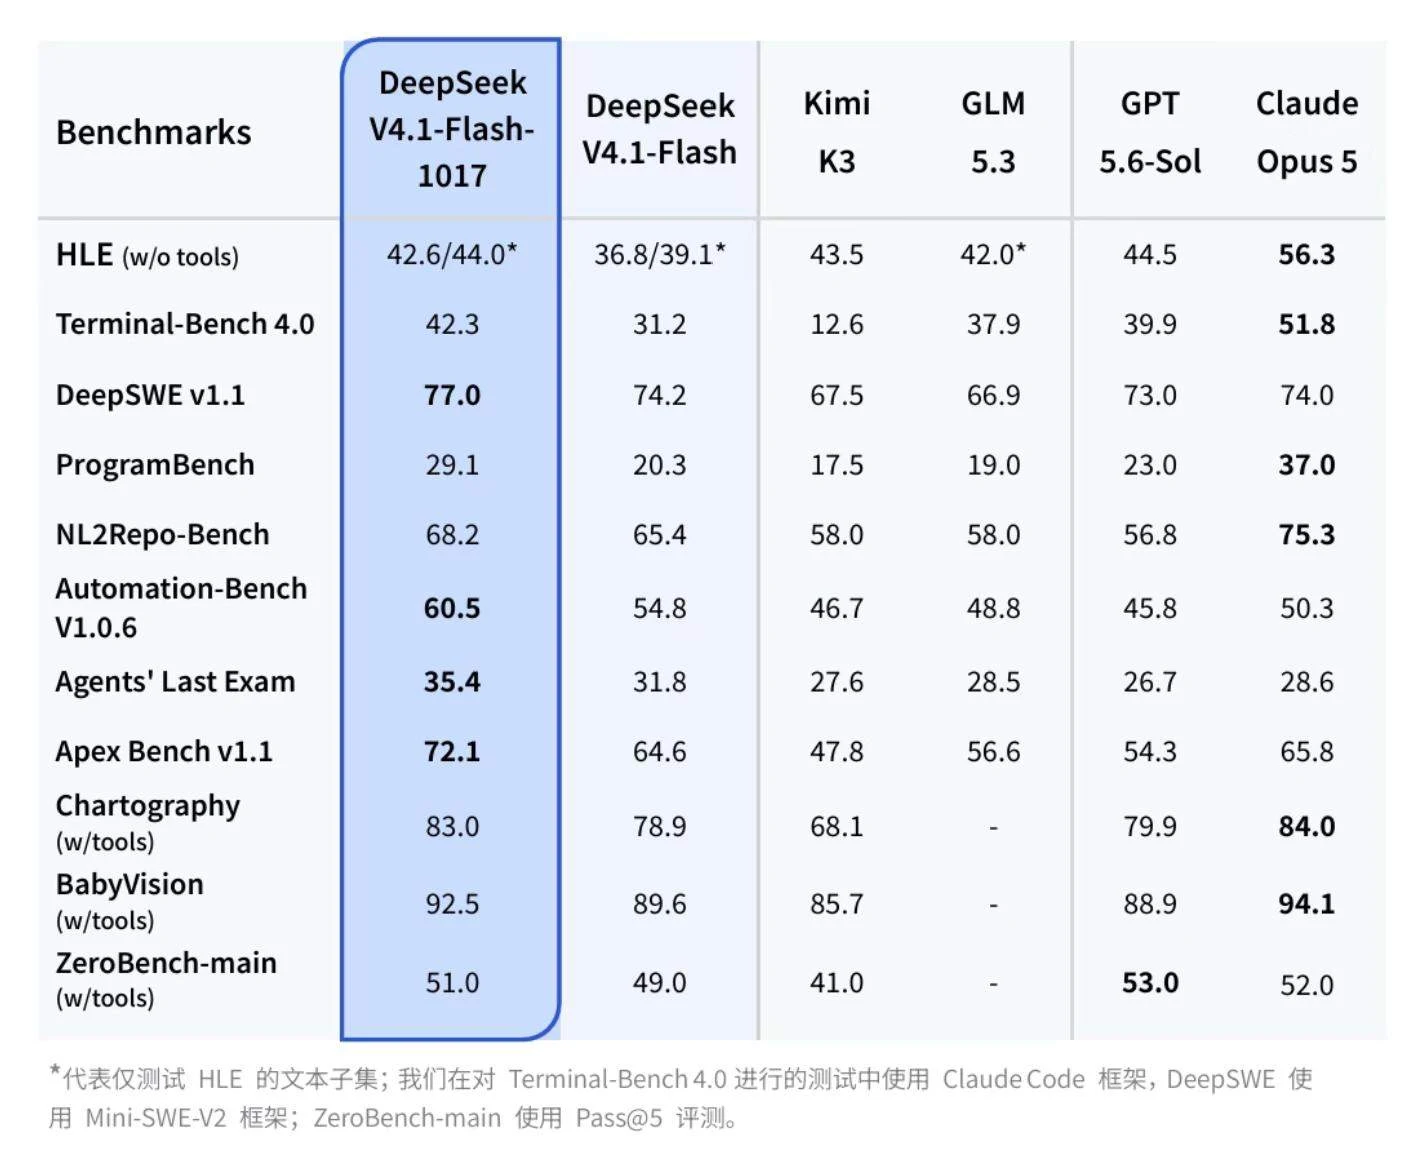
Mais la hausse des scores n'est pas la partie la plus impressionnante de cette mise à jour.
Car alors que les performances du modèle montent en flèche,le temps d'exécution des tâches et la longueur des sorties ont en réalité été réduits en même temps。
Hein ? Faire courir le cheval sans lui donner plus d'herbe à manger, c'est ça ??
L'éditeur appelle cela une « amélioration de Pareto performances-coûts » : auparavant, pour qu'un Agent travaille mieux, il fallait généralement accepter qu'il réfléchisse plus longtemps, fasse plus d'étapes et produise plus de Tokens.
Avec V4.1-Flash-1017, le modèle commence à essayer de prendre moins de détours, de parler moins pour ne rien dire, et de foncer droit vers l'accomplissement de la tâche.
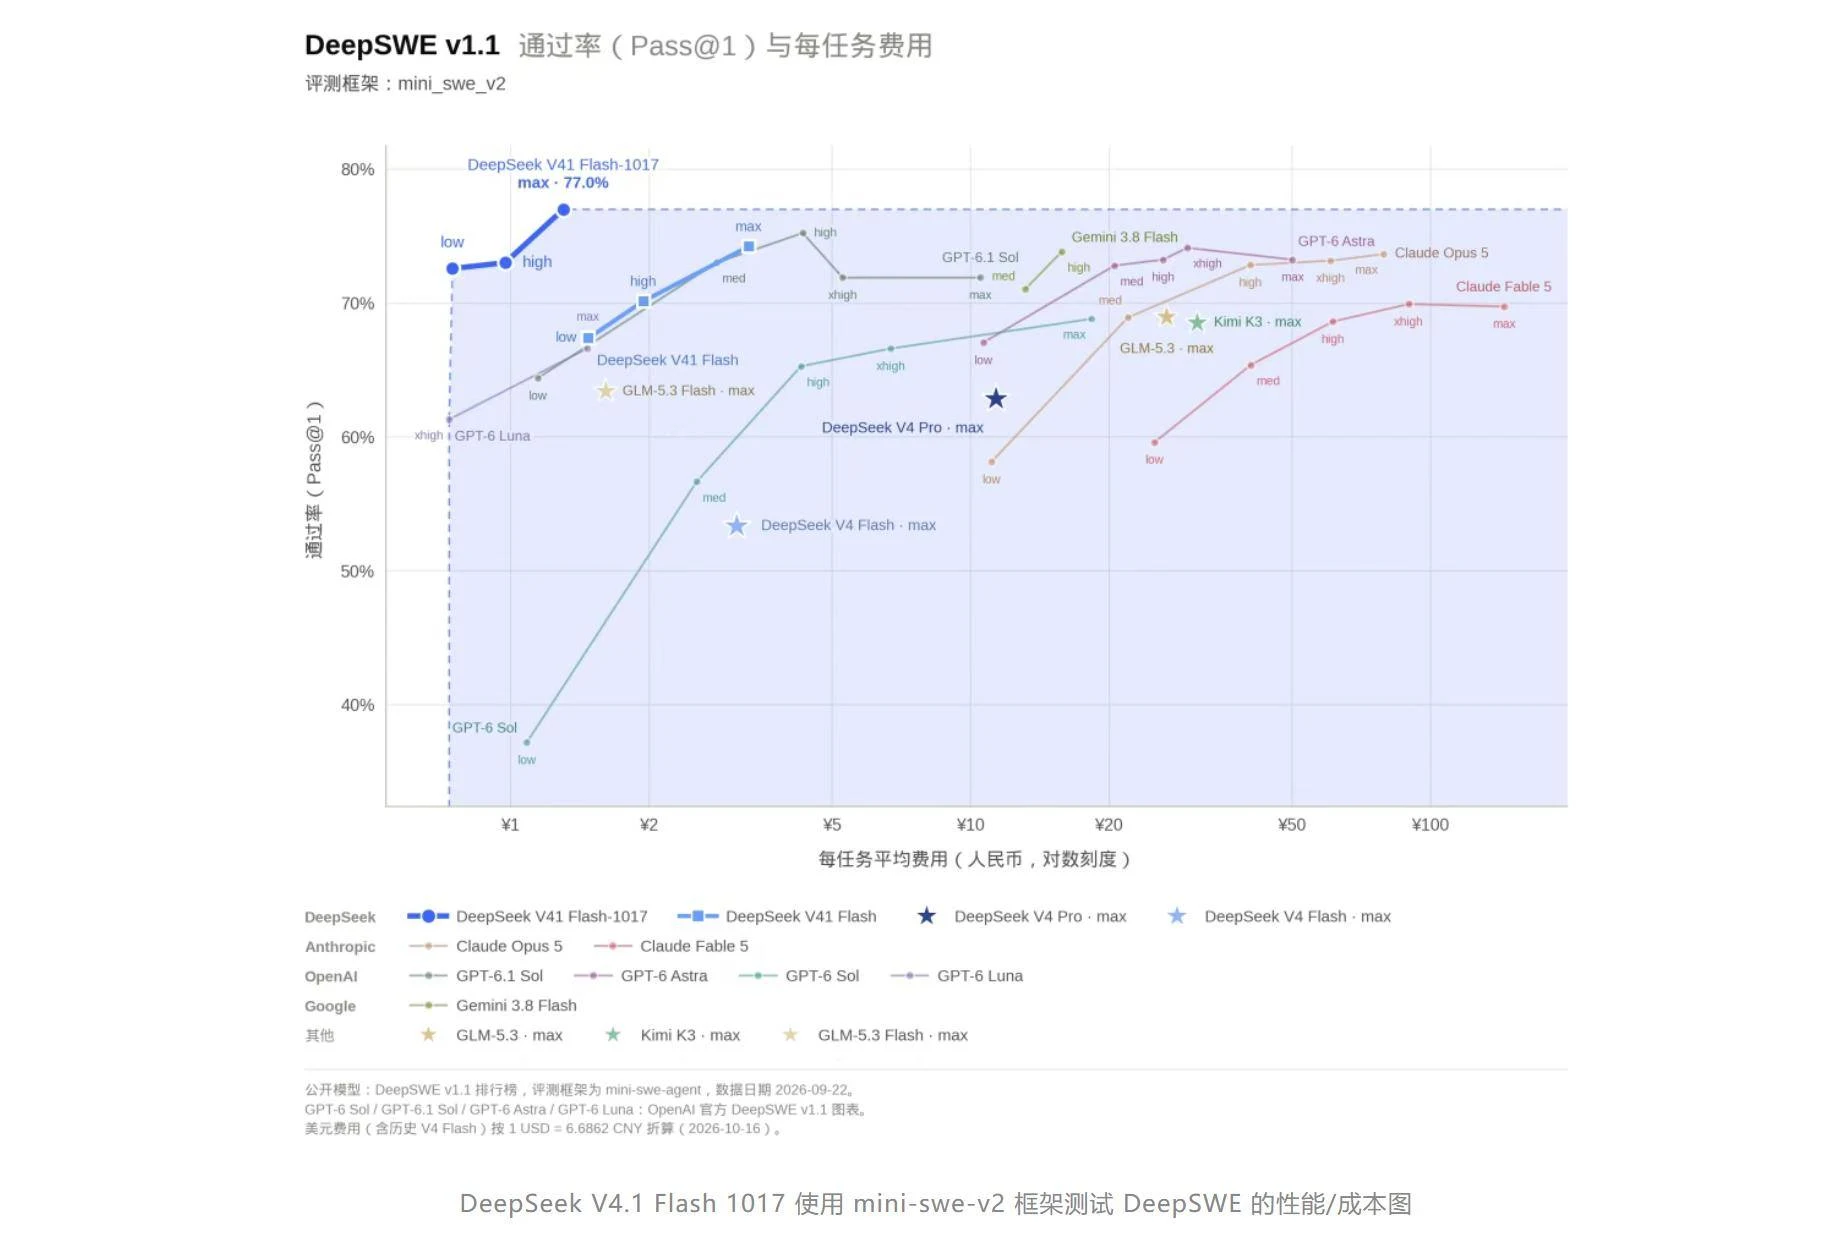
D'après les tests DeepSWE publiés par l'éditeur, V4.1-Flash-1017 a déjà repoussé davantage la frontière entre performance et coût sur plusieurs frameworks d'Agent.
Notamment DeepSeek Harness, CodeBuddy de Tencent et WorkBuddy, qui ont tous bénéficié cette fois d'une optimisation spécifique.
Pour l'instant, pour profiter pleinement de ces nouvelles capacités,DeepSeek Harness doit encore être mis à niveau vers la version 0.2.1-rc.1 ou supérieure。
« Programmation par vœux : un clic et le souhait se réalise »
Bien sûr, aussi beaux soient les benchmarks, rien ne vaut de voir directement ce qu'il peut produire.
Et cette fois, DeepSeek a préparé une nouveauté pour le V4.1-Flash-1017 dont le nom parle beaucoup aux internautes —
« Programmation par vœux »。
Comment ça marche, ce système de vœux ?
Avant, pour réaliser un projet complet, il fallait d'abord décomposer les fonctionnalités, la structure, les interactions et la pile technologique, et les expliquer une à une au modèle.
Désormais, l'utilisateur n'a qu'à exprimer clairement ce qu'il veut : la planification, l'écriture du code, l'exécution, la vérification et les modifications, le modèle s'en charge en poursuivant de lui-même.
La clé derrière cela,est un ensemble de techniques d'entraînement par apprentissage par renforcement basé sur l'auto-feedback。
Le modèle ne part pas tout de suite après avoir écrit la première version : il continue à vérifier ce qu'il a produit, détecte ce qui ne va pas, puis revient en arrière pour corriger.
Quels résultats cette méthode permet-elle d'obtenir ?
D'emblée, les officiels ont sorti un gros morceau : directement la Cité Interdite.
Le professeur D a directement construit, avec du code, une scène 3D permettant de naviguer en temps réel et de changer de point de vue.
Pas mal, alors que les autres font encore des Todo Lists en Vibe Coding, le professeur D a commencé à faire du Vibe sur la Cité Interdite...
Et ensuite, chacune était plus absurde que la précédente :
Un jeu de course sur navigateur qui se lance directement, une recréation de Portal 2 dans Godot réellement interactive, et un monde 3D dynamique allant de la préhistoire à l'époque moderne.
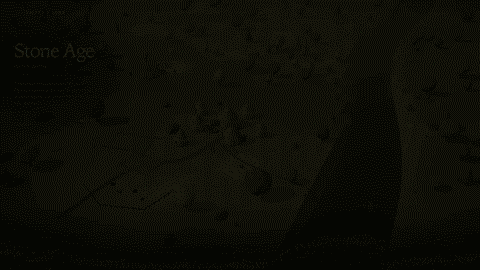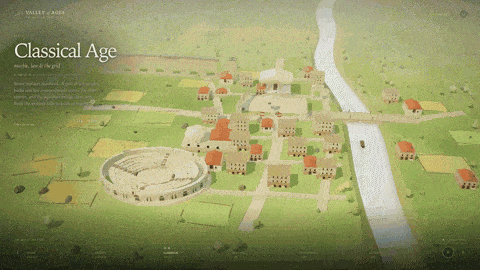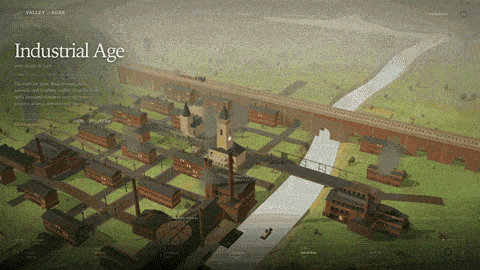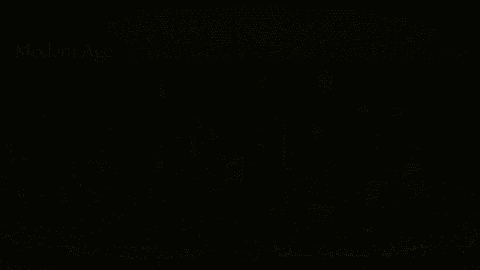
D'une simple phrase à un projet complet que l'on peut voir, animer et explorer.
« La programmation par vœux », et cette fois, le vœu du professeur D s'est réellement réalisé.
Fuite présumée avant la publication du modèle : « plus intelligent et aussi plus concis »
En réalité, DeepSeek-V4.1-Flash-1017 fuyait déjà depuis longtemps comme une passoire.
Il y a quelques heuresdes internautes attentifs avaient remarqué que « DeepSeek V4.1 Flash-1017 » était brièvement apparu dans la liste des modèles de DeepSeek.
Bien que sa mise en ligne soit récente, il a tout de même été pris sur le fait par ceux qui guettent les mises à jour.
« 1017 » correspond exactement au17 octobre, ce qui est également cohérent avec la méthode habituelle de DeepSeek consistant à marquer les instantanés de modèles avec des dates.
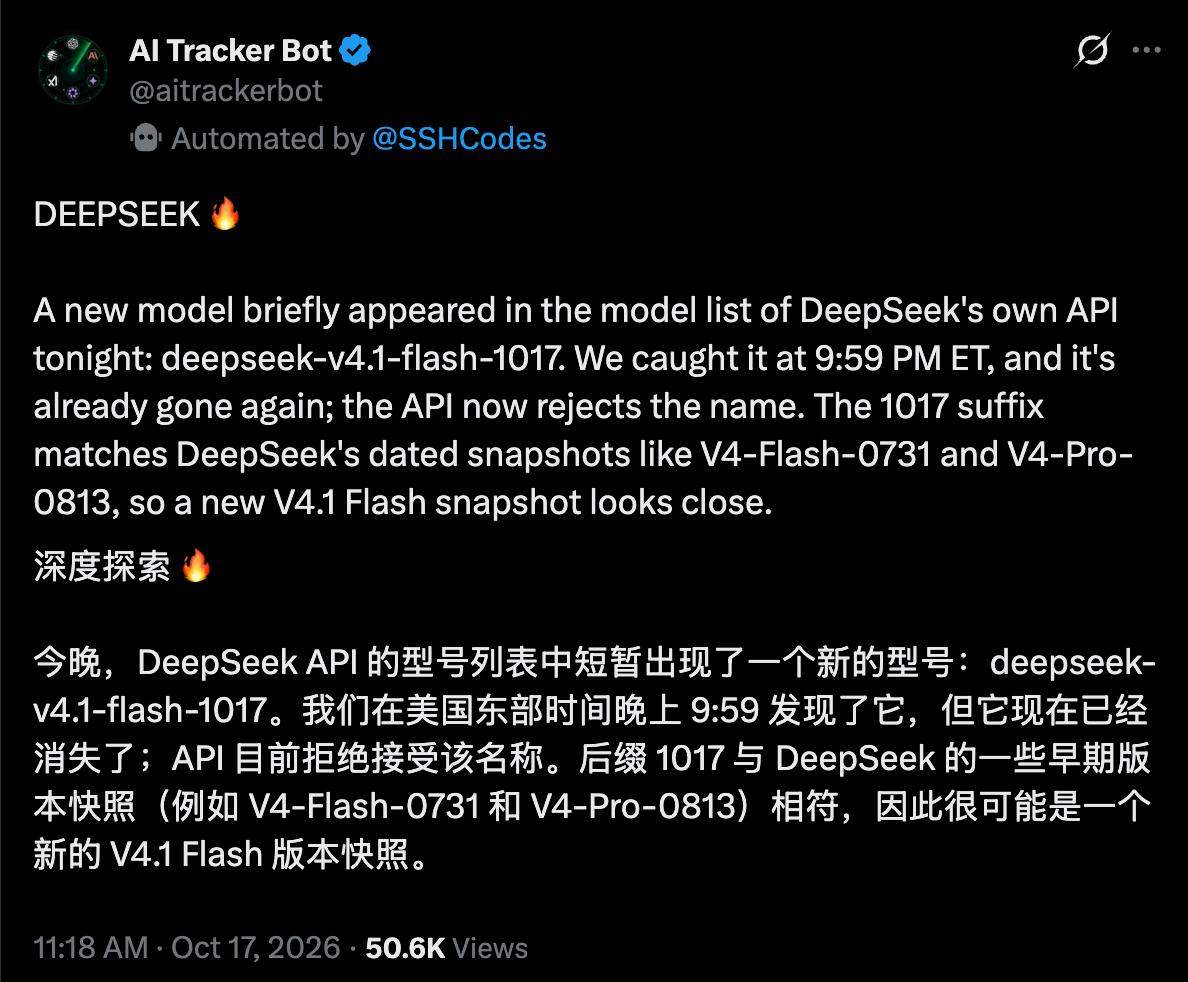
Immédiatement après, une autre preuve a fait surface.
Un internaute a découvert que l'empreinte système renvoyée par l'interface deepseek-flash est passée de «
aeb56401ca74e127821c4f9126dcb669 » à « e72d3c7f663d3e1383b00b3884cb4501 ».
Un changement d'empreinte système signifie généralement que la version du modèle ou la configuration de déploiement du service en arrière-plan a été mise à jour.
Après une série de tests, le consensus actuel est le suivant :
le nouveau modèle semble plus intelligent, plus rapide, et ses sorties sont également plus concises。
Le blogueur Chetaslua a constaté que les images générées par la nouvelle version à droite présentent des détails plus riches et des effets de lumière plus réalistes.
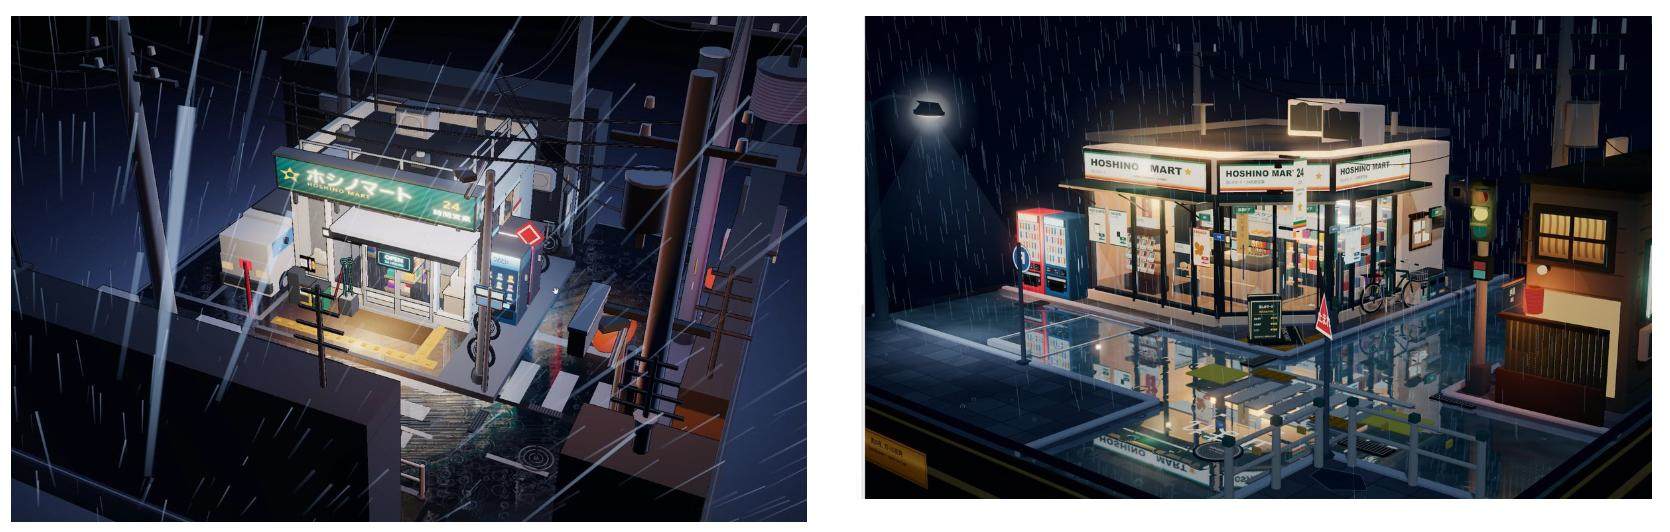
Les résultats générés à partir d'une simple phrase sont également très bons, avec en prime le processus de création détaillé.
L'auteur original indique que c'est plus fluide à utiliser queGemini 4 Argon.
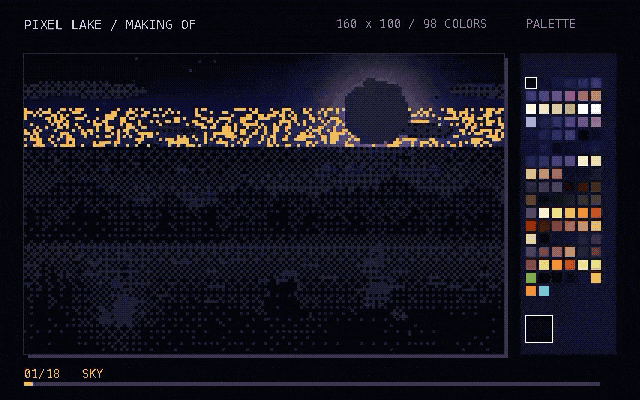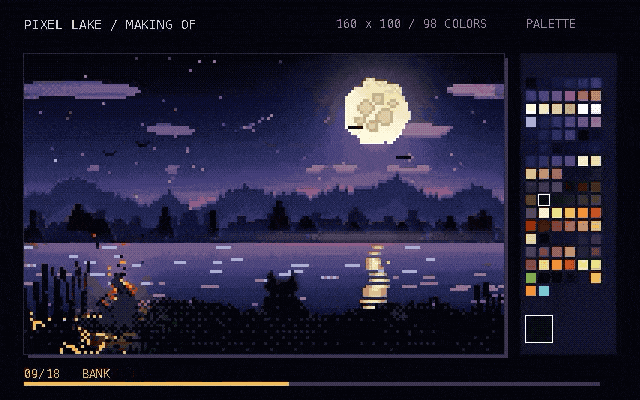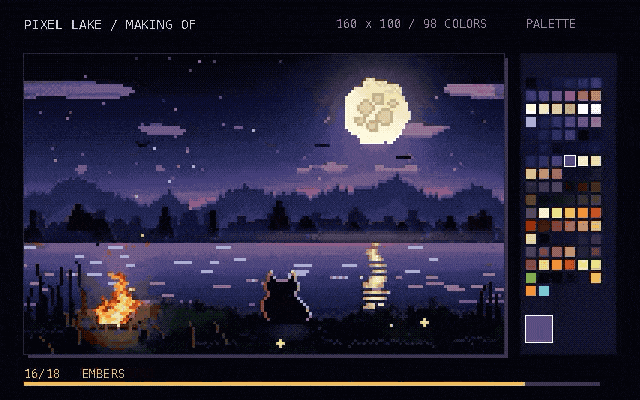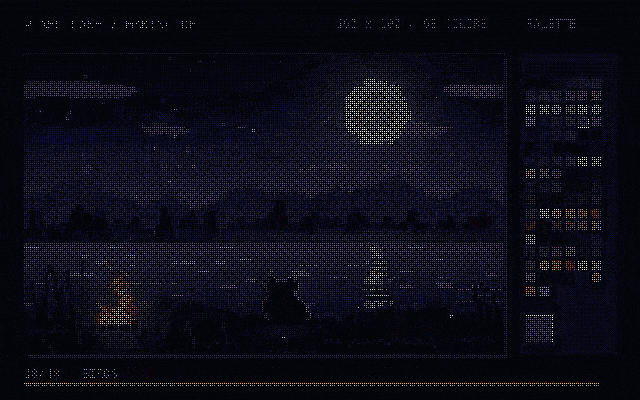
À en juger par davantage de résultats multimodaux, le nouveau modèle semble avoir renforcé sescapacités de génération 3D。
Les séries d'images publiées par le blogueur Hakm ont un effet vraiment bluffant, avec ce même genre de choc que l'on avait ressenti au lancement de GPT-6 Astra.
Il a aussi généré au passage, avec le modèle, un jeu de tir très classique.
Trop fort ! Cette fois, il y a vraiment de quoi voir.
L'API de recherche développée en interne est également ouverte
Ce n'est pas tout : cette fois, le gros poisson a aussi mis à notre disposition l'outil dédié permettant aux Agents de consulter des informations en ligne.
DeepSeek lance officiellement son moteur de recherche développé en interneSearchetFetchsont deux interfaces API : la première se charge de rechercher des pages web, la seconde sert à lire le texte intégral.
Les développeurs peuvent d'abord faire chercher des documents par l'Agent selon des mots-clés, puis extraire les pages web sélectionnées en texte Markdown, pour les confier ensuite au modèle afin qu'il poursuive l'analyse.
L'API Search permet en outre de restreindre la recherche par site, langue et date de publication : pour consulter les dernières actualités, on peut directement réduire le champ de recherche.
Les frais de facturation de cette partie sont également facturés séparément selon le nombre de requêtes réussies :
absolument dérisoire, chaque millier de requêtes réussies coûte5 yuans, soit une demi-centime par utilisation ; si la requête échoue, si la recherche ne donne aucun résultat ou si elle expire, rien n'est facturé.
Actuellement, les utilisateurs peuvent déjà y faire appel lorsqu'ils utilisent l'API DeepSeek dans DeepSeek Harness, Claude Code ou Codex, etOffre gratuite pour une durée limitée jusqu'au 1/11。
Honnêtement, le roi du rapport qualité-prix est de retour.
DeepSeek entre à nouveau dans le cycle de Liang Sheng.
HuggingFace :
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
ModelScope :
https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
Lien de référence :
[1]
https://mp.weixin.qq.com/s/X-5kbBkedQ5Oct9byUunag
[2]
https://x.com/aitrackerbot/status/2111295736411300047
[3]
https://x.com/yugen_matuni/status/2111336985554227345
[4]
https://x.com/hakmgpt/status/2111314470433947988
[5]
https://x.com/hakmgpt/status/2111314427416895798
[6]
https://api-docs.deepseek.com/guides/search/