
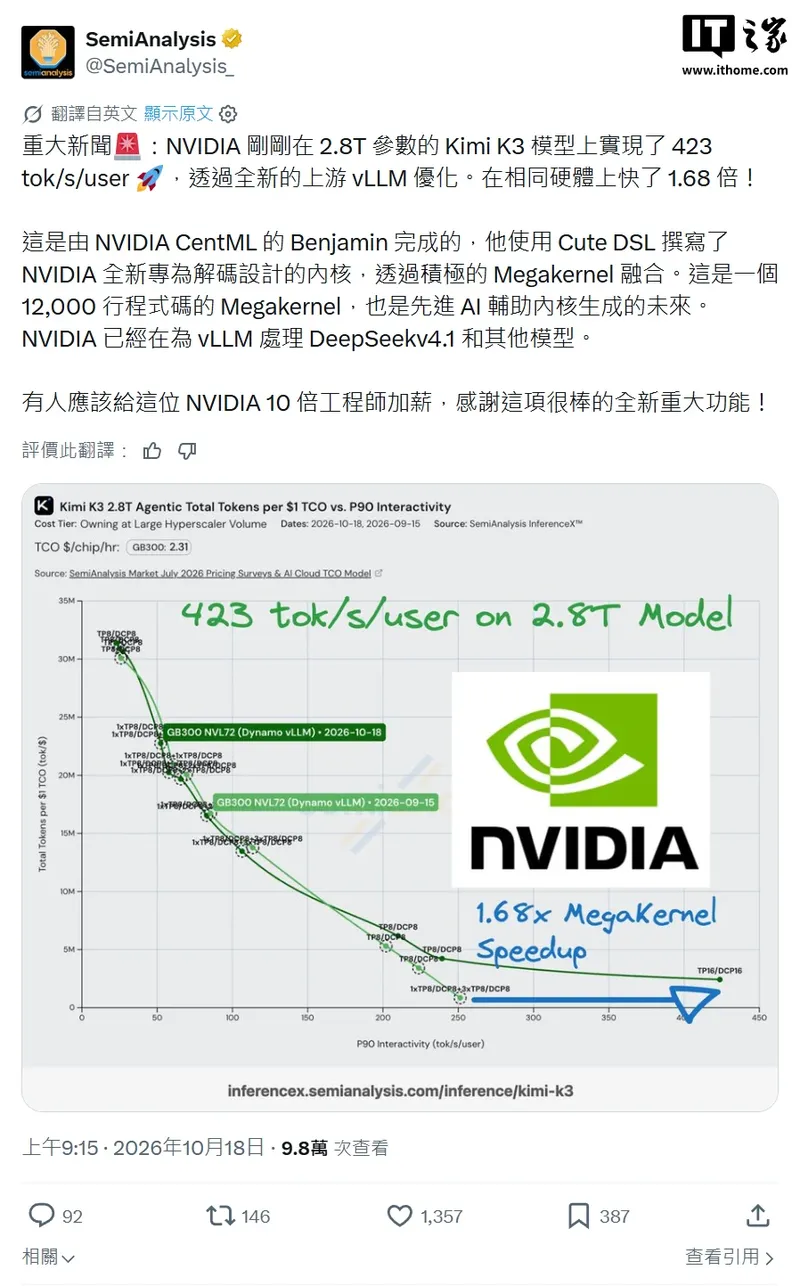
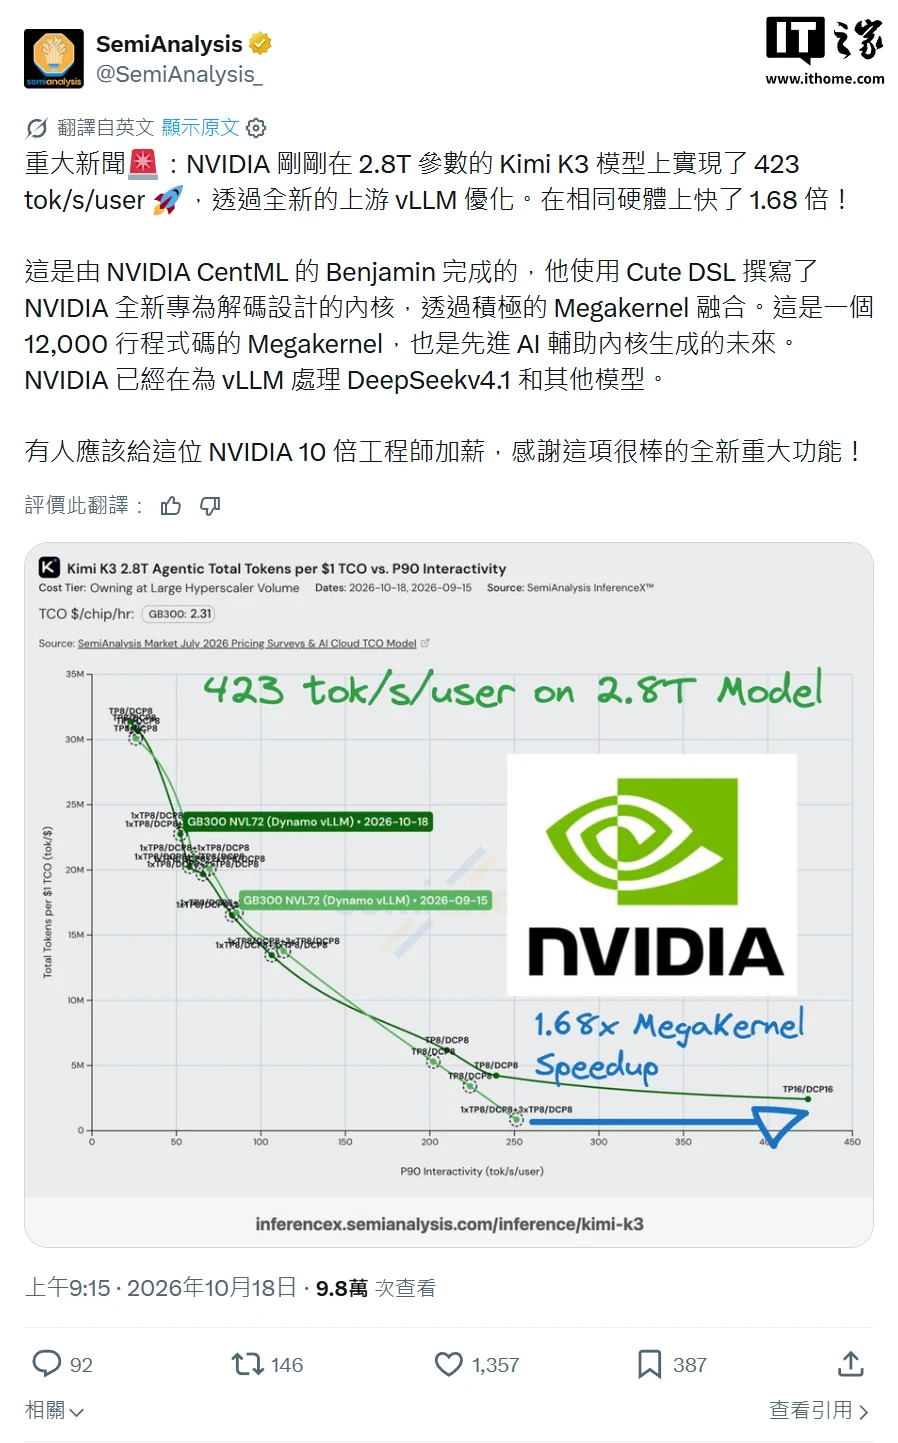
IT之家 le 18 octobre : selon un article publié aujourd'hui par le cabinet de recherche SemiAnalysis, NVIDIA a permis au modèle Kimi K3, comptant 2.8 billions de paramètres, d'atteindre une vitesse d'inférence de 423 tok/s/user (tokens par seconde par utilisateur),soit une amélioration des performances de 1.68 fois sur le même matériel (GB300 NVL72)。
Selon les informations, cette optimisation a été réalisée par Benjamin, ingénieur chez NVIDIA CentML. Elle repose sur une fusion Megakernel à grande échelle, utilisant Cute DSL pour écrire les nouveaux noyaux dédiés au décodage récemment lancés par NVIDIA.Ce Megakernel contient 12 000 lignes de code (1.2 万 lignes de code), ce qui représente la direction future de la génération de noyaux de calcul avancés assistée par l'IA. NVIDIA optimise la vitesse d'inférence du modèle Kimi K3, avec une amélioration de 1.68 fois.
IT之家 note qu'en plus de cela, NVIDIA développe également des optimisations pour vLLM concernant d'autres modèles tels que DeepSeek V4.1.