
En 2026, le secteur de l'IA connaît un virage intéressant. Alors que l'attention de l'industrie se concentre encore sur les paramètres des grands modèles, les agents intelligents et la superintelligence générale, Zuckerberg mise ses fonds sur un domaine bien plus épineux : les systèmes vivants.
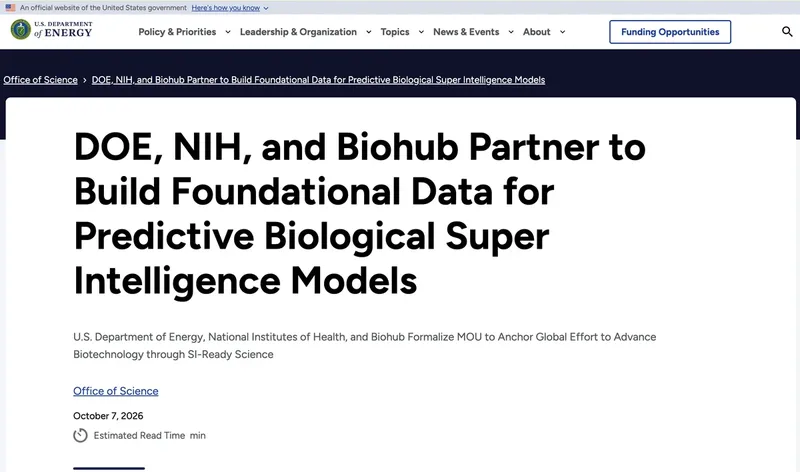
En avril de cette année, le Biohub fondé par Zuckerberg et sa femme Priscilla Chan a lancé un programme de biologie virtuelle, en investissant 500 millions de dollars pour mettre en place les capacités de données et d'expérimentation associées, afin d'entraîner des modèles d'IA capables de prédire les phénomènes biologiques. En octobre, ce projet s'est encore élargi. Le Département américain de l'énergie, les National Institutes of Health (NIH) et le Biohub se sont associés pour construire la base de données des modèles prédictifs du vivant, avec la participation de Meta, de Google DeepMind et d'Isomorphic Labs. Le projet représente au total un engagement de 1,8 milliard de dollars, dont plus de 500 millions de dollars sur cinq ans de la part du Département américain de l'énergie, tandis que les NIH ouvrent une grande quantité de données biomédicales accumulées.
L'objectif de ce projet est direct : créer une IA capable de prédire les comportements du vivant, ce que le Biohub appelle la biologie virtuelle. En termes simples, il s'agit de construire des versions numériques haute fidélité, depuis les molécules, les gènes et les cellules, jusqu'aux systèmes biologiques complets. À l'avenir, les chercheurs pourront, comme ils posent aujourd'hui des questions aux grands modèles, formuler des hypothèses sur le vivant et simuler des interventions sur ordinateur, réaliser d'abord des essais numériques, puis des expériences réelles en laboratoire.
Cet enjeu ne se limite pas à l'intérêt de Zuckerberg pour les biomédicaments. À un niveau plus profond, les sciences du vivant sont en train de devenir le deuxième champ de bataille de la compétition en IA. La course aux grands modèles généralistes s'est embrasée dans une surenchère de capital effrénée, avec des barrières toujours plus hautes en matière de puissance de calcul, de talents et de capitaux ; tandis que la compréhension des systèmes du vivant demeure une frontière encore en formation. Quiconque permettra à l'IA de véritablement lire le vivant bâtira une barrière bien plus difficile à copier que celle des chatbots.
L'IA excelle à concevoir des molécules, mais la mise au point de nouveaux médicaments reste difficile
L'association entre IA et biomédecine n'a rien de nouveau ; c'est même l'un des premiers domaines pour lesquels on a nourri des attentes d'industrialisation de l'IA. Mais après plus d'une décennie, une question centrale demeure : nous sommes-nous réellement rapprochés des nouveaux médicaments ?
Ces dernières années, les résultats les plus remarquables de l'IA pharmaceutique se sont concentrés au niveau moléculaire : prédiction des structures de protéines, criblage de molécules candidates, génération de molécules, prédiction de la sécurité des médicaments, interactions médicament-cible, etc. L'IA peut produire d'un seul coup des milliers de molécules candidates, élargissant considérablement l'espace chimique disponible au criblage ; le gain d'efficacité est bien réel.
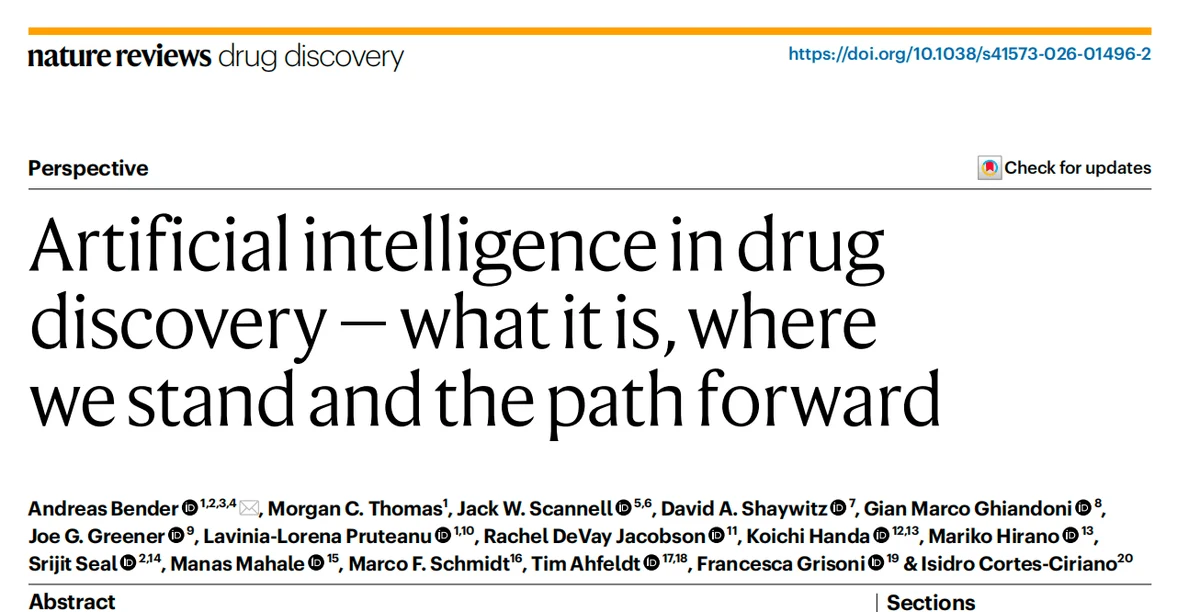
Mais si l'on déplace le critère d'évaluation des scores des modèles vers la mise sur le marché réussie d'un nouveau médicament, la réalité est moins optimiste. En août de cette année, la revue 《Nature Reviews Drug Discovery》 a publié un bilan de plus de dix ans d'IA pharmaceutique : bien que les algorithmes d'IA se soient multipliés, les résultats produisant une véritable valeur clinique restent limités. De nombreux projets d'entreprises pharmaceutiques IA stagnent en préclinique ou en essais de phase I ou II ; rares sont ceux entrés en phase III.
En matière de génération de petites molécules, l'IA trouve effectivement plus facilement des molécules capables de se lier aux protéines, mais il ne s'agit que de conception de ligands, pas de conception de médicaments. Trouver une molécule capable de se lier à une cible et trouver un médicament sûr et efficace dans le corps humain sont deux choses totalement différentes.
C'est là le point qui mérite le plus de réflexion dans le secteur aujourd'hui. Nous avons par le passé simplifié des problèmes biologiques complexes. L'IA est douée pour répondre à « quelle molécule peut se lier à cette cible », mais la vraie difficulté du développement de nouveaux médicaments réside dans une série de problèmes systémiques : pourquoi cette cible déclenche-t-elle la maladie ? Quelles réactions en chaîne l'ensemble du système biologique humain produira-t-il après l'intervention sur la cible ? Pourquoi le même médicament est-il efficace chez certains patients et pas chez d'autres ? Pourquoi des résultats excellents sur les cellules et les animaux se soldent-ils par des échecs en essais cliniques sur l'humain ?
Une molécule médicamenteuse n'agit pas de façon isolée. Elle entre dans un système dynamique et complexe : gènes, protéines, cellules, tissus, organes, immunité, métabolisme, sans oublier l'environnement extérieur, tous ces facteurs s'influencent mutuellement. La réussite ou non d'un médicament dépend précisément de ce système. D'où une question fondamentale : si l'IA ne comprend que les molécules, sans saisir le système biologique complet, jusqu'où peut-elle faire avancer le développement de nouveaux médicaments ?
Des modèles moléculaires ponctuels vers des modèles du monde vivant
Cela explique aussi le changement majeur de l'IA appliquée aux sciences du vivant en 2026 : l'échelle de modélisation ne se limite plus à une protéine, une molécule ou une cellule isolée, elle s'étend vers le haut pour construire des modèles prédictifs du vivant. L'objectif n'est plus seulement de prédire la structure des protéines, mais de décrire les états du vivant, d'anticiper les évolutions du système après une intervention, de simuler les réactions des cellules face aux perturbations — ce que le secteur appellemodèle du monde vivant。
Les grands modèles de langage apprennent les régularités du langage, les modèles du monde physique apprennent les règles du mouvement des objets et de l'espace ; les règles auxquelles sont confrontés les modèles du monde vivant sont bien plus complexes. Les mutations génétiques modifient l'expression des protéines, les protéines régulent les voies de signalisation, les signaux changent l'état des cellules ; les interactions entre cellules forment les microenvironnements tissulaires, qui influencent par paliers les organes, voire l'organisme entier. La vie n'est pas statique : elle croît, vieillit, développe des mécanismes de compensation, subit des mutations, et répond continuellement aux interventions extérieures.
Le modèle du monde vivant n'est donc pas une encyclopédie statique de la vie. Son cœur de métier est de comprendre comment la vie fonctionne et de prédire comment l'ensemble du système évoluera lorsqu'une variable est modifiée.
Une fois ce modèle opérationnel, la position de l'IA dans la recherche pharmaceutique changera complètement. Ancien modèle : étant donné une cible, trouver rapidement des molécules candidates. Nouveau modèle : étant donné une maladie, d'abord en élucider les causes profondes, puis déterminer où intervenir et quels patients en bénéficieront, et anticiper les réactions en chaîne induites dans tout l'organisme. Dans les deux cas l'IA assiste le développement de médicaments, mais les problèmes à résoudre sont déjà totalement différents.
La Chine avance en parallèle : la médecine computationnelle inscrite dans la planification nationale
Cette transition n'est pas l'apanage des États-Unis ; l'IA appliquée aux sciences du vivant en Chine passe elle aussi d'algorithmes ponctuels à la modélisation des maladies systémiques.
En septembre de cette année, dix administrations dont le Ministère de l'industrie et des technologies de l'information et la Commission nationale du développement et de la réforme ont publié le « Plan quinquennal pour le développement de l'industrie pharmaceutique (quinzième plan quinquennal) »,la médecine computationnelle figure pour la première fois aux côtés de l'IA, de l'informatique quantique et du supercalcul parmi les orientations technologiques prioritaires de l'industrie pharmaceutique pour les cinq prochaines années. L'IA et le supercalcul fournissent une puissante capacité de calcul généraliste ; la médecine computationnelle, elle, résout la question de savoir comment relier ces capacités de calcul aux systèmes biologiques pour résoudre de véritables problèmes de maladie.
En Chine, l'entreprise Zheyuan Technology suit précisément cette voie. Plutôt que de se contenter d'entraîner un encore plus grand modèle biologique, elle s'appuie sur les maladies elles-mêmes pour intégrer génome, caractéristiques cellulaires, mécanismes pathologiques, données de patients et informations sur les interventions médicamenteuses, en construisant des modèles de calcul multi-niveaux, dans le but de mettre en place un système de modèles du monde vivant capable de déduire, d'entraîner et de valider en continu.
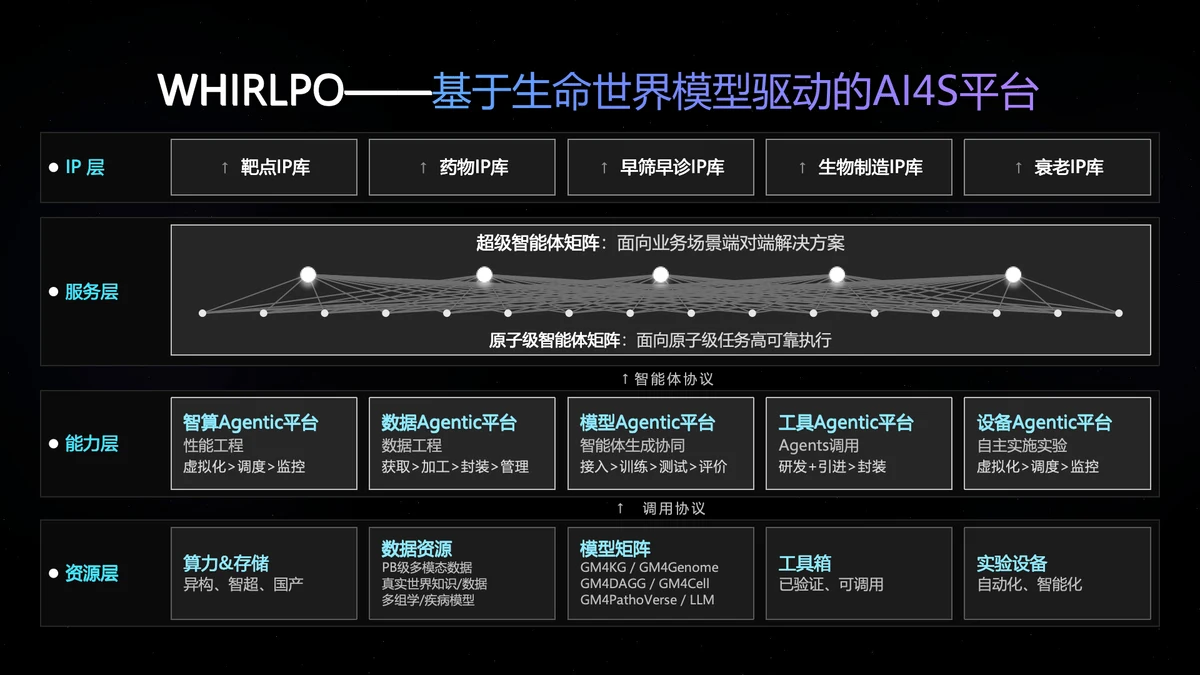
Le 17 octobre, Zheyuan Technology a lancé la plateforme de médecine computationnelle WHIRLPO. Ce n'est pas un modèle biologique indépendant, mais une solution à un problème d'ingénierie plus fondamental : si le modèle du monde vivant est l'infrastructure de la prochaine génération des sciences du vivant, il nous faut une base capable de soutenir l'entraînement et le fonctionnement de ce type de modèles.
Construire un modèle du monde vivant est bien plus difficile qu'entraîner un grand modèle de langage
La difficulté de mise en œuvre des modèles du monde vivant est facilement sous-estimée. Premièrement, le défi des données. Les grands modèles de langage disposent d'un immense corpus de textes internet comme nourriture, mais le domaine du vivant n'a pas de jeu de données unifié. Données génomiques, unicellulaires, d'omique spatiale, pathologiques, d'imagerie et cliniques proviennent de sources dispersées, avec des formats, des qualités et des échelles d'observation très différenciés. De nombreuses données à forte valeur nécessitent en outre des expériences spécifiques pour être produites. Une grande partie des 1,8 milliard de dollars investis par le Biohub servent précisément à produire des données biologiques, et non simplement à entraîner des modèles.
Deuxièmement, le défi de la modélisation multi-échelles. Il n'existe pas de modèle unifié du vivant. Étudier les mutations de l'ADN, l'état des cellules, les microenvironnements tissulaires ou les maladies humaines exige la coopération de modèles différents. Le futur modèle complet du monde vivant ne sera vraisemblablement pas un unique modèle géant, mais un système composite où modèles multiples, bases de connaissances et outils travailleront de concert.
Troisièmement, le défi d'ingénierie des calculs hétérogènes. Pré-entraînement des modèles, analyse omique, simulation de l'évolution des maladies, déduction sur des patients numériques : les modes de calcul diffèrent, et il faut pouvoir orchestrer avec souplesse des ressources de calcul de types CPU, GPU, etc., ce qui soulève des problèmes d'ingénierie de calcul scientifique à grande échelle que les grands modèles classiques rencontrent rarement.
Quatrièmement, les modèles du vivant doivent relier le monde du calcul et le monde de l'expérimentation réelle. Quand un modèle de langage se trompe, on peut simplement le réentraîner ; mais les hypothèses de cibles produites par un modèle du vivant doivent être vérifiées en laboratoire, et les résultats expérimentaux permettent en retour de corriger le modèle ; enfin, tout doit passer l'épreuve clinique — les conclusions du modèle ne peuvent pas rester auto-cohérentes uniquement dans l'ordinateur.
La plateforme WHIRLPO cible précisément ce point douloureux : intégrer la puissance de calcul hétérogène, les données de cycle de vie multi-groupes, la matrice de modèles, les outils de recherche scientifique, les Agents intelligents et la chaîne de validation expérimentale, afin de bâtir une infrastructure allant de l'entraînement des modèles et du calcul scientifique jusqu'à la validation en boucle fermée par expériences humides. En termes simples, Zheyuan ne se contente pas de créer des modèles : elle construit le socle de production des modèles du monde vivant.
L'IA en sciences du vivant entre dans la phase de la concurrence infrastructurelle
En 2026, une résonance sectorielle est apparue des deux côtés, aux États-Unis et en Chine. Aux États-Unis, Biohub s'associe au Département de l'Énergie, aux NIH, à Meta et à DeepMind pour construire les données, la puissance de calcul et l'infrastructure expérimentale nécessaires à l'IA du vivant ; en Chine, la médecine computationnelle est inscrite dans le plan quinquennal des industries pharmaceutiques et médicales du 15e plan, et les équipes locales commencent à construire des plateformes d'ingénierie pour les modèles du monde vivant.
Deux événements semblent indépendants, mais renvoient en réalité au même constat : l'IA appliquée aux sciences de la vie est passée de la compétition sur les indicateurs des modèles à l'ère de la concurrence des infrastructures.
Dans le passé, le secteur comparait la précision des prédictions de protéines, la qualité de la génération de molécules, ou la capacité à accélérer une étape donnée de la R&D. Au stade suivant, l'enjeu central devient : être capable d'obtenir des données de vie massives et de haute qualité ; être capable de modéliser à travers les différentes échelles du gène, de la cellule, du tissu et du corps humain ; être capable d'orchestrer la coordination de plusieurs modèles ; être capable de permettre aux modèles de s'améliorer en continu grâce à une boucle de validation avec de vraies expériences ; et finalement faire évoluer l'IA du traitement des données du vivant vers la compréhension des systèmes du vivant.
La découverte de médicaments par IA n'a pas eu une mauvaise direction au cours des quinze dernières années. Ce que nous avons résolu jusqu'ici, c'est seulement la partie des problèmes du vivant relativement facile à calculer. Les molécules sont certes importantes, mais les médicaments ne traitent pas des molécules, ils traitent des êtres humains. Entre une molécule candidate et un effet thérapeutique sur le corps humain, il y a tout un système du vivant complet et complexe.
Si le modèle du monde du vivant devient, après les modèles de langage et les modèles du monde physique, la prochaine direction centrale de l'IA, les plus grandes opportunités futures n'appartiendront pas nécessairement aux équipes qui améliorent légèrement les indicateurs de leurs modèles. L'actif véritablement rare n'est pas encore un modèle d'IA en biologie, mais une infrastructure complète permettant à l'IA d'entrer dans le monde réel du vivant.
Cet article est fourni par Zheyuan Technology ; Quantum Bit est autorisé à le republier, les opinions appartiennent à l'auteur original.