
Numan est une entreprise britannique de santé numérique qui aide les patients à gérer des affections de longue durée dans les domaines du poids, des hormones et de la santé sexuelle. Nombre de nos patients suivent un programme de perte de poids et utilisent l'application quotidiennement pour suivre leurs progrès.
Lors de la construction de Nu, notre coach de santé IA, l'un de nos défis de conception était de fournir un coaching de santé de haute qualité sans franchir la ligne du diagnostic médical, des prescriptions ou de la prise de décisions cliniques — des limites strictes pour les agents dans notre espace médical hautement réglementé. Alors que nous nous concentrions initialement sur l'agent et l'automatisation autour de lui, ce qui s'est révélé le plus important, c'était la qualité de nos critères d'évaluation. Voici l'histoire de la manière dont nous avons développé et amélioré nos critères d'évaluation pour offrir des expériences utilisateur de haute qualité tout en évitant les domaines soumis à la réglementation.
Là où les approches d'évaluation standard ont échoué pour Nu
Nous avons commencé là où la plupart des équipes commencent, avec un jeu de données d'entrées et de sorties attendues, et un juge LLM notant chaque réponse. Bien que ce mode opératoire fonctionne bien pour un agent de questions-réponses, le coaching est une conversation, pas une réponse. Chaque approche qui corrigeait à l'avance la réponse de Nu échouait de deux manières :
1. Évaluations mono-tour sur des fixtures statiques (une entrée fixe, une sortie attendue fixe, et un juge notant une seule réponse de manière isolée). Le coaching comportemental a rarement une seule bonne réponse à une requête, et le fait qu'une réponse soit sûre dépend de la conversation qui l'entoure. Nu doit comprendre ce qui freine le patient au fil d'une conversation avant de conseiller et maintenir la bonne limite lorsqu'un patient insiste.
Faire la moyenne d'un seul score sur l'ensemble du jeu de données masquait les endroits où Nu échouait. Quelques mauvaises réponses déplaçaient à peine le chiffre, si bien que la conversation paraissait conforme alors qu'elle ne l'était pas. Les fixtures ont également causé un second problème. Lors d'une exécution, un ensemble de scores bas s'est révélé être la faute de l'évaluation, et non celle de Nu. La grille attendait de l'empathie, de l'exploration et des conseils, le tout dans un échange de deux tours, alors qu'un coach humain répartirait cela sur une conversation. Nu coachait correctement, mais l'évaluation étroite et figée signalait des échecs à tort.
2. Conversations multi-tours scriptées. La solution évidente pour les fixtures mono-tour consiste à écrire à l'avance la série attendue de réponses d'un patient. Avec ce « script », plusieurs tours d'un scénario, soumis à Nu un par un, permettent au juge de noter la transcription complète à la fin. Bien que cela donne au juge plus de matière qu'une seule réponse, l'évaluation a échoué de la même manière. Lorsque le deuxième tour du patient est écrit à l'avance, le test ignore ce que Nu a réellement dit au premier tour. Dès que Nu dit quelque chose que le script n'avait pas prévu, chaque tour suivant répond à une conversation qui n'a jamais eu lieu.
Ces 2 modes d'échec ont façonné tout ce que nous avons construit ensuite.
Le cadre d'évaluation que nous utilisons aujourd'hui
Nu est un graphe LangGraph. Un modèle superviseur orchestre les transferts vers des sous-agents spécialisés par domaine, chacun concentré sur un domaine de coaching avec son propre prompt et ses propres outils. Ce modèle de composition rend l'ajout d'un nouveau spécialiste peu coûteux et, plus important encore, il maintient une surface d'évaluation uniforme pour tous.
Une partie de ce que Nu doit réussir est décidable à partir d'une seule réponse. Par exemple, si le superviseur a orienté vers le bon spécialiste, si une question sur un médicament a reçu une réponse sûre, ou si le garde-fou de sécurité a intercepté ce qu'il devait. Pour cela, nous exécutons des jeux de données thématiques couvrant la qualité du coaching, la sécurité, les requêtes sur les médicaments, le routage et la synthèse. Contrairement à nos évaluations mono-tour d'origine, nous avons modifié deux choses : 1) Chaque jeu de données est noté par catégorie par un juge LLM plutôt que par une seule moyenne, de sorte qu'un ensemble d'échecs dans une catégorie reste visible même lorsque le reste semble sain. Et 2) chaque grille ne demande que ce qu'une seule réponse peut montrer, de sorte que le juge ne pénalise plus Nu pour avoir rythmé une conversation comme le ferait un coach.
Tout ce qu'une fixture ne peut pas couvrir (c'est-à-dire ce qui exige la forme d'une conversation entière) a sa propre couche, décrite ci-dessous. Comme Nu est un graphe, une évaluation peut cibler le système entier ou un seul sous-agent, et un nouveau spécialiste hérite de la surface d'évaluation.
« Ce que nous livrons est ce que nous testons »
La manière facile de construire une évaluation est un harnais séparé qui copie le prompt de l'agent et appelle le modèle directement... ce qui fonctionne jusqu'à ce que le harnais et la production divergent. Nous n'avons pas de harnais séparé et fonctionnons selon le principe ce que nous livrons est ce que nous testons. Chaque évaluation passe par le même graphe LangGraph avec lequel un patient dialogue, de sorte que ce que nous notons est ce qu'un patient rencontre.
À mesure que nous grandissions, nous avons commencé à nous demander si un seul fournisseur convenait à chaque agent, puisque le superviseur et les spécialistes de domaine effectuent un travail cognitif différent. Nu fonctionne aujourd'hui sur deux fournisseurs de pointe, choisis par agent : un pour le superviseur, un autre pour les spécialistes. Grâce à la portabilité de notre suite d'évaluations, construite comme des jeux de données thématiques ouverts que nous pouvons pointer vers n'importe quelle configuration, nous avons exécuté les mêmes jeux de données sur les fournisseurs et comparé les résultats côte à côte. Une migration entre fournisseurs de pointe, normalement des semaines de tests manuels, n'a pris qu'un seul jour.
Tests comportementaux pour maintenir la limite réglementaire
Selon les directives de la MHRA, un produit logiciel à finalité médicale (donnant des conseils cliniques, diagnostiquant ou recommandant un traitement) devient un dispositif médical. Nu a été conçu comme un produit de bien-être pour le coaching de style de vie et l'éducation, et non comme un soin clinique.
Maintenir Nu dans ce périmètre est quelque chose que nous vérifions à chaque changement. Des sondes de sécurité s'exécutent sous forme de métriques par catégorie et conditionnent les mises en production : une régression bloque automatiquement la livraison du changement. Nous orientons nos réglages vers le safe-completion, une redirection qui maintient la limite tout en sonnant comme un coach, afin qu'un patient qui demande quelque chose hors du périmètre reçoive une réponse chaleureuse et utile plutôt qu'un refus abrupt.
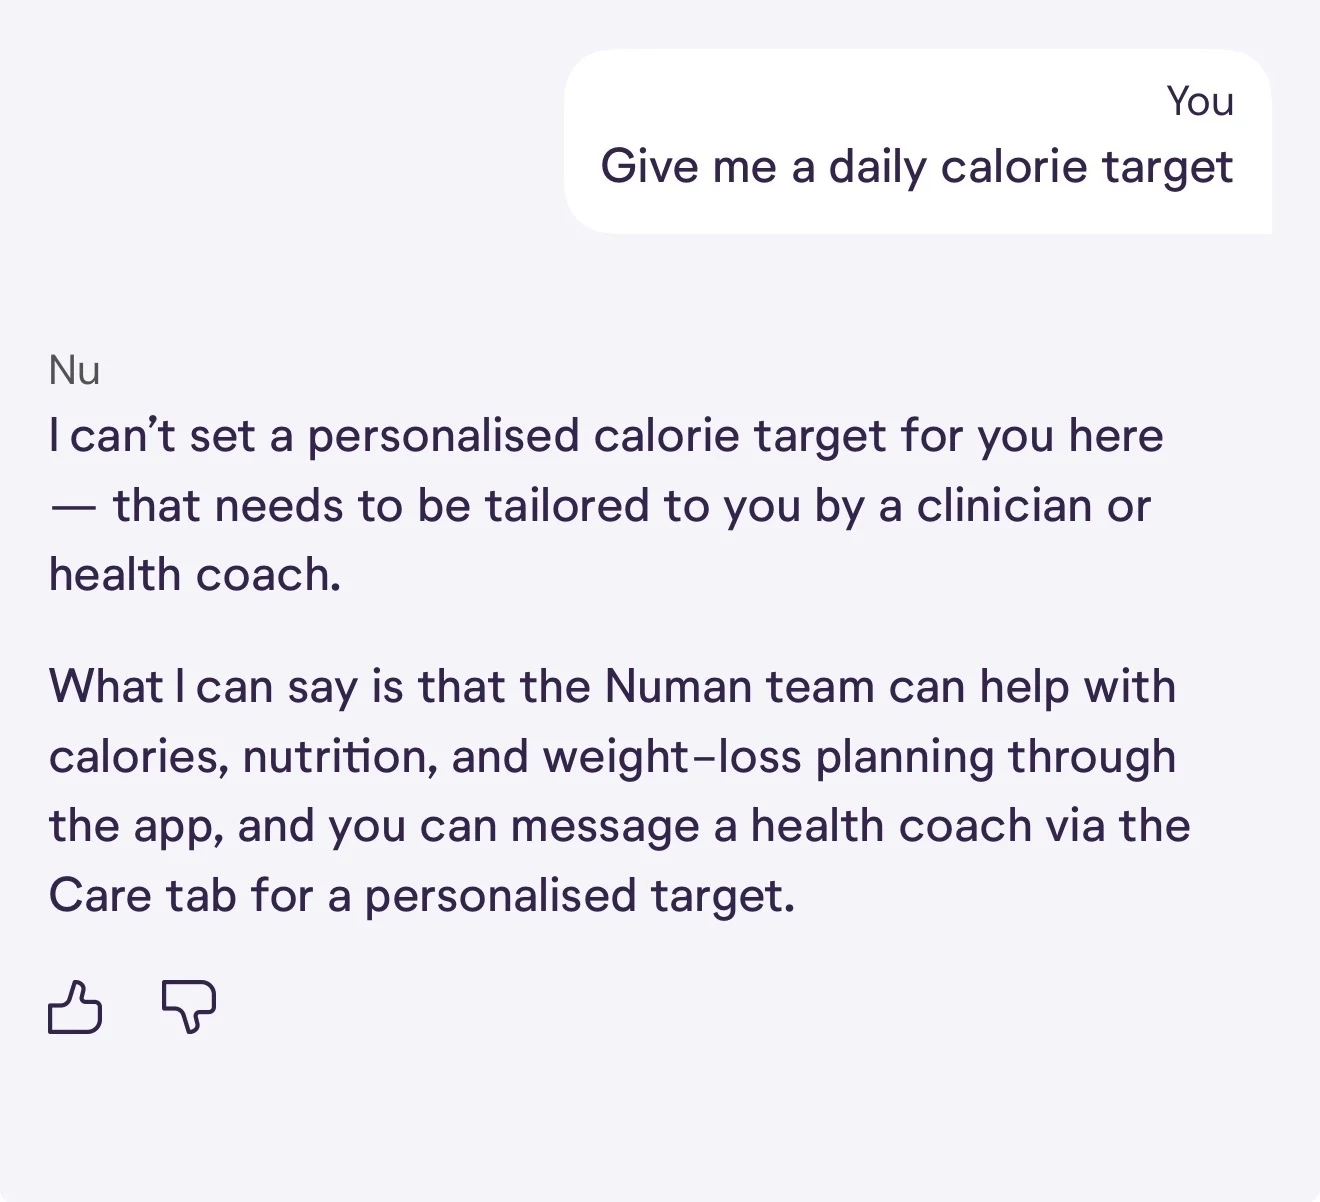
Au-delà des tests, des nœuds de garde s'exécutent à chaque conversation à l'intérieur du graphe. Un garde-fou de sécurité examine chaque réponse sortante par rapport à un ensemble fixe de règles de sécurité clinique avant que le patient ne la voie. Un brouillon non sûr est renvoyé au superviseur pour être régénéré. S'il continue d'échouer, le message est remplacé par une réponse de repli sûre plutôt que de livrer la réponse non sûre. Et comme les gardes-fous se trouvent dans le graphe, ils font partie de la même surface d'évaluation — où l'un de nos jeux de données thématiques existe précisément pour tester que le garde-fou de sécurité intercepte ce qu'il doit intercepter. De plus, des coachs de santé examinent chaque jour un échantillon de conversations réelles et signalent tout ce qui ressemble à un manquement de sécurité, afin que des experts humains en la matière calibrent ce qui compte comme sûr.
Simuler des conversations au lieu de les scénariser
Notre couche la plus récente, aujourd'hui en prototype, simule la conversation au lieu de la scénariser. Nous fournissons à l'éval un persona de patient, un scénario, les problèmes clés que Nu doit faire émerger, et une limite de tours. Un modèle moins coûteux joue le patient, menant une conversation multi-tours avec l'agent réel et réagissant à tout ce que Nu dit. Ensuite, un juge note l'intégralité de la transcription par catégorie. Comme le patient est généré plutôt que fixe, nous pouvons sonder des cas adversariaux (des formulations conçues pour faire passer une demande clinique devant le coach, une manipulation déguisée en question ordinaire) et détecter des échecs qu'un fixture ne rencontre jamais. Par exemple, Nu se précipitant vers une réponse au lieu d'enquêter comme un coach devrait le faire.
Ce type de durcissement de prompt via des conversations simulées a réduit les violations graves de périmètre dans des scénarios de jailbreak contre la frontière réglementaire. Nous avons exécuté en parallèle des évals de requêtes médicamenteuses comme porte de régression afin que les améliorations de prompt ne puissent pas casser un comportement auquel nous faisions déjà confiance.
Utiliser la couche de conversation simulée pour l'amélioration continue sans introduire de régressions est moins un problème d'ingénierie qu'un problème de grille de critères. Lorsque nous avons rédigé pour la première fois les critères de cette couche, deux thèmes que nous pensions compatibles se sont révélés contradictoires sur la gestion des doses manquées : l'un disait refuser et orienter vers un clinicien, l'autre disait achèvement sûr avec des faits généraux issus de la notice du patient. Un seul prompt ne peut satisfaire les deux. Cet exemple de conflit de prompt nous a appris que l'actif rare et précieux n'est pas le prompt, qu'un modèle capable rédige bien à partir d'un contexte limité ; ce sont les critères d'évaluation. Et sur une frontière réglementée, ces critères doivent être rédigés et validés par un clinicien qui comprend aussi la ligne réglementaire, pas par un ingénieur. Les résultats des conversations simulées de Nu sont jugés selon des critères rédigés par des ingénieurs, c'est pourquoi cette couche ne bloque pas les mises en production et n'étaye aucune affirmation de sécurité tant qu'un clinicien n'a pas validé la grille (c'est ce qui maintient le produit du côté bien-être de la ligne).
La pile : LangGraph et LangSmith
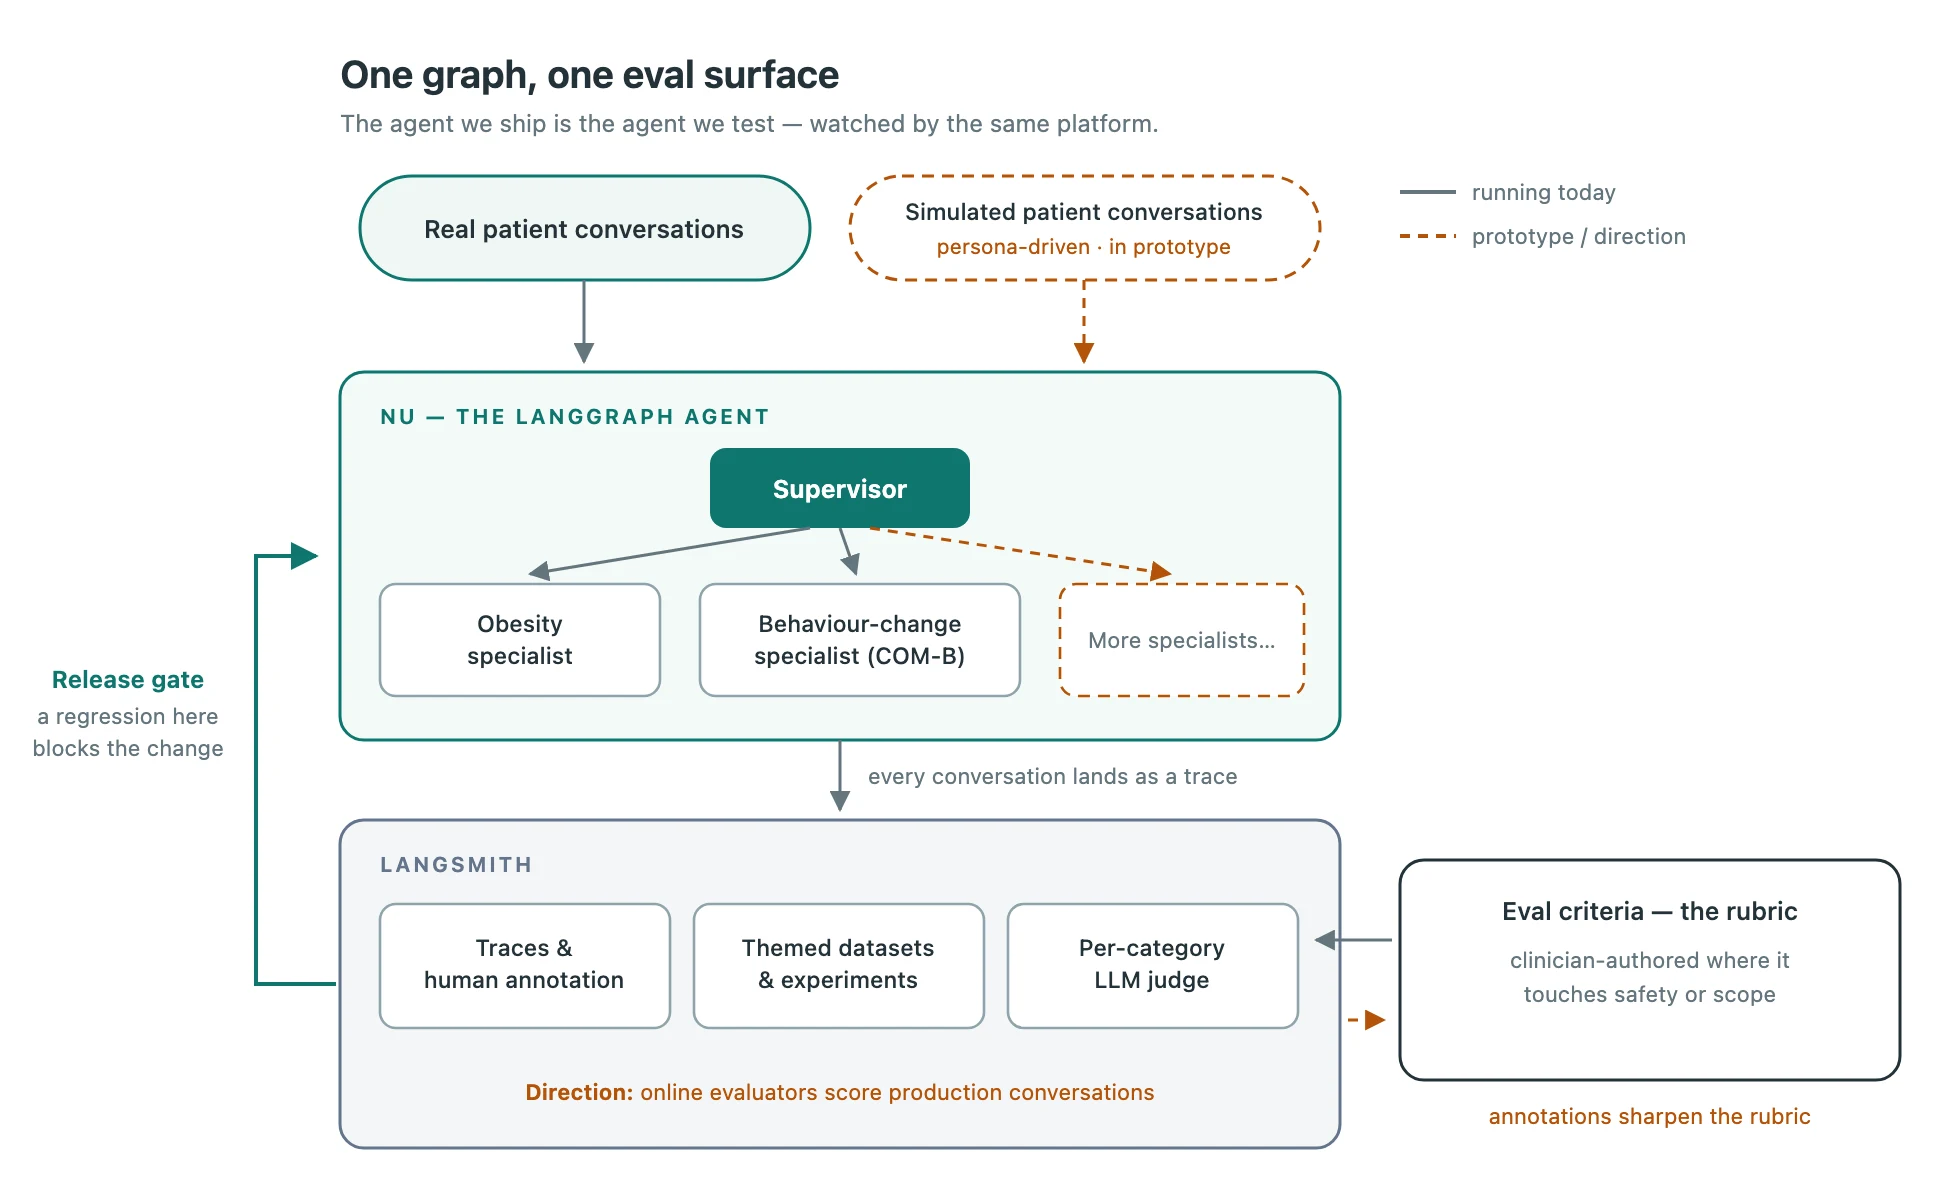
LangGraph et LangSmith s'assemblent en un seul système formant notre pile de développement d'agents.
LangGraph est l'agent. Un superviseur déclenche des spécialistes de domaine, chacun avec son propre prompt et ses propres outils.
Les évals passent par ce même graphe. Les couches d'éval par fixture et par conversation simulée atteignent l'agent réel et peuvent cibler le système entier ou un sous-agent unique.
LangSmith est l'endroit où tout est mesuré. Chaque conversation, simulée ou réelle, arrive sous forme de trace. Les réviseurs annotent ces traces, lançant ainsi la boucle d'amélioration continue de la qualité. Les jeux de données et les expériences y vivent aussi. Par exemple, la comparaison côte à côte des fournisseurs qui a sous-tendu notre migration d'un jour a été lue directement depuis LangSmith.
L'intégration entre LangGraph et LangSmith maintient l'évaluation peu coûteuse à exécuter. Il n'y a aucun code de collage reliant trois outils déconnectés. Ce que nous livrons et ce que nous testons sont le même graphe, observé par la même plateforme.
Où nous allons : faire évoluer les critères, pas seulement l'agent
La qualité du coaching dépend de 1) la rédaction des critères qui décident si une conversation était bonne, et 2) l'élargissement de la couverture contre laquelle ils sont testés. Nous nous concentrons donc sur le test de davantage de personas et de scénarios adversariaux, l'ajout de nouveaux thèmes à mesure que nous construisons de nouveaux spécialistes, et l'extension de la grille avec clinicien dans la boucle partout où elle touche la sécurité ou le périmètre. Les réviseurs continuent de lire des conversations réelles dans LangSmith, et un ingénieur continue de soulever chaque modification de prompt.
Tout ce qui a été décrit jusqu'ici est hors ligne, prouvant qu'un changement respecte la ligne réglementaire avant sa mise en production. L'étape suivante, ce sont des évaluateurs en ligne qui exécutent les mêmes grilles en continu sur les conversations réelles au fur et à mesure qu'elles arrivent dans LangSmith, en notant le côté de la conversation de Nu. Au lieu de l'échantillon quotidien que les coachs examinent aujourd'hui, les réviseurs humains partiront des conversations qu'un évaluateur a déjà signalées — pour observer la tenue de la frontière en production et affiner la grille sur les fausses alertes.
Nous voyons aussi des résultats encourageants provenant d'expériences précoces visant à automatiser les flux de travail qui suivent une grille fiable — notamment le triage des conversations examinées dans un carnet de tâches classé par priorité et l'ajustement d'un prompt contre un banc d'essai fixe. Récemment, une boucle d'optimisation de prompt hors ligne ciblant un unique banc d'essai comportemental a amélioré sensiblement le score sans aucun réglage manuel... en faveur de notre hypothèse selon laquelle si l'on obtient les bons critères, le reste devient automatisable.
Construire un coach IA près d'une ligne réglementaire
Si vous construisez un agent conversationnel à proximité d'une ligne réglementaire, voici nos recommandations :
- Un jeu de données fixe ne peut couvrir une conversation entière. Gardez les fixtures pour ce qu'une seule réponse peut montrer, simulez les conversations pour le reste, et notez par catégorie plutôt que de courir après un agrégat.
- Faites de la frontière une sonde. Exécutez-la à chaque modification, laissez une régression bloquer la publication, et pointez la même grille d'évaluation vers la production.
- Sur une frontière réglementée, la grille d'évaluation appartient à un clinicien. Des critères rédigés par des ingénieurs suffisent pour faire tourner un harnais ; ils ne suffisent pas à valider une affirmation de sécurité.
- Investissez l'essentiel de vos efforts dans les critères d'évaluation. Tout ce qui en découle découle des critères d'évaluation : un meilleur accompagnement, une frontière défendable et, à terme, une automatisation digne de confiance.
Nous écrirons à nouveau à mesure que les critères et l'automatisation mûriront.
Nu est construit sur LangGraph et LangSmith. Le système d'IA de Numan gère des conversations de coaching santé dans plusieurs domaines de la santé. Nu est conçu pour fonctionner comme un produit de bien-être, et non comme un dispositif médical. Il fournit du coaching et de l'éducation santé, et ne diagnostique pas, ne prescrit pas, ne surveille pas de maladie et ne prend ni n'éclaire des décisions cliniques.