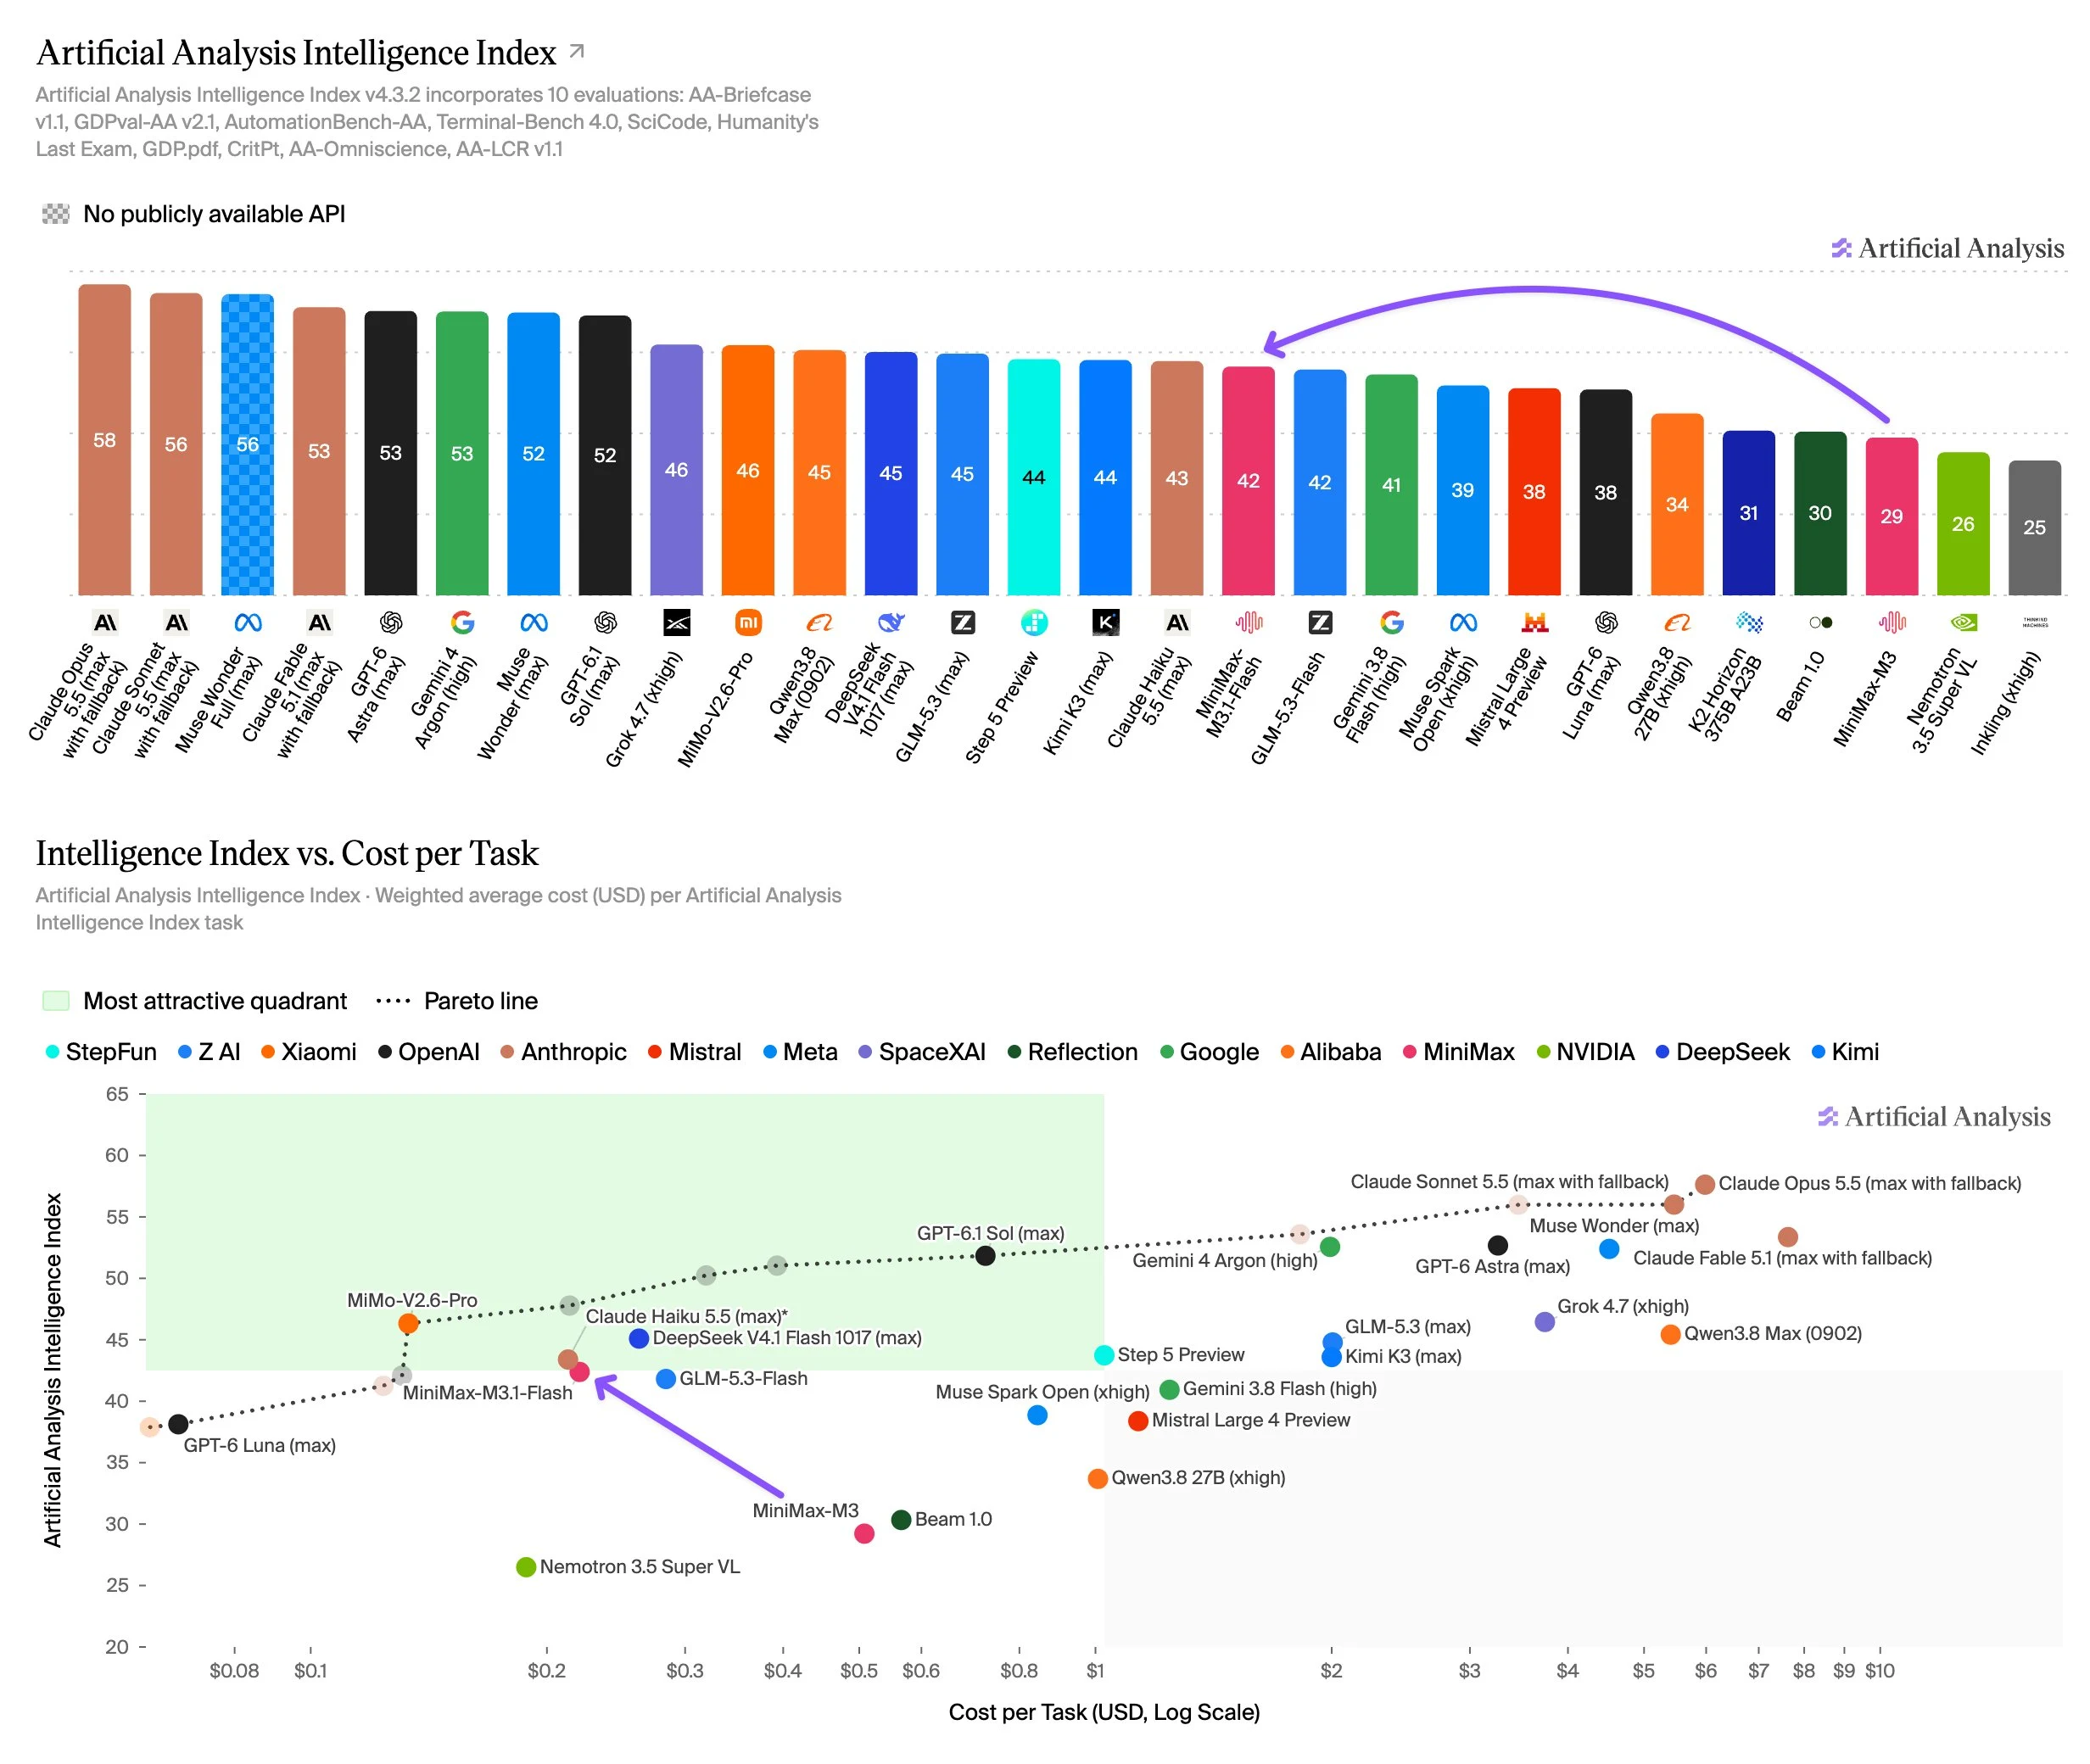
MiniMax-M3.1-Flash obtient un score de 42 sur l'Artificial Analysis Intelligence Index, soit 13 points de plus que MiniMax-M3 et moins de la moitié du coût par tâche. Il obtient un score égal à celui de GLM-5.3-Flash mais derrière DeepSeek V4.1 Flash 1017
MiniMax-M3.1-Flash est le nouveau modèle de raisonnement Flash de @MiniMax_AI, que nous avons évalué à son réglage d'effort maximal. Il obtient un score de 42 sur l'Artificial Analysis Intelligence Index, au niveau de GLM-5.3-Flash (max, 42), juste devant Gemini 3.8 Flash (high, 41), et derrière DeepSeek V4.1 Flash 1017 (max, 45)
Points clés :
➤ Raisonnement complexe nettement amélioré par rapport à M3 : MiniMax-M3.1-Flash obtient 48% sur Humanity's Last Exam, devant GLM-5.3-Flash (max, 40%) et DeepSeek V4.1 Flash 1017 (max, 43%), et au niveau de Gemini 3.8 Flash (high, 48%). Sur CritPt, il obtient 22%, devant GLM-5.3-Flash (15%) et Gemini 3.8 Flash (18%) et juste derrière DeepSeek V4.1 Flash 1017 (24%). Ce sont des progrès par rapport à MiniMax-M3 qui avait obtenu respectivement 39% et 4%
➤ Moins de tokens de sortie, coût par tâche plus faible : MiniMax-M3.1-Flash a utilisé environ 189M de tokens de sortie pour exécuter l'Intelligence Index, considérablement moins que GLM-5.3-Flash (max, ~324M), DeepSeek V4.1 Flash 1017 (max, ~224M) et Gemini 3.8 Flash (high, ~334M). Combiné à une tarification de $0.15/$0.60 par 1M de tokens d'entrée/sortie, cela porte son coût à environ $0.22 par tâche de l'Intelligence Index, contre ~$0.28 pour GLM-5.3-Flash, ~$0.26 pour DeepSeek V4.1 Flash 1017 et ~$1.24 pour Gemini 3.8 Flash, et moins de la moitié des ~$0.51 de MiniMax-M3
➤ Précision élevée sur AA-Omniscience, compensée par un taux d'hallucination élevé : MiniMax-M3.1-Flash répond correctement à 56% des questions sur AA-Omniscience, notre benchmark mesurant le rappel factuel et l'hallucination, contre 28% pour GLM-5.3-Flash (max) et 43% pour DeepSeek V4.1 Flash 1017 (max). Il tente presque toutes les questions, ce qui donne un taux d'hallucination de 93% et un score global de 16 sur AA-Omniscience
Détails clés du modèle :
➤ Fenêtre de contexte : 1M de tokens
➤ Multimodalité : entrée texte et image, sortie texte
➤ Tarification : $0.15/$0.60 par 1M de tokens d'entrée/sortie, avec une entrée en cache à $0.015/M
➤ Disponibilité : API première partie de MiniMax, MiniMax ayant annoncé une publication en poids ouverts le 23 octobre
➤ Licence : poids fermés actuellement, MiniMax ayant annoncé une publication des poids le 23 octobre