
vLLM est un moteur d'inférence et de service open source pour les grands modèles de langage (LLM). L'inférence des LLM comporte deux phases distinctes : le préfill, qui traite le prompt d'entrée et construit le cache clé-valeur (KV), et le décodage, qui utilise ce cache pour générer la sortie un token à la fois. Ces phases ont des caractéristiques de calcul, de mémoire et de mise à l'échelle différentes. La désagrégation préfill-décodage (P-D) les exécute sur des instances de moteur séparées, permettant à chaque phase d'être mise à l'échelle et optimisée indépendamment. Cela peut améliorer l'utilisation des ressources, le débit et la latence sous charge. Cependant, cela nécessite aussi de transférer le cache KV de l'instance de préfill vers l'instance de décodage avant que la génération de tokens puisse commencer, rendant un transfert KV efficace critique pour le time-to-first-token (TTFT).
L'un des moyens par lesquels vLLM effectue ce transfert est le connecteur NVIDIA Inference Xfer Library (NIXL), qui déplace les blocs KV sur des interconnexions prenant en charge l'accès direct à la mémoire à distance (RDMA), comme AWS Elastic Fabric Adapter (AWS EFA, le réseau RDMA à faible latence utilisé entre les serveurs dans AWS). Sur les types d'instances pris en charge, AWS EFA prend en charge GPUDirect RDMA et Neuron Direct RDMA. NIXL peut donc transférer les blocs KV directement entre la mémoire des GPU ou des appareils AWS Trainium sans passer par la mémoire de l'hôte. Le mode par défaut du connecteur NIXL est pull-based: après que l'instance de préfill a terminé le calcul du cache KV du prompt, le routeur relaie les métadonnées sources, y compris les ID de blocs de préfill, à l'instance de décodage. L'instance de décodage alloue alors les blocs de destination, prépare le transfert NIXL et initie un NIXL READ pour tirer les blocs KV de l'instance de préfill. Comme ces étapes de coordination et de préparation se produisent séquentiellement après le préfill et avant que le décodage puisse commencer, elles allongent le chemin critique du TTFT, comme le montre la chronologie suivante.
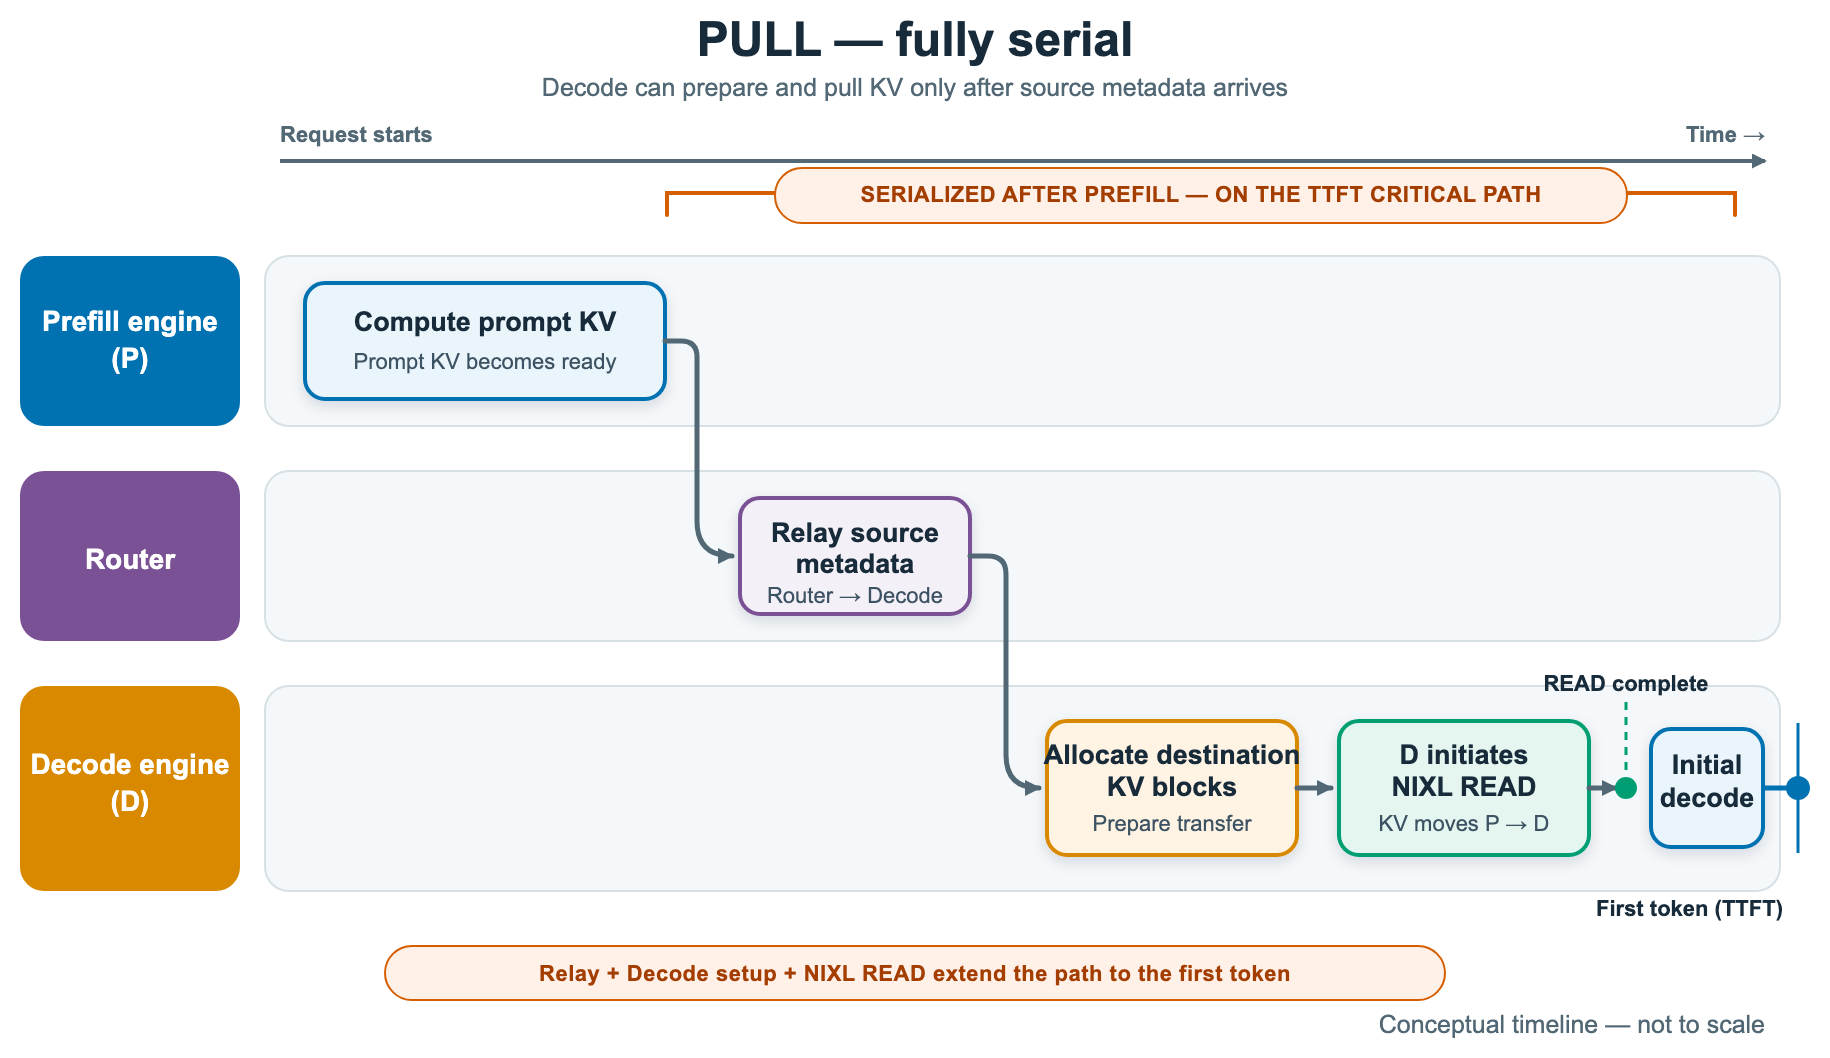
Figure 1 : Chronologie du transfert KV en mode pull, où le relais du routeur, l'allocation côté décodage et le NIXL READ s'exécutent en série sur le chemin vers le premier token
Cet article présente un connecteur NIXL en mode push qui sort la coordination et la préparation du transfert post-préfill du chemin critique. Si vous exécutez une inférence désagrégée préfill/décodage avec vLLM, le mode push peut améliorer la réactivité de l'application en réduisant le TTFT et le TPOT, en particulier à des taux de requêtes élevés.
Dans notre benchmark sur un déploiement 1P1D utilisant des instances Amazon Elastic Compute Cloud (Amazon EC2) P5en connectées avec EFA, le mode push a offert jusqu'à 3x de meilleur TTFT et jusqu'à 30 pour cent de meilleur time-per-output-token (TPOT) par rapport au mode pull (voir la section Performance data) pour le modèle Qwen3-32B. Les résultats dépendent de la charge de travail et de la configuration.
Nous avons construit et validé cette fonctionnalité sur des clusters d'instances AWS Trainium connectés avec EFA, puis nous l'avons contribué à vLLM en tant que fonctionnalité indépendante de l'accélérateur. Les résultats présentés ici proviennent d'un cluster Amazon EC2 P5en (GPU) avec EFA, montrant que les gains se reportent sur les GPU. Cet article explique l'architecture en mode push, le flux de transfert, le modèle de threading, les résultats de performance et comment reproduire le benchmark.
Transfert KV en mode push
Cette section explique la conception en mode push : son architecture, le protocole de transfert et le modèle de threading qui maintient le transfert KV hors du chemin critique.
Vue d'ensemble de l'architecture
Le transfert en mode push améliore le TTFT et le débit de décodage pour deux raisons :
- Il élimine la sérialisation du modèle pull en chevauchant le travail du producteur et du consommateur. L'instance de décodage enregistre ses blocs cibles à l'avance pendant que le producteur calcule encore le KV. Le transfert commence alors dès que les blocs du producteur sont prêts, plutôt qu'après un aller-retour de découverte d'ID côté consommateur, supprimant cet aller-retour du chemin vers le premier token.
- Il déplace le temps de préparation du transfert hors de l'instance de décodage. Cette préparation s'exécute côté préfill et sur un thread d'arrière-plan. Elle prépare les descripteurs NIXL et soumet le transfert, de sorte que l'instance de décodage ne dépense pas ces cycles pendant sa phase de génération de tokens critique pour la latence.
L'effet net est un TTFT plus faible et un débit de tokens de sortie plus élevé sur l'instance de décodage.
Le connecteur push coordonne trois acteurs : l'instance de décodage enregistre ses blocs cibles à l'avance, l'instance de préremplissage associe chaque requête et lance le transfert, et un thread d'arrière-plan dédié sort l'écriture KV de la boucle de passe forward du moteur. Le diagramme suivant montre comment ces éléments s'articulent.
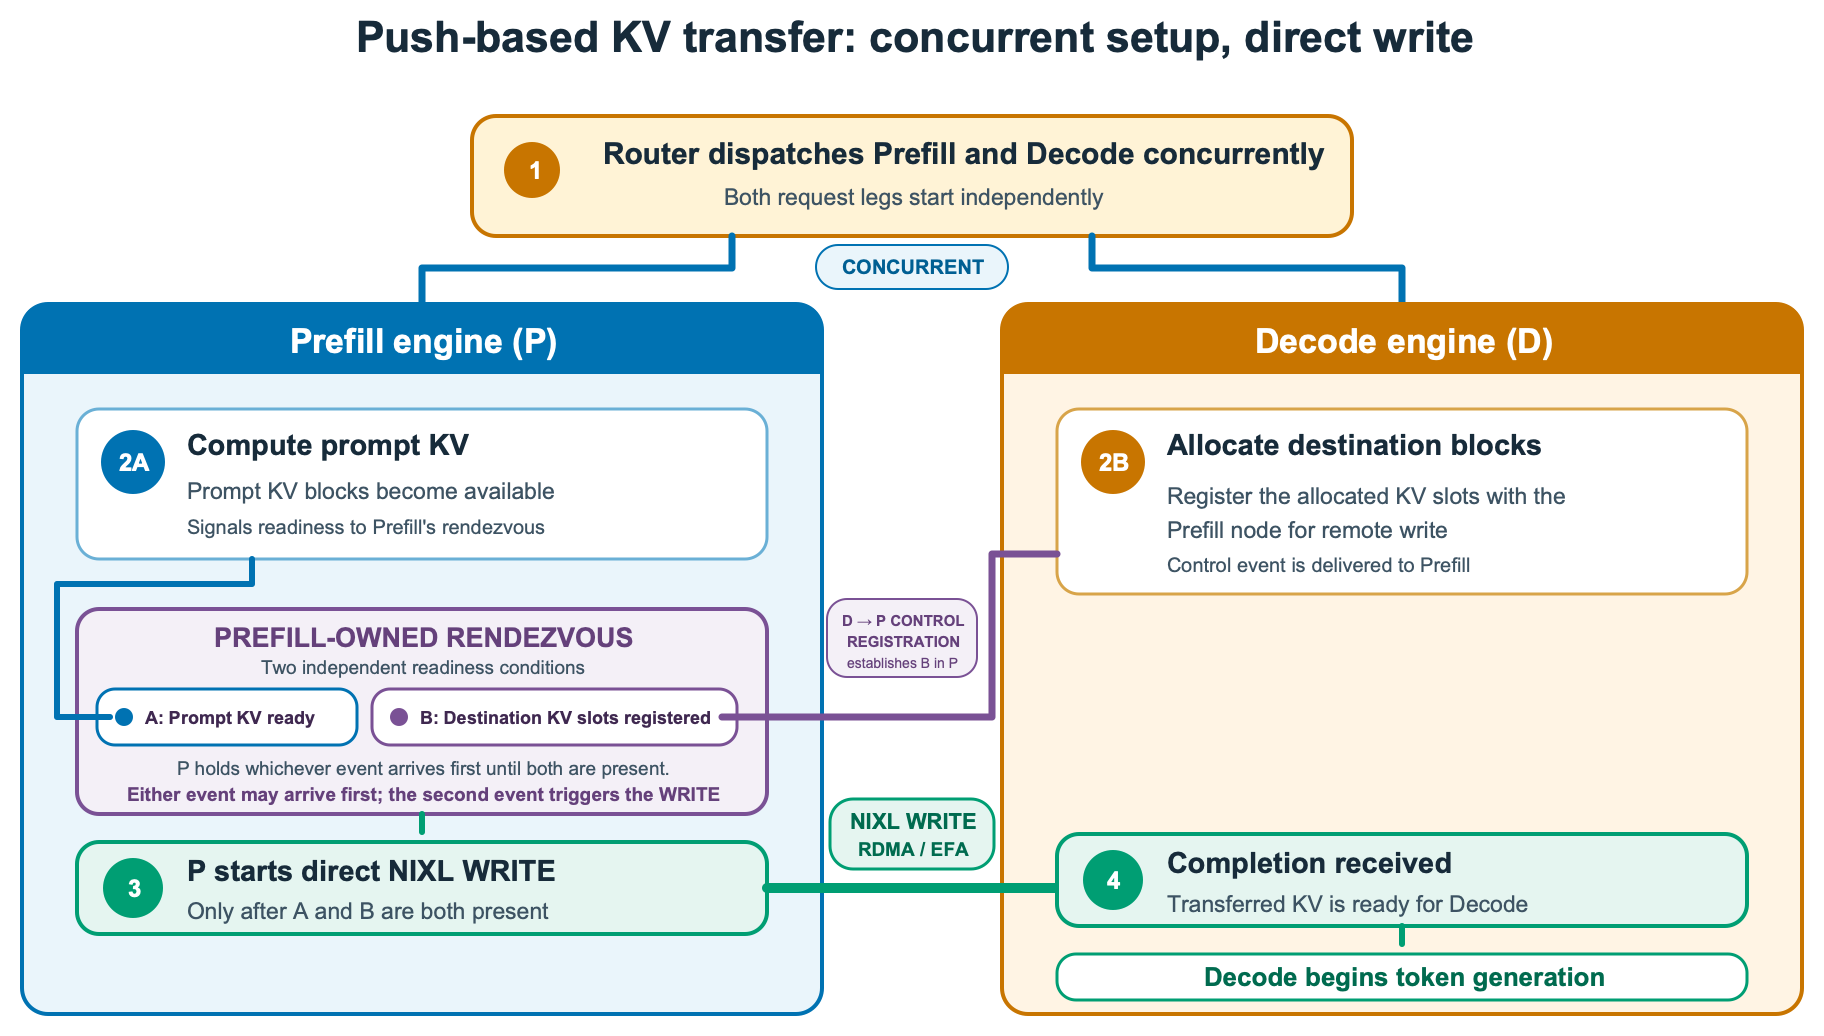
Figure 2 : Architecture de transfert KV basée sur le push, montrant comment l'instance de décodage, l'instance de préremplissage et le thread de transfert en arrière-plan se coordonnent
Détails de l'implémentation
Le protocole comporte trois étapes logiques.
1. Enregistrement (côté décodage). Lorsque l'instance de décodage alloue des blocs locaux pour une requête nécessitant un préremplissage distant, elle prépare un enregistrement décrivant où l'instance de préremplissage doit écrire le KV : sa propre identité et les emplacements de blocs qu'elle vient de réserver. Au sein de la même étape du moteur, le worker transmet cet enregistrement à l'instance de préremplissage sous forme de notification NIXL. Comme l'enregistrement a lieu au moment de l'allocation, le connecteur connaît les blocs de destination avant que l'instance de préremplissage ne termine le préremplissage.
2. Rendez-vous (côté préremplissage). L'enregistrement du décodeur et l'achèvement du préremplissage sur le producteur peuvent arriver dans n'importe quel ordre, et le connecteur gère les deux cas. Si l'enregistrement arrive en premier, le producteur le conserve jusqu'à ce que son propre préremplissage soit terminé. Si le préremplissage se termine en premier, le producteur conserve les blocs de la requête jusqu'à l'arrivée de l'enregistrement. Quel que soit l'événement qui survient en second, il déclenche le transfert. Le connecteur associe les requêtes par ID, et la correspondance prend en compte les requêtes réémises, en associant correctement les requêtes préemptées ou relancées.
3. Transfert (côté préremplissage). Une fois une requête associée, le producteur établit une connexion vers l'instance de décodage (si elle n'existe pas déjà) et émet un NIXL WRITE qui copie les blocs KV directement dans la mémoire enregistrée du décodeur, en s'adressant à chaque rang tensor-parallel de destination. Le producteur et le consommateur peuvent utiliser des dispositions de blocs internes différentes. Chaque côté mappe les emplacements de blocs sur sa propre disposition physique au moment du transfert, ce qui permet des tailles de blocs différentes de chaque côté. Chaque WRITE transporte une notification d'achèvement que NIXL délivre à l'instance de décodage une fois les données arrivées. Le décodeur compte ces notifications, une par rang de producteur qui écrit en lui. Il considère le KV comme reçu uniquement après l'arrivée de toutes les notifications attendues, moment où la requête passe en phase de décodage.
Modèle de threading
Le connecteur push sépare l'exécution du modèle de la préparation du transfert de KV en utilisant un thread de transfert en arrière-plan dédié sur chaque worker de préremplissage. Au début d'une requête, la boucle principale de décodage alloue ses blocs KV de destination et les enregistre auprès de l'instance de préremplissage pendant que la boucle principale de préremplissage calcule le cache KV du prompt. Une fois que l'enregistrement de destination et le KV du prompt sont prêts, la boucle principale de préremplissage remet les blocs KV au thread d'arrière-plan et retourne rapidement à l'exécution du modèle.
Le thread d'arrière-plan établit ou réutilise la connexion NIXL, mappe les IDs de blocs KV de la requête sur des descripteurs mémoire, fusionne les blocs contigus en régions de transfert plus grandes et soumet le NIXL WRITE à l'instance de décodage. Lorsque NIXL termine le transfert, il envoie une notification d'achèvement à l'instance de décodage, qui commence alors la génération de tokens. Le fait de maintenir la préparation des descripteurs et la soumission des transferts hors des boucles principales critiques pour la latence empêche ce travail par requête de retarder l'exécution du modèle. Le diagramme suivant montre ces passages de relais entre la boucle principale et le thread d'arrière-plan pour une seule requête.
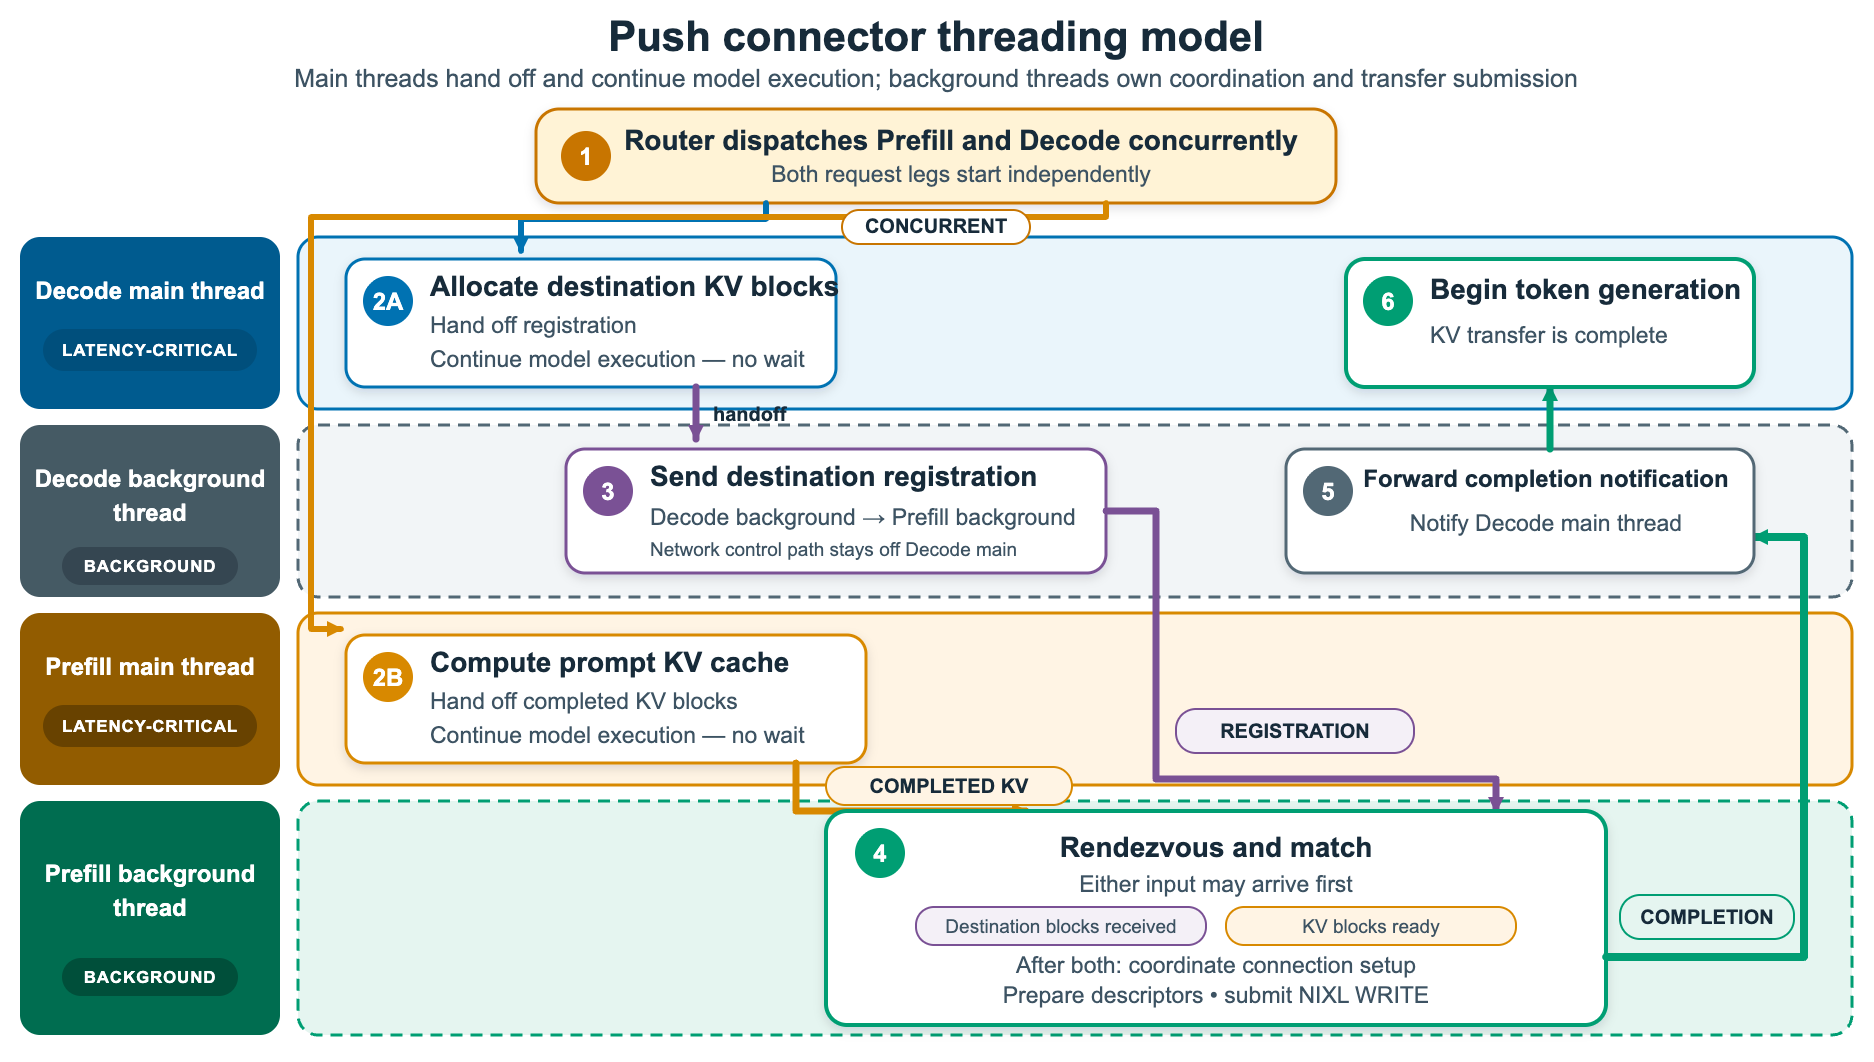
Figure 3 : Passages de relais entre la boucle principale et le thread d'arrière-plan pour une seule requête dans le modèle de threading basé sur le push
Comparaison temporelle entre pull et push
Le diagramme suivant résume les flux de transfert pull et push décrits dans les sections précédentes et met en évidence leur effet sur le TTFT. Bien que les deux modes utilisent le même chemin de données NIXL et EFA/RDMA, le pull effectue le relais des métadonnées et la configuration côté décodage après le préremplissage, tandis que le push chevauche la configuration côté décodage avec le préremplissage. Ainsi, le push retire ces opérations du chemin critique post-préremplissage, permettant au décodage de commencer plus tôt.
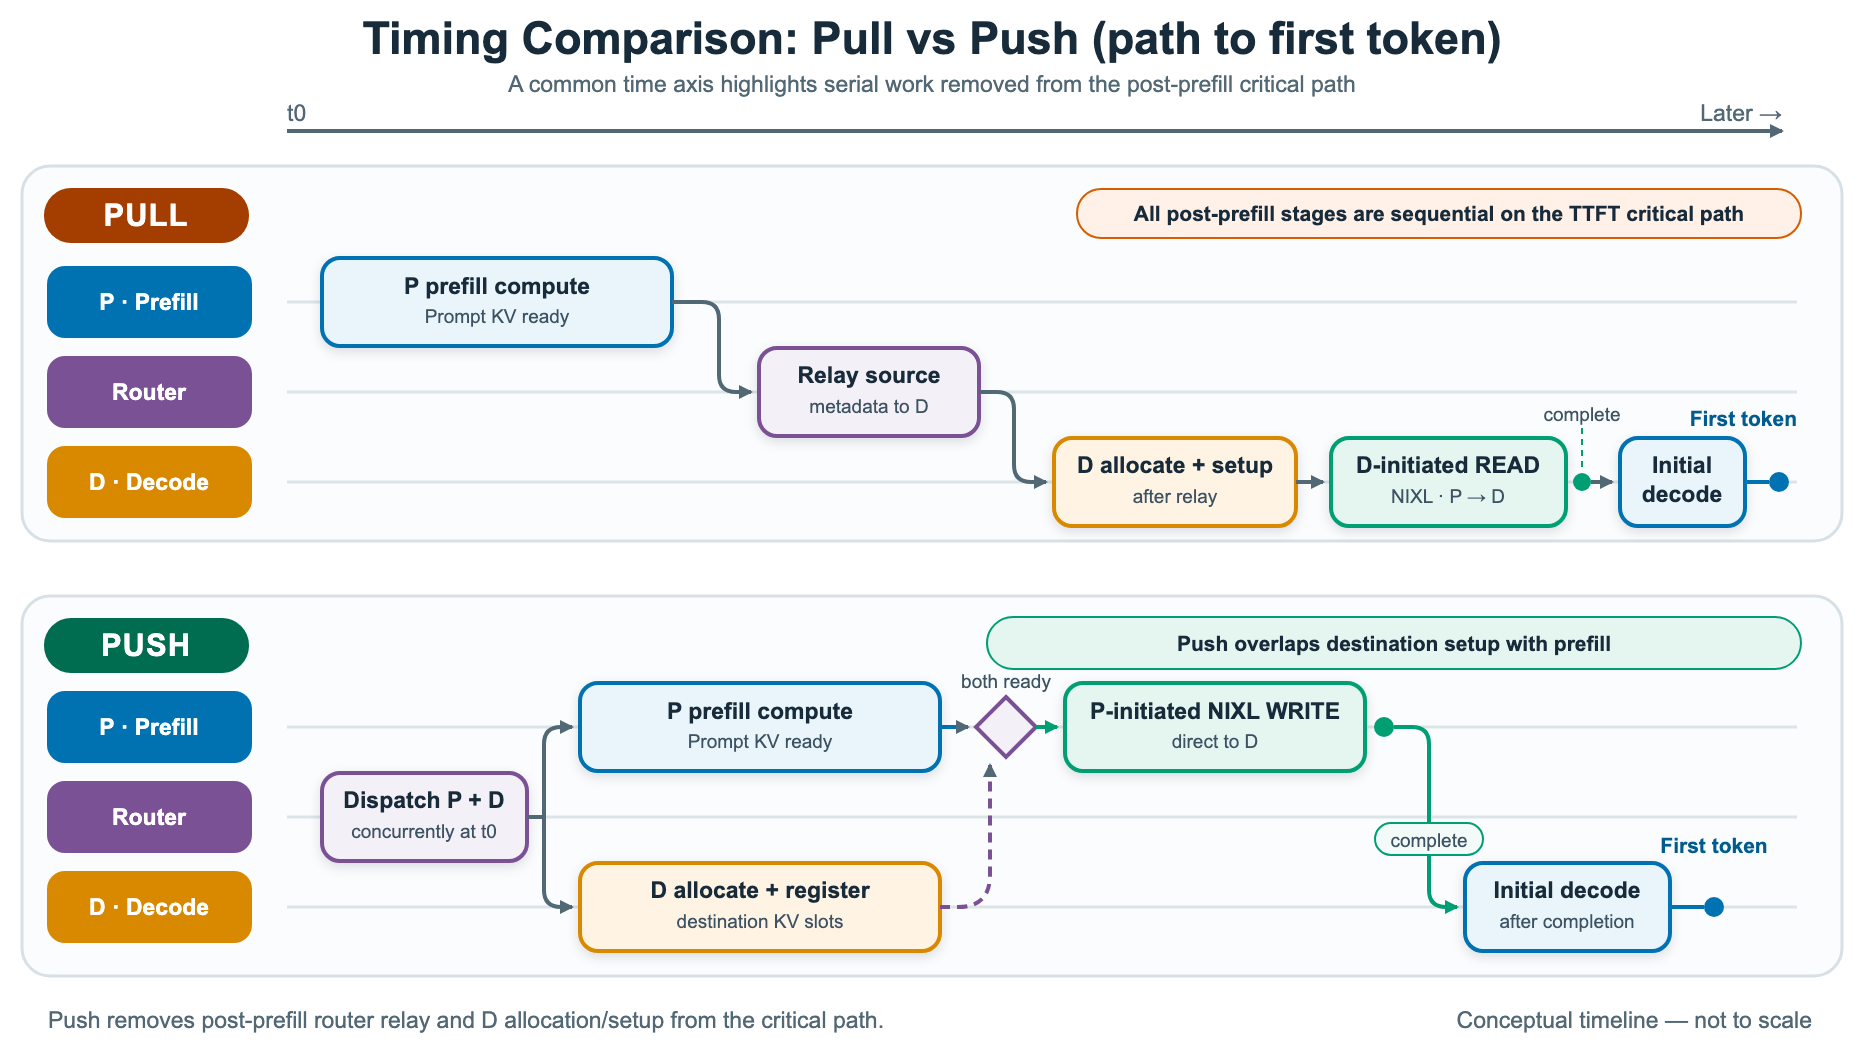
Figure 4 : Comparaison des flux de transfert pull et push, mettant en évidence la façon dont le push chevauche la configuration côté décodage avec le préremplissage
Les deux modes impliquent également un compromis de routage. Le mode pull permet au routeur de sélectionner une instance de décodage après l'achèvement du préremplissage, ce qui offre une plus grande flexibilité pour le routage tenant compte de la charge et la gestion de la qualité de service. Le mode push sélectionne l'instance de décodage plus tôt afin que la configuration de la destination puisse chevaucher le préremplissage. En contrepartie, à charge comparable, l'instance de préremplissage peut libérer ses blocs KV plus tôt car le transfert commence dès que le KV du prompt et l'enregistrement de destination sont prêts.
Données de performance
Pour l'évaluation, nous avons utilisé le modèle Qwen3-32B sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées via EFA. Pour isoler les performances de transfert P→D, nous avons configuré le benchmark pour désactiver le prefix caching avec --no-enable-prefix-caching. Cette configuration fait que le nœud de décodage récupère l'intégralité du cache KV depuis le nœud de préremplissage pour chaque requête. Sinon, des prompts qui se chevauchent pourraient réutiliser le cache local du nœud de décodage et contourner le transfert, ce qui produirait des résultats de comparaison trompeurs.
Le graphique suivant compare le TTFT pour le transfert de KV en push et en pull. Nous balayons les longueurs d'entrée de 1k à 16k et des taux de requêtes de 1 à 8 requêtes par seconde (QPS). À faible charge et avec des prompts courts, les deux modes fonctionnent de manière presque identique. À mesure que le QPS et la longueur d'entrée augmentent, le mode pull se dégrade fortement, atteignant environ 1,744 ms à 8 QPS et 16k. Le mode push reste bien plus bas, à environ 540 ms, soit une réduction d'environ 3x. L'écart s'explique parce que le mode pull publie les descripteurs NIXL en ligne sur le worker de décodage, de manière synchrone dans sa boucle du moteur, ce qui bloque la génération de tokens. Le mode push déplace ce travail vers un thread d'arrière-plan, hors du chemin critique.
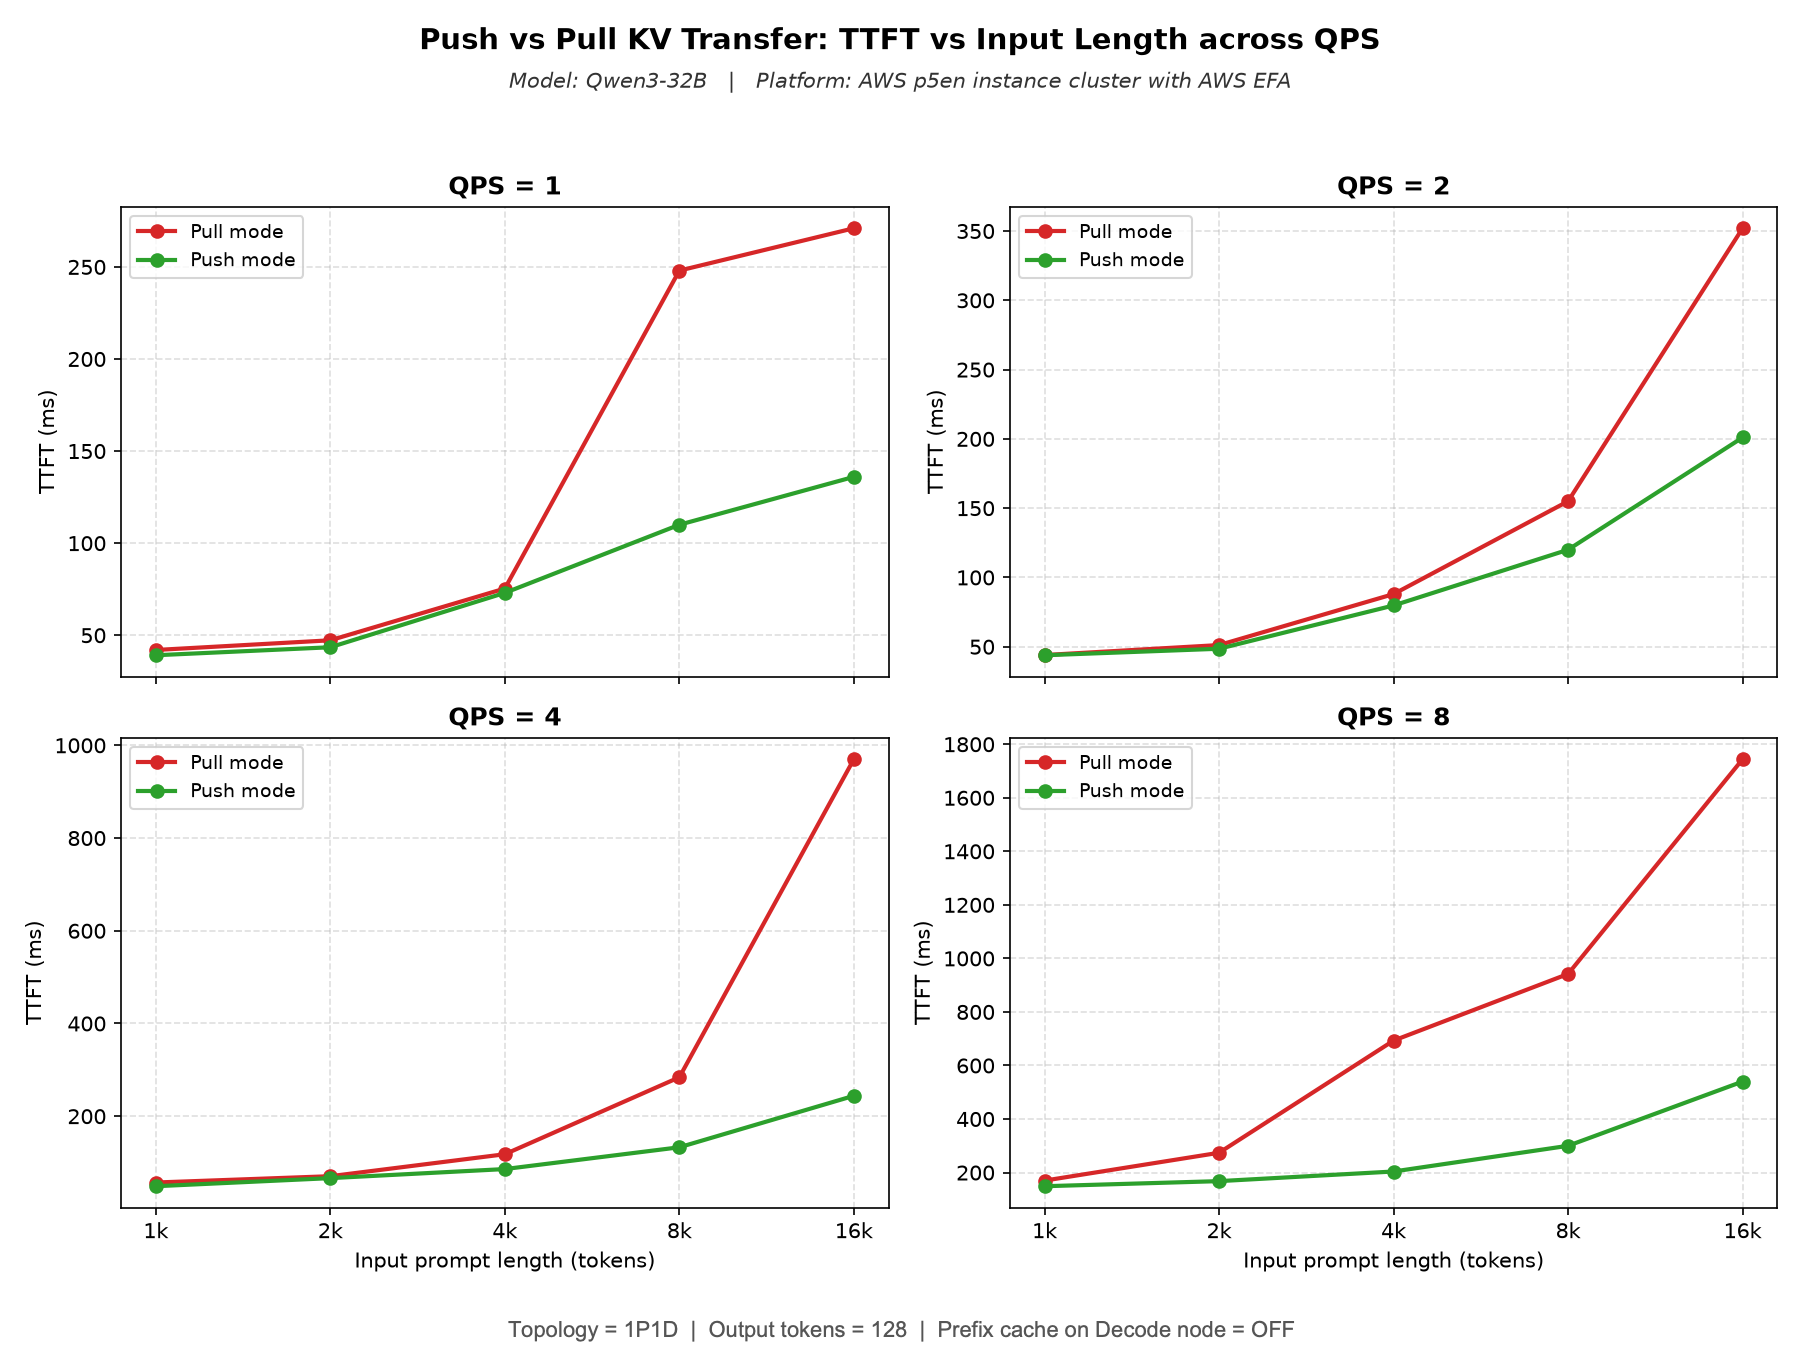
Figure 5 : TTFT du push comparé au transfert de KV en pull selon les longueurs d'entrée et les taux de requêtes (topologie 1P1D, 128 tokens de sortie, prefix caching désactivé sur le nœud de décodage)
Ce graphique montre le TPOT dans les mêmes conditions. Le schéma reflète celui du TTFT. À charge légère, push et pull sont proches, autour de 5,6–5,8 ms. À mesure que la charge et la longueur d'entrée augmentent, le pull monte à environ 10,4 ms à 4–8 QPS et 16k, tandis que le push se maintient autour de 7 ms. La raison en est que le push décharge la préparation des descripteurs et la soumission des transferts du worker de décodage. La génération de tokens n'est pas privée de ressources, de sorte que la latence par token reste stable même à haute concurrence et avec de longs contextes.
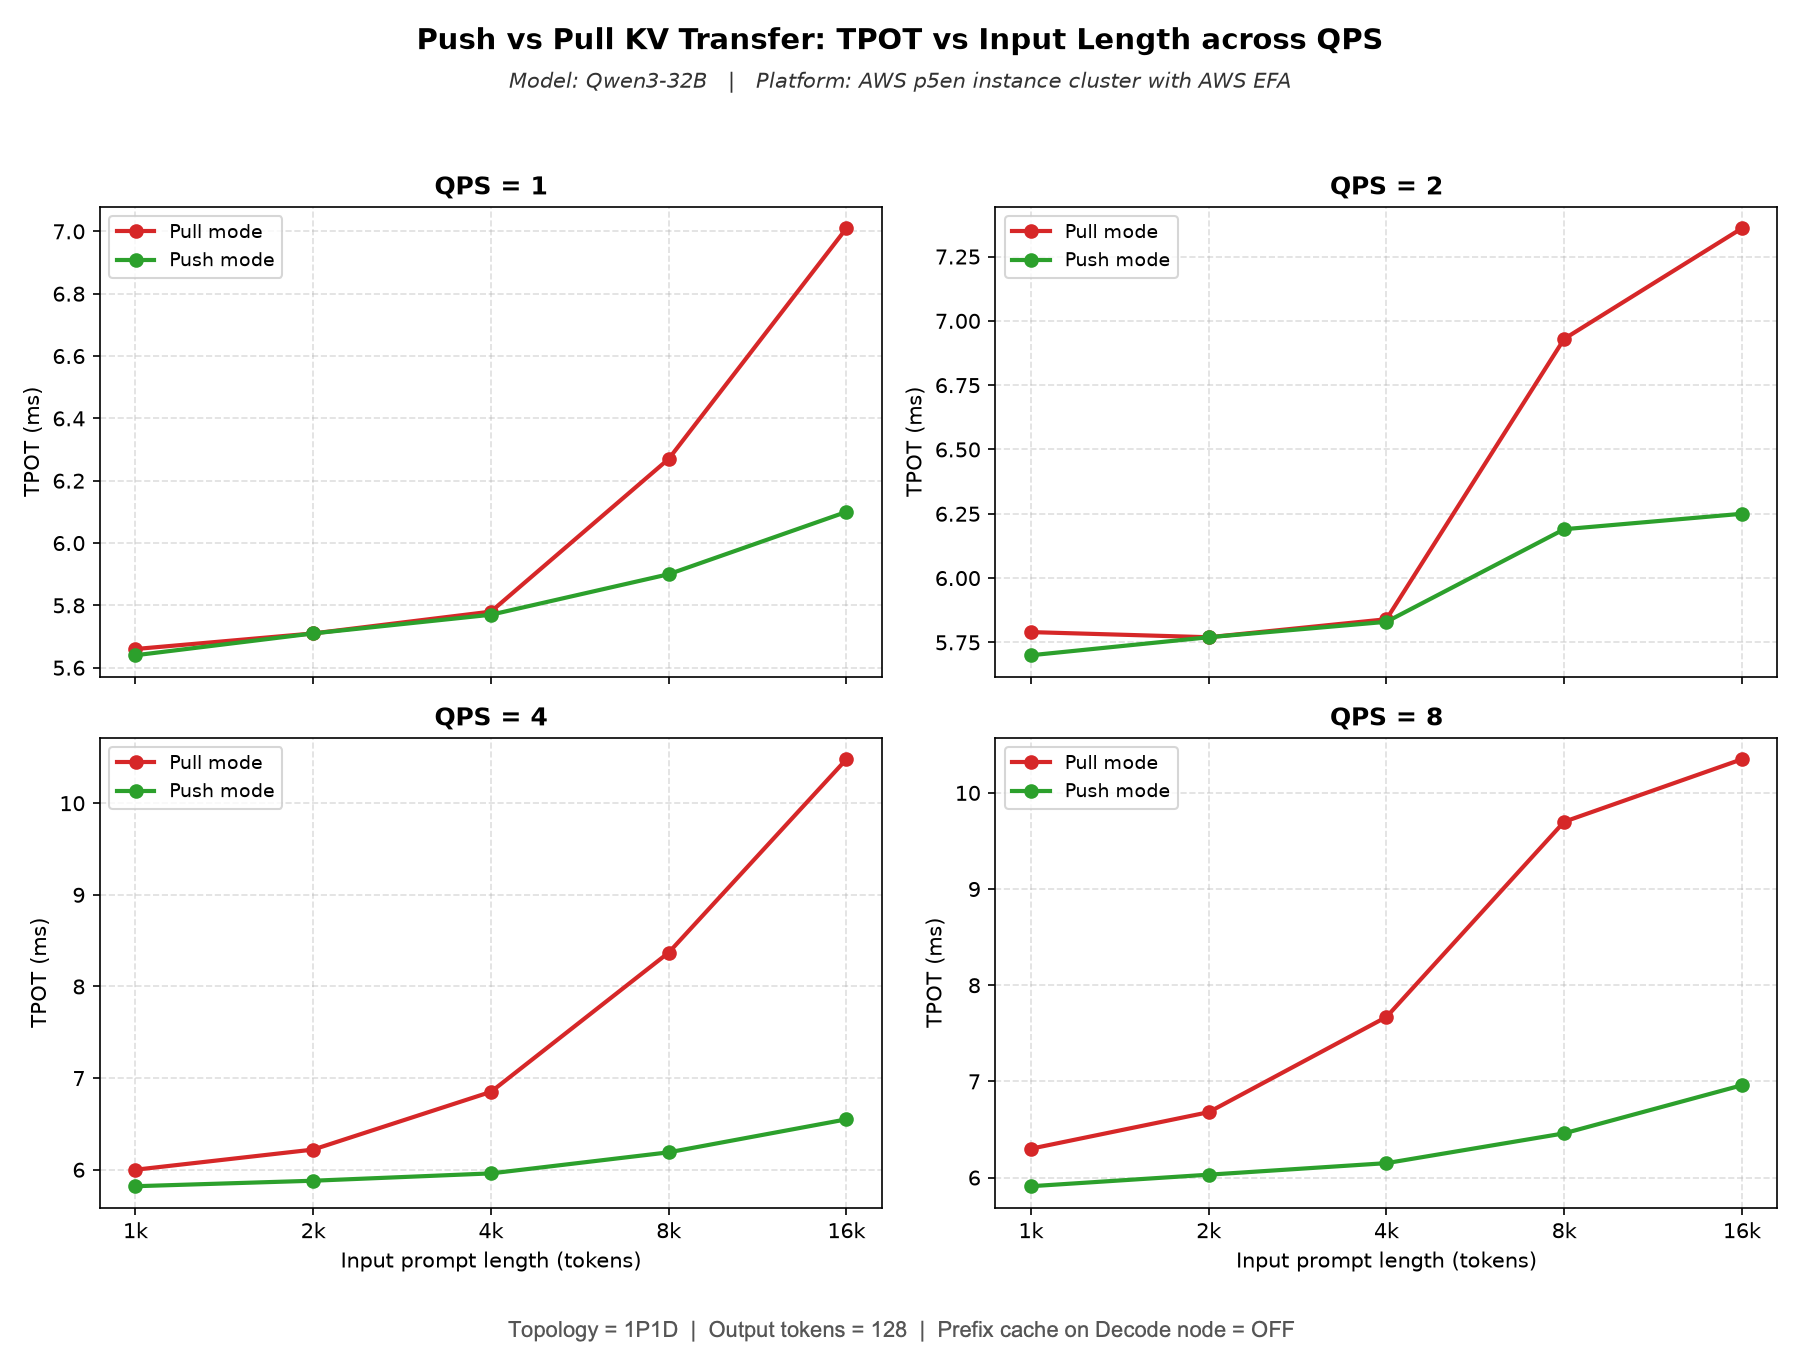
Figure 6 : TPOT pour le transfert KV en push comparé au pull selon les longueurs d'entrée et les taux de requêtes (topologie 1P1D, 128 tokens de sortie, cache de préfixe désactivé sur le nœud de décodage)
Comment exécuter un benchmark
Pour reproduire notre configuration de benchmark 1P1D, un nœud de préfill et un nœud de décode, en utilisant des instances Amazon EC2 P5en connectées avec EFA, reportez-vous aux instructions détaillées dans le Reproduction de nos résultats guide. Le guide couvre la configuration de l'environnement, le lancement des serveurs vLLM de prefill et de decode, l'exécution du benchmark et la collecte des résultats. La fonctionnalité peut fonctionner sur d'autres configurations prises en charge, mais les performances varieront selon le matériel, le modèle, la charge de travail et la configuration réseau.
Conclusion
Dans cet article, nous avons montré comment le connecteur KV de type push chevauche le calcul de prefill avec l'allocation et l'enregistrement de blocs côté decode, supprimant ainsi l'aller-retour du routeur après le prefill et la configuration du transfert côté decode du chemin critique. Cela réduit le TTFT et le TPOT, en particulier à des taux de requêtes élevés. Dans notre benchmark Qwen3-32B sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées via EFA, le mode push a offert jusqu'à une amélioration d'un facteur 3 du TTFT et une amélioration de 30 % du TPOT par rapport au mode pull. Les résultats varient selon la charge de travail et la configuration. Pour utiliser le mode push, configurez à la fois les serveurs de prefill et de decode pour utiliser NixlPushConnector au lieu de NixlConnector.
Choisissez le connecteur push lorsque la sélection précoce du nœud de décodage est acceptable et qu'un TTFF plus faible est la priorité. Le connecteur pull reste le meilleur choix pour les charges de travail qui nécessitent transfert KV bidirectionnel ou différer la sélection de l'instance de décodage jusqu'après le prefill pour un routage tenant compte de la charge. vLLM prend en charge les connecteurs KV à la fois en mode push et en mode pull, vous pouvez donc choisir l'approche qui correspond le mieux à votre déploiement.
En tant qu'amélioration future, nous explorons l'apport du modèle de threading NIXL en arrière-plan au connecteur en mode pull, afin de sortir la configuration NIXL du chemin critique pour que les charges de travail en mode pull puissent bénéficier des mêmes optimisations. Nous avons ouvert une pull request pour explorer cette piste.
Ressources associées
Remerciements
Nous remercions la communauté vLLM pour son soutien dans la maintenance de cette fonctionnalité.