
Les charges de travail agentiques multi-tours s'appuient sur un contexte accumulé à mesure qu'un agent raisonne, invoque des outils et intègre les résultats antérieurs. À chaque nouveau tour, le client renvoie l'historique de la conversation, y compris les instructions système, les requêtes précédentes, les résultats d'outils et les réponses du modèle, ce qui fait que le contexte croissant est traité de manière répétée. Dans Désagrégation préremplissage-décodage (P-D), chaque requête est répartie entre des nœuds spécialisés : le nœud de préfill traite le prompt et construit son cache clé-valeur (KV), puis le nœud de decode récupère ces blocs KV et génère la réponse.
Cependant, le serving désagrégé conventionnel ne transfère le KV cache que dans un seul sens : du nœud de prefill vers le nœud de decode. Ce flux unidirectionnel crée deux inefficacités pour les charges de travail multi-tours. Premièrement, après avoir généré une réponse, le nœud de decode conserve les entrées de KV cache à la fois pour le prompt et pour les nouveaux tokens générés. Lors du traitement du tour suivant, le nœud de prefill ne peut pas récupérer ces entrées, il doit donc recalculer les projections KV pour les tokens de réponse précédents. Deuxièmement, le nœud de decode maintient l'état de la session alors que les nœuds de prefill ne le font pas, ce qui augmente la probabilité d'éviction du cache pour les sessions actives sur les nœuds de prefill. En cas d'échec total du cache, le nœud de prefill doit recalculer les projections KV pour l'intégralité de l'historique de la conversation, y compris les instructions système, les requêtes utilisateur précédentes, les résultats des outils et les réponses générées par le modèle. À mesure que la conversation s'allonge, ce travail redondant consomme davantage de capacité d'accélérateur et augmente le temps jusqu'au premier token (TTFT).
Lorsque vous créez des assistants conversationnels et des applications agentiques, des historiques d'interaction plus longs peuvent augmenter la latence et consommer de la capacité d'accélérateurs via des calculs de préfill répétés. Dans cet article, nous montrons comment transfert bidirectionnel de cache KV permettent aux nœuds de prefill et de decode de réutiliser le contexte précédemment calculé d'un tour à l'autre, ce qui améliore l'utilisation des accélérateurs et aide les applications à maintenir un TTFT réactif à mesure que les conversations s'allongent.
Dans nos benchmarks multi-tours sur un déploiement 1P1D utilisant des instances Amazon Elastic Compute Cloud (Amazon EC2) P5en, le transfert KV bi-directionnel a réduit le TTFT jusqu'à 1,6x pour Qwen3-32B et jusqu'à 3,3x pour zai-org/GLM-5-FP8 (voir la section Performance data). Les résultats varient selon la charge de travail et la configuration. Les instances sont connectées avec AWS Elastic Fabric Adapter (AWS EFA), un réseau d'accès direct à la mémoire à distance (RDMA) à faible latence utilisé entre les serveurs dans AWS. Le types d'instances pris en charge, AWS EFA prend en charge GPUDirect RDMA et Neuron Direct RDMA pour déplacer les blocs KV directement entre la mémoire des GPU ou des dispositifs AWS Trainium sur les nœuds de prefill et de decode.
Nous avons initialement développé et validé la fonctionnalité sur AWS Trainium des clusters d'instances connectés avec EFA et nous l'avons contribuée à vLLM en tant que capacité indépendante de l'accélérateur. Les résultats présentés ici proviennent d'un cluster de GPU Amazon EC2 P5en avec EFA, montrant que les avantages s'étendent également aux GPU. Ce billet explique l'architecture de transfert KV bi-directionnel, le flux de métadonnées du routeur, la rétention des blocs KV et les contrôles de recompute, les résultats de performance, et comment reproduire le benchmark.
Transfert KV bi-directionnel
Le transfert KV bi-directionnel est un mécanisme par lequel un nœud de decode renvoie les KV précédemment calculés à un nœud de prefill lors des tours suivants d'une conversation. Cela évite de recalculer le contexte partagé sur le nœud de prefill et est régi par un seuil de recompute KV configurable. Ce mécanisme atténue les deux scénarios de redondance computationnelle décrits précédemment. Pour que cela fonctionne, les KV doivent survivre au tour qui les a produits et voyager dans la direction inverse, de manière coordonnée par un routeur conscient du cache KV.
Améliorations du connecteur KV NIXL pour le transfert bi-directionnel
Nous avons étendu le connecteur KV de la NVIDIA Inference Xfer Library (NIXL) pour permettre aux nœuds de prefill de consommer des blocs KV distants, de la même manière que les nœuds de decode consomment déjà les blocs KV fournis par le nœud de prefill. Ce n'est pas un changement trivial, car les deux types de nœuds sont architecturalement différents : les nœuds de prefill calculent les représentations KV pour les nouveaux tokens de prompt et peuvent fournir des blocs KV de prompt complets. Les nœuds de decode n'ont pas la capacité (ou l'efficacité) de générer des représentations KV complètes et ne peuvent servir que des blocs KV précédemment mis en cache. Par conséquent, les nœuds de prefill et de decode conservent leurs propres rôles et logiques pour calculer les métadonnées des blocs KV distants et locaux. Le mécanisme de transfert KV réel (un NIXL READ), cependant, est commun aux deux directions, P->D et D->P en sens inverse.
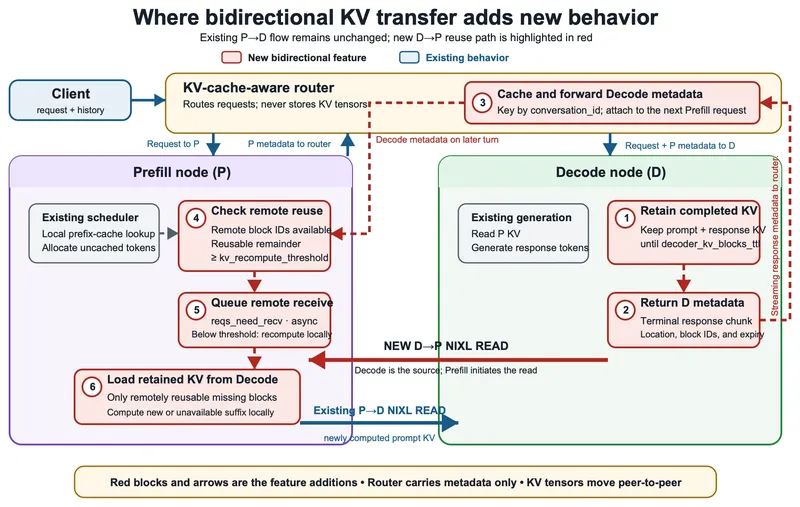
Le diagramme suivant montre d'abord le flux existant en bleu. Le routeur envoie la requête au nœud de préfill, le nœud de préfill calcule les KV du prompt et retourne ses métadonnées de blocs, et le routeur transmet la requête et les métadonnées au nœud de decode pour le NIXL READ standard P→D. Le chemin rouge numéroté illustre les ajouts de transfert de KV bi-directionnel : (1) le nœud de decode conserve les blocs KV éligibles après la génération, (2) retourne leurs métadonnées dans la réponse en streaming, et (3) le routeur met ces métadonnées en cache pour la prochaine requête de préfill. Le nœud de préfill (4) vérifie ensuite les KV réutilisables à distance après avoir appliqué les correspondances du cache local, (5) met en file une réception asynchrone lorsque le nombre de jetons réutilisables atteint le seuil, et (6) effectue un NIXL READ D→P avant de calculer le suffixe restant.
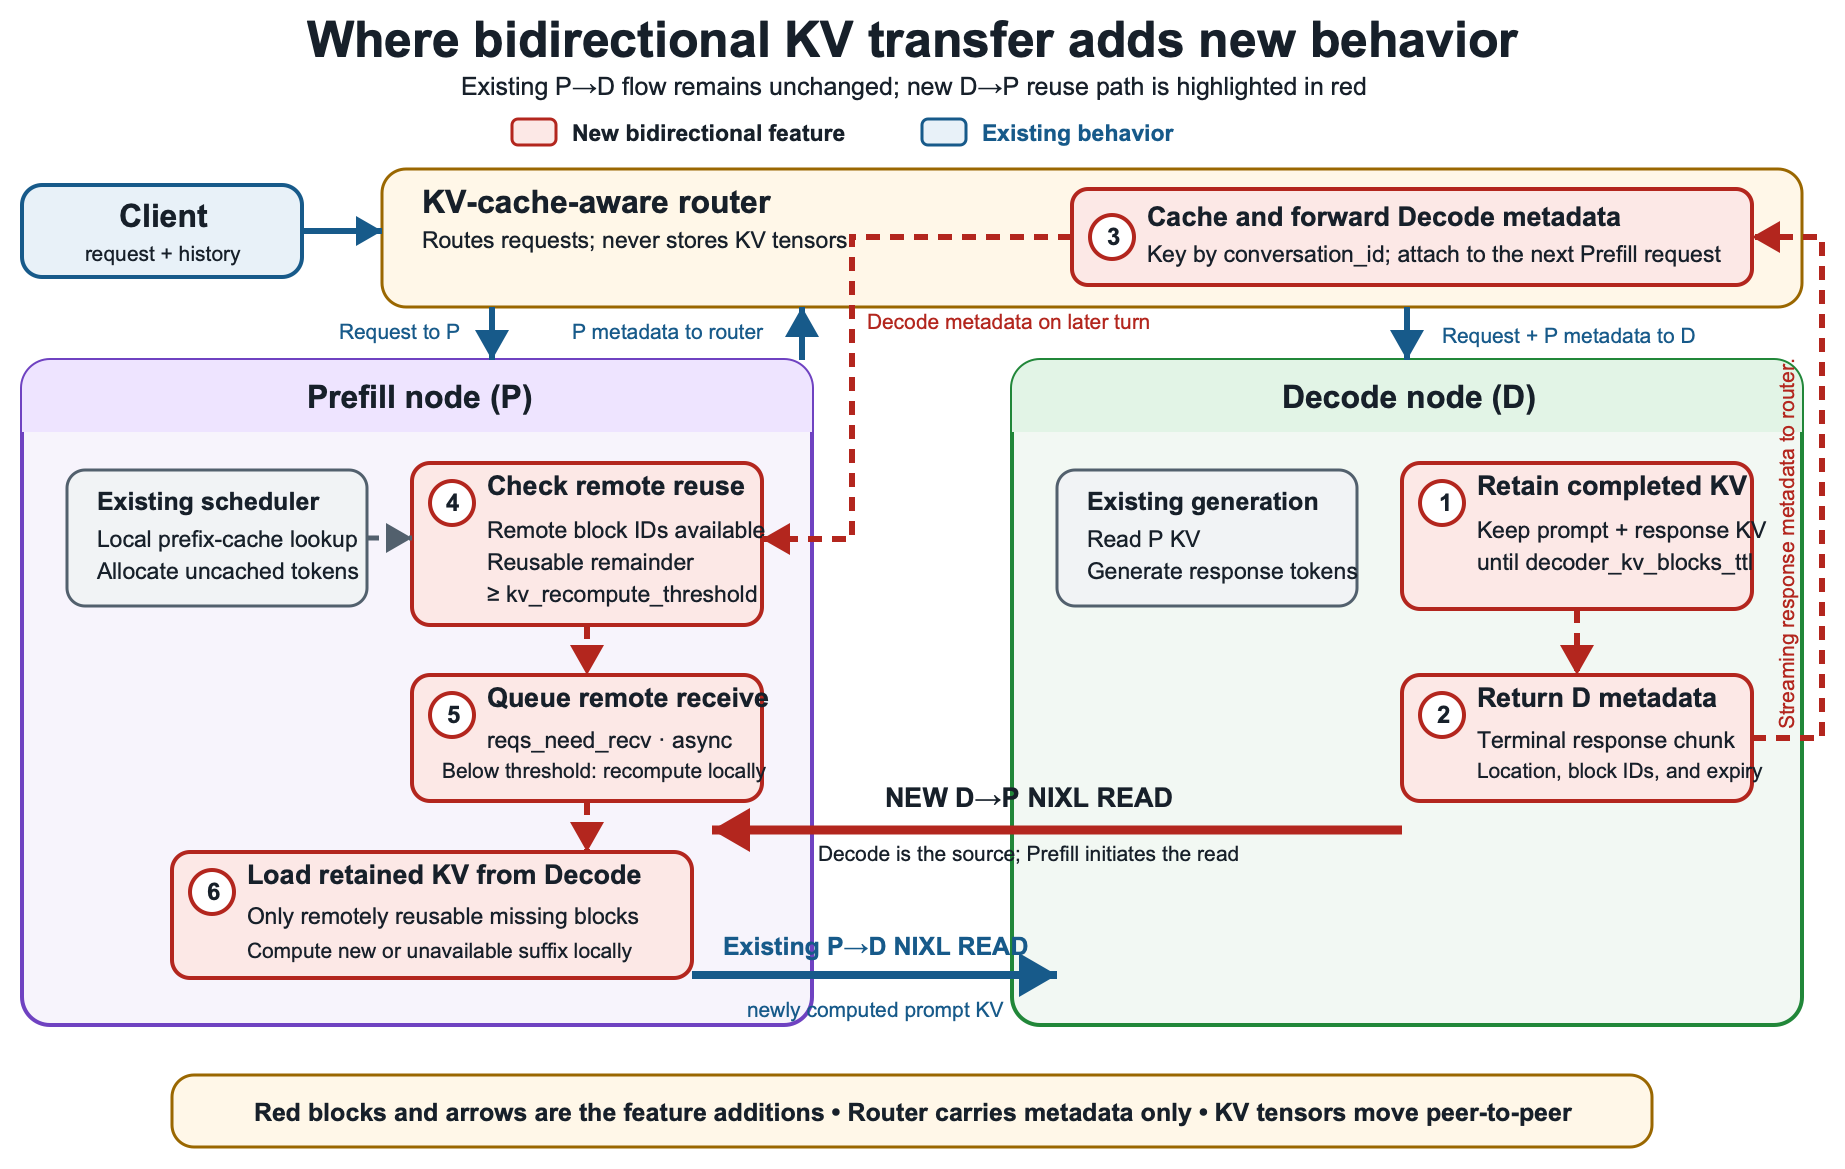
Figure 1 : Flux standard préfill-versus-decode (bleu) et ajouts de transfert de KV bi-directionnel (rouge)
Routeur sensible au cache KV
vLLM inclut une prise en charge côté connecteur pour le transfert de KV bi-directionnel, tandis que la coordination de la réutilisation des KV entre les tours de conversation nécessite un routeur sensible au cache KV. Le GitHub de vLLM fournit un proxy d'exemple qui implémente le flux utilisé dans cet article et qui peut être adapté à votre environnement.
Le routeur sensible au cache KV est un composant de plan de contrôle léger et avec état, situé entre le client, les nœuds de préfill et de decode. Il maintient une correspondance en mémoire entre le conversation_id fourni par le client et le kv_transfer_paramsdu decode. Le routeur stocke uniquement les métadonnées d'emplacement de blocs, pas les tenseurs KV, et obtient ces métadonnées depuis le flux de réponse plutôt qu'en interrogeant séparément le nœud de decode.
Le diagramme suivant montre comment le routeur gère les métadonnées KV au fil des tours de conversation. Au premier tour, la recherche dans le cache échoue et la requête suit le flux standard P→D. Le routeur enregistre ensuite les métadonnées du decode depuis le flux de réponse. Aux tours suivants, le routeur récupère ces métadonnées à l'aide du conversation_id afin que le préfill puisse réutiliser les KV du decode. Il actualise ensuite les métadonnées après la génération pour le tour suivant.
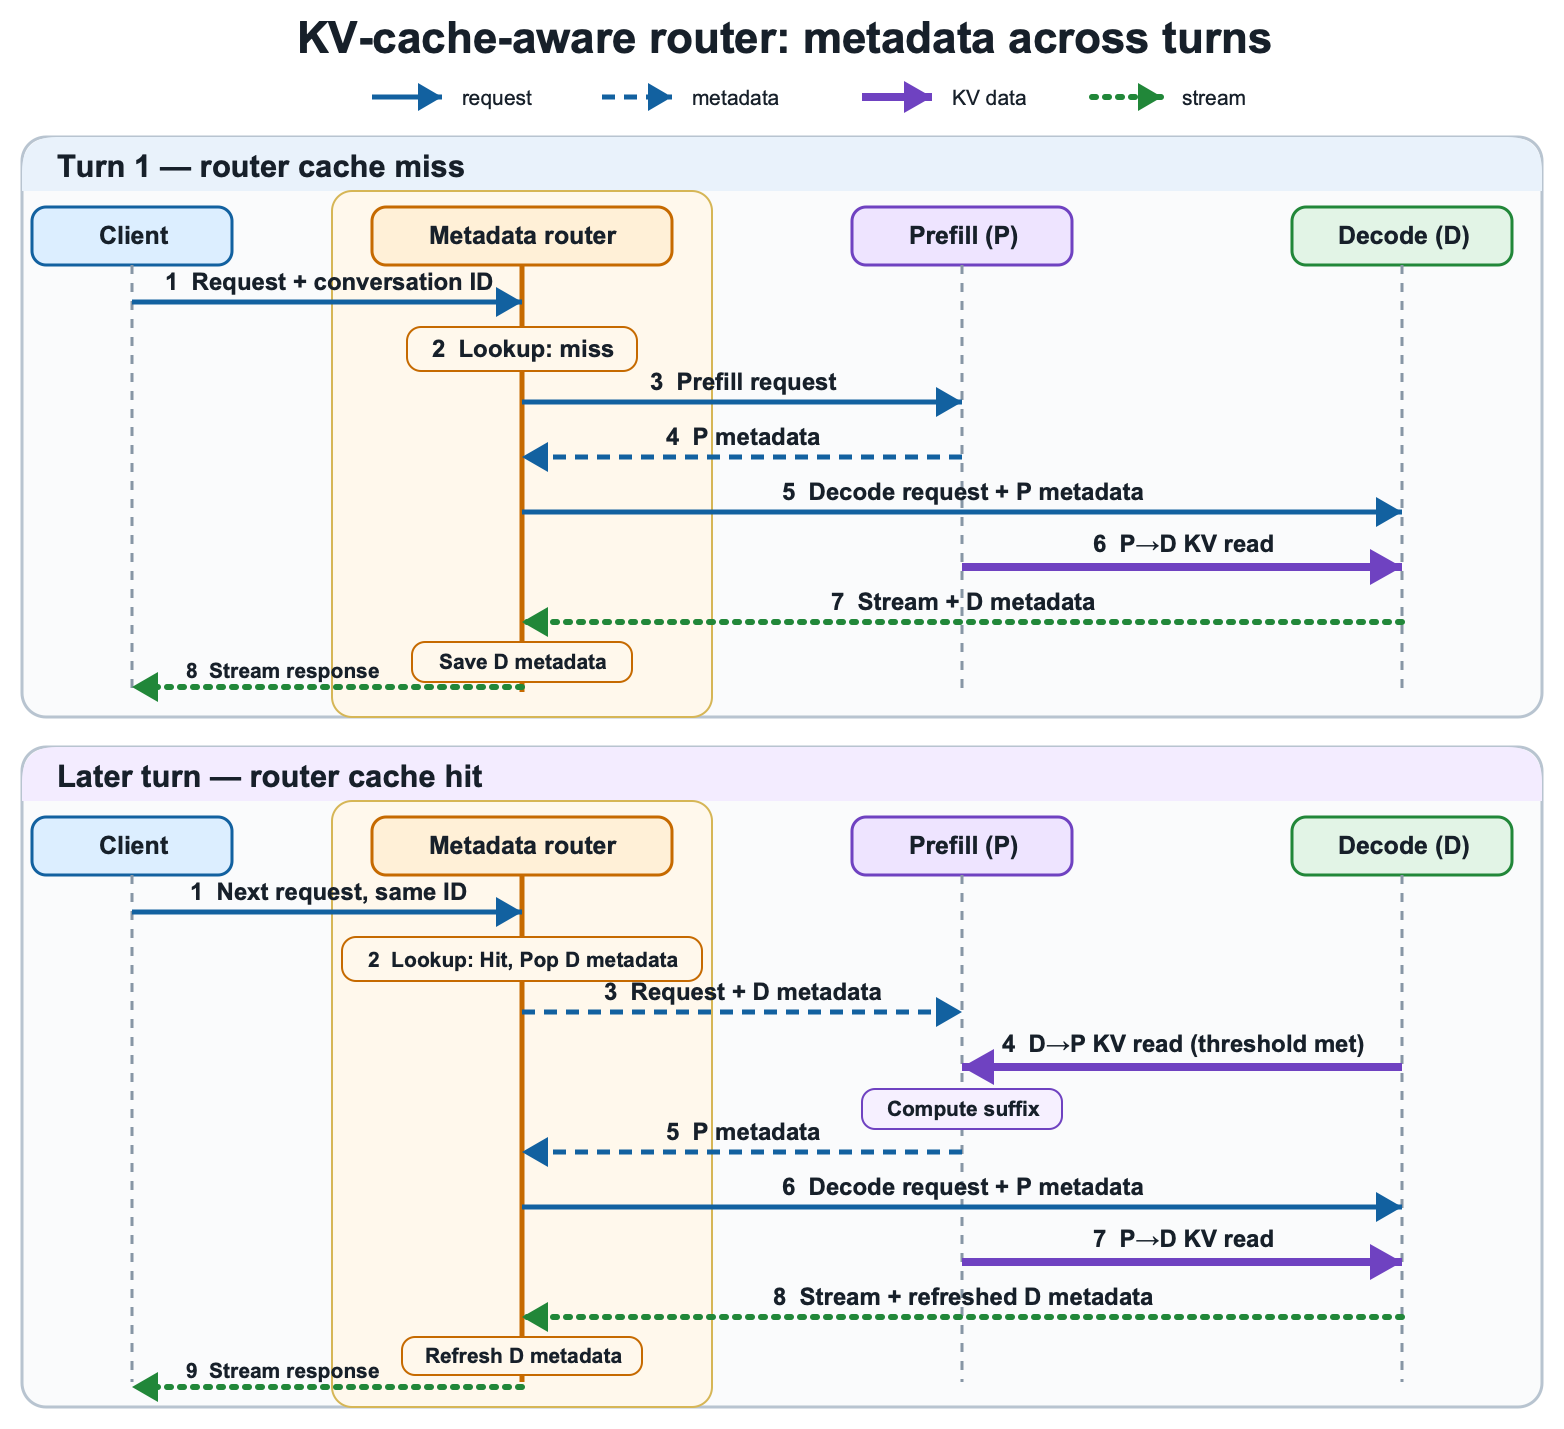
Figure 2 : Flux de métadonnées du routeur sensible au cache KV au fil des tours de conversation
TTL de rétention des blocs
Normalement, une instance de decode libère les blocs d'une requête dès que la génération se termine. En mode de transfert de KV bi-directionnel, elle les conserve pendant une durée de vie configurable (decoder_kv_blocks_ttl, 480 secondes par défaut) et publie leur emplacement et leur expiration. Les KV de la conversation, à la fois le préfixe du prompt et la réponse générée, restent ainsi disponibles pour le tour suivant. Pour un tour qui arrive avant l'expiration de la durée de vie (TTL), le nœud de préfill réutilise les KV. Un tour qui arrive plus tard revient au préfill normal. Comme ce TTL est fixe et n'est pas renouvelé, réglez-le sur le temps attendu entre les tours afin d'équilibrer la réutilisation des KV et l'utilisation de la mémoire de l'accélérateur. Une amélioration naturelle suivante serait d'étendre le bail renouvelé par battement de cœur au côté decode. Une instance de decode pourrait alors récupérer les blocs dès qu'une conversation devient inactive plutôt qu'à la fin d'un minuteur fixe.
Seuil de recalcul des KV
La réutilisation des KV n'est pas toujours plus rapide que le recalcul local. Pour un préfixe réutilisable court, la surcharge d'interconnexion et de coordination peut dépasser le temps nécessaire pour recalculer les jetons. Le paramètre kv_recompute_threshold , qui vaut 64 jetons par défaut, contrôle cette décision. Le nœud de préfill recalcule lorsque le nombre de jetons à calculer est inférieur au seuil et récupère les KV du nœud de decode lorsqu'il est égal ou supérieur au seuil. Les déploiements peuvent ajuster cette valeur en fonction du temps de calcul du modèle, de la taille des KV et des performances d'interconnexion.
Données de performance
Pour l'évaluation, nous avons utilisé les modèles Qwen3-32B et GLM-5-FP8 sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées via EFA. Pour émuler des scénarios dans lesquels le nœud de préfill a expulsé son cache local ou le routeur sélectionne un nœud de préfill différent qui ne possède pas les blocs KV de la conversation, nous avons désactivé le cache de préfixe sur le nœud de préfill avec --no-enable-prefix-caching.
Sur les deux modèles, l'activation du transfert de KV bi-directionnel réduit le calcul de préfill dans les conversations multi-tours, et le bénéfice croît généralement avec la longueur du prompt. Avec la fonctionnalité DÉSACTIVÉE, l'instance de préfill recalcule l'intégralité du contexte accru à chaque tour, de sorte que le TTFT augmente fortement. Qwen3-32B passe de 158 ms à 2k à 778 ms à 24k, et GLM-5-FP8 de 500 ms à 2k à 2,334 ms à 20k. Avec la fonctionnalité ACTIVÉE, les KV conservés par l'instance de decode sont réutilisés au lieu d'être recalculés, ce qui maintient le TTFT bien plus stable. Qwen3-32B ne passe que de 122 ms à 460 ms sur la même plage (environ une réduction de 1.6x au prompt le plus long), tandis que GLM-5-FP8 passe de 358 ms à 702 ms et reste jusqu'à 3.3x en dessous du chemin de recalcul pour les prompts longs. La répartition de la durée de préfill explique pourquoi.
Le transfert bi-directionnel ajoute un petit temps de transfert de KV (environ 30 ms à 130 ms pour Qwen3-32B ; environ 29 ms à 110 ms pour GLM-5-FP8), mais le calcul de préfill qu'il supprime dépasse largement ce temps de transfert de KV. Par conséquent, la durée totale de préfill avec le transfert ACTIVÉ (Qwen3-32B : 128 ms à 414 ms ; GLM-5-FP8 : 316 ms à 541 ms) reste bien en dessous du chemin de recalcul seul (Qwen3-32B : 153 ms à 744 ms ; GLM-5-FP8 : 500 ms à 2,331 ms). Le modèle plus grand GLM-5-FP8 montre un écart absolu et relatif plus important, car son temps de recalcul par jeton plus élevé rend la réutilisation des KV d'autant plus rentable à mesure que les modèles et les contextes s'accroissent.
Qwen3-32B
Le graphique suivant trace le TTFT en fonction de la longueur du prompt pour Qwen3-32B, en comparant le transfert de KV bi-directionnel ACTIVÉ et DÉSACTIVÉ.
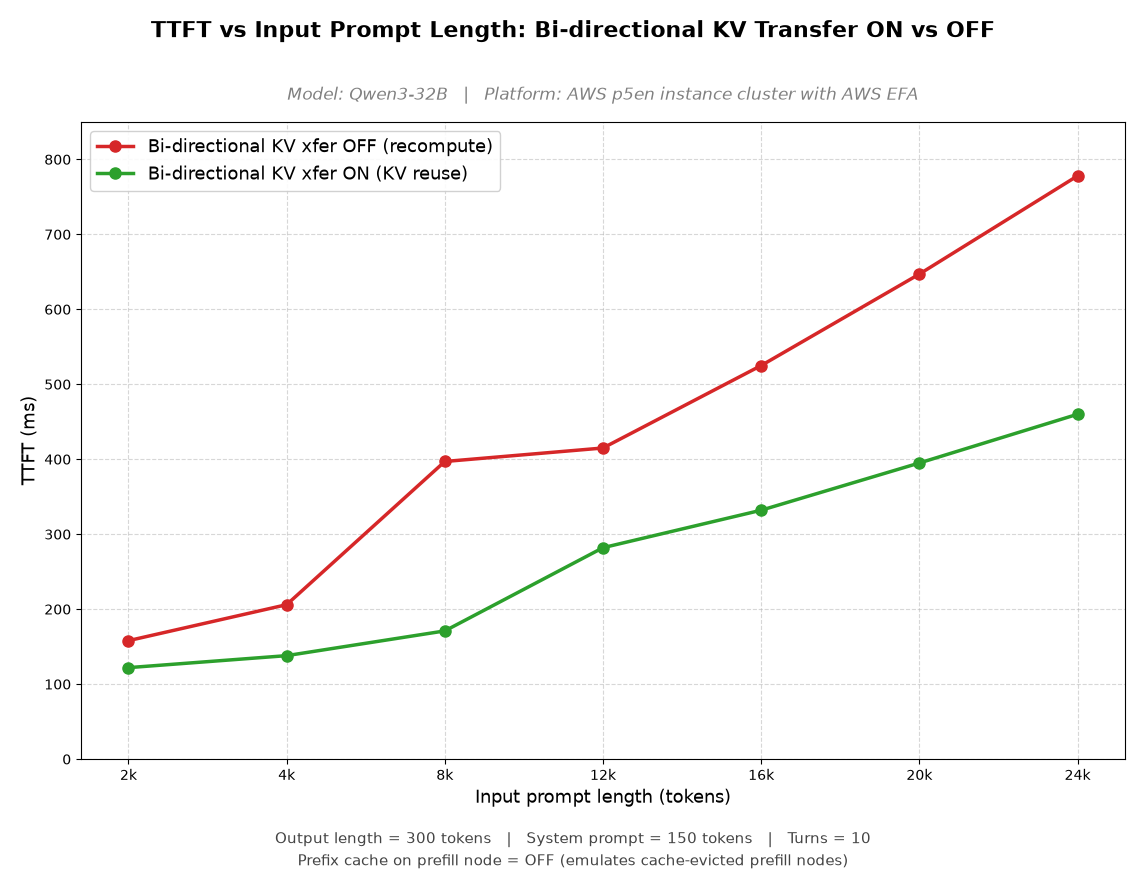
Figure 3 : TTFT de Qwen3-32B en fonction de la longueur du prompt avec le transfert de KV bi-directionnel activé et désactivé
Le graphique suivant décompose la durée de préfill des mêmes exécutions en ses composantes de recalcul et de transfert de KV.
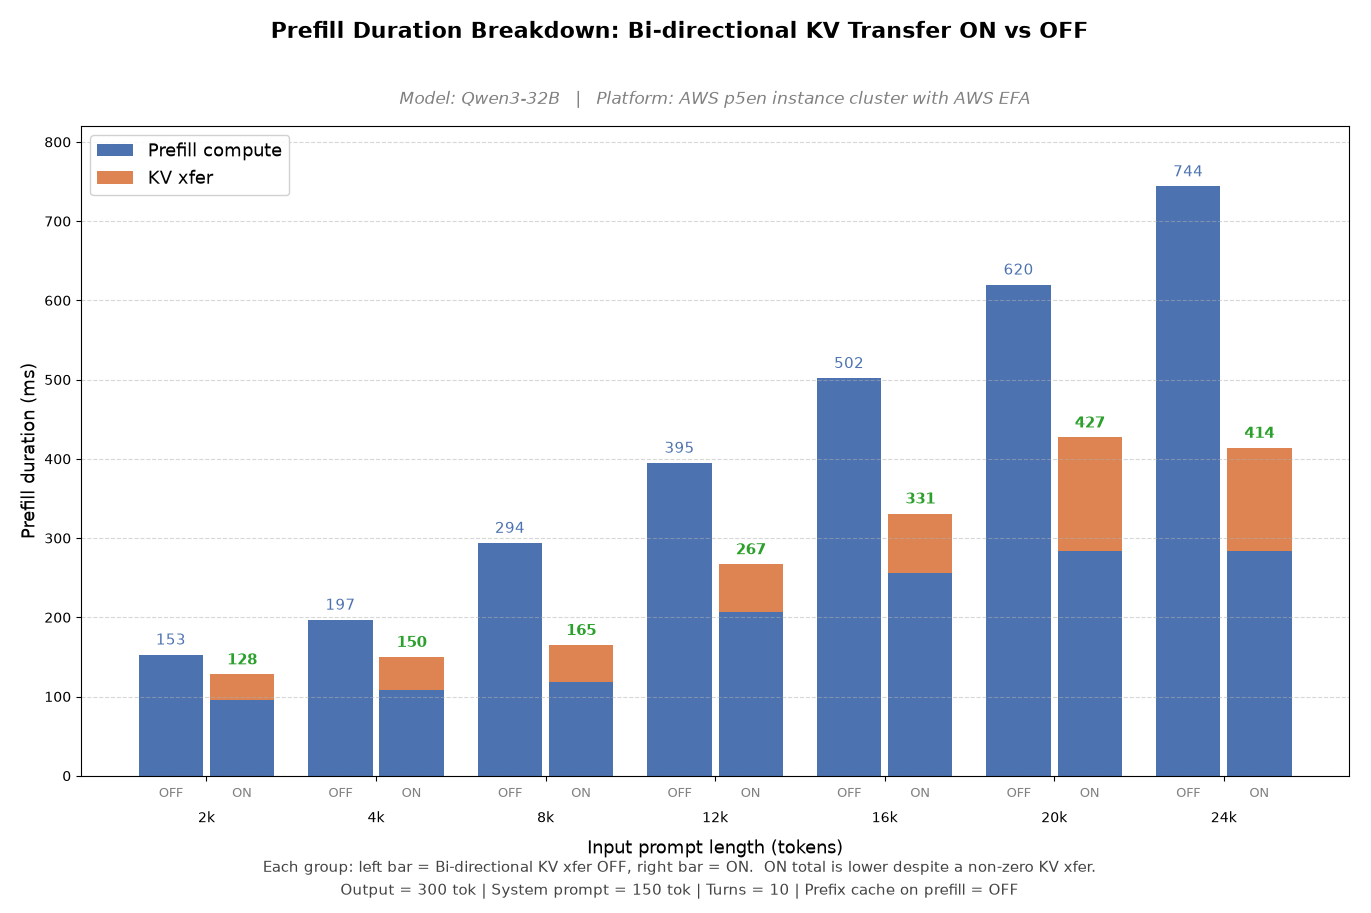
Figure 4 : Durée de préfill de Qwen3-32B répartie en composantes de recalcul et de transfert de KV
Ensemble, les graphiques montrent que le TTFT reste quasiment stable avec la fonctionnalité activée (ON) alors que le chemin sans (OFF) grimpe fortement à mesure que le contexte grandit, car le faible temps de transfert KV est largement compensé par le recalcul qu'il élimine.
zai-org/GLM-5-FP8
Les deux mêmes vues s'appliquent à GLM-5-FP8. La première trace le TTFT en fonction de la longueur du prompt avec la fonctionnalité activée (ON) ou désactivée (OFF).
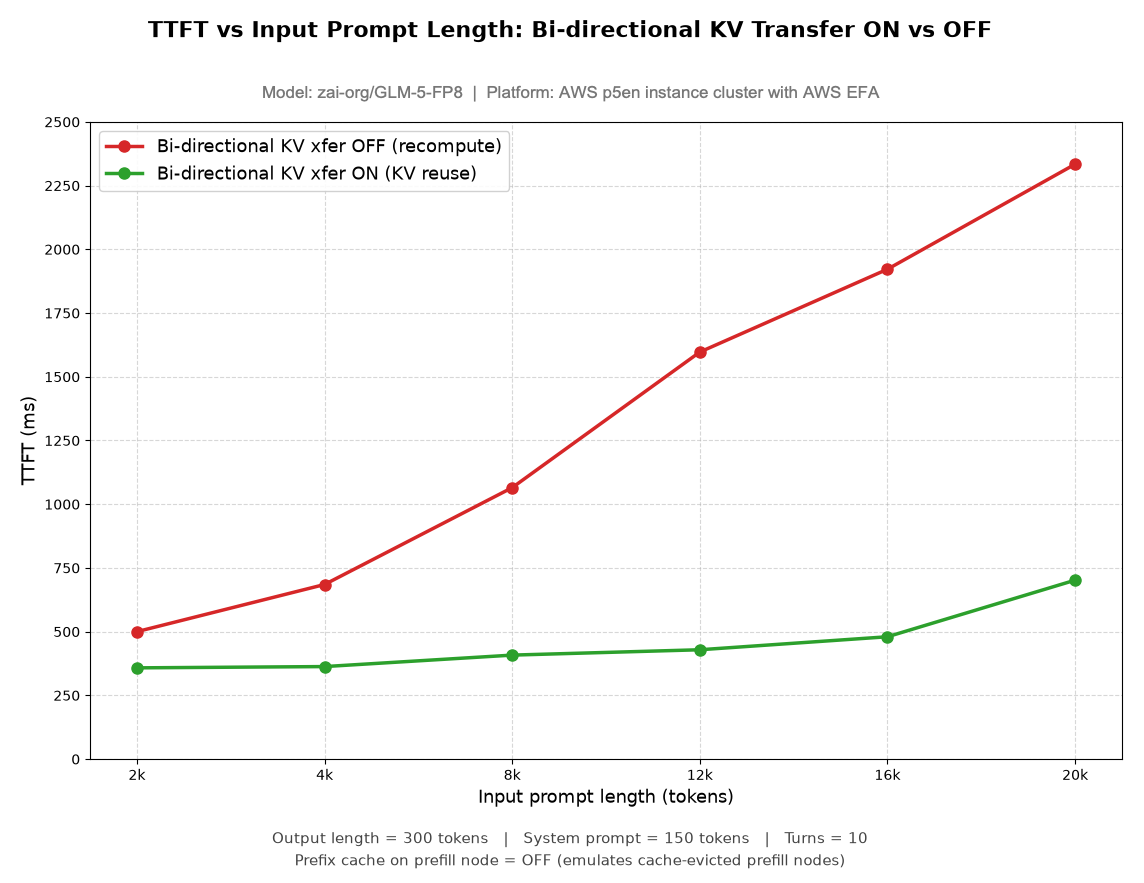
Figure 5 : TTFT de zai-org/GLM-5-FP8 avec réutilisation KV activée et désactivée
La seconde décompose la durée du prefill en ses composants de recalcul et de transfert KV.
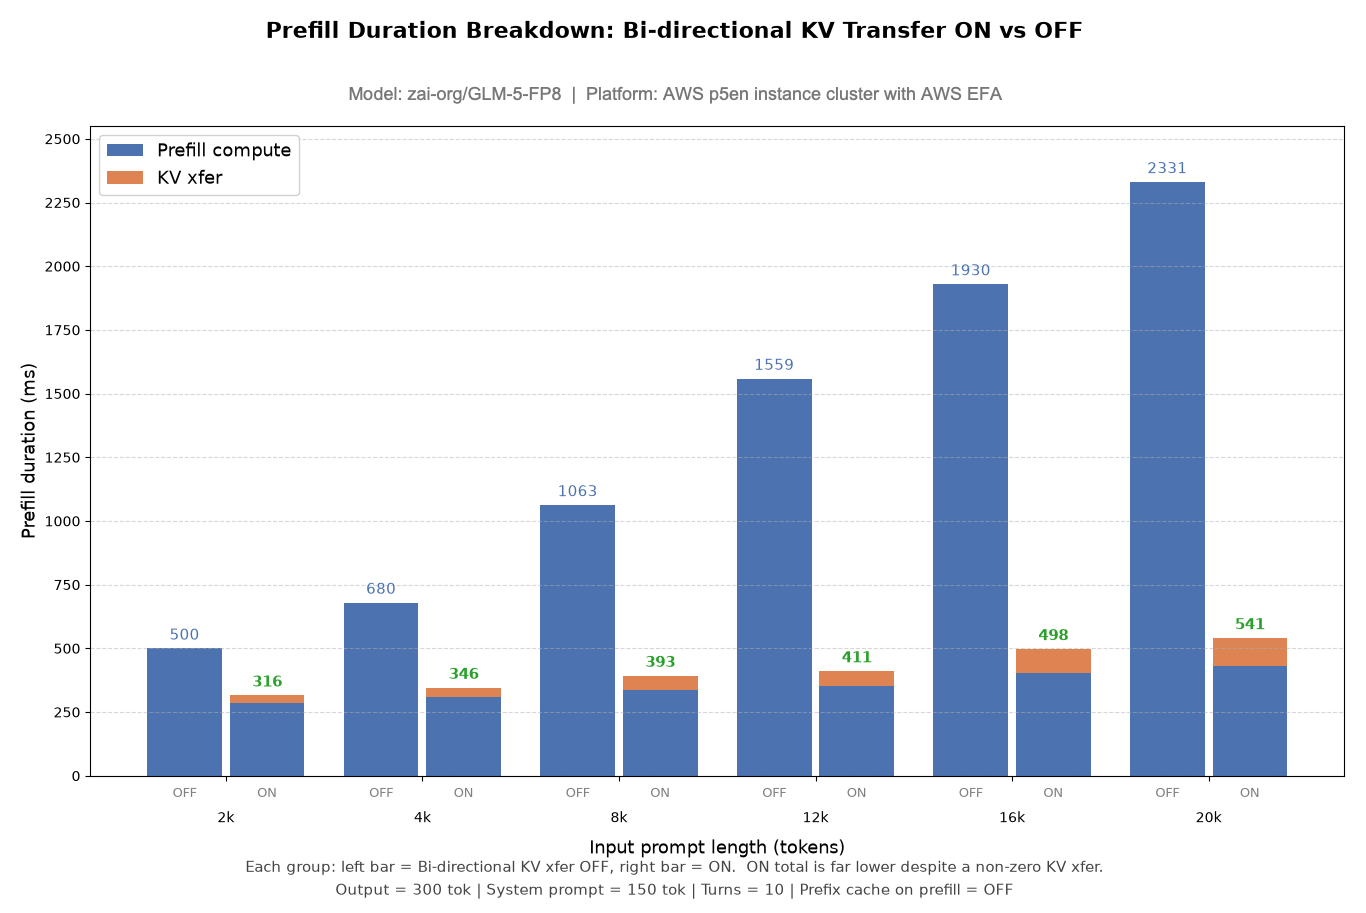
Figure 6 : décomposition de la durée de prefill de zai-org/GLM-5-FP8
GLM-5-FP8 montre un écart bien plus important que Qwen3-32B, avec un TTFT jusqu'à environ 3.3x plus faible pour les longs prompts, car son temps de recalcul plus élevé par jeton fait que la réutilisation KV est encore plus rentable à mesure que la longueur du contexte augmente.
Comment exécuter le benchmark
Pour reproduire notre configuration de benchmark 1P1D, un nœud de prefill et un nœud de décodage, à l'aide d'instances Amazon EC2 P5en avec EFA, suivez les instructions étape par étape dans le guide de reproduction de nos résultats. Le guide couvre la configuration de l'environnement, le lancement des serveurs de prefill et de décodage vLLM, l'exécution du benchmark et la collecte des résultats. La fonctionnalité peut s'exécuter sur d'autres configurations prises en charge, mais les résultats de performances varieront selon le matériel, le modèle, la charge de travail et la configuration réseau.
Conclusion
Dans cet article, nous avons montré comment le transfert bidirectionnel du cache KV peut réduire le TTFT à mesure que l'historique de conversation d'un agent grandit. Dans les déploiements désagrégés P-D, la fonctionnalité permet au nœud de prefill de réutiliser les blocs KV conservés par le nœud de décodage entre les tours, réduisant ainsi les calculs répétés. Des seuils configurables de rétention de blocs et de recalcul déterminent le moment où la réutilisation se produit. Sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées avec EFA, pour les longueurs de prompt les plus longues testées, nous avons observé des réductions de TTFT de 1.6x pour Qwen3-32B et de 3.3x pour zai-org/GLM-5-FP8. Les résultats dépendent de la charge de travail et de la configuration du déploiement. Pour implémenter cela dans votre environnement, utilisez vLLM v0.21.0 ou une version ultérieure avec NixlConnector, activez bidirectional_kv_xfer sur les serveurs de prefill et de décodage, utilisez un routeur tenant compte du kv-cache, et suivez le guide de reproduction sur GitHub.
Ressources associées
- AWS EFA
- Service désagrégé Prefill-Decode (P-D)
- Benchmark KV Cache Offloading with Multi-Turn Conversations
Remerciements
Nous remercions la communauté vLLM pour son soutien dans la maintenance de cette fonctionnalité.