
Comme la voix devient une modalité de première classe pour l’IA, les modèles de Deepgram couvrent la transcription par voix, la transcription par texte et les agents vocaux. Ils traitent actuellement des quadrillions de tokens audio par an pour plus de 200 000 développeurs et 1 400 organisations. Les clients les utilisent via l’API Deepgram ou les exécutent dans leurs propres environnements, y compris sur Amazon SageMaker AI.
Pour Deepgram, l’efficacité de service détermine la quantité d’audio que le système peut traiter pour un budget d’infrastructure donné. Les charges de travail en lot à haute intensité exercent une pression importante sur ce budget ; donc, plus chaque heure d’accélération est utilisée efficacement, plus Deepgram peut servir d’audio avec la même flotte. Cela a fait de l’efficacité de l’inférence un objectif naturel, et Deepgram s’est tourné vers les puces AI d’AWS pour l’améliorer. Ils ont collaboré avec AWS pour intégrer son modèle de traduction parlée à texte Nova-3 dans AWS Trainium2, afin de gérer des tâches en batch hors ligne telles que l’analyse des centres d’appels et la transcription médicale.
L’engagement a commencé avec Deepgram qui fournissait le Nova-3 en code PyTorch standard. Au cours de plusieurs mois, Deepgram et l’équipe AWS Forward Deployed Engineering (FDE) ont porté le Nova-3 vers AWS Trainium2 en reconstruction PyTorch, et l’ont ajusté pour s’adapter au nouveau matériel. La configuration finale permet de faire fonctionner huit répliques de modèle sur une instance Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge. Sur les charges de travail en lot orientées vers le débit, hors ligne de Deepgram, cette configuration génère 11–70 % plus d’audio par dollar que les options de calcul utilisées auparavant. Ces gains ont été mesurés en utilisant les tarifs des instances au moment de l’évaluation. Ces avantages permettent à Deepgram de se déployer efficacement, de livrer de meilleurs modèles et de les proposer aux clients à des prix plus bas. Ces bénéfices peuvent s’étendre aux clients qui hébergent eux-mêmes les modèles de Deepgram dans leur propre cloud privé virtuel (VPC) sur Amazon SageMaker AI. Là, Deepgram et AWS continuent d’améliorer la facilité d’installation, la fiabilité et l’observabilité.
Dans cet article, nous détaillons l’ensemble des efforts d’optimisation de l’inference effectués sur Trainium : la migration de Nova-3 vers l’environnement logiciel AWS Neuron, les ajustements au niveau du noyau qui ont suivi, le runtime Rust parallèle aux données qui permet aux serveurs de modèles propriétaires de Deepgram d’appeler Trainium, ainsi que les résultats en termes de débit et de coût mesurés lors de la transcription par lots.
Optimiser Nova-3 vers Nova-2 avec PyTorch natif
En commençant par le code standard de PyTorch, nous avons utilisé TorchNeuron, l’intégration native de PyTorch du Neuron Compiler, qui prend en charge à la fois l’exécution eager et torch.compile. Nous avons d’abord exécuté Nova-3 en mode eager sur Trainium2, puis vérifié quelles opérations se référaient au CPU, avant de compiler avec torch.compile. Le chemin compilé a exécuté toutes les opérations du modèle sur Trainium2, sans détection de redondance avec le CPU.
Nous avons compilé l’encodeur et le décodeur en graphiques de forme statique distincts en utilisant torch.compile. Au cours de ce processus, nous avons vérifié la précision numérique à deux niveaux : la cohérence de l’output au niveau des couches par rapport à la CPU, et le taux d’erreur de mots end-to-end (WER), qui devait respecter les valeurs de référence et les objectifs de Deepgram.
À partir de cette base de travail, nous avons commencé les travaux d’optimisation en remplaçant plusieurs couches par des noyaux fusionnés provenant de la bibliothèque publique NKI Library (NKILib), une collection de noyaux de référence préconstruits écrits avec l’interface de noyau Neuron (NKI). Ces noyaux couvrent des opérations telles que les projections QKV fusionnées, les couches de réseau feed-forward fusionné (FFN) et la convolution 1D en profondeur.
Nous avons optimisé pour le débit et, par conséquent, l’efficacité coûts, en ciblant les charges de travail d’inférence hors ligne de Deepgram. Le débit est indiqué comme une gain relatif par rapport à une configuration de base, plutôt que comme un nombre absolu de sons traités par seconde. Nous avons testé des tailles de lot allant de 1 à 128 pour trouver la taille de lot qui maximise le débit.
Ajustement au niveau du noyau avec Neuron Explorer et NAD
Activer les noyaux est seulement la première étape d’un cycle d’optimisation : activer un noyau NKI (personnalisé ou provenant de NKILib), profiler la charge de travail, puis soit ajuster le noyau existant, soit le remplacer par un nouveau noyau en fonction des informations obtenues lors du profilage. Ce cycle se répète jusqu’à ce que l’objectif de performance soit atteint. À chaque étape, une partie différente de la pile Neuron accélère le travail : NKILib fournit des noyaux de remplacement faciles à intégrer, Neuron Explorer est l’outil de référence pour l’analyse des charges de travail Neuron, et le toolkit Neuron Agentic Development (NAD) accélère l’analyse d’analyse et la mise à jour des noyaux grâce à ses compétences en analyse d’analyse et en écriture de noyaux.
Dans notre cas, les noyaux NKILib nous ont menés à la plupart du chemin, et l’analyse de performance a révélé où un noyau écrit manuellement serait plus efficace. À chaque fois, les compétences en analyse de performance de NAD nous ont menés d’un profil Neuron Explorer à une cause racine, et les compétences en écriture de noyaux de NAD ont aidé à produire les noyaux de remplacement.
| Layer | Ce que nous avons découvert et modifié | Gain |
| FFN | Le plan de tiling du noyau de référence a réinitialisé l’ensemble des poids de projection depuis la mémoire hors chip pour chaque tuile de token, ce qui limite le débit de mémoire à mesure que le nombre de tokens augmente. Notre noyau ajusté manuellement charge chaque tuile de poids une fois, la réutilise entre plusieurs tuiles de token, et conduit les lectures de poids avec le calcul en chip. | 2,0x moins de latence par rapport au noyau de référence à l’échelle de lot de 96 |
| Profondeur 1 conv1d | Le noyau expérimental NKILib a présenté l’opération sous forme d’une multiplication matricielle générale implicite (GEMM), ce qui a réduit l’utilisation du Tensor Engine. Nous l’avons remplacé par un cycle de multiplication et d’accumulation diffusée sur le Vector Engine, permettant ainsi une utilisation complète de l’engin, suffisante pour compenser le faible débit maximal du Vector Engine. | 1,5x accélération par rapport au noyau de référence à l’échelle de lot 96 |
| Conv2d | Les couches conv2d du modèle rencontrent un obstacle de compilation : au-delà de la taille de lot de 32, ces couches empêchent le modèle de se comporter comme un seul graphique. Comme NKILib ne disposait pas de noyau conv2d, nous avons écrit un noyau à partir de zéro dans NKI. Le noyau a subi plusieurs itérations basées sur les données du profiler, conformément au mécanisme décrit précédemment, ce qui a permis d’accéder à des tailles de lot supérieures à 32. | Jusqu’à 50 fois sur le module de convolution avec des tailles de lot ≤32 |
Exécution parallèle de données en Rust
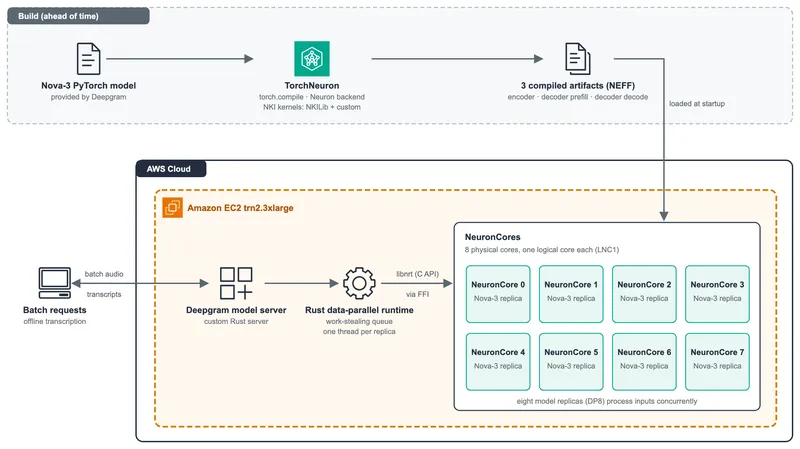
Chaque dispositif Trainium2 dispose de huit Cœurs Neuronaux physiques, qui sont exposés par défaut sous forme de quatre Cœurs Neuronaux logiques (LNC2). Comme chaque instance du modèle Nova-3 peut se placer confortablement sur un seul cœur physique, nous avons réduit le nombre de cœurs physiques par cœur logique à un (LNC1). Cette configuration permet de héberger huit répliques de modèle (DP8) par dispositif Trainium2. Les entrées sont traitées simultanément, maximisant ainsi le débit par dispositif. Le temps de exécution parallèle de données est piloté par une file d’attente de vol de travail, avec un thread pour chaque réplica.
La stack de service de production de Deepgram est écrite en Rust, donc la portabilité de Nova-3 vers Trainium2 nécessitait plus que la compilation du modèle : il fallait également fonctionner sans Python ou PyTorch dans le processus de service. Nous avons donc développé un runtime léger dans lequel Rust coordonne les répliques du modèle via une file de partage de travail. Une couche C charge et exécute en amont-compilée les fichiers exécutables du format NEFF directement via l’API du runtime Neuron (libnrt). Le runtime s’intègre directement à l’architecture de service de Deepgram et reproduit exactement les séquences de tokens de référence pour chaque taille de lot testée.
Nous l’avons comparé avec les temps de exécution parallèle en Python (MT) et le multiprocesseur (MP). Par rapport au point de base MP, le temps de exécution Rust élimine complètement la surcharge liée à l’interpréteur Python. Par rapport au point de base MT, il soulage encore davantage la serialization liée au verrou global de l’interpréteur (GIL), de sorte que les appels de dispatch provenant des threads de travail concurrents ne se font plus en conflit au sein d’un même processus. Ces gains sont importants, car Nova-3 effectue une série de petites appels de décodeur pour chaque morceau audio, ce qui fait que le dépassement côté hôte constitue un goulot d’étranglement lors des tailles de lot faibles. L’amélioration du débit est donc la plus importante là-bas, et reste significative même à la taille de lot maximisant le débit. Là, le runtime Rust a apporté une augmentation du débit de 7,5 % par rapport au modèle basique en Python multiprocesseur.
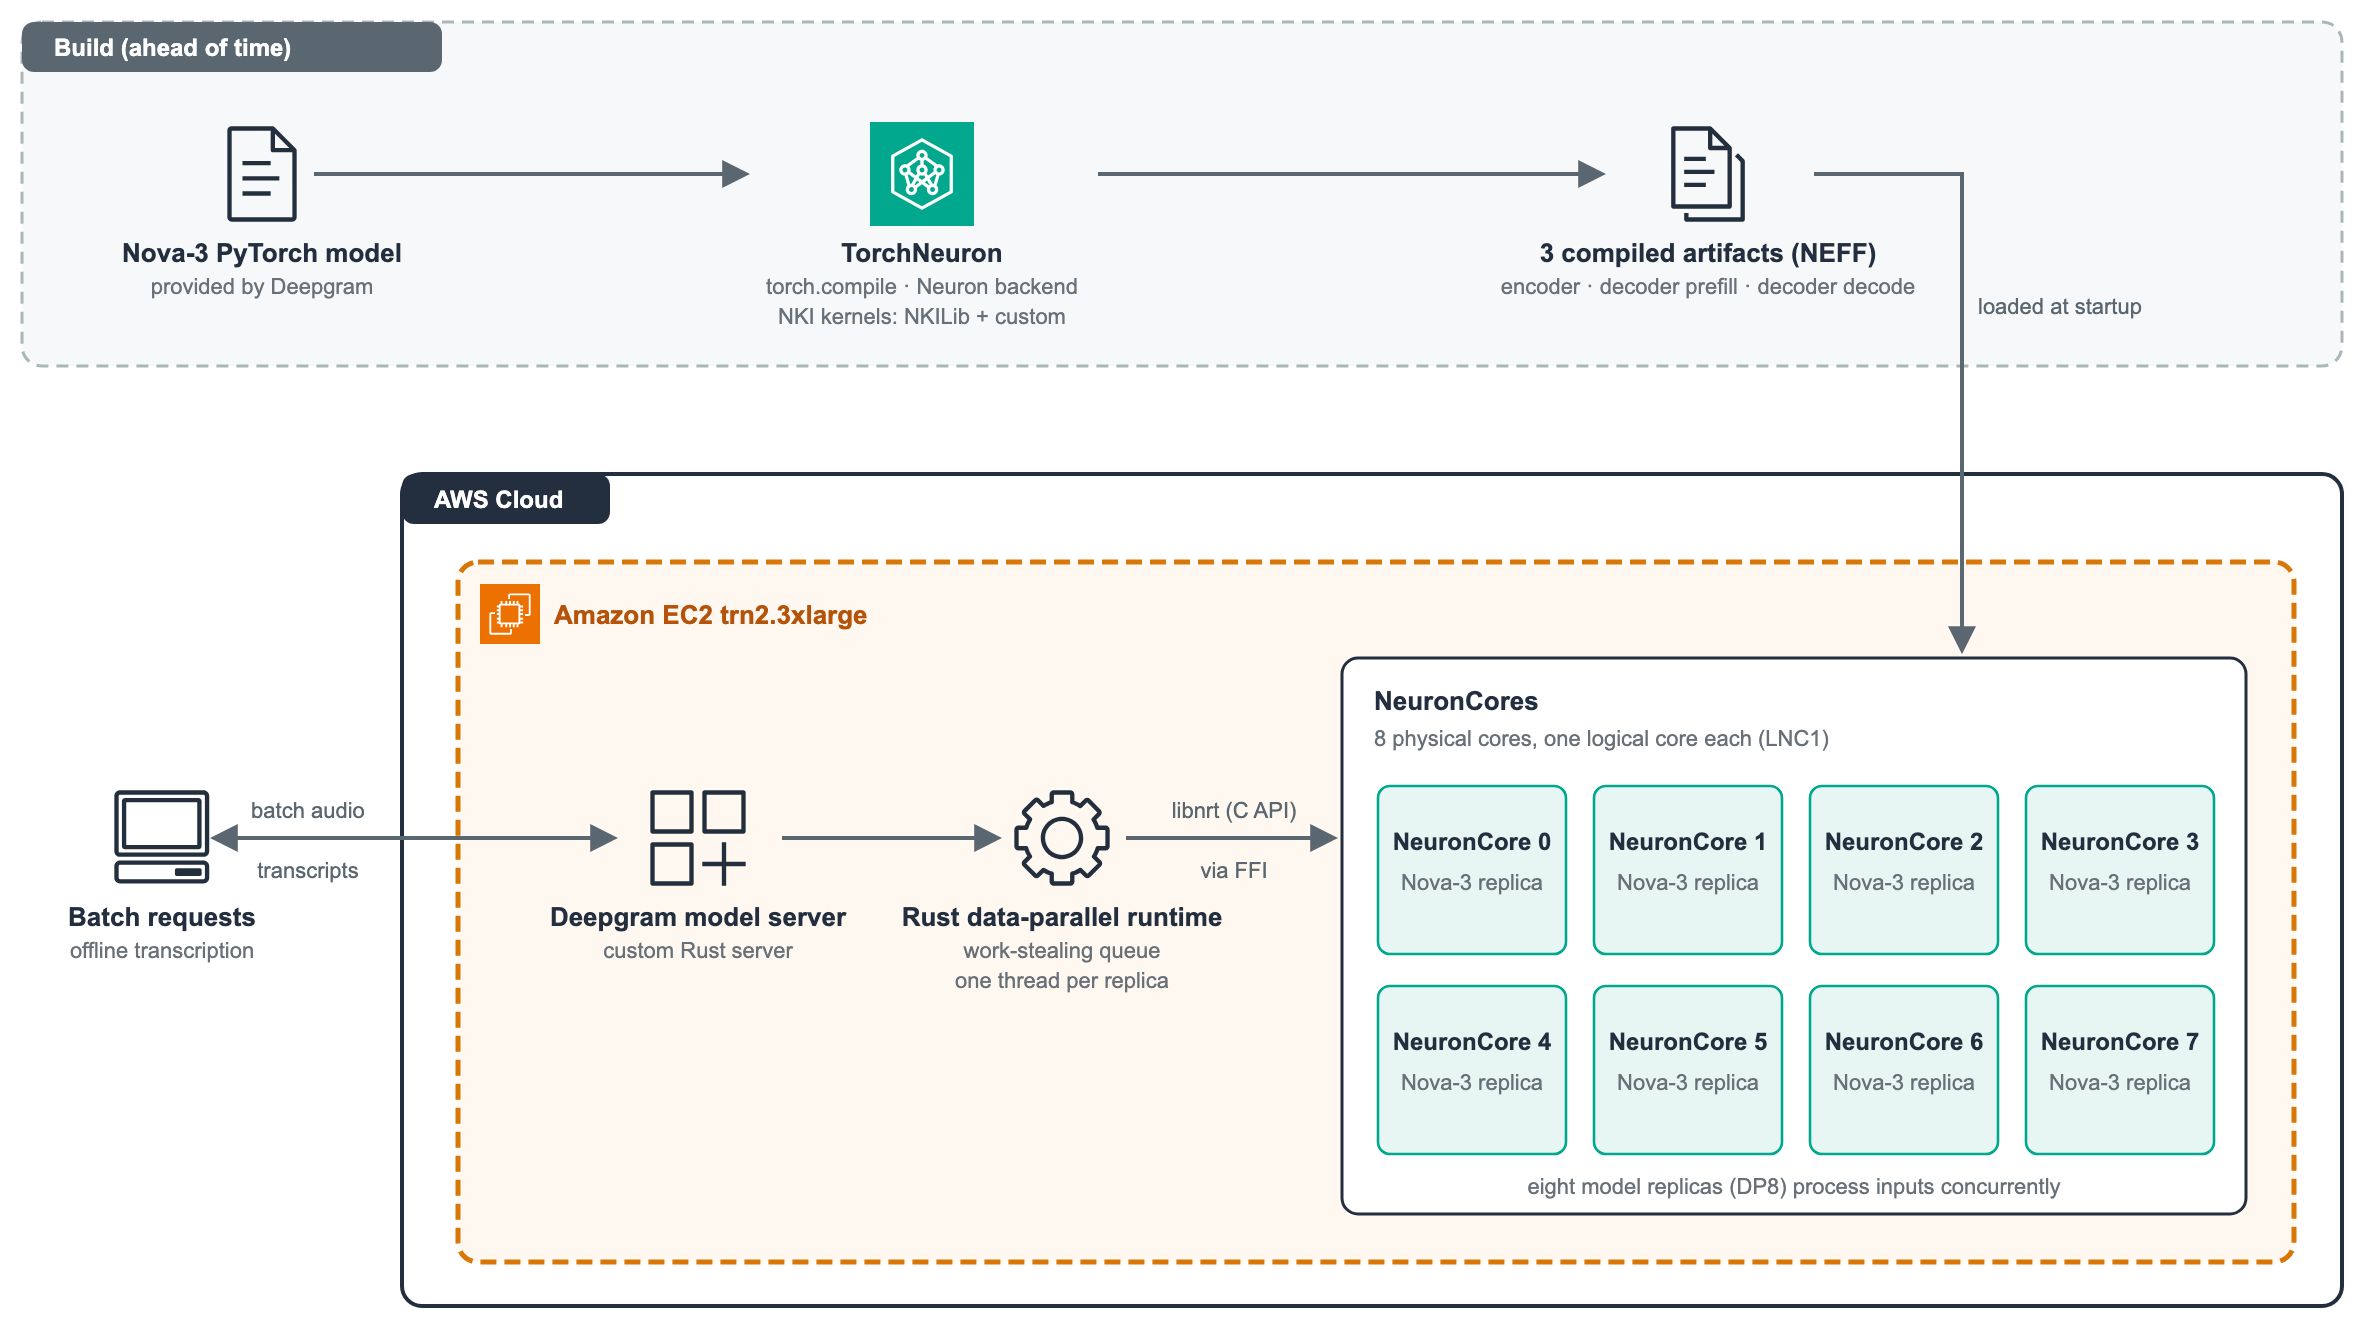
Figure 1 : Deepgram Nova-3 sur AWS Trainium2, compilé à l’avance et servi par Rust
Impact sur l’économie de coûts
Nous avons mesuré le rapport prix-performance en termes de son par dollar. Sur les charges de travail par lot orientées vers la vitesse d’exécution en mode hors ligne de Deepgram, l’installation Trainium2 pour un seul appareil (trn2.3xlarge) a traité de 11 à 70 % plus d’audio par dollar que les options de calcul utilisées par Deepgram.
Conclusion
Dans cet article, nous avons montré comment Deepgram et l’AWS FDE ont porté le modèle de parler à texte Nova-3 de PyTorch sur le matériel Trainium en utilisant TorchNeuron, qui offre une intégration native avec le framework PyTorch pour AWS Trainium. Nous avons amélioré les performances en remplaçant directement les couches par des noyaux prêts à l’emploi provenant de NKILib. Ensuite, nous avons évalué les performances à l’aide de Neuron Explorer et avons utilisé les compétences de profilage NAD pour interroger les données de profilage et accélérer le débouchage des problèmes de performance. En nous basant sur ces observations, nous avons adapté le code source du noyau en utilisant les compétences de rédaction de noyaux NAD. Enfin, nous avons créé un runtime data-parallel léger en Rust pour AWS Trainium, appelant l’API Neuron Runtime depuis Rust. Notre configuration a permis d’obtenir des économies de coûts dans les scénarios orientés sur le débit hors ligne, validant ainsi AWS Trainium comme une option viable et efficace pour les charges de travail d’inférence de Deepgram.
Pour tester cette approche sur vos modèles personnels, commencez par la documentation AWS Neuron, qui couvre le compilateur, le runtime et les frameworks pris en charge. Le guide de la Interface du noyau Neuron (NKI) explique comment écrire les noyaux décrits dans cet article, et le répertoire de samples NKI contient les noyaux de référence dont nous avons partagé les exemples. La documentation des outils de développement Neuron couvre le profilage et les outils agentiques que nous avons utilisés ici, y compris Neuron Explorer et Neuron Agentic Development. Pour plus d’informations sur les tailles et les prix, consultez les instances Amazon EC2 Trn2. Pour obtenir de l’aide concernant la conception d’une version similaire, contactez l’équipe Engineering AWS Forward Deployed.