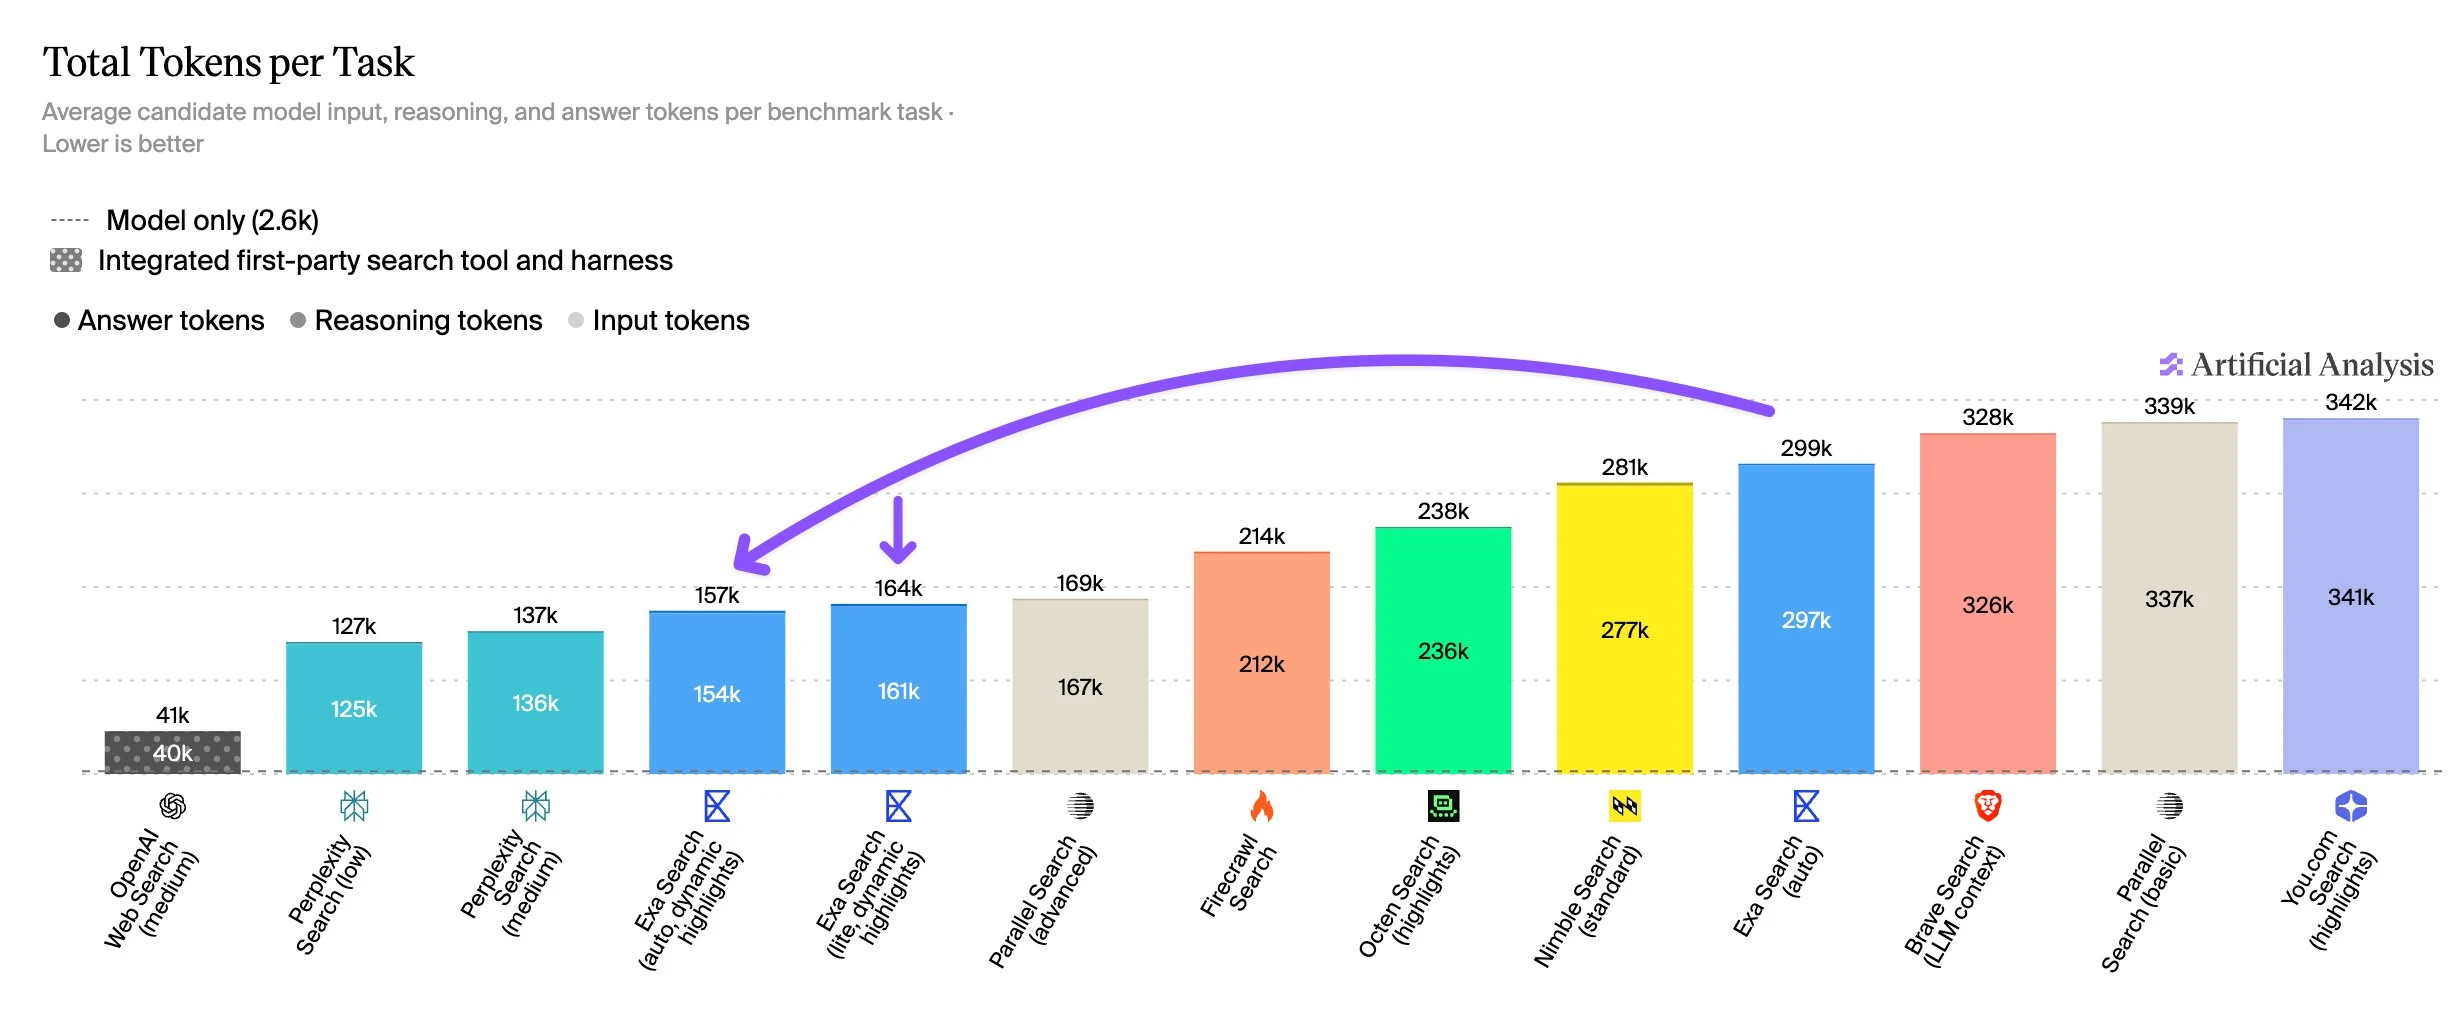
Nombre total de tokens par tâche mesure les tokens d'entrée, de raisonnement et de sortie du modèle
Exa (auto, Dynamic Highlights) utilise 157k tokens par tâche, soit 47 % moins que l’auto avec les highlights standards (299k). Exa (lite, Dynamic Highlights) utilise 164k tokens, soit une réduction de 45 %.
Les Highlights dynamiques réduisent la quantité de contenu recherché retourné au modèle, diminuant ainsi la consommation de tokens et les coûts d’inférence du modèle. Parmi les API de recherche, seuls Perplexity (faible, 127k) et Perplexity (moyen, 137k) utilisent moins de tokens par tâche