
MiniMax M3.1 Flash montre qu’il n’y a pas de limite visible dans la course des prix de l’IA en Chine.
 Matthias Bastian
Voir le profil LinkedIn de Matthias Bastian
19 oct. 2026
 Nano Banana Pro demandé par THE DECODER
Jusqu’à quel point l’IA peut être économique ? La Chine : Oui !
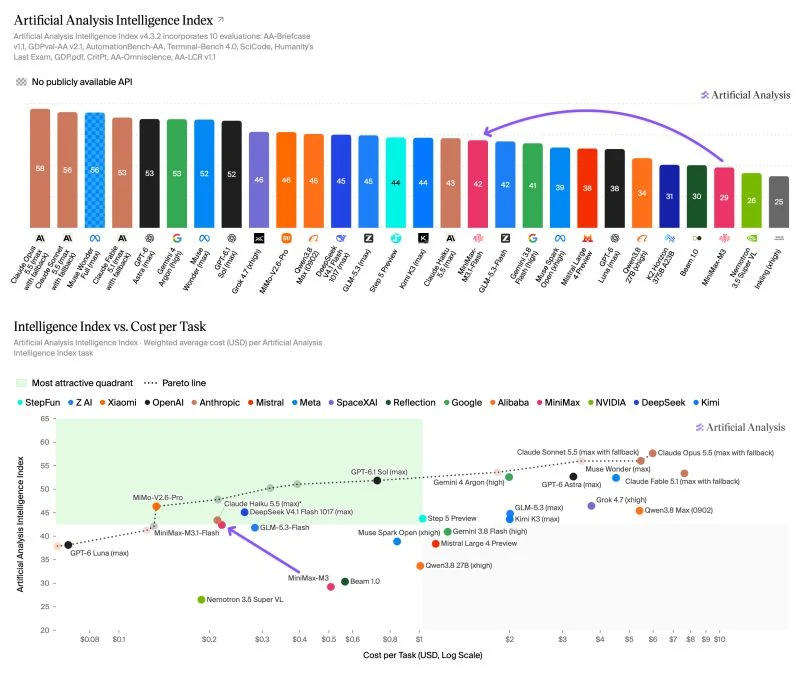
MiniMax a lancé M3.1 Flash, un nouveau modèle de raisonnement qui obtient 42 points sur l’Indice d’Intelligence d’Analyse Artificielle. Cela représente une augmentation de 13 points par rapport à son prédécesseur M3, et le coût par tâche est inférieur à moitié. Le modèle s’aligne avec GLM-5.3-Flash, dépasse Gemini 3.8 Flash (41) et est en retard par rapport à Deepseek V4.1 Flash 1017 (45).
La raisonnement complexe a connu la meilleure amélioration. Sur le « dernier examen de l’humanité », M3.1 Flash atteint 48 %, dépassant à la fois Deepseek et GLM. Il obtient également 22 % sur le CritPt benchmark, qui teste le raisonnement en physique de niveau de recherche sur 71 problèmes complexes. Cela le place devant GLM-5.3-Flash (15 %) et Gemini 3.8 Flash (18 %), mais juste derrière Deepseek (24 %). Pour la précision factuelle sur l’examen AA-Omniscience, M3.1 Flash répond correctement à 56 % des questions, bien plus que GLM-5.3-Flash (28 %) et Deepseek (43 %).
Le modèle utilise également beaucoup moins de tokens de sortie que ses concurrents, ce qui réduit le coût par tâche à environ 0,22 $. MiniMax indique qu’il fonctionne trois fois plus rapidement que M3. Un point faible est son taux de hallucination de 93 %, car le modèle essaie de répondre à chaque question de test plutôt que de refuser lorsqu’il est incertain, selon Artificial Analysis.Ad
Le modèle gère jusqu’à un million de tokens de contexte et accepte à la fois du texte et des images. Les tarifs de l’API s’élevent à 0,15 $ par million de tokens d’entrée et 0,60 $ par million de tokens de sortie, avec un coût de 0,015 $ pour les entrées stockées. Le plan MiniMax permettra de lancer le modèle en poids ouvert le 23 octobre. L’API est disponible à platform.minimax.io, et MiniMax propose également une application de bureau appelée MiniMax Code.
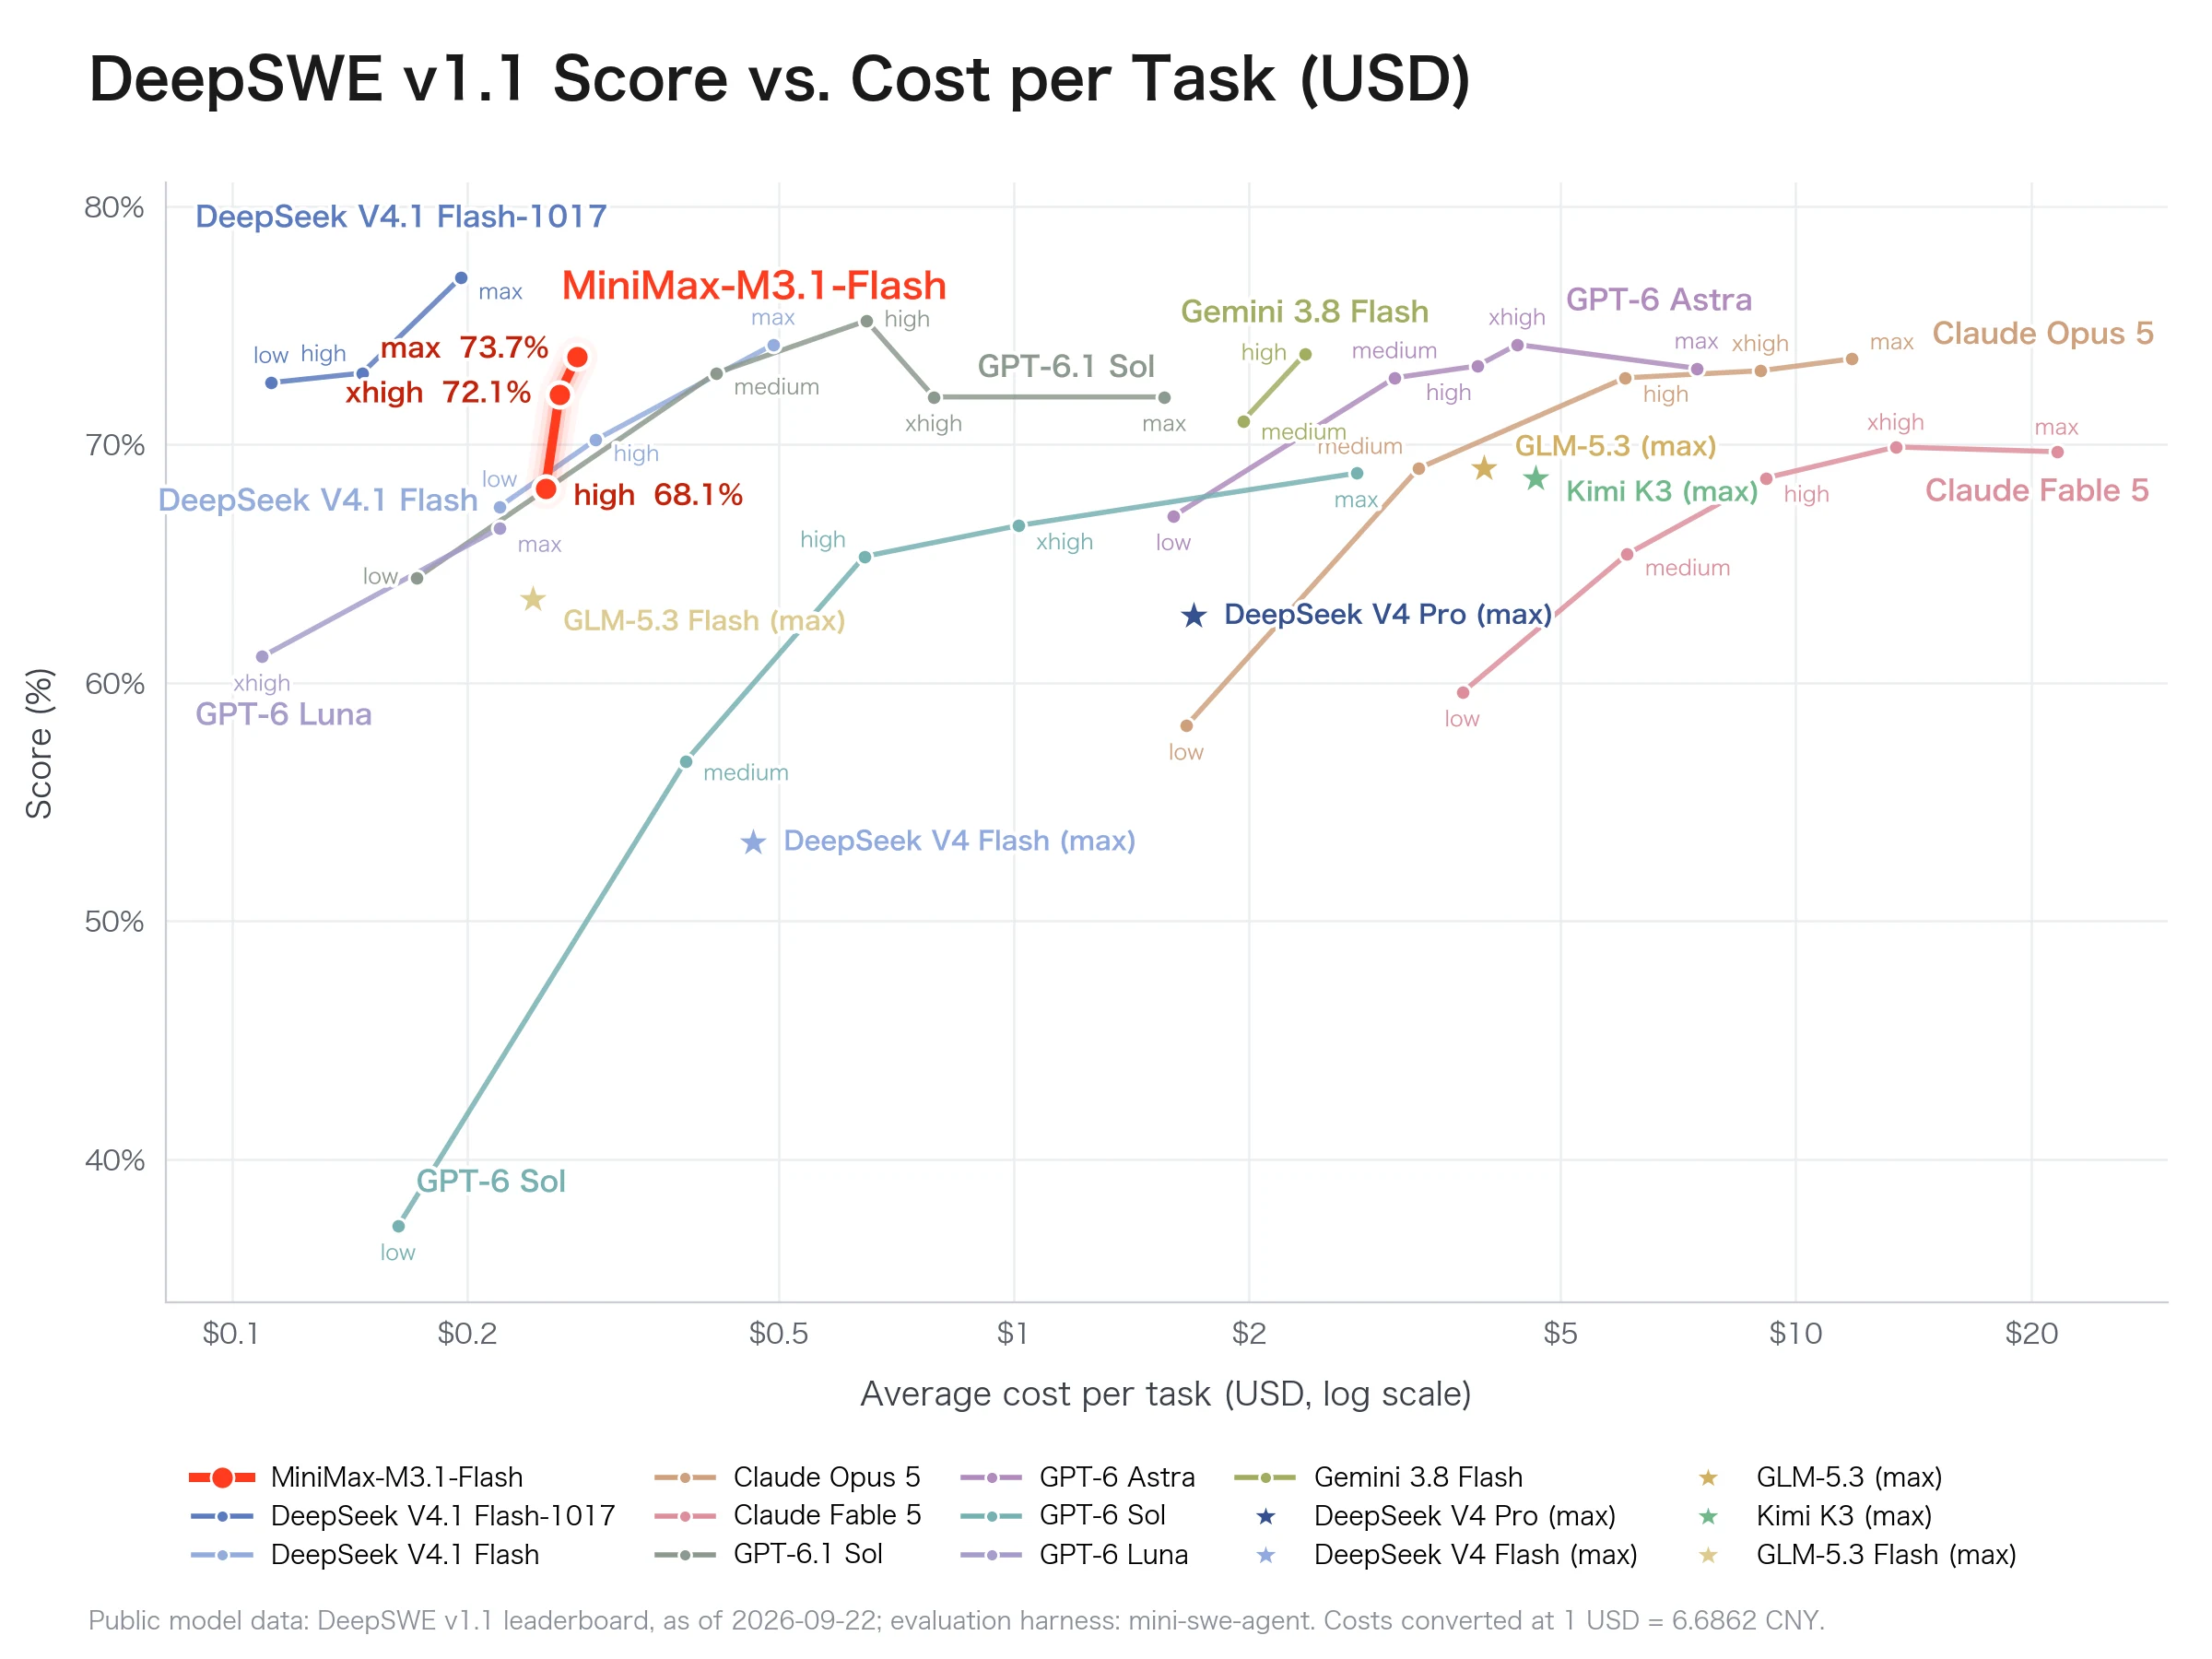
Deepseek et MiniMax se partagent les résultats dans la dernière bataille de prix en Chine
Comparé face à face avec le Deepseek V4.1 Flash 1017 récemment sorti, aucun modèle ne gagne partout. Deepseek devance sur l’Indice d’Intelligence avec 45 points contre 42 de MiniMax, et a une légère avance sur le benchmark CritPt avec 24 % contre 22 %.
MiniMax se distingue sur les autres tests. Il obtient 48 % sur « L’ultime examen de l’humanité », tandis que Deepseek atteint 43 %. Pour garantir la précision factuelle sur le test AA-Omniscience, MiniMax répond correctement à 56 % des questions, contre 43 % pour Deepseek. De plus, MiniMax est légèrement moins coûteux par tâche : 0,22 $ contre 0,26 $ pour Deepseek, car il nécessite moins de tokens de sortie sur l’ensemble du benchmark, environ 189 millions contre 224 millions pour Deepseek.
Les deux modèles sont sortis sous forme de version ouverte. Deepseek est déjà sur Hugging Face, et MiniMax sera suivi le 23 octobre.
Nouvelles sur l’IA Sans Hype – Sélectionnées par des humains
Abonnez-vous à THE DECODER pour une lecture sans publicités, un bulletin hebdomadaire sur l’IA, notre rapport exclusif « AI Radar » six fois par an, un accès complet à l’archive, et un accès à notre section de commentaires.
Source : Artificial Analysis | Minimax