
Traditionnellement, changer le nombre de GPU dans un service vLLM nécessitait d'ajouter ou de retirer des réplicas entiers du modèle ou de redémarrer le moteur avec un nombre de GPU différent. À mesure que les modèles grossissent, chaque réplica nécessite plus de GPU, donc la mise à l'échelle par réplica ajoute ou retire des GPU par incréments de plus en plus importants. Redémarrer vLLM pour faire passer DeepSeek V4 Pro de 16 à 20 GPU GB200 interrompait le service pendant 197 secondes (voir la section sur les performances pour plus de détails), laissant ces GPU coûteux alloués sans générer de tokens.
Dans notre premier article sur Elastic EP, nous avons montré comment vLLM pouvait ajouter ou retirer des GPU d'un déploiement DEP en cours d'exécution (attention en parallèle de données avec MoE en parallèle d'experts) sans le redémarrer. Bien que nous ayons évité un redémarrage, le service s'interrompait quand même pendant toute la reconfiguration, le temps d'initialiser les nouveaux workers, de préparer les groupes de communication élargis, de charger les poids du modèle, et de répéter le warmup des kernels et la capture des graphes CUDA. Dans notre benchmark DeepSeek V4 Pro, cette pause durait 100 secondes lors du passage de 16 à 20 GPU et 56 secondes lors du retour à 16 GPU (tous les détails dans la section sur les performances).
Dans cet article, nous décrivons comment la préparation asynchrone et NIXL EP ont permis une reconfiguration Elastic EP avec une indisponibilité quasi nulle. Dans le même benchmark, nous avons réduit l'indisponibilité à 0.82 seconde lors du passage de 16 à 20 GPU et 1.96 seconde lors du retour à 16 GPU, ce qui nous a permis de monter et descendre en puissance avec presque aucun impact sur les performances de service.
Chevauchement de la préparation de la topologie avec le service
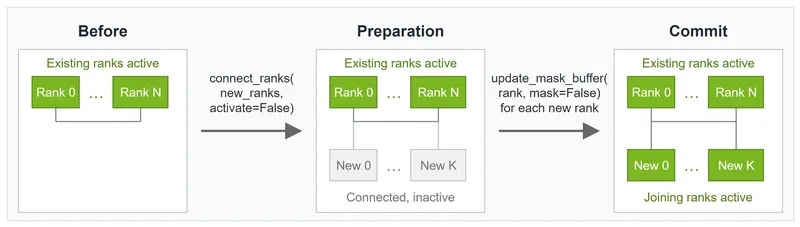
Nous avons réorganisé le flux de reconfiguration de vLLM en deux phases : une préparation en arrière-plan et une courte validation (commit). Les workers existants utilisent des threads d'arrière-plan séparés pour préparer et réchauffer la communication cible, transférer les poids du modèle et synchroniser les informations liées à l'exécution (telles que les résultats d'autotuning) avec les workers entrants, tout en continuant à servir les requêtes avec leurs groupes de communication et graphes CUDA actuels. En parallèle, les workers entrants s'initialisent, reçoivent les poids du modèle et préparent leur communication et leur exécution GPU. Pendant la phase de validation, vLLM met brièvement en pause ses ordonnanceurs, active la topologie préparée et reprend le service. Ces changements ont été introduits dans la préparation asynchrone et les optimisations prepare/commit.
La préparation couvre quatre tâches principales :
- Initialiser les workers entrants. Démarrer leurs processus et allouer le stockage pour le modèle et l'exécution.
- Préparer la communication. Configurer les groupes de communication cibles et étendre le communicateur EP.
- Transférer les poids du modèle. Transférer les poids requis des workers existants vers les workers entrants via NVLink ou RDMA.
- Préparer l'exécution. Effectuer sur les workers entrants la compilation requise, le warmup des kernels, la configuration du tuning et la construction des CUDA graphs.
Après la phase de commit, l'équilibrage de charge Expert Parallel asynchrone (EPLB) permet aux nouveaux workers de commencer à gérer l'attention tandis que les workers existants gèrent le calcul des experts. EPLB redistibue ensuite les experts dans le groupe étendu en arrière-plan.
Le principal défi consiste à préparer la communication et l'exécution GPU sans impliquer ni perturber les workers qui servent des requêtes.
Étendre la communication EP en place
Avant NIXL EP, les backends de communication EP disponibles dans vLLM utilisaient une appartenance fixe : chaque instance était créée pour un ensemble spécifique de ranks. Ajouter ou retirer des ranks nécessite une nouvelle instance. Même lorsque cette instance peut être créée en arrière-plan, deux problèmes subsistent.
Premièrement, les anciennes et nouvelles instances nécessitent des tampons de communication et d'autres ressources distincts, y compris les enregistrements mémoire, les handles IPC et les RDMA Queue Pairs (QPs). Maintenir les deux instances actives augmente l'utilisation mémoire de la communication et exige de répéter la configuration plutôt que de réutiliser les ressources existantes.
Deuxièmement, le changement de communicateur EP modifie les tampons et l'état de communication utilisés par les kernels de communication EP. Cela invalide les CUDA graphs précédemment capturés, qui doivent être recapturés avant de reprendre le service. Cela nécessite de répéter le warmup et la construction de graphes pour de nombreuses formes de batchs sur tous les workers conservés. Dans notre benchmark DeepSeek V4 Pro, même avec une préparation asynchrone, l'exécution du warmup et de la recapture des graphes pendant la phase de commit a entraîné des pauses de service de 58 secondes lors du scale-up et 44 secondes lors du scale-down.
Pour résoudre ces problèmes, nous avons conçu NIXL EP, une bibliothèque de communication EP conçue sur mesure pour Elastic EP. Elle ajoute ou retire des ranks en place, en réutilisant le même agent NIXL, les mêmes tampons et les mêmes connexions. De nouveaux pairs peuvent être connectés pendant que les workers existants continuent de servir, et seuls les pairs entrants ont besoin de nouvelles connexions et enregistrements. NIXL EP conserve également la validité des entrées EP dispatch et combine capturées lors des reconfigurations, permettant aux workers conservés de réutiliser leurs CUDA graphs existants.
Pendant la préparation, le thread d'arrière-plan de vLLM connecte les pairs qui rejoignent sans les activer. La phase de commit active ensuite les pairs préparés sans remplacer le communicateur.
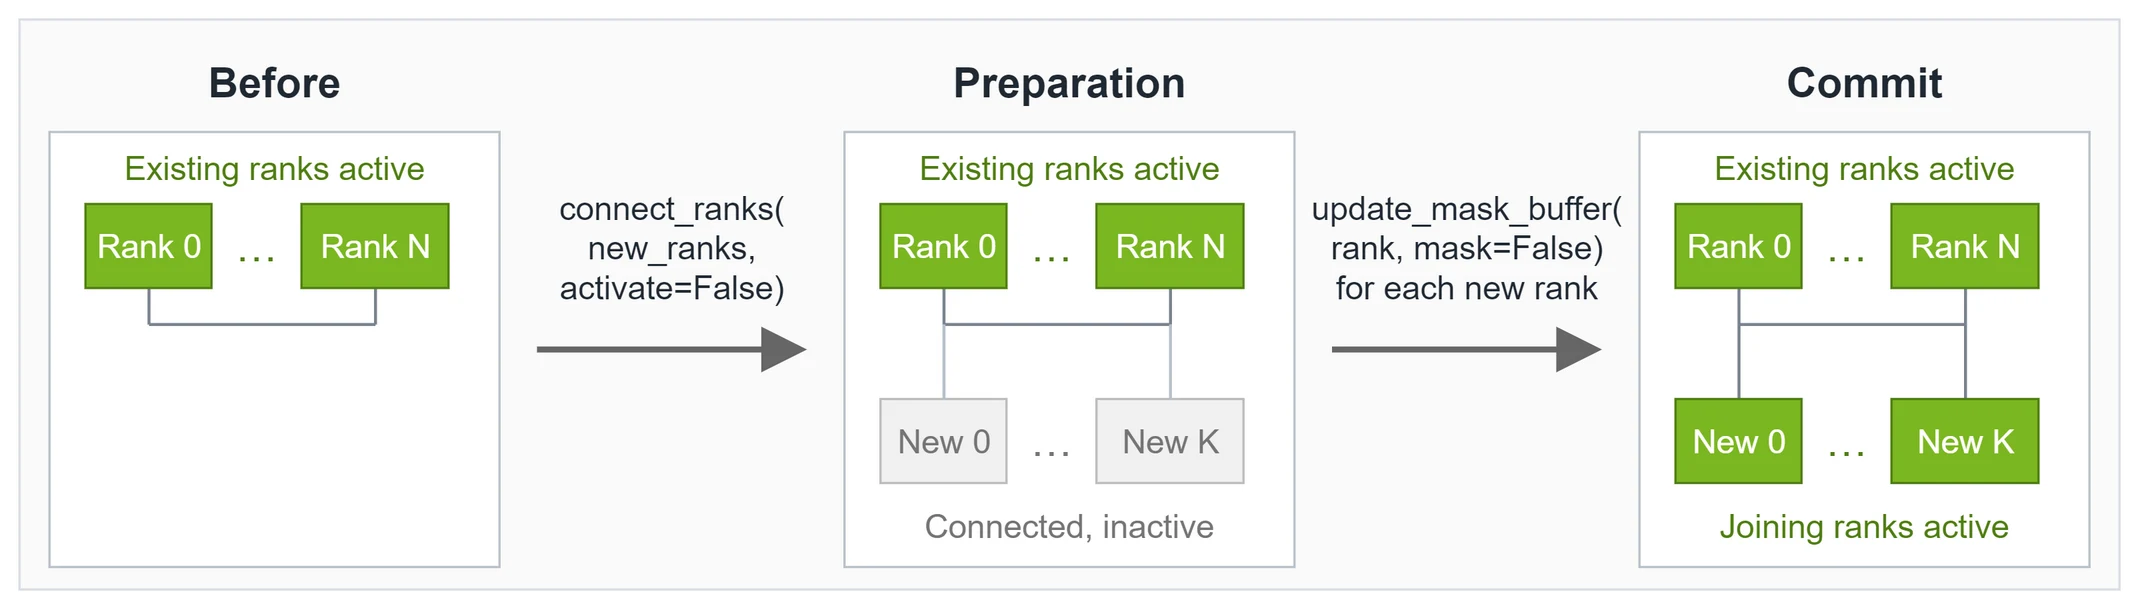
Figure 1. Connexion et activation de nouveaux pairs EP. Les rangs verts sont actifs ; les rangs gris sont connectés mais masqués. Pendant la phase de commit, les nouveaux pairs sont activés sans remplacer l'agent ni les tampons.
vLLM crée toujours de nouveaux groupes de coordination DP et groupes EPLB pour la topologie cible, mais leur communication s'exécute en dehors du passage avant capturé du modèle, de sorte que la bascule vers eux n'invalide pas les graphes CUDA.
Préserver les graphes CUDA sur les workers existants
Un graphe CUDA enregistre les opérations GPU afin que vLLM puisse rejouer un passage avant sans relancer chaque opération depuis le CPU à répétition. Un nœud de kernel capturé inclut sa configuration de lancement et ses valeurs d'arguments, y compris les pointeurs vers les tenseurs d'entrée et de sortie. Le contenu de la mémoire peut changer entre les rejeux, mais les pointeurs enregistrés doivent rester valides. Ces exigences font partie du contrat d'exécution des graphes CUDA.
vLLM capture des graphes distincts pour différentes formes de batch et modes d'exécution et exécute des passages avant d'échauffement avant chaque capture.
Préserver les graphes CUDA capturés exige plus que le simple maintien en vie de l'objet communicateur. NIXL EP maintient également stables les configurations de lancement des kernels, les arguments de communication visibles par le graphe, et les adresses des tenseurs d'entrée et de sortie lors de la reconfiguration. Ses kernels lisent l'appartenance au groupe actif à partir d'un état de périphérique qui peut être mis à jour sur place.
Nous avons également modifié vLLM pour maintenir stables les arguments capturés, les configurations de lancement et les adresses des tenseurs d'entrée et de sortie des kernels de calcul environnants lors de la reconfiguration :
- Nous réutilisons les objets d'exécution fused-MoE conservés des workers existants au lieu de les reconstruire pour une taille EP active différente.
- Nous maintenons stables les adresses et dispositions des espaces de travail visibles par le graphe et des sorties de dispatch lors de la reconfiguration, afin que les kernels d'experts capturés puissent continuer à les utiliser. Les sorties de dispatch servent également d'entrées au calcul des experts. Si leurs adresses ou dispositions changeaient avec la taille EP, les kernels d'experts capturés utiliseraient toujours les anciens pointeurs et décalages.
- Nous préservons le stockage sous-jacent des tenseurs de routage des experts et mettons à jour les mappings sur place. Cela permet à EPLB de modifier le contenu des mappings sans déplacer les tenseurs utilisés par les kernels capturés.
Ensemble, ces changements permettent aux workers conservés de réutiliser leurs graphes CUDA existants après une montée comme une descente en échelle.
Préparer les workers entrants de manière indépendante
Les workers existants ont des graphes à préserver. Les workers entrants n'en ont aucun.
Les workers entrants se préparent normalement en exécutant des passages avant du modèle avec le dispatch et le combine EP, ainsi qu'en échangeant des informations de batch avec d'autres workers. Ces étapes exigent la participation d'autres workers, mais les workers existants servent déjà de vraies requêtes sur la topologie actuelle.
NIXL EP permet à chaque worker entrant de masquer temporairement tous les pairs EP distants pendant l'échauffement et la préparation des graphes. Seul le rang local de ce worker est actif pour la communication EP. Nous avons également modifié vLLM afin que ces passes de préparation n'attendent pas les informations de batch DP des autres workers. Cela permet aux workers entrants d'exécuter leurs batchs fictifs et de capturer des graphes CUDA sans exiger la participation des workers existants.
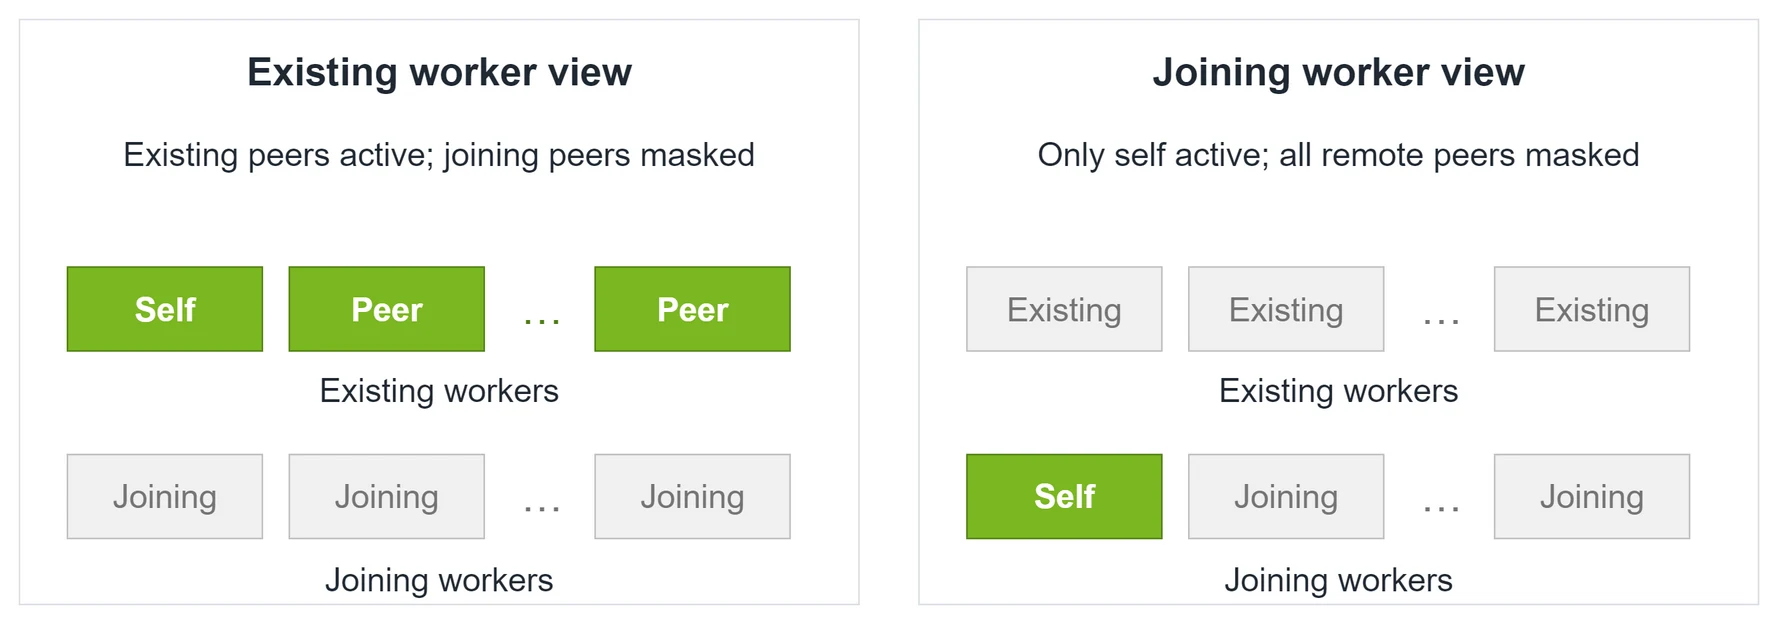
Figure 2. Les rangs verts sont actifs pour la communication EP ; les rangs gris sont masqués. Les workers existants servent ensemble tandis que chaque worker entrant masque tous les pairs EP distants pour la préparation.
Après la capture, NIXL EP peut réactiver les pairs sans invalider les graphes. Les workers entrants réutilisent leurs graphes capturés localement lorsqu'ils commencent à servir au sein du groupe étendu.
Performances sur DeepSeek V4 Pro
Toutes les expériences de cette section ont utilisé DeepSeek V4 Pro sur des GPU GB200, avec TP=1 et des tailles DP/EP de 16 et 20. Les poids du modèle ont été pré-téléchargés au format safetensors sur un stockage Lustre partagé et chargés en utilisant le --load-format autopar défaut. Les mesures ont utilisé des caches de compilation de kernels chauds (Triton, TileLang et FlashInfer).
Délais de montée et de descente en charge
Le tableau indique quelles étapes s'exécutent pendant que le service est suspendu et lesquelles s'exécutent en arrière-plan pendant que les workers existants continuent de servir.
| Étape | A : bloquant | B : préparation asynchrone | C : préparation asynchrone + réutilisation du graphe |
|---|---|---|---|
| Initialisation des workers qui rejoignent | Service suspendu | Arrière-plan | Arrière-plan |
| Préparer la communication cible | Service en pause | Arrière-plan | Arrière-plan |
| Transférer les poids du modèle | Service en pause | Arrière-plan | Arrière-plan |
| Échauffement et capture de graphe sur les workers qui rejoignent | Service en pause | Service en pause | Arrière-plan |
| Échauffement et capture de graphe sur les workers existants | Service en pause | Service en pause | Non nécessaire (les graphes existants restent valides) |
| Activer la topologie cible | Service en pause | Service en pause | Service en pause |
La configuration C est prise en charge uniquement par NIXL EP.
- Temps d'indisponibilité : l'interruption de service observée, lorsque les requêtes en cours cessent de progresser et que les nouvelles requêtes ne sont pas admises.
- Durée totale : la durée de l'opération complète de mise à l'échelle, préparation incluse.
Les deux durées sont mesurées séparément.
| Métrique | A : Bloquant | B : Préparation asynchrone | C : Préparation asynchrone + réutilisation des graphes |
|---|---|---|---|
| 16 à 20 GPUs : temps d'indisponibilité | 99.62 s | 58.04 s | 0.82 s |
| 20 vers 16 GPU : temps d'arrêt | 56,25 s | 44,07 s | 1,96 s |
| 16 vers 20 GPU : temps total | 99,72 s | 97,27 s | 92,34 s |
| 20 vers 16 GPU : temps total | 56,21 s | 51,46 s | 9,32 s |
Toutes les configurations ont réussi les vérifications d'exactitude numérique, y compris les vérifications sur chaque worker qui rejoint.
Maintenir le SLO tout en ajoutant des GPU
Nous avons servi DeepSeek V4 Pro sur 16 GPU, puis augmenté progressivement le taux de requêtes entrantes d'environ 8 à 16 requêtes par seconde. Nous avons rejoué le même scénario de 11 391 requêtes contre trois déploiements : l'un est resté à 16 GPU, l'un a redémarré avec 20 GPU, et l'un est passé à 20 GPU en utilisant Elastic EP avec NIXL EP. L'objectif de niveau de service (SLO) était un p95 glissant du temps jusqu'au premier token inférieur à 5 secondes.
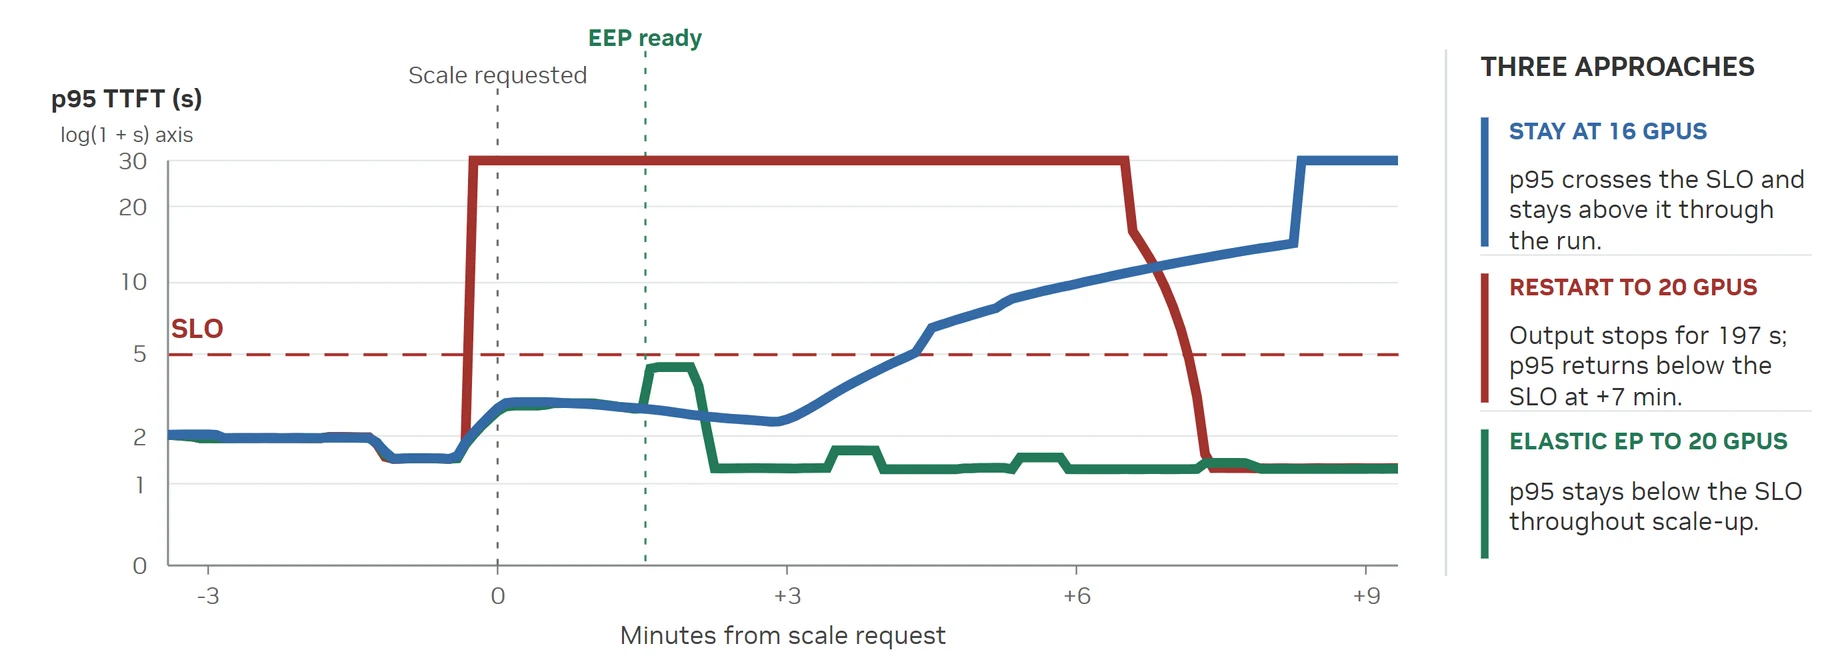
Figure 3. Service de bout en bout sous une charge de requêtes croissante. Les courbes montrent les résultats p95 glissants sur 30 secondes, les requêtes échouées se voyant attribuer une pénalité de 30 secondes plutôt qu'un TTFT mesuré.
- Elastic EP a terminé les 11 391 requêtes et est resté en dessous du SLO tout au long du scénario.
- Pendant la préparation, Elastic EP a égalé les performances de service du déploiement statique à 16 GPU, sans dégradation visible due à la préparation en arrière-plan.
- Après la mise à l'échelle, Elastic EP a égalé les performances du déploiement à 20 GPU récupéré, sans dégradation visible après la mise à l'échelle.
Essayer Elastic EP
La préparation en arrière-plan, la réutilisation des graphes CUDA et la capture indépendante des graphes sur les workers qui rejoignent sont toutes disponibles aujourd'hui dans les dernières versions de vLLM et NIXL . Installez-les avec pip et commencez à utiliser Elastic EP.
Pour un exemple d'utilisation complet, consultez le cuda_graphs_heavy_nixl_ep cas dans le test Elastic EP de vLLM. L'exemple comprend la configuration du serveur et les appels API de mise à l'échelle. Il passe de deux GPU à quatre puis revient en arrière tout en envoyant des requêtes, en vérifiant le service pendant la préparation et l'exactitude du modèle autour de chaque redimensionnement.
Et ensuite ?
Restaurer les workers à chaud avec Dynamo Snapshot
Nous avons pratiquement résolu la longue interruption de service. Le prochain défi est de rendre la nouvelle capacité prête plus rapidement. Nous prévoyons d'intégrer Instantané Dynamo permettant ainsi aux workers qui rejoignent de restaurer un processus initialisé et un état CUDA au lieu de répéter la compilation, l'échauffement des kernels, la construction des graphes et d'autres travaux de démarrage.
La communication pour la topologie cible doit être préparée séparément car elle n'est pas restaurée depuis l'instantané. La restauration des poids de grands modèles depuis le stockage des checkpoints peut dominer le temps de restauration, c'est pourquoi nous prévoyons de conserver le transfert de poids GPU-à-GPU d'Elastic EP depuis les workers existants.
Atteindre une communication EP de pointe avec NIXL EP
Nous visons des performances de dispatch et de combine à l'état de l'art avec NIXL EP tout en maintenant une prise en charge complète d'Elastic EP et de la tolérance aux pannes. Une prochaine mise à jour de performance de NIXL EP constitue la prochaine étape vers cet objectif (voir le RFC de roadmap NIXL EP).
Connecter Elastic EP à l'orchestration Dynamo et llm-d
La capacité au niveau du moteur étant en place, la prochaine étape consiste à utiliser Elastic EP depuis les autoscalers des orchestrateurs. Le travail vers cette intégration est déjà en cours au sein des communautés vLLM, Dynamo et llm-d.
Ces efforts comprennent les travaux de vLLM sur l'équilibreur de charge externe et la proposition Elastic EP de Dynamo.
Si vous exécutez de l'inférence à grande échelle, nous vous encourageons à essayer Elastic EP et à partager vos charges de travail et vos exigences opérationnelles. Si vous construisez une infrastructure d'inférence, nous accueillons les contributions à vLLM Elastic EP et NIXL EP. Faisons fonctionner Elastic EP en production.
Remerciements
- Tyler Michael Smith et Sage Moore de Red Hat pour leurs retours inestimables et leurs relectures approfondies tout au long de ce travail.
- Linoy Geva (NVIDIA) pour son travail sur les performances de service pendant la préparation.
- Toute l'équipe NIXL pour ses efforts sur NIXL EP.
- Tzu-Ling Kan, Julien Mancuso et toute l'équipe Dynamo pour leurs efforts pour prendre en charge Elastic EP dans Dynamo.