
TorchNeuron propose un nouveau backend natif pour PyTorch sur AWS Trainium. Transformers, Diffusers et Kernels le supportent nativement, ce qui facilite considérablement l’exécution des modèles sur Trainium et leur partage sur le hub HF.
TorchNeuron
TorchNeuron est un plugin PyTorch qui propose un nouveau backend pour Trainium, permettant l’accompagnement du mode eager, de torch.compile et d’API distribuées natives telles que FSDP et TP.
Lisez le blog de PyTorch pour en savoir plus sur TorchNeuron.
À partir du 20 octobre 2026, TorchNeuron sera disponible en version bêta publique. Les chercheurs et les développeurs pourront l’installer via pip install torch-neuronx.
Nouvel backend, interface native dans les bibliothèques HF
Jusqu’à présent, l’expérience Hugging Face sur AWS Trainium et Inferentia – les puces d’IA conçues respectivement pour la formation et l’inférence à grande échelle à coût réduit – a été mise en œuvre via optimum-neuron. Cette bibliothèque repose sur le package torch-neuronx, qui est basé sur PyTorch XLA. C’était la solution naturelle à l’époque, mais cela impliquait de penser comme un compilateur : des tensors légers plutôt que l’exécution active, uniquement des formes statiques, et une recompilation pour chaque brèche dans le graphe. Optimum Neuron a existé pour cacher cette complexité, et maintenait du code personnalisé (classes de modélisation, entraîneurs, etc.) pour y parvenir.
TorchNeuron change cela. Il s’intègre directement dans PyTorch et expose neuron en tant que dispositif natif, avec exécution eager, les primitives distribuées propres à PyTorch (DTensor, FSDP2) et torch.compile.
Pour les bibliothèques Hugging Face, Trainium fonctionne comme tout autre dispositif : Transformers, Diffusers, Accelerate, PEFT et TRL s’exécutent directement sur lui, avec les mêmes classes et scripts que ceux utilisés sur n’importe quel autre accélérateur. À partir de maintenant, nous recommandons aux utilisateurs de Neuron d’utiliser ces bibliothèques directement plutôt que de passer par Optimum Neuron.
Transformers
Inférence
La génération de texte est désormais nativement prise en charge par Transformers pour une large gamme de modèles. Avec TorchNeuron, 89 % des 100 architectures de modèles de génération de texte les plus utilisées sont prises en charge directement, contre 46 % avec Optimum Neuron v0.4.5. Il suffit d’ajouter l’argument device_map=neuron dans votre code, et votre modèle sera déplacé vers les dispositifs Neuron.
Voici un exemple de génération de texte avec le parallélisme tensoriel, qui permettra de bénéficier pleinement de votre instance Neuron. Notez que l’on utilise un cache statique pour la génération, car cela est fortement recommandé avec Neuron afin d’éviter des recompilations fréquentes.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
Traînage
Maintenant que Neuron est un dispositif natif PyTorch, l’entraînement sur Trainium utilise les mêmes bibliothèques Hugging Face que tout autre accélérateur : Transformers, Accelerate, PEFT et TRL. Vous n’avez plus besoin d’un entraîneur dédié ou d’une version spécifique du code du modèle pour Neuron. Un script de fine-tuning standard TRL fonctionne sur une instance Trainium avec seulement quelques paramètres spécifiques à Neuron.
Voici un script de fine-tuning supervisé construit sur SFTTrainer de TRL. Si vous avez précédemment financé un modèle avec TRL sur des GPU, cela devrait vous sembler familier.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
Le parallélisme est géré naturellement par Transformers. Vous placez un DistributedConfig contenant les dimensions de la paralélisation tensorielle (TP) et de FSDP dans model_init_kwargs, SFTTrainer le passe à from_pretrained, et le modèle est partagé lors de l’chargement de ses poids. Le Trainer constate que le modèle est déjà distribué et ne le ré-distribue pas. Vous n’avez pas besoin de la flag --fsdp ou d’une configuration FSDP d’Accelerate.
Rien dans le script n’est lié à Trainium : le même code fonctionne sur n’importe quel matériel. Quelques points méritent d’être notés lorsque vous l’exécutez sur Trainium :
- Formes statiques. Le script désactive les formes dynamiques automatiques dans
torch.compileet utilise un packaging enveloppé pour produire des séquences pouvant atteindre 2048 tokens. Avec TRL ≥ 1.16, les lots sur Neuron sont étendus à un multiple de 128 tokens, limitant ainsi le nombre de formes d’entrée. Les graphes compilés sont réutilisés pour les étapes suivantes avec les mêmes formes. torch.compileactivé. Il suffit de passer par--torch_compile true: sur une instance Trainium,torch.compiledétecte le dispositif et choisit automatiquement le backend Neuron, sans aucune configuration supplémentaire.- Chargement d’weight asynchrone désactivé. Le chargement d’weight asynchrone intégré dans Transformers n’est pas supporté sur Neuron, donc pour l’instant, nous le désactivons avec
HF_DEACTIVATE_ASYNC_LOAD=1.
Le commande suivante lance l’entraînement avec torchrun, qui démarre un processus par NeuronCore. TP_SIZE et FSDP_SIZE définissent le schéma de parallélisation, et leur produit représente le nombre de processus : ici, 4 x 8 = 32, correspondant à --nproc_per_node. Les 32 processus forment un réseau de 4 x 8. La parallélisation des tensors divise chaque couche entre les 4 cœurs d’un groupe TP, et FSDP distribue les paramètres, les gradients et l’état de l’optimiseur entre les 8 groupes TP.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
Nous l’avons exécuté sur 8 puces Trainium2 (32 NeuronCores), ce qui correspond à la moitié d’une instance trn2.48xlarge.
Les entraînements se terminent, et trainer.save_model écrit un point de checkpoint standard pour Transformers. Rien dans celui-ci est lié à Neuron : on peut le mettre sur le Hub Hugging Face tel quel, et le charger sur n’importe quel autre matériel.
Diffusers
Inférence
De nombreux pipelines de la bibliothèque Diffusers sont compatibles avec TorchNeuron en mode eager et compilé. FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 et H3 sont également compatibles avec le parallélisme tensor pour tirer le meilleur parti de vos dispositifs Neuron. Voici un exemple montrant comment utiliser TP :
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
Vous pouvez exécuter ce morceau de code avec : NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
De plus en plus de pipelines seront compatibles avec TP. Si un pipeline que vous aimez ne l’est pas, vous pouvez également ajouter son support en suivant cet guide.
Kernel
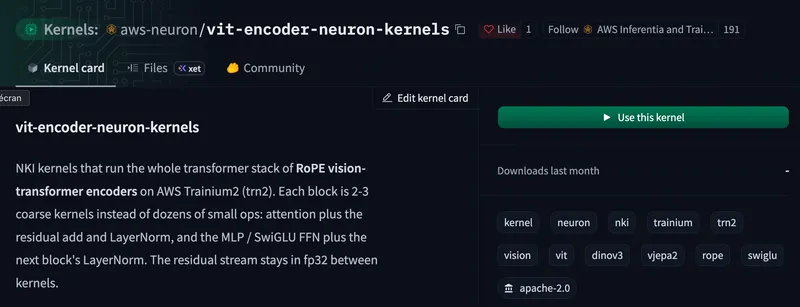
Veuillez consulter les kernels du team Neuron, car de plus en plus de kernels Neuron seront disponibles sur le Hub afin d’accélérer vos modèles. Les kernels Neuron peuvent être écrits à l’aide de l’Neuron Kernel Interface (NKI), qui offre un contrôle moindre pour optimiser les opérations. De cette manière, les utilisateurs peuvent exécuter leurs propres opérations personnalisées et les partager sur le hub.
Vous pouvez utiliser par exemple ce noyau pour accélérer vos vision transformers avec jusqu’à une accélération de 2,4 fois sur Trainium !

Remerciements
Merci spécial à l’équipe AWS pour son travail sur TorchNeuron et pour sa réactivité face à nos retours, afin d’améliorer au maximum l’intégration avec HF.