Nous lançons des classements pour HealthBench et HealthBench Professional, deux outils de benchmarking qui évaluent la manière dont les modèles d’IA réagissent dans des conversations médicales réalistes.
HealthBench et HealthBench Professional sont des outils de mesure proposés par @OpenAI qui évaluent les réponses des modèles aux conversations sur la santé réalistes en fonction de critères établis par des médecins.
HealthBench teste des modèles sur 5 000 conversations de santé avec des utilisateurs et des professionnels de la santé. Ils couvrent sept thèmes, allant des orientations d’urgence à la santé mondiale, et chaque critère de notation relève d’un des cinq axes : précision, complétude, qualité de communication, connaissance du contexte et suivi des instructions. HealthBench Professional est un ensemble plus restreint de 525 conversations, qui, contrairement à HealthBench, sont toutes avec des cliniciens. Ces tâches couvrent les activités de consultation, d’écriture et de recherche, et incluent des conversations conflictuelles et difficiles conçues pour mettre en question les modèles.
Nous rapportons à la fois le score brut (la part des points de la évaluation obtenus) et le score ajusté en longueur indiqué par OpenAI. Le score ajusté en longueur diminue le score des réponses plus longues que 2 000 caractères, et augmente celui des réponses plus courtes. Conformément à la mise en œuvre originale d’OpenAI, les réponses sont notées par GPT-5.4 (faible) (HealthBench Professional) et GPT-4.1 (HealthBench).
Résultats clés pour HealthBench Professional :
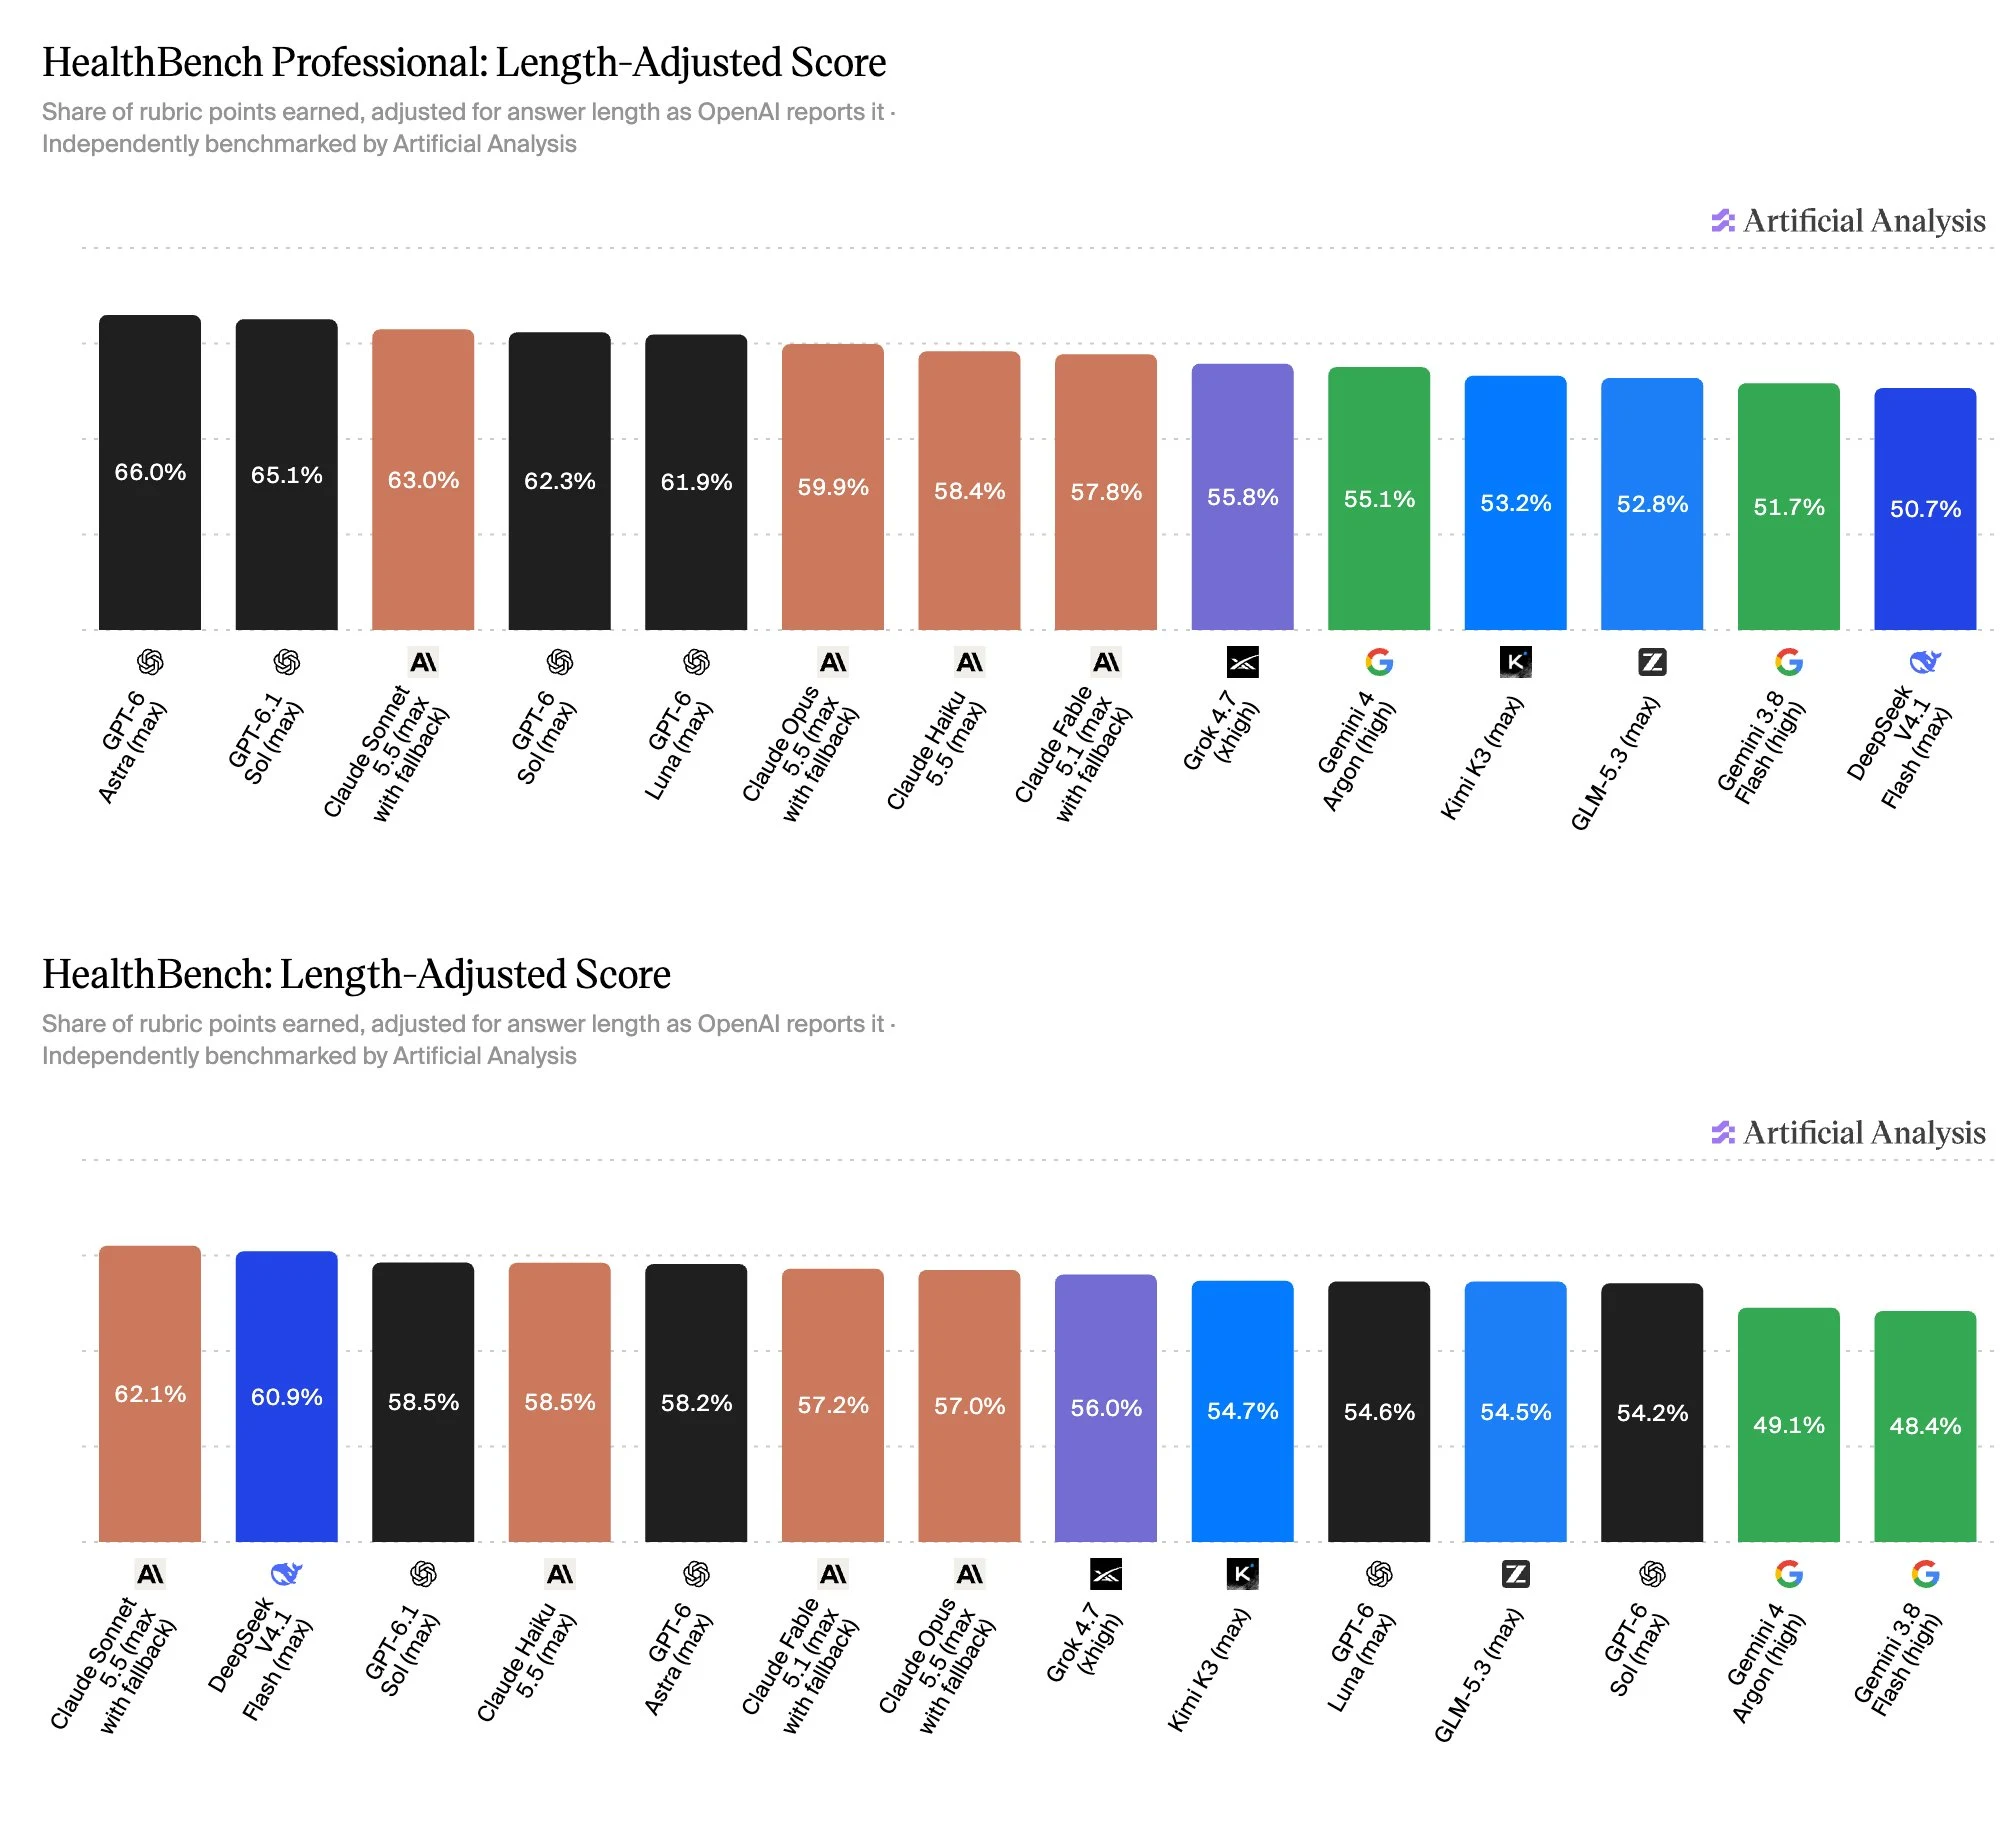
➤ GPT-6 Astra et GPT-6.1 Sol se classent en tête du classement : GPT-6 Astra (max) obtient 66,0 % sur le score ajusté en longueur, comparable à GPT-6.1 Sol (max, 65,1 %) et devant Claude Sonnet 5,5 (max avec fallback, 63,0 %)
➤ Les modèles OpenAI composent toute la frontière Pareto du score vs. Coût par tâche : la frontière Pareto comprend GPT-6 Luna (max, 61,9 %, $0,004 par tâche) jusqu’à GPT-6 Sol (max, 62,3 %, $0,036) et GPT-6.1 Sol (max, 65,1 %, $0,047) jusqu’à GPT-6 Astra (max, 66,0 %, $0,27). GPT-6 Luna (max) obtient 4 points en dessous de GPT-6 Astra (max), à moins de 2 % du coût.
➤ Claude Opus 5.5 et Claude Fable 5.1 subissent les pénibilités de longueur les plus importantes : tous ont en moyenne environ 5 900 caractères par réponse, soit près de 3 fois le seuil de 2 000 caractères, et perdent plus de 11 points après ajustement. Claude Opus 5.5 (maximum avec fallback) obtient la note brute la plus élevée (71,4 %), mais se classe au sixième rang (59,9 %). GPT-6 Sol (maximum) est le seul modèle dont la moyenne des caractères est inférieure à 2 000 (~1 600), et c’est le seul dont la note augmente.
Résultats clés pour HealthBench:
➤ Claude Sonnet 5.5 tops HealthBench : Claude Sonnet 5.5 (maximum avec fallback) obtient 62,1 % sur le score ajusté en longueur, devant DeepSeek V4.1 Flash (maximum, 60,9 %) et GPT-6.1 Sol (maximum, 58,5 %)
➤ GPT-6 Luna, DeepSeek V4.1 Flash et Claude Sonnet 5.5 forment le classement par la frontière Pareto du coût par tâche : GPT-6 Luna (max) obtient 54,6 % avec un coût de 0,002 $ par tâche, et DeepSeek V4.1 Flash (max) obtient 60,9 % avec un coût de 0,005 $ par tâche. Claude Sonnet 5.5 (max avec fallback) a un coût moyen par tâche de 0,08 $, soit environ 16 fois plus cher que DeepSeek V4.1 Flash, pour une augmentation de score d’environ 1 point
➤ Des réponses plus courtes échangent la complétude contre la qualité de communication : chaque élément de la rubrique HealthBench est étiqueté selon l’un des cinq axes. La complétude vérifie si une réponse contient toutes les informations importantes, tandis que la qualité de communication vérifie si elle est claire, bien structurée et à la longueur et au niveau de détail appropriés. GPT-6 Sol (max) écrit les réponses les plus courtes (~1 000 caractères) et obtient le score de qualité de communication le plus élevé (81 %), mais le score de complétude le plus faible (34 %). Claude Sonnet 5.5 (maximum avec fallback) devance en Précision (63 %)