
Yunzhong, depuis Aofeisi
Quantum Bit | Compte officiel QbitAI
Des modèles généralistes à l'intelligence personnalisée, la concurrence dans l'intelligence artificielle s'étend désormais versl'apprentissage à long terme et les capacités exclusivesqui s'accumulent progressivement.
Tongyan Lingzhi explore le Personal AI centré sur l'apprentissage paramétrique et l'évolution continue, permettant aux individus et aux organisations d'accumuler progressivement, au fil de leur utilisation de l'IA, leurs propres actifs d'intelligence.
Ces dernières années, les grands modèles n'ont cessé de repousser les limites de leurs capacités, et de plus en plus d'entreprises commencent à intégrer l'IA dans des activités essentielles telles que la R&D, la recherche en investissement et les opérations, via des API, des bases de connaissances et des Agents.
Mais à mesure que l'IA participe de plus en plus longtemps au travail réel, une nouvelle question émerge :la riche expérience métier générée chaque jour par les entreprises est-elle seulement appelée temporairement par le modèle, ou peut-elle se transformer progressivement en capacités d'IA qui leur sont propres ?
Les entreprises technologiques mondiales ont déjà commencé à explorer cette direction.
OpenAI améliore la mémoire à long terme de ChatGPT grâce à Dreaming, lui permettant de synthétiser les interactions historiques pour mieux comprendre les préférences des utilisateurs, le contexte des projets et les besoins à long terme ; Muse, lancé par Meta, combine en outre la compréhension personnalisée et l'exécution autonome, faisant évoluer le Personal Agent de la simple réponse aux questions vers l'accomplissement de tâches concrètes.
Qu'il s'agisse de mémoire à long terme ou d'exécution proactive, tout reflète une tendance de plus en plus claire : l'IA évolue d'un outil généraliste destiné à tous vers un service d'intelligence à long terme destiné à des utilisateurs spécifiques.
Li Wei, CEO de la plateforme industrielle de l'Institut de recherche de Pékin sur l'intelligence artificielle générale (BIGAI), estime : « Plus les modèles de base sont puissants, plus l'intelligence personnalisée peut jouer un rôle important. Nous croyons en une nouvelle division technique du travail : les modèles de base avancés fournissent des capacités générales partagées, tandis que les modèles personnalisés, grâce à l'apprentissage par interactions à long terme et à l'évolution continue, forment progressivement des capacités exclusives adaptées aux besoins de chaque sujet. »
Note : Tongyan Lingzhi s'appuie sur l'accumulation scientifique et les ressources de valorisation industrielle du système de l'Institut de recherche de Pékin sur l'intelligence artificielle générale (BIGAI), et se consacre à la R&D de modèles exclusifs auto-évoluants continus (Personal AI) destinés aux entreprises et aux particuliers. Grâce à l'entraînement de modèles personnalisés, à l'apprentissage continu et à l'optimisation de la puissance de calcul sous-jacente, elle fait évoluer les connaissances professionnelles et l'expérience métier vers des capacités d'intelligence exclusives capables d'évoluer de manière durable.
Alors que la personnalisation devient un axe d'intérêt commun à toute l'industrie, l'exploration technique commence également à s'étendre vers l'intérieur même des modèles.
Au-delà de la mémorisation des informations de l'utilisateur, l'IA peut-elle réellement apprendre l'expérience accumulée à long terme par les individus et les organisations ? Ces capacités peuvent-elles se mettre à jour continûment avec l'usage, et être préservées après le remplacement du modèle de base ? Et lorsque le nombre de modèles exclusifs augmente continûment, comment contrôler les coûts d'entraînement et d'exécution ?
Tongyan Lingzhi concentre sa direction technique sur leRecursive Self-Improving Personal AI (intelligence personnalisée à auto-amélioration récursive)en tentant d'apporter une solution systémique aux questions précédentes.
S'appuyant sur les ressources scientifiques et industrielles du système de l'Institut de recherche de Pékin sur l'intelligence artificielle générale, l'entreprise choisit de construire, au-dessus des modèles généralistes existants, des capacités exclusives pour différents sujets via des paramètres personnalisés légers, combinés à des mécanismes d'apprentissage continu et à des technologies d'ordonnancement de la puissance de calcul, permettant au modèle de s'adapter continûment à l'utilisateur au fil d'une utilisation à long terme.
L'objectif de cet ensemble technologique est de permettre aux individus, aux projets et aux entreprises d'établir progressivement une intelligence exclusive adaptée à leurs besoins propres et capable d'évoluer continûment, sans avoir à entraîner séparément un grand modèle généraliste complet.
De la mémoire à long terme à l'apprentissage par le modèle, la personnalisation entre dans la couche des paramètres
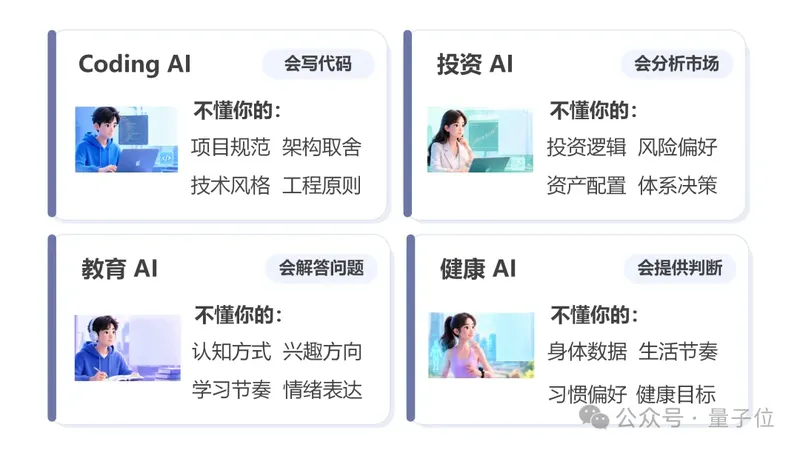
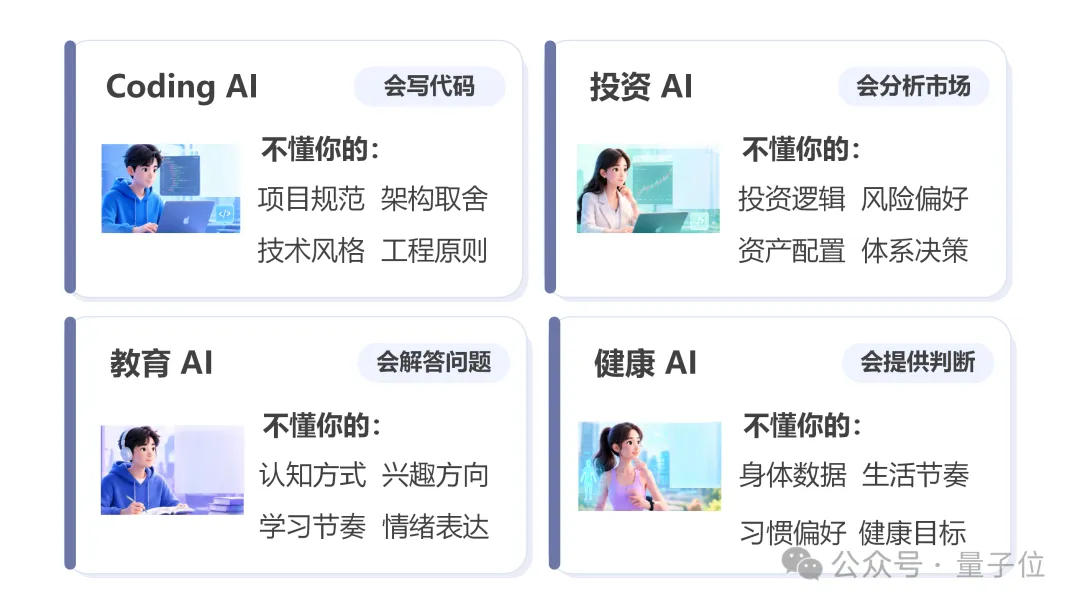
En utilisant le même Coding Agent, les résultats obtenus par différentes équipes de développement peuvent varier considérablement.
Un système logiciel mature possède souvent ses propres principes d'architecture, normes techniques et contraintes historiques ; les ingénieurs expérimentés savent quels modules ne doivent pas être modifiés à la légère, et savent aussi quand privilégier la stabilité plutôt que la solution techniquement optimale.
Une partie de cette expérience est consignée dans la documentation, mais une grande partie est dispersée dans les modifications de code à long terme, les discussions sur les solutions et la pratique des projets.
Des situations similaires existent dans les domaines de la recherche en investissement financier et des opérations d'entreprise. Les modèles généralistes peuvent analyser les marchés et comprendre les processus métier, mais les appétits pour le risque, les habitudes de décision et les méthodes de travail formés à long terme par différentes équipes nécessitent souvent une collaboration continue pour être progressivement maîtrisés.
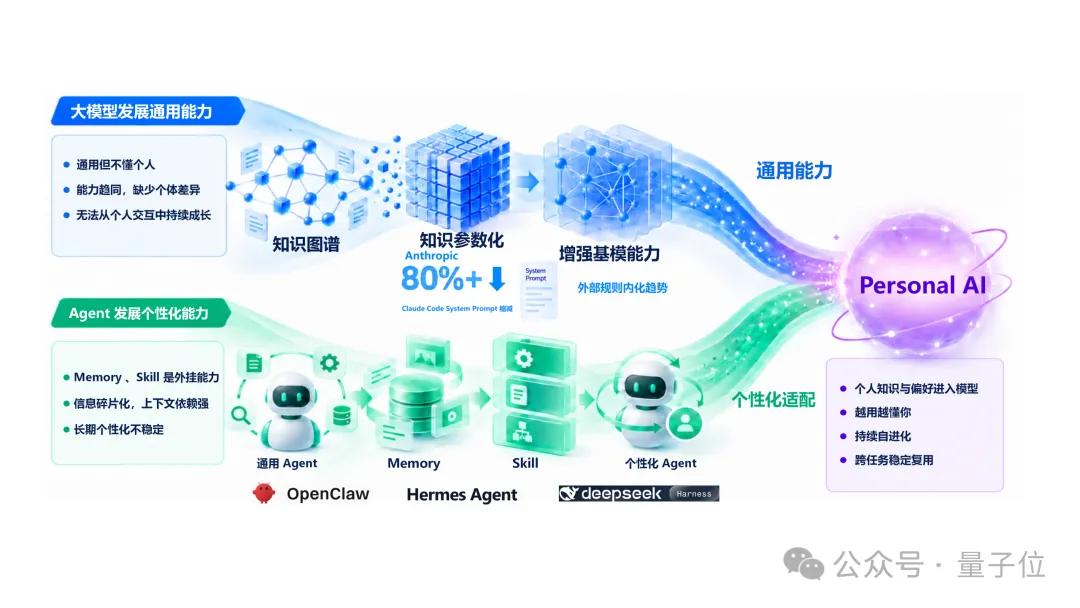
Actuellement, l'IA s'adapte principalement à des scénarios spécifiques grâce à des mécanismes tels que Prompt, RAG, Memory et Skill. Ceux-ci assurent respectivement la contrainte d'instructions, la récupération des connaissances, la sauvegarde des états et la réutilisation des capacités, et sont devenus des composants essentiels des applications d'entreprise des grands modèles. Toutefois, ces mécanismes organisent principalement l'information à l'extérieur du modèle, et les paramètres du modèle lui-même ne changent généralement pas à la suite d'une interaction métier.
Lorsque les besoins de personnalisation s'étendent de l'obtention d'informations aux modes de comportement à long terme, l'apprentissage paramétrique offre une autre option technique.
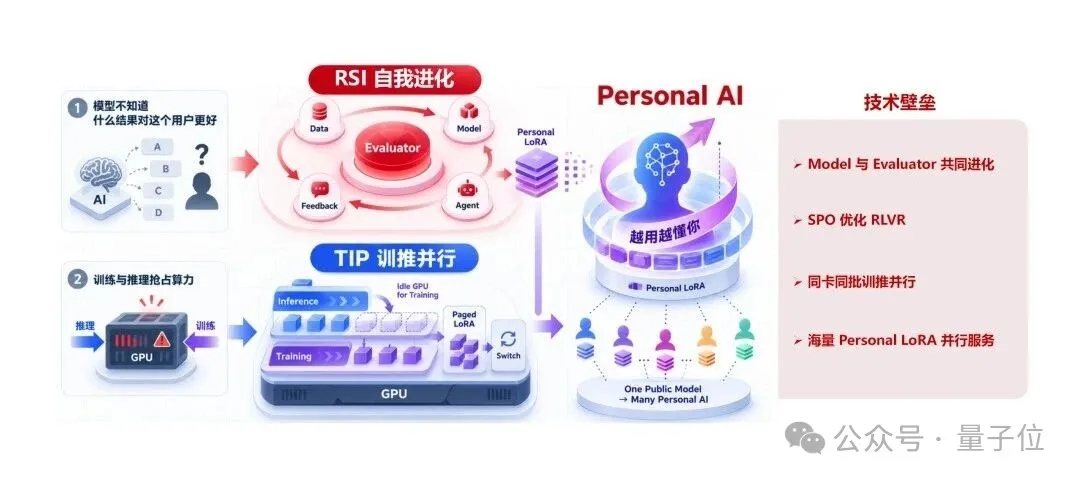
Tongyan Lingzhi adopte une architecture combinant un modèle de base partagé (Base Model) et des paramètres personnalisés (Personal Parameters).Le modèle de fondation fournit des connaissances générales et des capacités de raisonnement, tandis que les différents individus, projets et entreprises effectuent une adaptation des paramètres grâce à des Personal LoRA légères, intégrant progressivement dans le modèle des préférences professionnelles et des caractéristiques comportementales validées.
Contrairement aux modèles sectoriels traditionnels qui visent principalement à résoudre les écarts de capacités entre différents secteurs, cette approche s'intéresse davantage aux différences entre les utilisateurs au sein d'un même secteur et d'une même tâche. Par exemple, dans le développement logiciel, deux projets peuvent exiger des normes d'ingénierie complètement différentes ; dans la recherche en investissement, différentes équipes ont chacune leurs propres critères d'évaluation et leur discipline de risque.
Cela ne signifie pas que les bases de connaissances et la mémoire à long terme perdront leur valeur. Les connaissances dynamiques devront toujours être récupérées, les états des tâches devront toujours être enregistrés, et les modèles de comportement relativement stables qui se répètent au fil d'une pratique de longue durée pourront en outre être transformés en capacités paramétrées par l'entraînement.
La personnalisation passe ainsi progressivement de « donner au modèle plus d'informations sur l'utilisateur » à « permettre au modèle de développer des capacités mieux adaptées aux besoins de l'utilisateur ».
Xie Xiaonan, PDG de Tongyan Lingzhi, a déclaré : «Le besoin des entreprises en IA évolue de l'acquisition de capacités générales vers l'accumulation de capacités propres. Les mêmes types de services d'intelligence générale seront accessibles à un nombre croissant d'entreprises, mais ce qui creusera véritablement l'écart, c'est la capacitéà transformer le jugement professionnel et les méthodes de travail forgés au fil du temps en capacités du modèle, plutôt que de rester éternellement au stade de la simple « consultation de documents ».”
Pour permettre au modèle de progresser dans son travail réel, l'essentiel est d'établir un mécanisme d'apprentissage fiable
Une fois les paramètres exclusifs en place, de nouveaux défis apparaissent : comment le modèle peut-il continuer à absorber des expériences de valeur tout en évitant d'accumuler des erreurs au cours de son apprentissage ?
L'utilisation quotidienne de l'IA par les entreprises génère une grande quantité de retours. Les développeurs acceptent ou modifient du code, les commerciaux ajustent leurs stratégies de communication avec les clients, les gestionnaires d'investissement corrigent leurs conclusions de recherche : tous ces comportements contiennent des signaux d'apprentissage potentiels. Mais un retour isolé ne reflète pas nécessairement une tendance de long terme, et un jugement réussi une fois ne signifie pas que la même stratégie soit applicable à tous les scénarios.
Si les enregistrements d'interactions étaient utilisés pour l'entraînement sans filtrage préalable, le modèle pourrait renforcer des préférences fortuites, voire dégrader ses capacités existantes. Par conséquent, l'apprentissage continu nécessite la mise en place de mécanismes capables d'identifier les retours efficaces, d'évaluer les effets des mises à jour et de contrôler les changements de comportement du modèle.
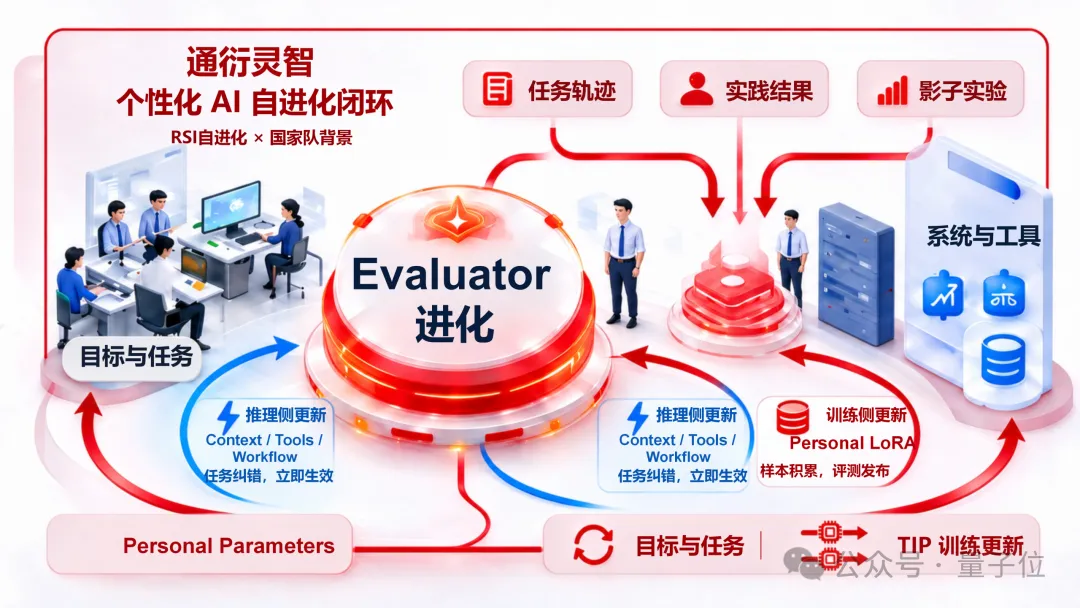
Autour de ce besoin, Tongyanlingzhi développe la technologie RSI (Recursive Self-Improvement, auto-amélioration récursive), qui construit un cadre d'apprentissage continu grâce à l'itération coordonnée entre le modèle et l'évaluateur.
Dans ce cadre, les trajectoires de tâches générées par l'exploitation métier, les corrections humaines et les résultats réels forment d'abord des données d'apprentissage candidates ; l'Evaluator filtre et juge les retours selon les critères d'évaluation propres à chaque utilisateur ou entreprise, puis les échantillons valides sont utilisés pour la mise à jour incrémentale du Personal LoRA.
Le modèle mis à jour doit ensuite subir une évaluation supplémentaire, comparant ses performances de tâches à celles de la version d'origine. Seules les mises à jour conformes aux exigences prédéfinies sont mises en service ; les résultats anormaux doivent être traités par le contrôle de version et les mécanismes de rollback.
Parallèlement, les effets réels des mises à jour du modèle peuvent également servir à améliorer l'Evaluator, permettant ainsi au système d'optimiser progressivement ses méthodes de filtrage des données d'apprentissage et ses critères d'évaluation.
Prenons l'exemple du développement logiciel : le système peut analyser les enregistrements de code review pour comprendre pourquoi certaines modifications sont acceptées ou rejetées de façon répétée, et vérifier ensuite, au moyen de tâches ultérieures, si le modèle a réellement maîtrisé les exigences d'ingénierie concernées. À mesure que les retours efficaces s'accumulent, le modèle a l'opportunité de s'adapter progressivement aux méthodes de travail forgées à long terme par l'équipe.
Ce mécanisme soulève des défis techniques tels que l'oubli catastrophique, la pollution par les retours, la dérive du modèle et la stabilité des mises à jour. Tongyanlingzhi indique que la trajectoire technologique centrale du RSI et l'architecture produit sont aujourd'hui clairement définies, que les modules concernés sont en cours d'industrialisation, et que la boucle entièrement automatisée reste encore en phase de recherche et développement continue.
Le CTO de Tongyanlingzhi, Chu Bingbing, a déclaré que, dans leur processus d'entraînement, un simple clic de l'utilisateur sur « refuser » n'est absolument pas immédiatement utilisé pour entraîner le modèle : l'Evaluator qu'ils ont introduit évalue d'abord si ce retour a une valeur d'apprentissage. Un retour isolé n'est qu'un signal ; c'est un motif qui se répète qui peut réellement devenir un apprentissage. Après mise à jour, le modèle doit également être réexécuté sur le même lot de tâches que l'ancienne version : la mise en ligne n'a lieu qu'en cas d'amélioration confirmée, et un rollback en cas de régression, afin de garantir la sécurité et l'efficacité de l'évolution.
À long terme, si le modèle parvient à apprendre de manière stable dans des activités réelles, les entreprises auront l'opportunité de réduire les travaux de configuration répétée et d'entraînement centralisé, permettant ainsi aux capacités de l'IA de se mettre à jour progressivement avec le développement de l'activité.
La généralisation des modèles exclusifs : le coût des ressources de calcul est une réalité
La commercialisation des modèles personnalisés se heurte à une autre contrainte bien réelle : le coût.
Si, à l'avenir, une entreprise doit maintenir des paramètres de modèle distincts pour des centaines de postes et des milliers d'agents, tout en prenant en charge l'entraînement continu de ces modèles et des services en ligne, les approches traditionnelles d'entraînement indépendant et de déploiement indépendant engendreront des coûts de calcul et de gestion élevés. Pour les plateformes servant un grand nombre d'utilisateurs individuels, l'importance de l'efficacité des ressources sera encore plus grande.
Tongyanlingzhi fait donc de l'infrastructure IA une composante essentielle du Personal AI, avec des optimisations centrées sur l'ordonnancement coordonné de l'entraînement et de l'inférence, ainsi que sur la gestion mémoire des paramètres personnalisés massifs.
Parmi celles-ci, TIP (entraînement et inférence en parallèle) vise principalement à résoudre le problème d'allocation des ressources entre l'entraînement et l'inférence en ligne. Les architectures traditionnelles gèrent généralement séparément l'entraînement des modèles et les services d'inférence, mais l'apprentissage continu signifie que ces deux types de tâches alternent fréquemment pendant l'exécution du modèle.
Grâce à des techniques telles que l'entraînement et l'inférence en parallèle sur une même carte et un même lot, et l'accumulation asynchrone des gradients, Tongyanlingzhi tente, tout en garantissant le service en ligne, d'utiliser la puissance de calcul disponible pour effectuer l'entraînement incrémental des paramètres personnalisés, réduisant ainsi les coûts supplémentaires liés à un pool de ressources d'entraînement indépendant.
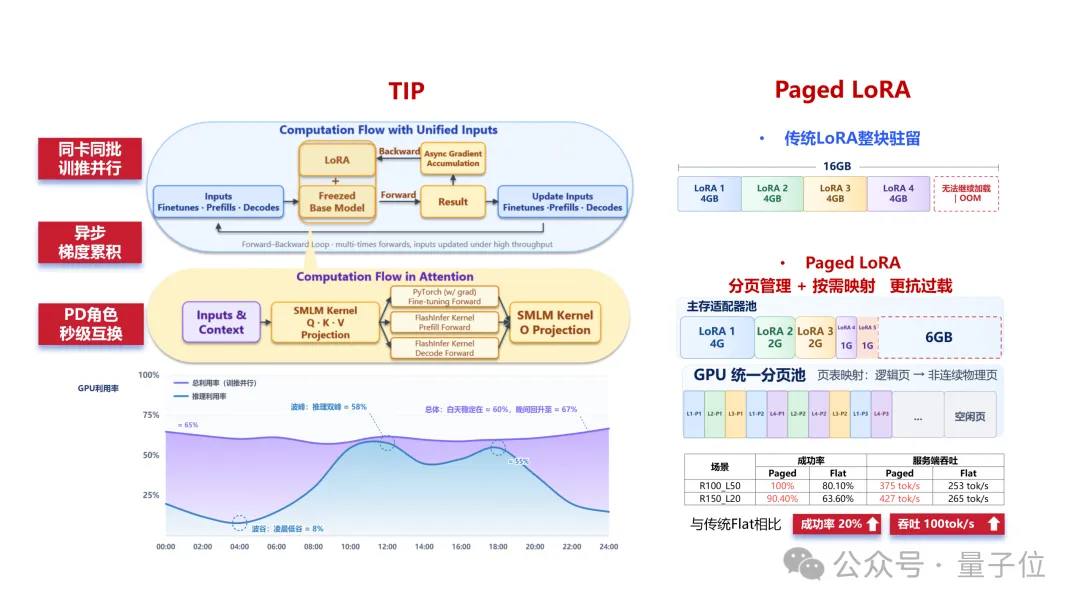
Paged LoRA, quant à lui, s'attaque au problème de gestion mémoire lorsqu'un grand nombre d'Adapters fonctionnent en concurrence. Les méthodes traditionnelles allouent souvent la mémoire par unités fixes relativement grandes ; à mesure que le nombre de modèles et la fréquence d'accès varient, cela conduit facilement à une utilisation insuffisante des ressources et à des fluctuations de la latence de réponse. Paged LoRA adopte une gestion par pagination et un mécanisme de mappage à la demande, permettant à différents Personal LoRA de partager plus souplement le modèle de base et la mémoire GPU.
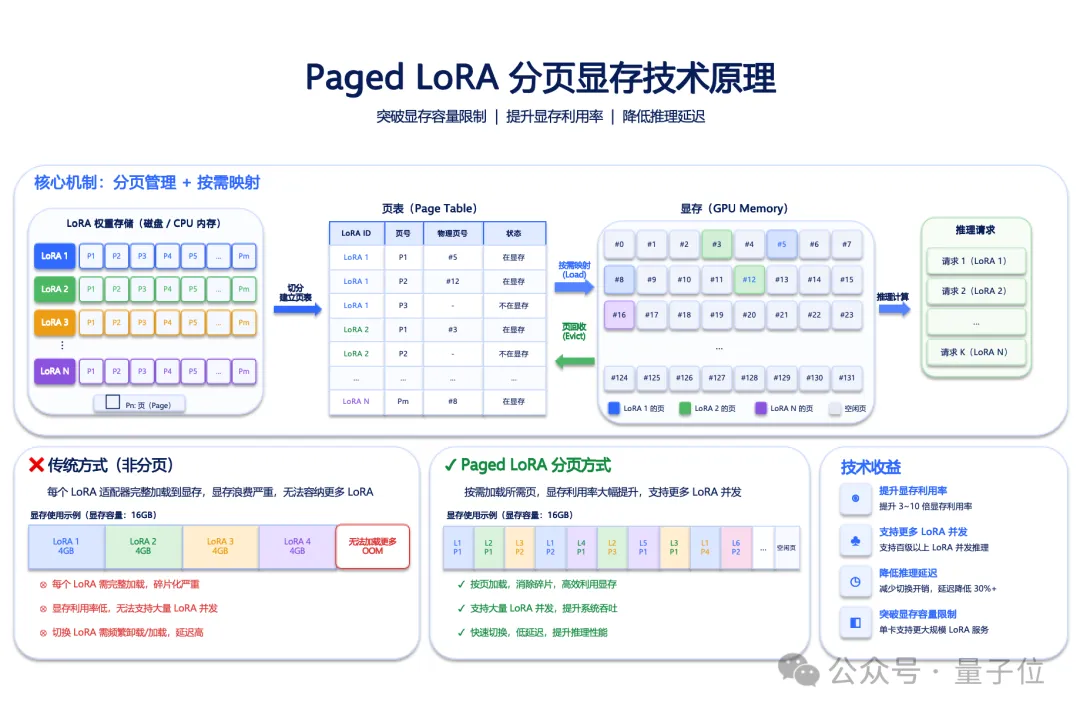
Dans les tests partiels déjà réalisés, Tongyanlingzhi a utilisé Qwen2.5-72B-Instruct et 8 GPU NVIDIA H800, en maintenant un budget mémoire LoRA uniforme de 5.79GB pour les modes Paged et Flat traditionnel. Sous des charges de test où la proportion de requêtes LoRA était de 1 % à 30 %, la solution Paged a montré un certain avantage en matière de latence de réponse et de comportement en queue de distribution.
Les tests ont également montré que lorsque la proportion de requêtes LoRA atteint 50 %, les fréquents échanges de paramètres entrée/sortie provoquent encore une dégradation des performances. L'équipe poursuit ses optimisations autour du chargement asynchrone et du préchargement des paramètres à chaud ; les performances de ces technologies dans des environnements de production plus larges restent à valider davantage.
Chu Bingbing a ajouté que si le coût d'inférence des modèles de base diminue, la fréquence d'appel des agents et les besoins d'entraînement personnalisé, eux, augmentent. Pour un système d'apprentissage continu, il ne faut pas seulement regarder le prix d'un appel de modèle unique, mais aussi le coût global de l'entraînement, des mises à jour et des services à long terme ; ce n'est que si l'équivalence économique est raisonnable que ce type de service pourra toucher un public plus large.
Pour Tongyanlingzhi, l'optimisation des ressources de calcul sous-jacentes sert l'exploitation à long terme des modèles personnalisés. En faisant progresser l'apprentissage continu grâce au RSI, puis en améliorant l'efficacité des ressources d'entraînement et de services concurrents grâce au TIP et à Paged LoRA, l'entreprise espère abaisser progressivement le seuil d'utilisation des modèles exclusifs, pour les faire passer d'un service sur mesure à coût élevé à des applications pratiques plus répandues.
Les modèles se succèdent : comment les capacités d'intelligence peuvent-elles s'accumuler et se conserver à long terme ?
À mesure que les capacités, les prix et les modes de déploiement des modèles de base évoluent sans cesse, les entreprises pourraient à l'avenir utiliser simultanément plusieurs modèles, ou changer de socle technologique selon les besoins de leur activité.
Une fois que l'IA participe profondément aux opérations quotidiennes, les coûts liés au changement de modèle ne se limitent plus à l'adaptation des interfaces et des systèmes. Les entreprises doivent également se demander si les données d'entraînement, les habitudes de travail, les retours humains et les critères d'évaluation accumulés au prix d'un investissement considérable en temps peuvent continuer à jouer leur rôle dans le nouvel environnement de modèle.
Tongyanlingzhi espère réduire la dépendance à long terme des entreprises envers un socle de modèle unique grâce au partage du modèle de base et à la stratification des capacités personnalisées.
Il convient de préciser que les structures et les espaces de paramètres des différents modèles de base ne sont pas naturellement compatibles, et que les Personal LoRA ne peuvent généralement pas être réutilisés directement d'un modèle à l'autre. Toutefois, les données métier déjà accumulées par l'entreprise, les échantillons d'entraînement, les trajectoires de tâches et les systèmes d'évaluation peuvent continuer à servir à l'adaptation et à l'entraînement de nouveaux modèles, réduisant ainsi le travail de reconstruction des capacités exclusives.
Cette approche donne également aux entreprises l'occasion d'établir leurs propres critères d'évaluation des modèles, en comparant les différents modèles de base selon leurs performances métier réelles, plutôt que de se fier entièrement aux indicateurs génériques fournis par les fournisseurs de modèles pour faire leur choix.
Tout aussi important que le changement de modèle : comment gérer les données et les acquis des modèles accumulés à long terme.
Dans la conception des produits de Tongyanlingzhi, le modèle de base partagé, les données métier de l'entreprise et les paramètres personnalisés sont répartis en couches distinctes, offrant une base technique pour l'utilisation des données, l'adaptation des modèles et la gestion des acquis correspondants. Les droits sur les données, la propriété intellectuelle et l'attribution des acquis des modèles doivent encore être précisés par des contrats, des autorisations et des mécanismes de gouvernance des données ; la stratification technique ne produit pas en soi automatiquement une propriété juridique.
La possibilité offerte par cette architecture est de permettre à l'entreprise, tout en utilisant l'IA en continu, de constituer progressivement des données d'entraînement, des systèmes d'évaluation et des capacités de modèles personnalisés relativement indépendants, et de continuer à exploiter ces acquis lors des futures mises à niveau ou migrations de modèles.
Il en va de même pour les individus. Leur structure de connaissances, leur expérience professionnelle et leurs préférences de travail, forgées au fil du temps, s'ils peuvent être efficacement préservés et continuellement utilisés pour s'adapter aux nouveaux systèmes intelligents, voient leur valeur ne plus se limiter à un produit unique ou à un service ponctuel.
Xie Xiaonan estime également que les entreprises n'ont pas à craindre que le remplacement du modèle de base remette leur accumulation à zéro. Ce qui appartient réellement à l'entreprise, ce sont les données métier accumulées sur le long terme, les trajectoires de tâches, les retours humains et le système d'évaluation ; ces actifs peuvent être réadaptés sur un nouveau modèle, au lieu de repartir de zéro. Le modèle peut être changé, mais l'expérience de l'entreprise ne doit pas être effacée avec lui.
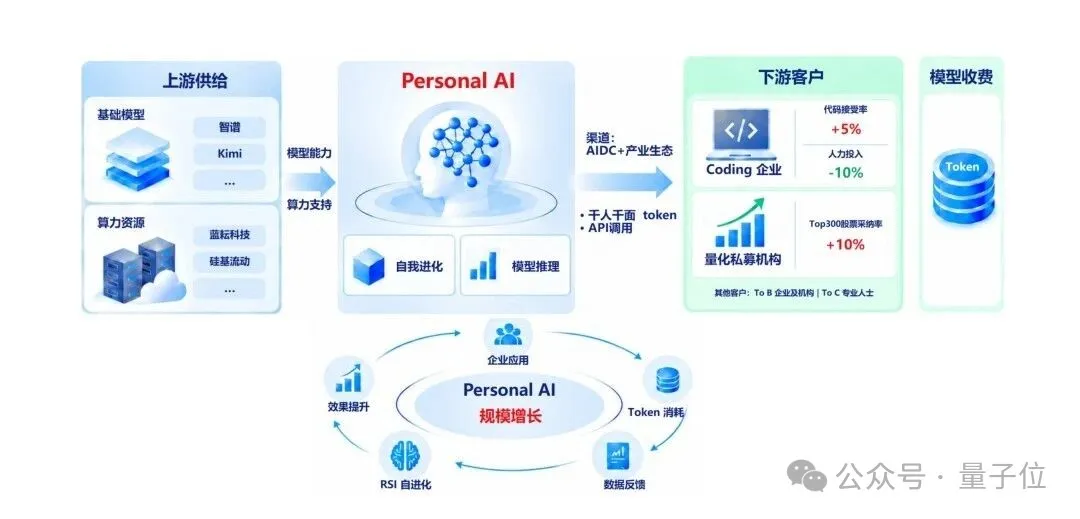
Du point de vue du modèle économique, le Personal AI fait ainsi apparaître une direction qui mérite attention :la valeur des services d'IA peut s'étendre de la livraison de tâches immédiates à l'accumulation, par l'utilisateur, d'actifs intelligents à long terme.
Du progrès technique au partage de la valeur : faire en sorte que l'intelligence serve véritablement l'humain
L'intelligence artificielle est en train de redéfinir la manière dont se forment les connaissances et les capacités de production.
Par le passé, l'expérience individuelle était principalement conservée dans la cognition et la pratique de chacun, tandis que les compétences professionnelles des entreprises étaient dispersées parmi les employés, les institutions, les systèmes métier et la collaboration organisationnelle. À mesure que l'IA participe de manière toujours plus profonde à la production sociale et à la vie quotidienne, ces connaissances et expériences jusque-là dispersées commencent à avoir la possibilité d'être systématiquement organisées, apprises et réutilisées.
Mais tandis que les capacités techniques continuent de progresser, il faut également réfléchir à une question plus profonde :
lorsque les utilisateurs contribuent sans cesse par leurs interactions, leurs corrections et leurs retours métier à rendre les systèmes d'IA plus intelligents, comment la valeur à long terme créée par ces contributions devrait-elle revenir aux individus et aux organisations eux-mêmes ?
Les services d'IA plateforme traditionnels fournissent principalement aux utilisateurs des capacités de modèle immédiates, et le comportement d'utilisation peut aussi aider la plateforme à optimiser en continu ses produits. Ce que le Personal AI explore, c'est de permettre aux utilisateurs, tout en bénéficiant du service, d'accumuler progressivement des actifs intelligents exclusifs formés par leurs propres connaissances, expériences et jugements, afin que la valeur de l'utilisation à long terme de l'IA puisse continuellement se déposer.
Le sens de cette accumulation va bien au-delà de l'amélioration des effets de personnalisation.
Pourles individus, l'expérience professionnelle peut se transformer progressivement en capacités numériques utilisables à long terme, les aidant à prolonger leur accumulation à travers différents outils et différents environnements de travail.
Pourles entreprises, les méthodes métier et les connaissances organisationnelles formées sur le long terme ont l'opportunité d'être préservées et transmises grâce à des modèles exclusifs, réduisant le risque de perte d'expériences clés due à la mobilité du personnel ou aux changements technologiques.
Lorsque ces capacités peuvent être réadaptées entre différents modèles de base, les individus et les organisations disposent également d'un plus grand espace de choix technologiques : ils peuvent évaluer, adopter et remplacer des modèles selon leurs propres besoins, réduisant leur dépendance à long terme envers une plateforme unique.
Les entreprises n'ont pas nécessairement besoin de réentraîner un grand modèle généraliste qui leur soit propre, mais elles devraient avoir la possibilité de posséder progressivement un ensemble de capacités intelligentes qui leur appartiennent.
Cela illustre également la « personnalisation de l'intelligence centrée sur l'humain » prônée par Tongyan Lingzhi. À leurs yeux, le développement de l'intelligence artificielle doit donner aux utilisateurs une plus grande autonomie, faire en sorte que les connaissances, expériences et jugements accumulés à long terme par les individus et les organisations soient respectés, préservés et perpétués, et permettre à la valeur créée par le progrès technique de bénéficier plus largement aux utilisateurs.
Enfin, Li Wei a souligné que l'inclusivité de l'intelligence artificielle ne devrait pas seulement signifier que davantage de personnes peuvent utiliser des modèles avancés, mais aussi que davantage de personnes peuvent s'appuyer sur l'IA pour accumuler et développer leurs propres capacités. Faire en sorte que les fruits du progrès technique se transforment davantage en croissance des personnes, en innovation des entreprises et en amélioration de la productivité sociale, voilà ce que Tongyan Lingzhi entend par « centré sur l'humain ».
En s'appuyant sur l'accumulation scientifique du système du Beijing Institute for General Artificial Intelligence, Tongyan Lingzhi est en train de mettre cette philosophie en pratique dans l'apprentissage paramétré, l'évolution continue et les architectures de calcul sous-jacentes.
Les technologies concernées nécessitent encore une recherche et une validation industrielles continues, mais la valeur à long terme qu'elles visent possède une signification sociale plus large : faire des capacités d'intelligence artificielle avancées un soutien durable pour le développement individuel, la croissance des organisations et l'amélioration de la productivité sociale.
Dans une perspective à plus long terme, l'intelligence artificielle ne devrait pas être seulement un système qui absorbe continuellement les connaissances humaines et améliore ses propres capacités, mais aussi devenir une infrastructure essentielle aidant l'humanité à accumuler des connaissances, à transmettre des expériences et à étendre ses capacités.
Lorsque l'intelligence générale deviendra progressivement une capacité de base largement accessible à la société, ce qui sera réellement attendu, c'est que chaque personne et chaque organisation puisse construire sa propre accumulation à long terme dans le progrès technique, et dispose de l'espace pour choisir et développer ces capacités.
L'IA ne devrait pas seulement devenir plus intelligente grâce à la participation humaine, elle devrait aussi permettre aux humains de disposer de davantage de capacités grâce à la diffusion de l'IA. Les fruits du progrès technique ne devraient pas seulement se déposer dans les modèles et les plateformes, mais davantage se déposer en une force durable pour la croissance individuelle, le développement organisationnel et le progrès social.
*Cet article est publié par QbitAI avec autorisation ; les opinions exprimées appartiennent exclusivement à l'auteur original.