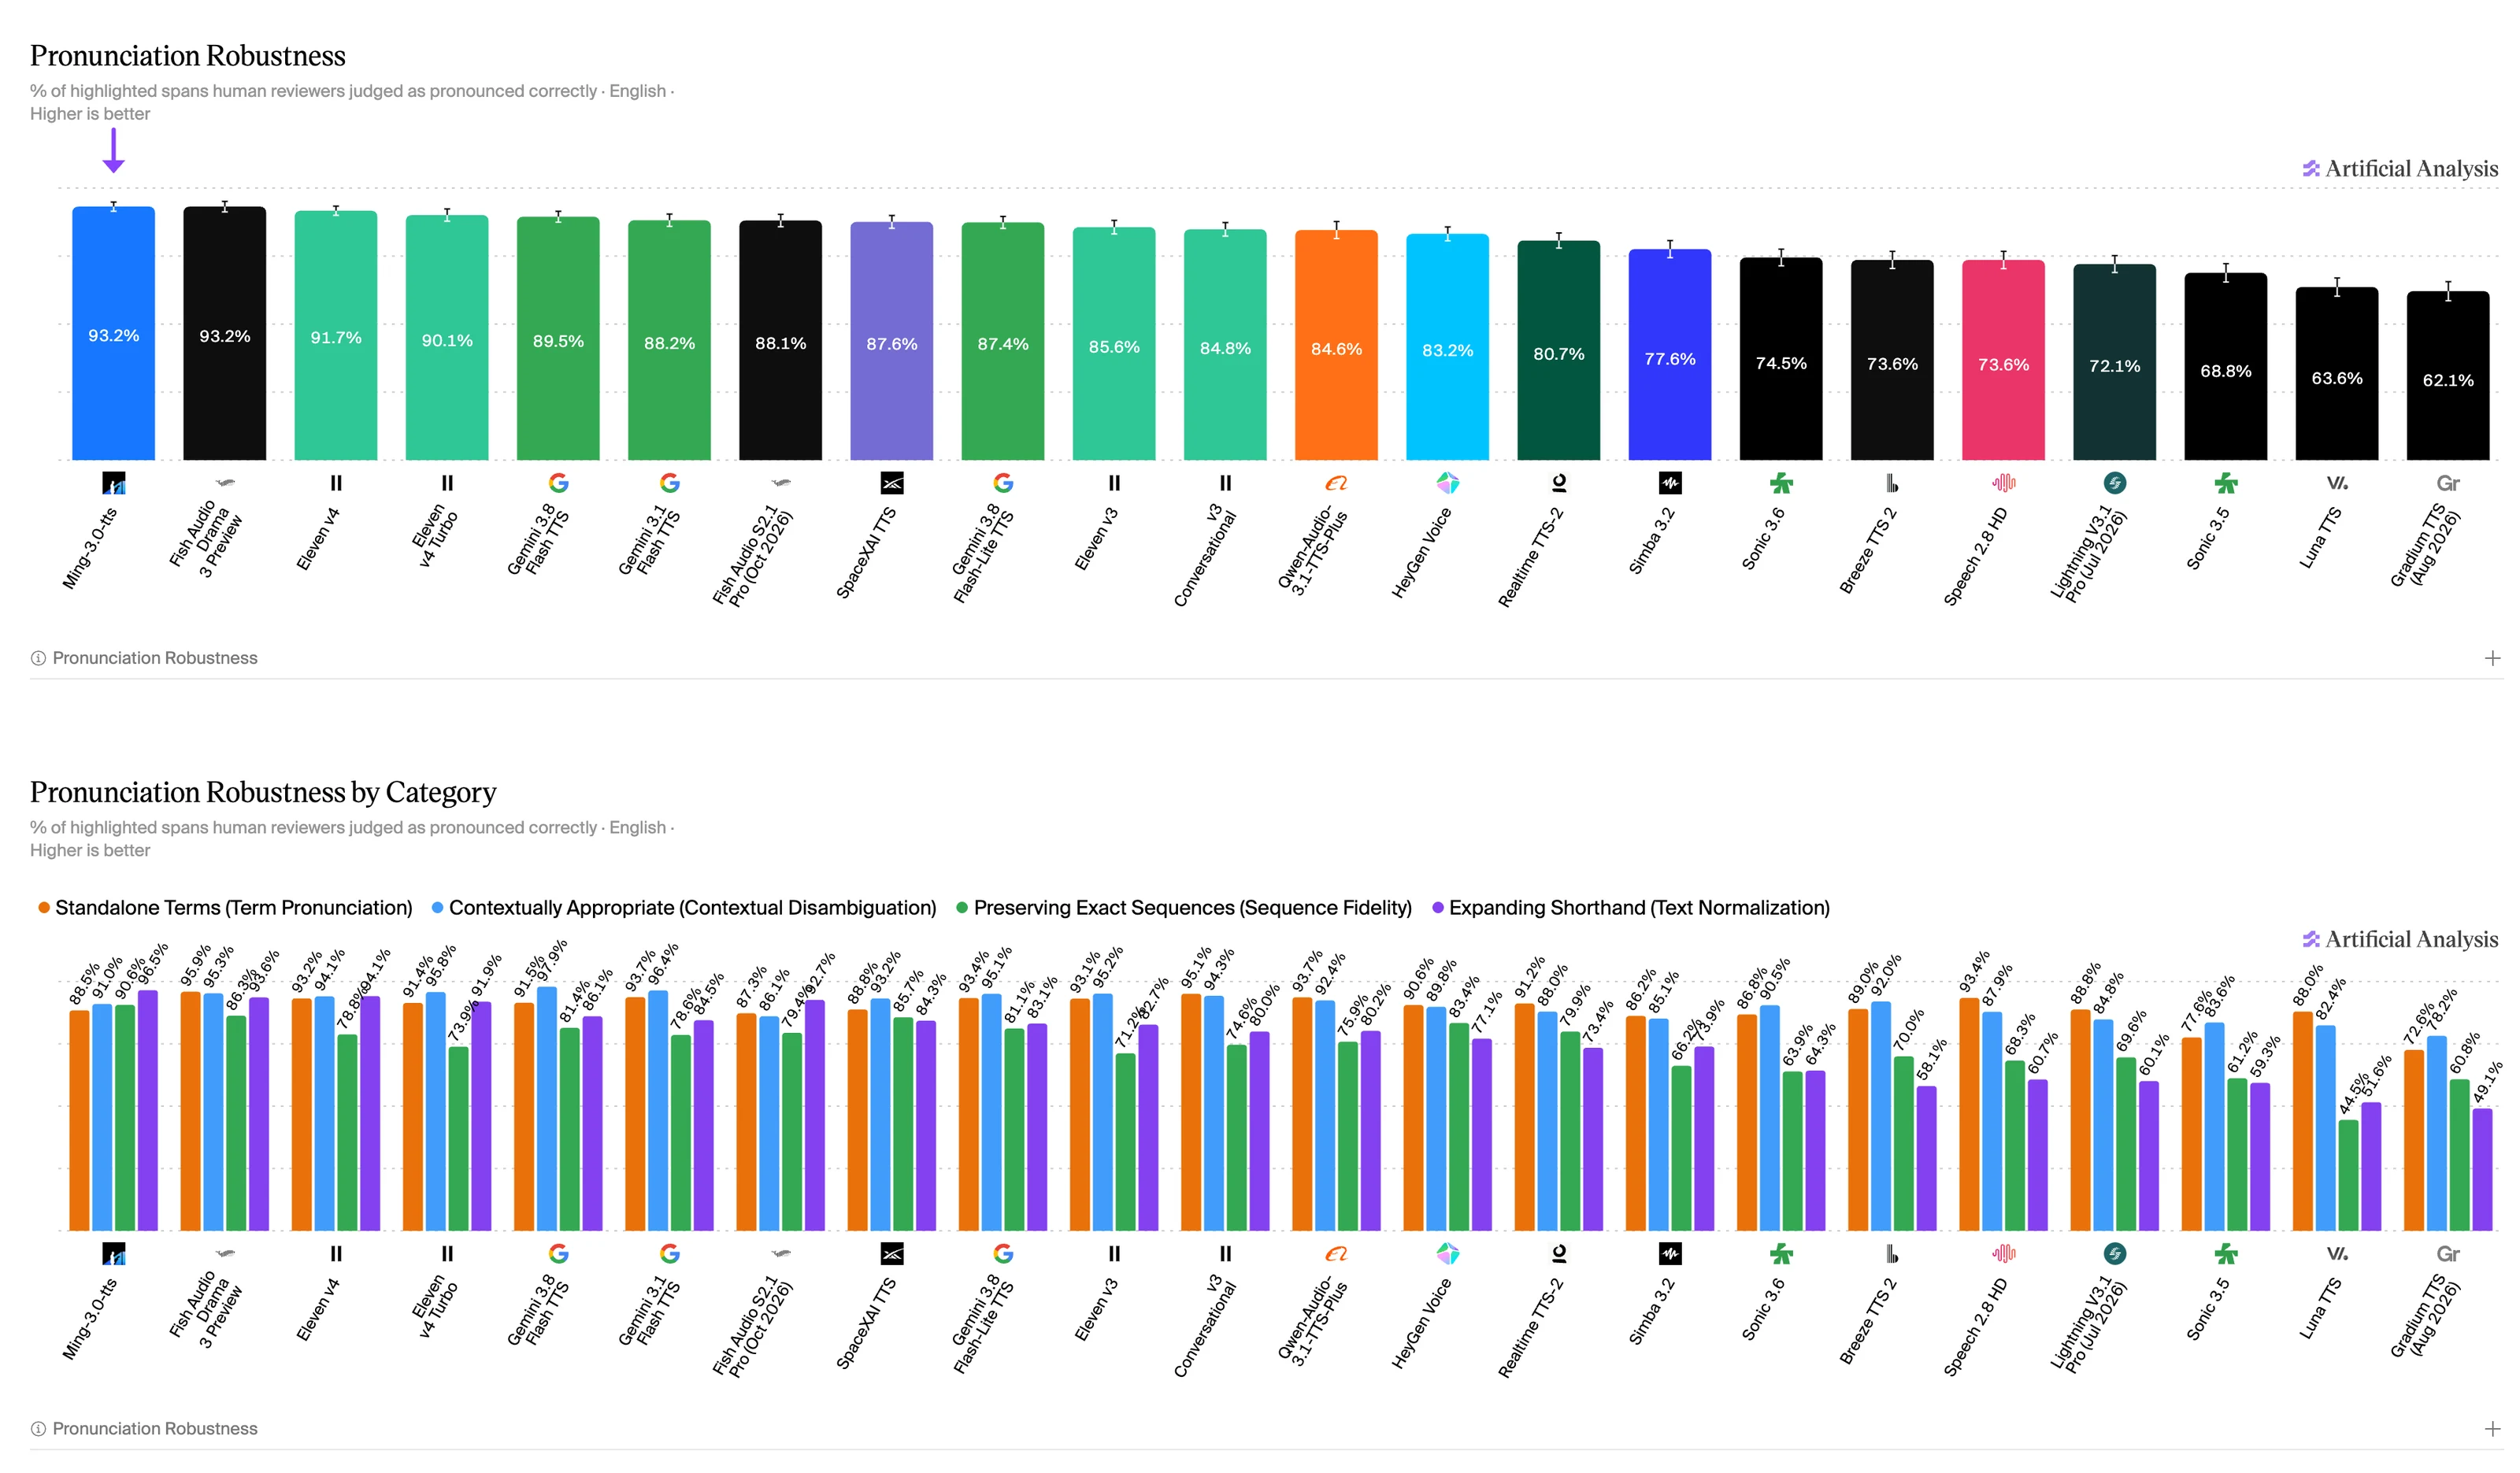
La robustesse de prononciation mesure si les modèles de synthèse vocale prononcent correctement des textes difficiles dans quatre catégories, avec des évaluateurs humains jugeant chaque clip par rapport aux prononciations acceptées convenues à l'avance. Ming-3.0-tts domine globalement à 93,2 %.
➤ Développement des abréviations : Ming-3.0-tts se classe #1 à 96,5 %, devant Eleven v4 à 94,1 % et Drama 3 Preview à 93,6 %.
➤ Préservation des séquences exactes : Ming-3.0-tts se classe #1 à 90,6 %, devant Drama 3 Preview à 86,3 % et SpaceXAI TTS à 85,7 %.
➤ Adéquation contextuelle : Ming-3.0-tts obtient 91,0 %, tandis que Gemini 3.8 Flash TTS mène à 97,9 %.
➤ Termes autonomes : Ming-3.0-tts obtient 88,5 %, tandis que Drama 3 Preview mène à 95,9 %.