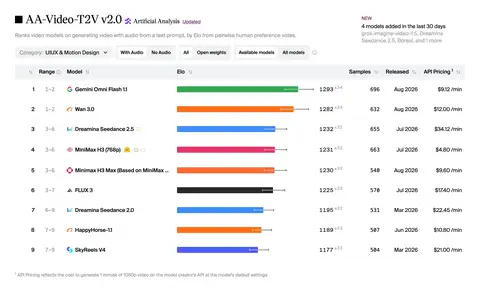
Nous lançons AA-Video-T2V v2.0, notre nouveau benchmark pour évaluer les modèles de texte en vidéo, ainsi que AA-Video-T2V-Silent v2.0 pour la génération de vidéo sans audio. Fondé sur une nouvelle méthodologie, il évalue chaque modèle en 1080p sur un ensemble de prompts régulièrement actualisé, et les classe à travers 10 cas d'usage, 10 capacités et une large gamme de styles. Les modèles vidéo sont adoptés dans un nombre croissant d'industries et de flux de travail, des studios de cinéma aux agences de publicité. Notre nouveau benchmark ne classe pas seulement les modèles dans leur ensemble, mais montre aussi quel modèle est le meilleur pour un cas d'usage spécifique et une capacité de génération vidéo donnée. Les cas d'usage sont ancrés dans la manière dont les consommateurs et les entreprises utilisent la génération vidéo. Les capacités s'appuient sur les recherches menées en laboratoire et dans le milieu académique, ainsi que sur la façon dont les créateurs et les entreprises repoussent aujourd'hui les limites des modèles vidéo. Nous étiquetons chaque prompt par cas d'usage (comme Film en prises de vues réelles et Marketing & Publicité) et par la capacité qu'il teste (comme Rendu de texte et Synchronisation audio), et le benchmark global échantillonne de manière équilibrée les deux. De ce fait, le classement général reflète la polyvalence d'un modèle à travers les cas d'usage et son équilibre à travers les capacités. Nous étiquetons également chaque prompt par style visuel, comme photoréaliste, rendu 3