Présentation de ChatGPT Images 2.5
ChatGPT Images 2.5 aide à transformer vos idées, croquis et photos de référence en images plus personnalisées et plus abouties, qui reflètent mieux vos idées.
Les nouvelles de l’IA, leurs sources et leurs dates.
ChatGPT Images 2.5 aide à transformer vos idées, croquis et photos de référence en images plus personnalisées et plus abouties, qui reflètent mieux vos idées.
OpenAI élargit son soutien au journalisme avec des outils, des formations et des partenariats destinés aux étudiants, aux enseignants, aux journalistes et aux organisations de presse.
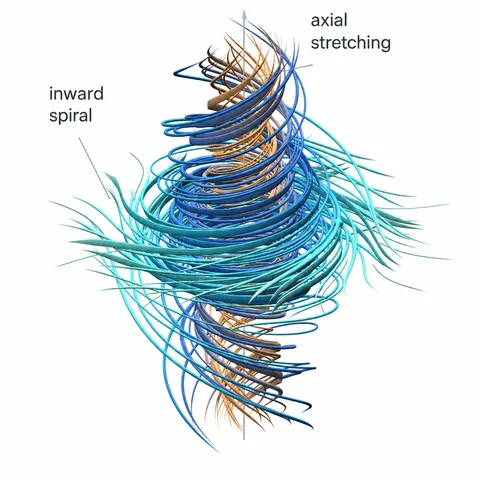
Nous partageons une solution générée par IA au problème du prix du Millénaire des équations de Navier–Stokes, comprenant un rapport et une preuve formelle en Lean.
Postulez dès maintenant au programme de subventions de 5 millions de dollars d'OpenAI soutenant la recherche indépendante sur la manière dont l'IA générative affecte le développement, le bien-être et la sécurité des adolescents.
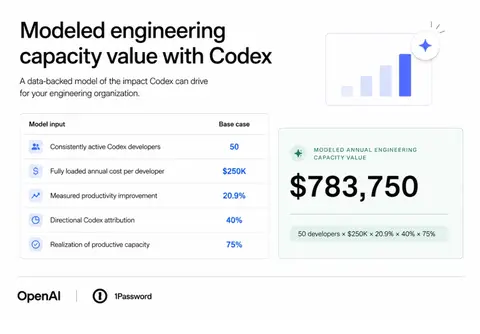
Les ingénieurs de 1Password utilisent Codex pour créer rapidement de nouvelles fonctionnalités et des outils internes, atteignant un état prêt pour la production tout en maintenant des politiques de sécurité rigoureuses.
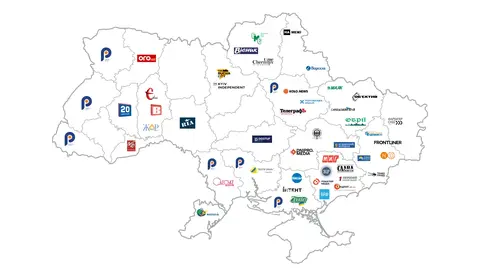
OpenAI, AIRPPU et WAN-IFRA lancent un programme d'IA destiné à aider les organisations de presse ukrainiennes à renforcer l'innovation, la résilience et le journalisme indépendant.
Jakub Pachocki réfléchit sur les IA de plus en plus capables et le défi de les maintenir alignées. Il appelle à des mesures de protection plus robustes et à une coordination internationale.
Chez OpenAI, les agents de codage transforment la recherche en IA. Découvrez les premières données sur l'utilisation des agents, la vélocité des expériences, la complexité des tâches et l'accélération de la recherche.
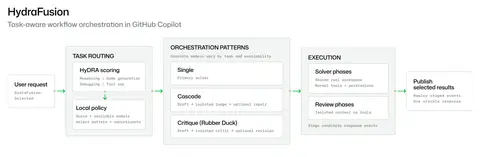
Dans des évaluations hors ligne contrôlées, les workflows de codage sélectifs de HydraFusion ont égalé ou dépassé la référence Opus 5 évaluée tout en réduisant le coût estimé du workflow. Désormais disponible en aperçu de recherche dans GitHub Copilot. L’article Projet HydraFusion : une qualité de pointe grâce à l’orchestration multi-modèles est apparu en premier sur The GitHub Blog .
Apprenez à exécuter des agents en parallèle dans l’application GitHub Copilot, et vivez le moment où cela cesse de faire peur et commence à sembler puissant. L’article Application GitHub Copilot pour débutants : exécuter plusieurs agents à la fois est apparu en premier sur The GitHub Blog .
OpenAI présente Daybreak for Frontline Defenders. Un engagement de 1 milliard de dollars élargit l'accès à l'IA cyber de pointe, à la formation et au soutien pour les services essentiels.
Legora a utilisé GPT-6 Astra pour examiner 41 documents en quelques minutes, détecter les quatre erreurs dissimulées et améliorer les performances de près de 40 % dans ce flux de travail de revue financière.
En utilisant GPT-6 Astra, Playco a construit trois prototypes de jeux thématisés à partir d'une base grey box et a signalé 50 % de corrections manuelles en moins qu'avec le modèle précédent.
Découvrez GPT-6 Astra, notre modèle le plus intelligent et le mieux aligné à ce jour, avec des capacités de pointe en utilisation de l'ordinateur, en programmation, en cybersécurité et en science.
Au cours des dernières années, le mode d'évaluation des agents consistait globalement à fixer un objectif, que le modèle s'efforçait d'atteindre en un nombre limité de tours. Par exemple, trouver un trésor dans un labyrinthe, produire un rapport ou corriger un morceau de code. La performance du modèle est alors évaluée selon la qualité du livrable ou le degré d'achèvement de la tâche, et ce type d'évaluation comporte souvent un état de terminaison naturelle explicite. Les tâches à long terme du monde réel n'ont pour la plupart pas d'état de terminaison naturelle explicite, par exemple la prévision météorologique, le trading d'actions ou la gestion commerciale. Tout comme une boutique en ligne ne sera pas « gérée avec succès » un certain matin : le stock accumulé le mois dernier, le prix négocié avant-hier et l'activité promotionnelle d'hier influenceront tous
Nous proposons Qwen-Drive-1.0. Il s'agit du premier modèle fondationnel vision-langage pour la conduite autonome qui unifie la perception 3D et le question-réponse visuel dès la phase de pré-entraînement, puis s'étend à la planification de mouvement, tout en conservant l'architecture VLM pré-entraînée inchangée de bout en bout. Le modèle repose sur Qwen3.5-4B, nativement multimodal, et ajoute deux modules externes. La tête de perception BEV sert de sonde 3D explicite et inspectable, et réalise conjointement la détection d'objets 3D, la prédiction d'Occupancy sémantique et la segmentation de carte BEV. L'expert en planification génère les trajectoires futures du véhicule ego par correspondance de flux. Grâce à un entraînement par étapes, nous améliorons significativement les capacités de conduite autonome du VLM généraliste, et nous validons sa faisabilité sur les tâches de perception 3D, de question-réponse visuel de conduite et de planification de mouvement, formant ainsi un modèle vision-langage unifié pour la conduite autonome, qui fournit une nouvelle génération de base VLM pour l'adaptation aux scénarios de conduite.