GPT-6 Astra : Une nouvelle génération d'intelligence
Découvrez GPT-6 Astra, notre modèle le plus intelligent et le mieux aligné à ce jour, avec des capacités de pointe en utilisation de l'ordinateur, en programmation, en cybersécurité et en science.
Première main: Partez du document original, de sa date, de son périmètre et de ses révisions. Une source directe établit ce qui a été annoncé, pas une validation indépendante. Page 21 sur 43
Découvrez GPT-6 Astra, notre modèle le plus intelligent et le mieux aligné à ce jour, avec des capacités de pointe en utilisation de l'ordinateur, en programmation, en cybersécurité et en science.
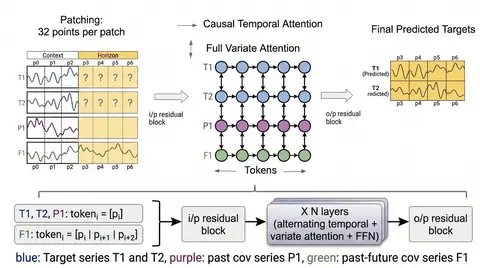
Au cours des dernières années, le mode d'évaluation des agents consistait globalement à fixer un objectif, que le modèle s'efforçait d'atteindre en un nombre limité de tours. Par exemple, trouver un trésor dans un labyrinthe, produire un rapport ou corriger un morceau de code. La performance du modèle est alors évaluée selon la qualité du livrable ou le degré d'achèvement de la tâche, et ce type d'évaluation comporte souvent un état de terminaison naturelle explicite. Les tâches à long terme du monde réel n'ont pour la plupart pas d'état de terminaison naturelle explicite, par exemple la prévision météorologique, le trading d'actions ou la gestion commerciale. Tout comme une boutique en ligne ne sera pas « gérée avec succès » un certain matin : le stock accumulé le mois dernier, le prix négocié avant-hier et l'activité promotionnelle d'hier influenceront tous
Nous proposons Qwen-Drive-1.0. Il s'agit du premier modèle fondationnel vision-langage pour la conduite autonome qui unifie la perception 3D et le question-réponse visuel dès la phase de pré-entraînement, puis s'étend à la planification de mouvement, tout en conservant l'architecture VLM pré-entraînée inchangée de bout en bout. Le modèle repose sur Qwen3.5-4B, nativement multimodal, et ajoute deux modules externes. La tête de perception BEV sert de sonde 3D explicite et inspectable, et réalise conjointement la détection d'objets 3D, la prédiction d'Occupancy sémantique et la segmentation de carte BEV. L'expert en planification génère les trajectoires futures du véhicule ego par correspondance de flux. Grâce à un entraînement par étapes, nous améliorons significativement les capacités de conduite autonome du VLM généraliste, et nous validons sa faisabilité sur les tâches de perception 3D, de question-réponse visuel de conduite et de planification de mouvement, formant ainsi un modèle vision-langage unifié pour la conduite autonome, qui fournit une nouvelle génération de base VLM pour l'adaptation aux scénarios de conduite.
GPT-6 Astra est notre modèle le plus capable largement déployé et le premier à atteindre le niveau Critical de capacité en cybersécurité selon notre Preparedness Framework.
Le programme Fairwind est un programme à accès limité destiné aux gouvernements et aux partenaires de confiance pour utiliser nos outils de cyberdéfense.
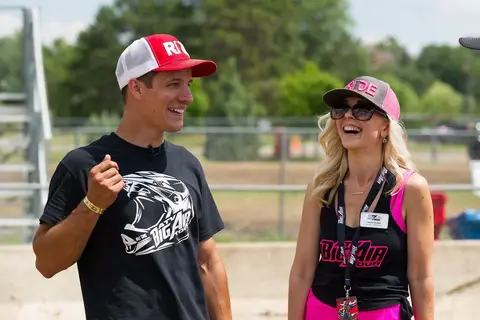
ATV Big Air Tour utilise ChatGPT Work pour accélérer le marketing, la gestion des produits dérivés et bien plus. L'entreprise a même transformé des photos de marchandises en site web d'inventaire en 15 minutes.
Voici les dernières mises à jour d'IA de Google d'août 2026
Basis, Clay et Exa Labs utilisent des agents d'IA pour améliorer l'intégration, la gestion des comptes et les intégrations pour développeurs. Découvrez ce que les dirigeants d'entreprise peuvent en appliquer.
Les lauréats de la sixième édition des OlympusMons Awards ont été officiellement annoncés lors du Forum mondial des experts en stockage de données 2026, honorant sept équipes de recherche mondiales de premier plan.
Conçu sur notre dernier modèle Nano Banana, Google Pics — notre outil de création et de modification d'images — est désormais disponible.
Astra est le premier modèle d'OpenAI à atteindre le seuil de capacité cybernétique Critical au titre du Preparedness Framework, avec des garanties renforcées pour sa mise à disposition.
ChatGPT peut désormais se connecter à des données de santé fiables, aidant les cliniciens à accéder de manière sécurisée au contexte des patients, à la recherche médicale, et plus encore.
Découvrez comment Gilbert + Tobin associe un engagement porté par la directrice générale, une gouvernance rigoureuse et une responsabilité humaine pour déployer ChatGPT Enterprise et Codex dans l'ensemble du cabinet.
Nos modèles les plus avancés pour le codage et le travail de connaissance. Leurs capacités de recherche offrent également un premier aperçu de la manière dont les modèles d’IA contribueront au progrès scientifique.
Le RSS contient les versions de lecture complètes et à jour dans cette langue, avec leurs sources.