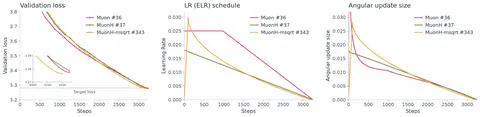
Dans le préentraînement des grands modèles de langage (Large Language Models, LLM), les hyperparamètres sont des facteurs clés qui influencent la qualité des résultats et contrôlent la dynamique d'entraînement du modèle. Or, le taux d'apprentissage (Learning Rate, LR), l'un des hyperparamètres les plus importants du préentraînement, ne permet pas de contrôler précisément la vitesse d'évolution des paramètres du modèle, et sa valeur optimale change souvent avec l'augmentation de l'échelle du modèle et des données. Cet article introduit le taux d'apprentissage effectif (Effective Learning Rate, ELR) pour contrôler le changement de direction des poids du modèle. En tant qu'hyperparamètre réglable, l'ELR est plus proche de la dynamique interne de l'entraînement que le LR, et constitue donc une base de réglage plus appropriée : dans le modèle à loi de puissance multiple (Multi-Power Law, MPL), l'ELR permet de prédire plus précisément la perte, et l'ELR optimal peut aussi être transféré plus fiablement à des modèles de différentes tailles. En outre, cette perspective de l'ELR peut également nous guider pour concevoir des stratégies de planification du LR plus appropriées, et se révèle supérieure en expérience aux stratégies de planification du LR conventionnelles servant de référence.