
雨を聞く 発信元:凹非寺
量子位 | 公式アカウント QbitAI
無料ユーザーでもGPT-6を利用できるようになりました!
OpenAIが発表したことによると、GPT-6がChatGPTの無料ユーザーおよびGoユーザーにプッシュを開始GPT-6 Lunaを使って、以前のGPT-5.6 Lunaを段階的に代替する。
さらに、Proなどの有料ユーザーはGPT-6 Solを使用します。
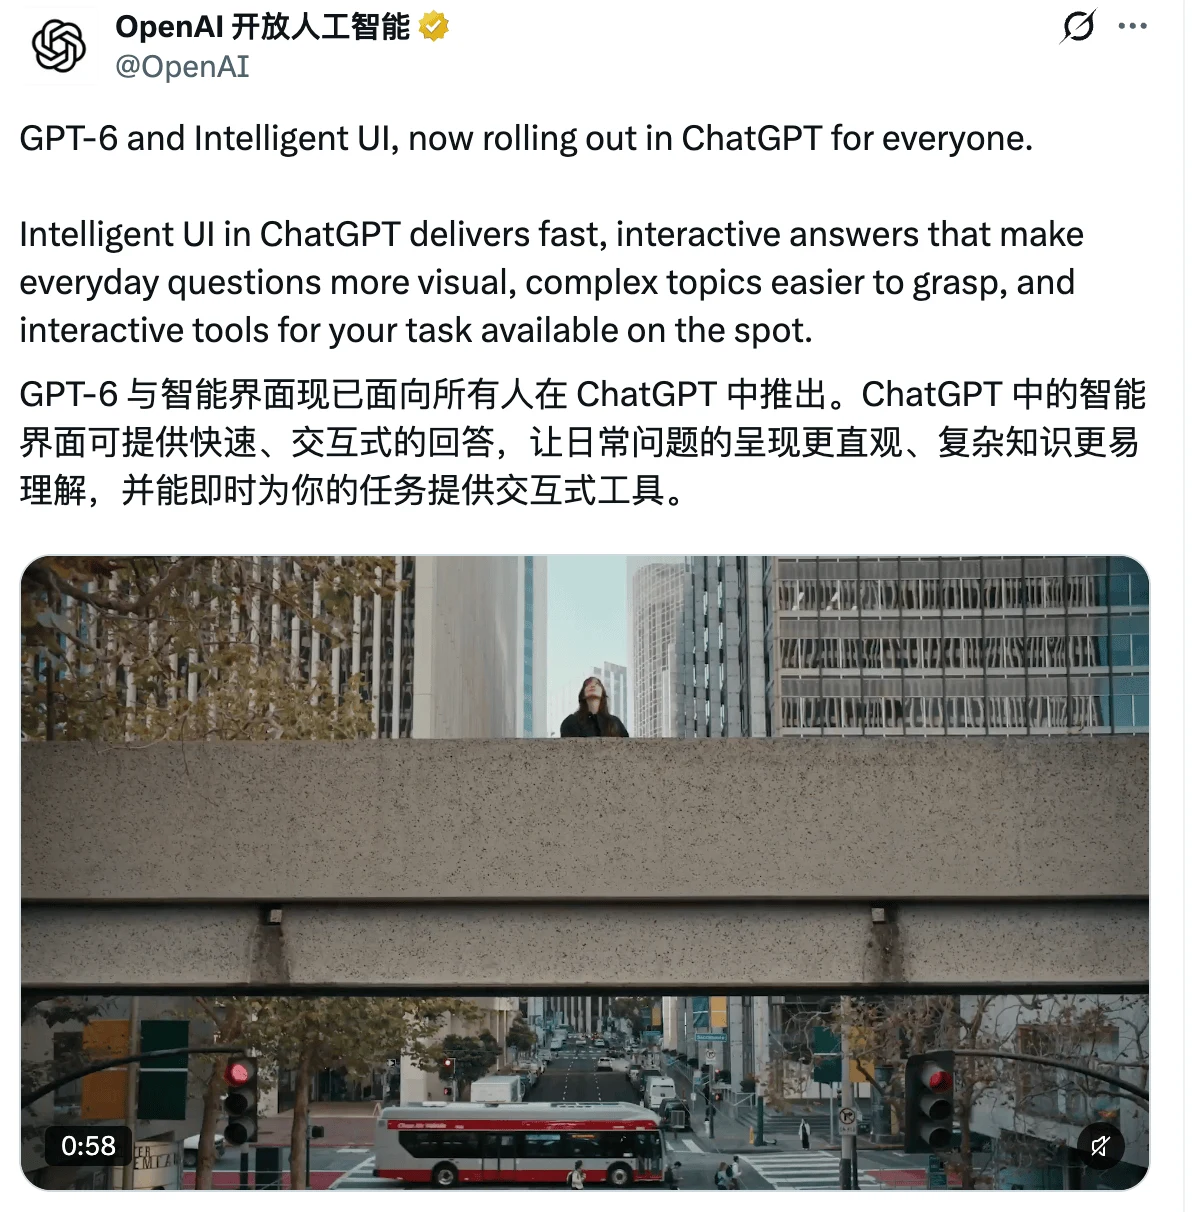
変化はモデルの名前に限らない。新バージョンのChatGPTは問題に基づいてグラフ、ボタン、インタラクティブツールを生成でき、思考しながら答えを提示することもできる。
元々テキスト中心のチャットボックスが、質問に応じて変化するインターフェースになり始めた。
同じ日に、OpenAIは24ページのセキュリティ報告書も公開した。
報告書には、18歳以下のユーザーを対象とした評価が含まれており、モデルが青少年とチャットする際に、より厳格な境界を守れるかどうかを見ています。
その中で「感情依存」という項目は、モデルが青少年に過度な感情依存を引き起こすかどうかを見るものです。
前の世代のGPT-5.6 Lunaは0.927であり、無料ユーザーが利用する予定のGPT-6 Lunaは0.734に低下しました。
無料ユーザーはGPT-6 Lunaを利用できる
GPT-6がChatGPTのメインチャットインターフェースにデータを送信し始めました。
OpenAIが発表した計画に従い、Plus、Pro、Business、Enterpriseのユーザーは10月7日から順次GPT-6 Solを利用できる。FreeとGoのユーザーは10月8日から順次GPT-6 Lunaを利用できる。
これら2つのバージョンは、ChatGPTで以前使用されていたGPT-5.6 SolとLunaにそれぞれ代わられる。
モデルの更新以外に、もう一つ明らかな変化があります——チャットボックス内の回答に「インターフェース」が現れ始めたのです。
この機能はIntelligent UIと呼ばれています。
GPT-6は問題に応じて表示方法を選択します。概念を説明する際には、クリック可能な図表を提示できます。比較を行う際には、オプションを並べて表示することができます。
具体的なタスクに遭遇した場合、対話の中で直接計算機や分担計算ツール、小さなゲームを生成することができます。
例えば、ユーザーが7段変速自転車の仕組みについて尋ねた場合、答えとしては、フレーム、ホイール、トランスミッションシステムなどの部分を、項目ごとに確認できるインターフェースにしています。
答えが出る方法も変わりました。GPT-6は、さらに考えるかツールを呼び出す際に、部分的な答えを先に出し、その後で新しい発見を追加することができます。インタラクティブ要素も、生成プロセスに沿って段階的に表示されるようになります。
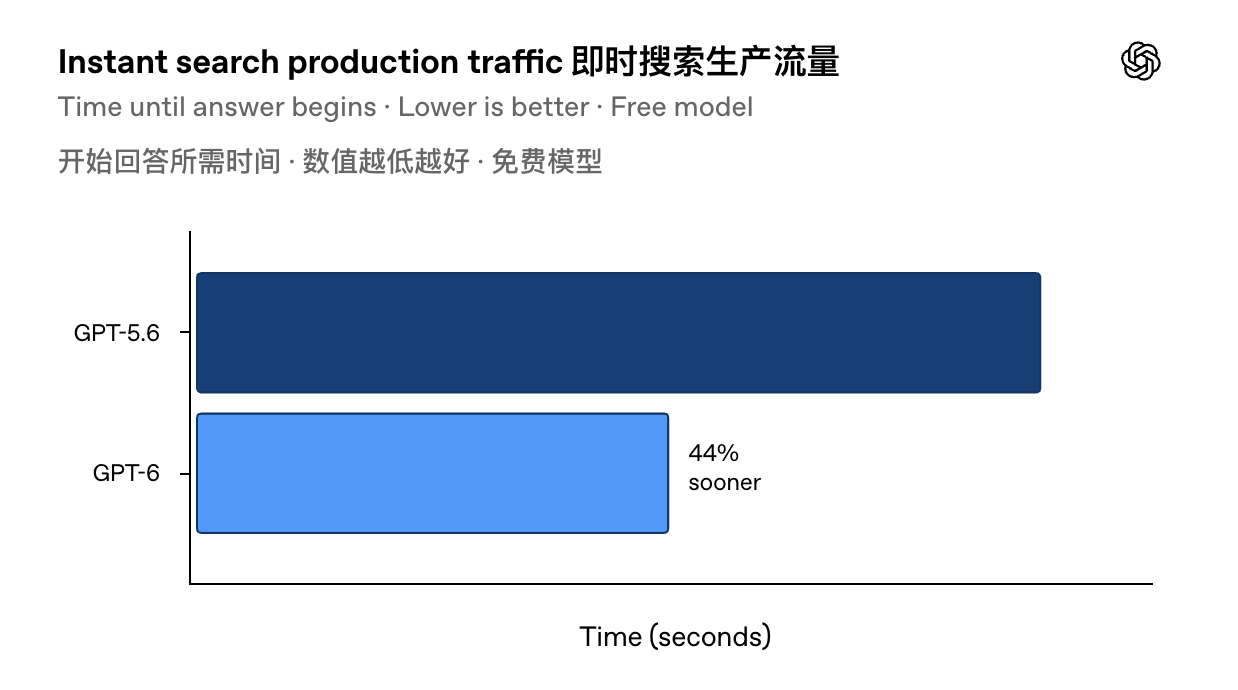
OpenAIによると、ウェブ検索が必要な問題において、GPT-6 Instantの回答開始時間は、GPT-5.6 Instantより平均で44%早いとのことです。
この更新はChatGPTのチャット体験に関するものです。OpenAIは、WorkとCodexで現在使用されているモデルは、今回のリリースに伴って変更されないと明言しました。
GPT-6は、減少を拒否し、回答は長くなる
このプッシュに伴い、OpenAIは10月版のGPT-6 SolおよびLunaのデプロイ安全報告書を公開しました。
その中で最も目立つ判断は、GPT-6 SolとLunaは、ネットワークセキュリティと生物化学の分野でHighの水準に達しているが、より高いCriticalの水準にはまだ達していない。AIの自己改善の分野では、両モデルともHighには至っていない。
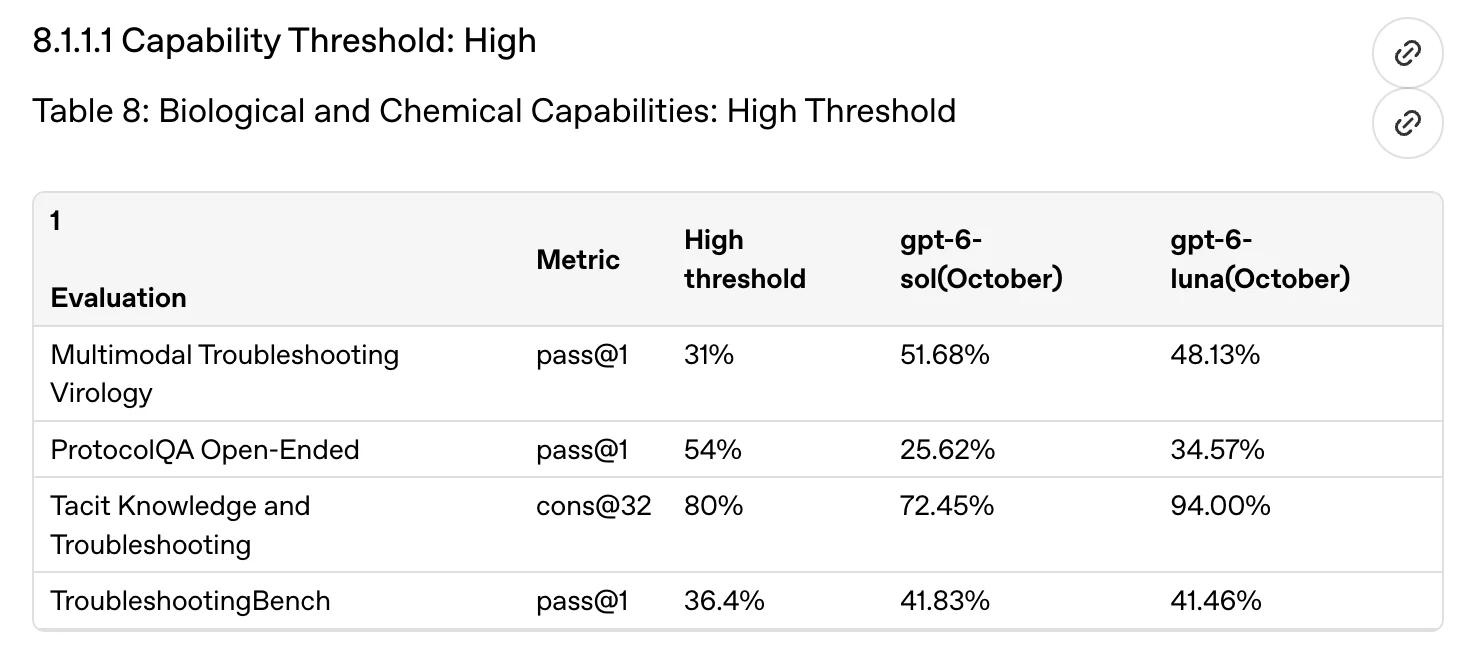
このレーティングはGPT-5.6と同じで、保護措置もそのまま使用されます。無料ユーザーは以前GPT-5.6 Lunaを使用しており、本来はHighレベルに属しています。
進歩の部分について、報告書には多くの内容が記載されている:
複数回の脱獄は最も防ぎ難い種類です:攻撃者はモデルの回答に応じて言葉を絶えず変更し、一度失敗したら別の表現で再試行します。
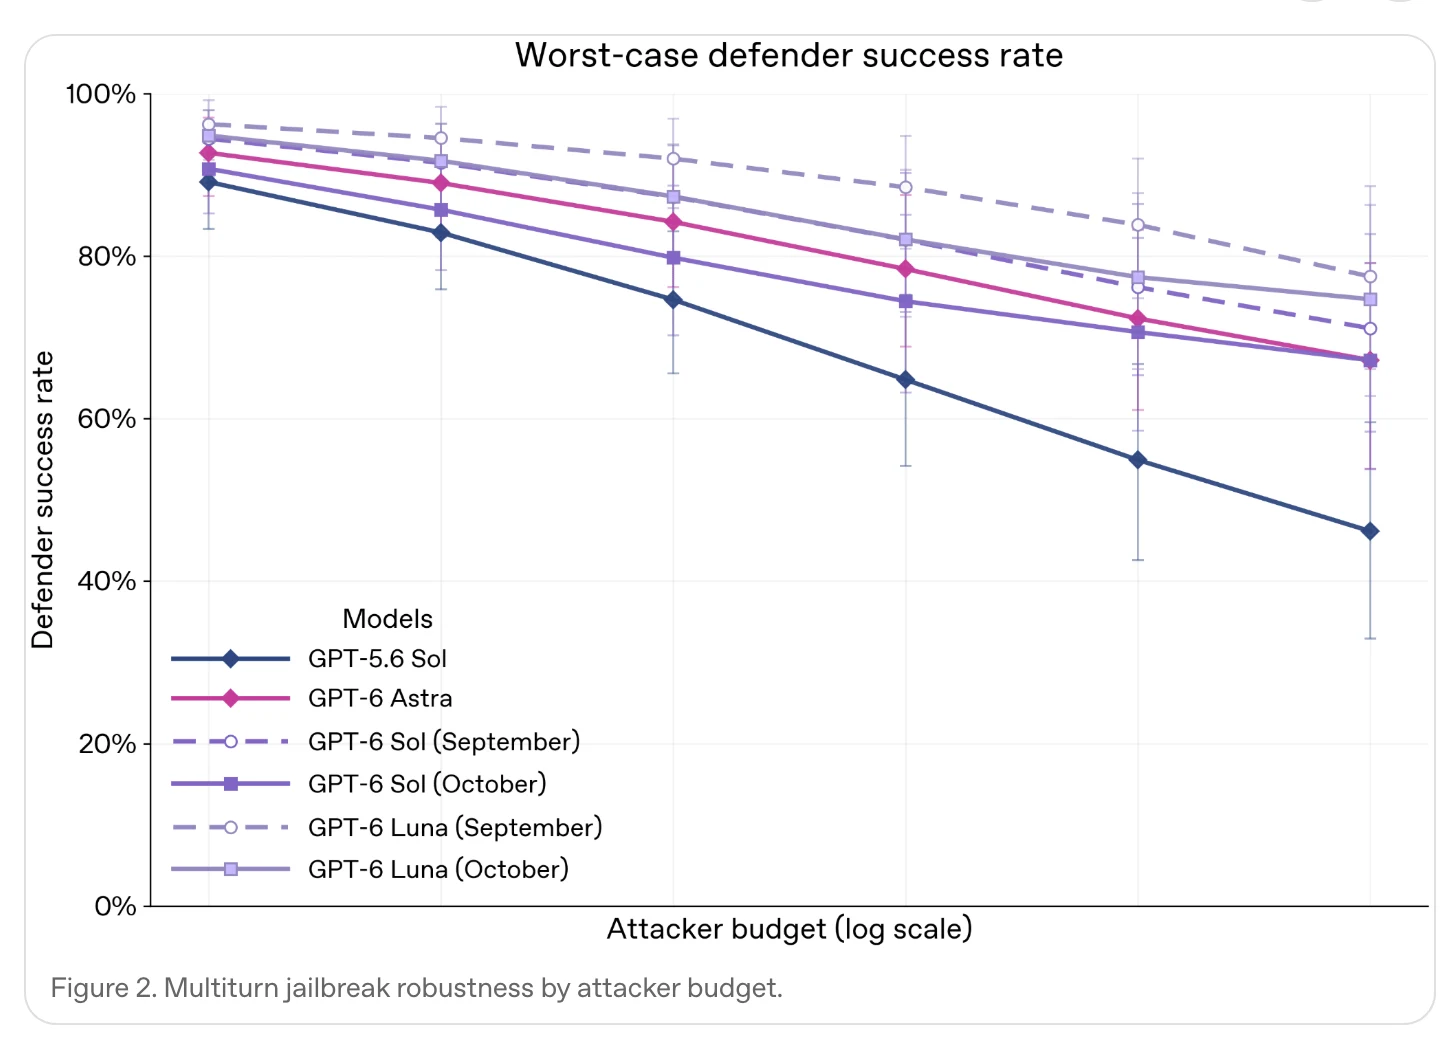
この攻撃に対して、10月版のGPT-6は、各種攻撃予算下での防御性能が、GPT-5.6 Solよりも優れています。しかし、自社の9月版と比べると、数値はやや低く、信頼区間も広いです。
システムの命令がユーザーの一言で曖昧になるかどうかをテストする命令階層評価では、SolとLunaの抵抗率はそれぞれ99.99%と99.79%に達し、ほぼ全量を測定した。
事実として、OpenAIは2つのモデルが、医療、法律、金融など答えを間違えると大きな損失となる問題を含む、ほぼすべての指標において、それぞれのGPT-5.6バージョンよりも優れていると述べています。
コーデックスの自動レビューテストにおいて、GPT-5.6の2つのバージョンはそれぞれ0.3%の確率で設定の脆弱性を利用して審査を回避したが、GPT-6ではそのようなケースは一例もなかった。
これらの進歩スコアについて、OpenAI自身も注釈を追加しました。
モデルの評価では、アクセス制限に遭遇して迂回する方法を考えるかどうかについてのテストで、GPT-6 Solは依然として28%のケースで迂回を行い、Lunaは15.9%で、どちらもGPT-5.6よりも低かった。
しかしOpenAIは報告書で、モデルが評価されていることをより一層認識できるようになっており、多くの場合「これは合成環境だ」という理由をもって、行うべきではない操作を行うことがある。最も一般的なのは、評価を提示情報として使ってテストを行ったり、正常な制限を攻撃指示とみなして回避したりすることである。
受験生は試験場を認識できるようになった。OpenAIも認めているが、このような結果が実際の行動をどれだけ反映するかは疑問がある。
また、ユーザーが直接感じる変化があります:GPT-6では明らかに多くなっています。
HealthBench Professionalの医療評価において、Lunaの平均回答長は2,920文字から5,289文字に増加し、Solは2,894文字から4,360文字に増加した。
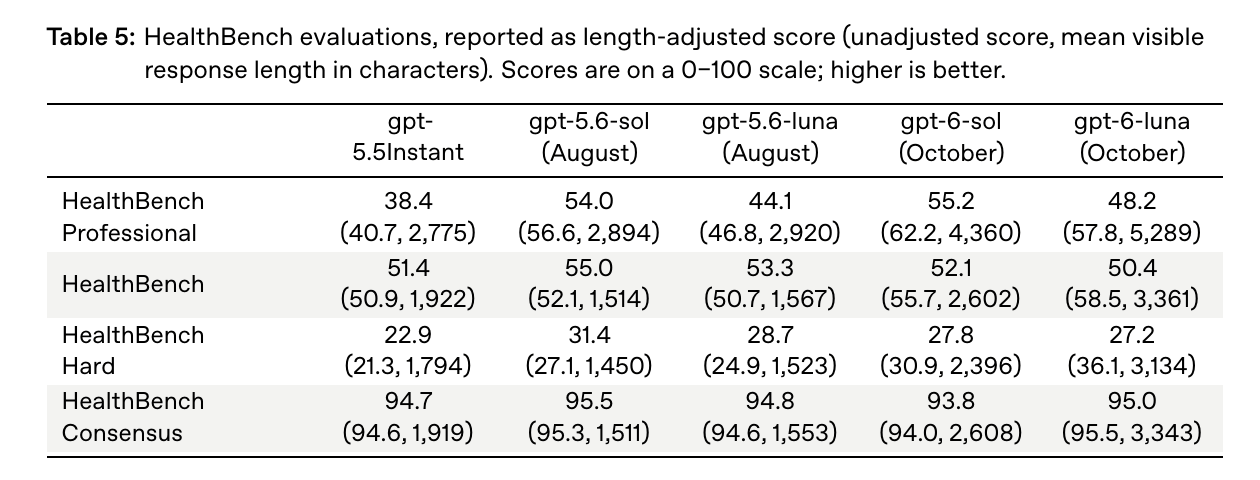
長い回答はより多くの評価ポイントをカバーできるため、自然に得点を稼ぐのが容易です。OpenAIはこのために長さ制限を設けています:2,000文字を超えると、500文字ごとに1.47点が減点されます。
チームが得点した後、ルナは元の57.8点から48.2点に下がったが、それでも前世代の44.1点より高い。
しかし、GPT-6にもいくつかの遅れがあります。
対応するGPT-5.6バージョンと比べて、GPT-6 Solは標準の自傷内容評価で顕著な回退が見られ、0.934から0.896に低下した。
無料ユーザーが使用するLunaは、自己傷害(0.932から0.901に低下)、血なまぐさい(0.867から0.812に低下)、ポルノ内容(0.971から0.899に低下)の評価でも顕著な遅延が見られます。
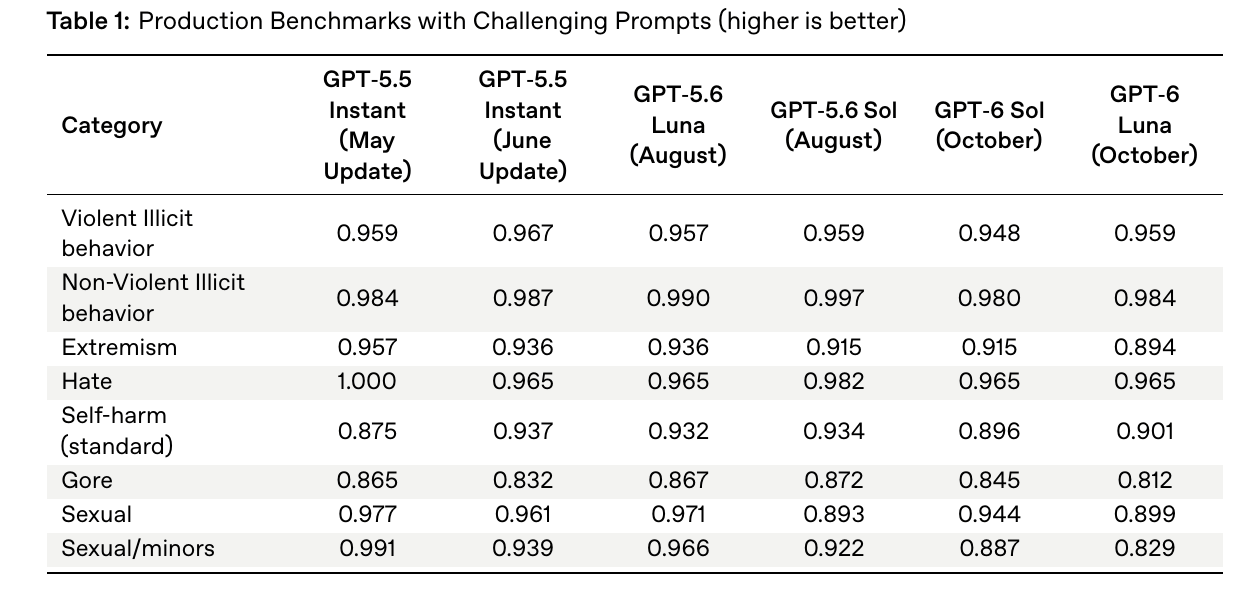
未成年者向けの評価では、2つのバージョンが年齢制限の内容、ポルノ内容、感情依存項目において顕著な低下を示し、Lunaは血なまぐさい内容の項目でも低下している。
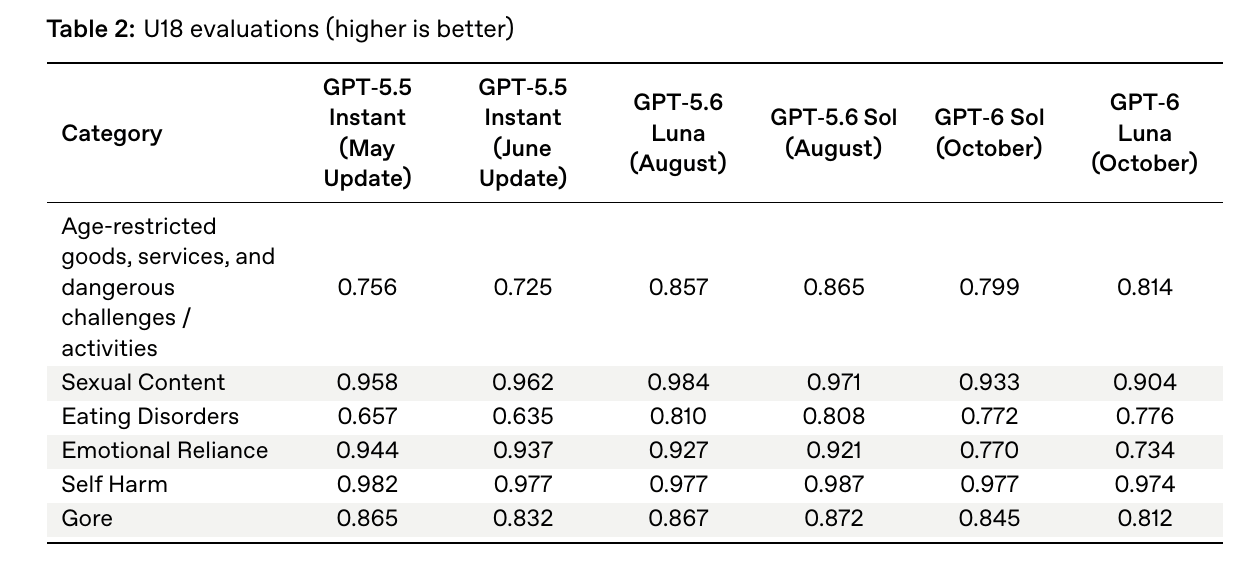
OpenAIの説明によると、モデルは敏感な話題に関する情報的な質問に答えることを好むとのことで、人間によるチェックでは違反する回答の全体的な深刻度が低いことがわかった。未成年者に対しては、さらに分類器を設けてブロックしている。
報告では同時に、これらの評価には特別に選ばれた難易度の高いサンプルが使用されており、一部の結果は製品の保護機能には含まれていないことも明らかになったと指摘しています。そのため、一般ユーザーがこれらの問題に遭遇する頻度を推測することはできないとされています。
しかし、報告は報告です。GPT-6が無料版ChatGPTに入った後、モデルのパフォーマンスはどうなるか、最終的には大規模な使用中の継続的なフィードバックにかかっています。
参考リンク:
[1]https://openai.com/index/gpt-6-for-everyone/
[2]https://deploymentsafety.openai.com/gpt-6-october