
AIにARCの抽象推論問題を教えていたのが、まさかの猫だったとは?
何愷明(カイミン・ホー)氏のチームによる最新論文は~を提案したNAT-ARC、純視覚的なARC解答ソリューション。
LLMに頼らず、ImageNet上の猫・犬・花草で事前学習を行い、モデルに「見る」ことを学ばせ、それを抽象的な格子推論へ転移させています。
その結果、NAT-ARCで最も優れた単一モデルはARC-1で63.4%のpass@2スコアを記録し、アンサンブル後には70.2%に達しました。
これは純視覚方式として初めてのことです汎用特化型LLMシステムに迫るの水準。
ARCは、最も難しいとされるAI向け視覚知能テストの一つで、いくつかの色付き格子の入出力例を示し、その背後に隠された変換ルールを推測させ、それを新しい格子に適用させる。
従来の主流な解法は一様に、格子を文字や記号に変換してLLMに推論させていた。
この論文はむしろ逆で、事前学習段階ではARCのグリッドすら使っていない。
実世界から学習したモデルの視覚能力は、そのまま見事に完全に抽象的な色付きの格子推論へと転移した。
ARCトラック、ビジュアルソリューションの台頭
ARCはAbstraction and Reasoning Corpusの略称で、Kerasの生みの親であるFrançois Cholletが2019年に提唱したものです。
ARCの各問題の形式はとても統一されており、最大30×30の2次元グリッドで、最大10種類の色が使われます。問題には2から5組の入出力例が与えられ、挑戦者はその例から隠された変換ルールを推測し、そのルールをまったく新しい入力グリッドに適用して、出力を予測する必要があります。
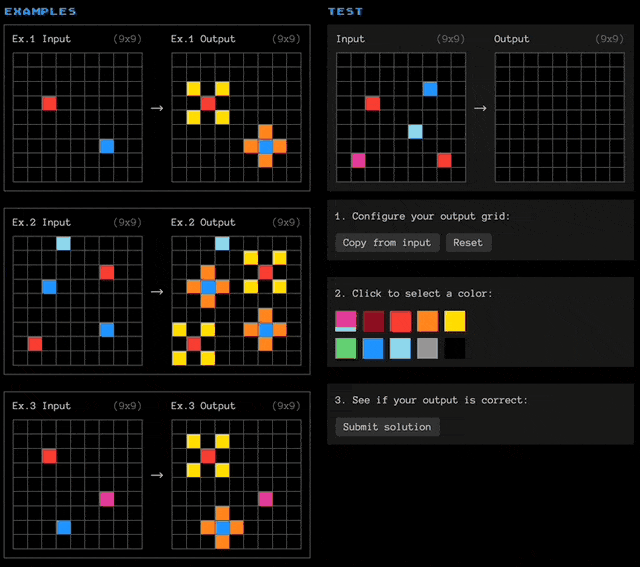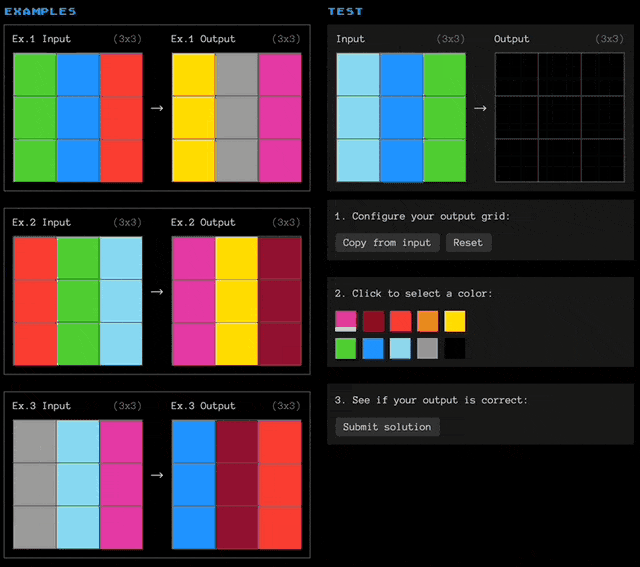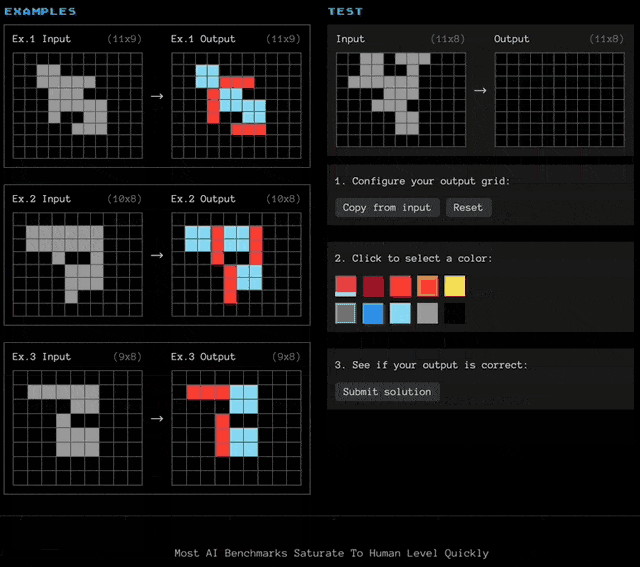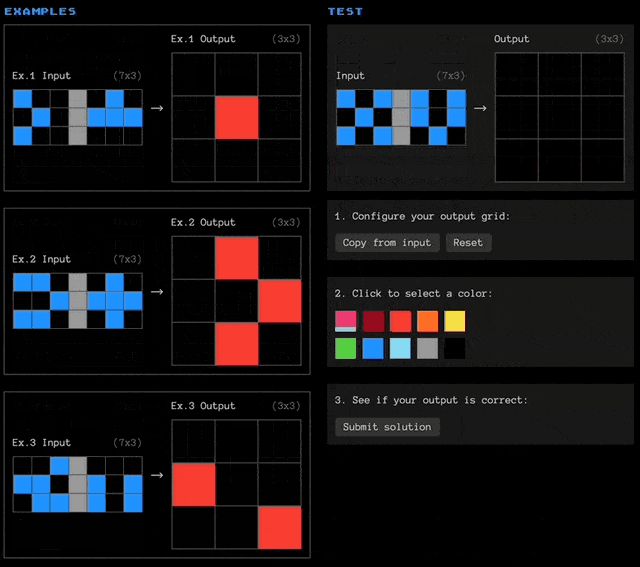
これらの問題は、絵を見てパターンを見つける子供向けのクイズのように聞こえますが、ARCはAIにとって非常に難しいものです。
一方で、各問題の変化のルールがすべて異なっており、暗記できる固定のテンプレートがない。
それに、データ量が極めて少なく、わずか2、3の例から抽象的なルールを归纳し、それを正確に実行しなければならない。
この組み合わせにより、ARCはAIの抽象的推論能力を測るベンチマーク。
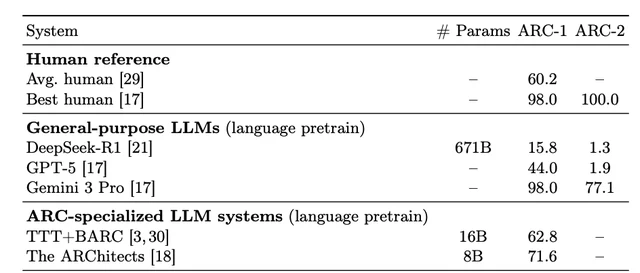
現在ARC分野で支配的な地位を占めているのはほぼすべて大規模言語モデル方式であり、これらの方式に共通する発想は、グリッドをテキストや記号列に変換して言語モデルに処理させるというものです。
ビジュアル路線はその後にようやく台頭し始めた。
ある研究チームはまったく異なる道をたどりました。彼らはグリッドをテキストに翻訳するのではなく、視覚モデルでグリッド画像を直接処理する方式に切り替えました。
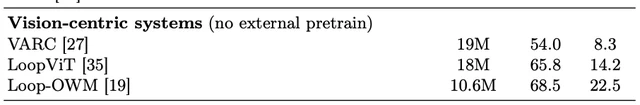
その中で最も重要な一歩は、同じMITチームが提案したものから生まれた。VARCこの手法はARCを条件付きの画像から画像への翻訳タスクとして再定義し、19Mパラメータの視覚モデルで54%に到達しました。
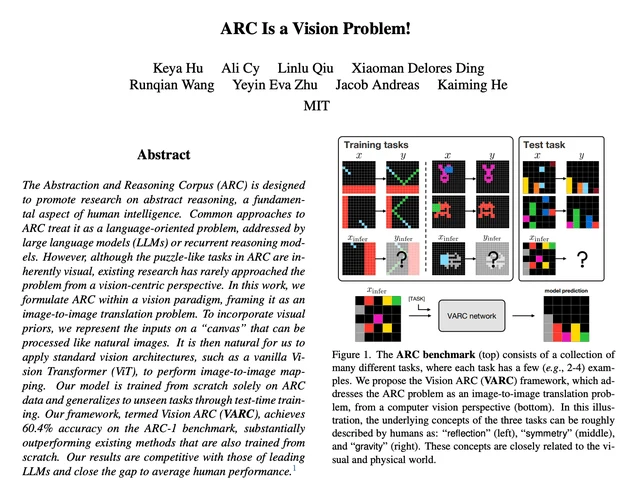
LoopViTはこのフレームワークに反復推論機構を加え、18Mパラメータで65.8%を達成した。
Loop-OWMは動画事前学習モデルでfew-shotを行い、10.6Mパラメータで68.5%を達成した。
これらのモデルのパラメータ数はLLM方式より数桁小さいですが、効果はすでに追いつき始めています。
しかし、ビジュアル路線には依然として構造的な弱点がある。
LLMがARCでどんどん良い結果を出せるようになった核心的な理由の一つは、膨大なコーパスによる事前学習を通じて汎用能力を蓄積してきたことであり、モデルが大きく、事前学習が十分であるほど、下流タスクにおけるスケーリングの効果が顕著になる。
一方、視覚ARC方式の多くのモデルはランダム初期化から学習を始めており、事前学習の恩恵を受けていない。
この点を踏まえ、NAT-ARCの目標は、視覚ルートに事前学習というステップを補い、そのスケーリングのボトルネックを打開しようとすることである。
猫を見終わったら、ARCに挑戦
NAT-ARCの核心的なアイデアは、VARCの視覚パイプラインの前にImageNet MAE事前学習というステップを挿入すること。
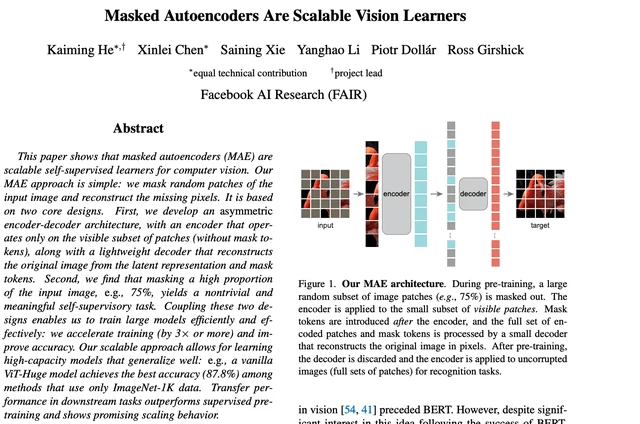
MAE(Masked Autoencoder)は、何愷明(カイミン・ヘー)がFAIR時代の2022年に提案した自己教師あり視覚事前学習手法である。
その訓練過程は、一枚の画像の大部分を覆い隠し、モデルに残った断片から元の画像を復元させるというものです。
このタスクを通じて、モデルは物体の形状、構造、空間的な関係を理解できるようになります。
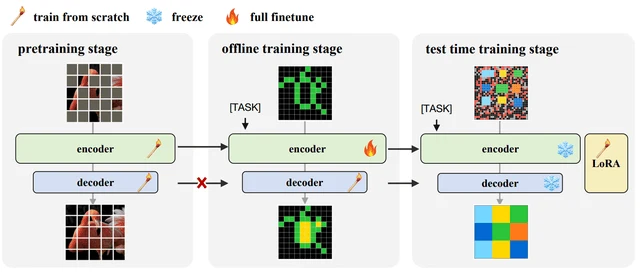
NAT-ARCの手法は、ImageNet(約130万枚の猫や犬、草花などの自然画像を含むデータセット)で訓練したMAEのencoder重みをそのまま視覚エンコーダの初期化に使い、decoderはランダム初期化から訓練するというものです。
全体の流れは三段階に分かれます。
- 第一段階は、ImageNet上のMAEでencoderを事前訓練する;
- 第二段階は、ARC訓練セット上でエンコーダ・デコーダ全体をオフラインで訓練する;
- 第三段階は、テスト時に各問題ごとに個別にLoRA微調整を行う、です。
微調整段階では、各問題に2〜5組のデモンストレーションペアしかなく、モデルはこれらのデモからその問題のルールを「学ぼう」とします。
注目すべき細部が一つあります。NAT-ARCはMAEの公開checkpointをそのまま使い、事前訓練に追加で一銭も費やしていません。
ただし、このcheckpointはもともとより大きなサイズのImageNet画像向けに設計されたものであり、ARCのグリッドはわずか64×64ピクセルで、サイズ差が非常に大きいものです。
適合させるため、NAT-ARCは元のpatch embeddingと位置エンコーディングを捨て、backboneの重みだけを保持し、位置エンコーディングを2D RoPEに置き換えました。
簡単に言えば、NAT-ARCはMAEがImageNetで学んだ視覚特徴抽出の能力だけを保持し、ImageNetの画像サイズに結びついた空間認識の部分をすべて捨てて、より柔軟な方法で再学習させたのです。
しかし、なぜ猫や犬の写真から学んだことが、抽象的なグリッド推論に役立つのでしょうか?
論文はアテンションの可視化によって一つの手がかりを示しています。
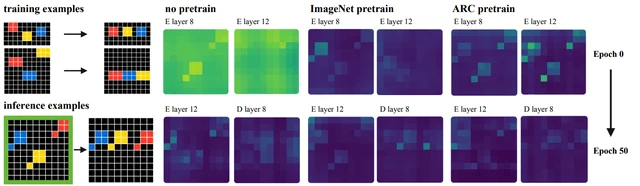
研究者たちは、三つの初期化方法(事前訓練なし、ImageNet MAE事前訓練、ARCスタイルのグリッドMAE事前訓練)のモデルを同じARC問題の前に置き、ARCの訓練を始める前のアテンション分布を観察しました。
結果は明らかで、ランダム初期化のモデルのアテンションは均一に散らばり全く焦点がありませんでしたが、ImageNetで事前訓練されたモデルはすでに前景と背景を区別でき、アテンションが自動的にグリッド内の意味のあるパターン領域に集中していました。
このモデルはARCグリッドを一度も見たことがありませんが、ImageNetで学んだ「物体を背景から認識する」能力が、ARCグリッド上で自然に発揮されたのです。
研究者たちはさらにタスクレベルでの分解を行いました。
彼らは事前訓練後に顕著に向上した15問のARC問題を選び出し、手動で注釈を付けたところ、これらの問題は二種類のタスクに集中していることが分かりました。
そのうち6問はmatch-and-copyに属し、モデルは一致するオブジェクト、色、またはパターンを認識し、対応する構造を出力にコピーする必要があります;
別の6問はconnected-component reasoningに属し、モデルは空間的に連結された領域を認識、塗りつぶし、または再着色する必要があります。
この二種類の能力は、まさに自然画像における視覚的先験に対応しています。
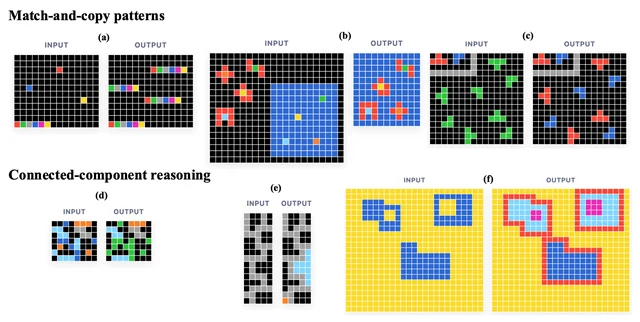
ImageNetで猫を見て学んだ「猫を草地の背景から分離する」ことは、ARCでは「この連結された色の領域をグリッドから認識する」ことになりました。
視覚世界と抽象世界の根底にある論理は、物体のグループ化、パターンマッチング、領域分割といった操作において、同じ一連の表現を共有していたのです。
猫猫から始まり、猫猫へ還る
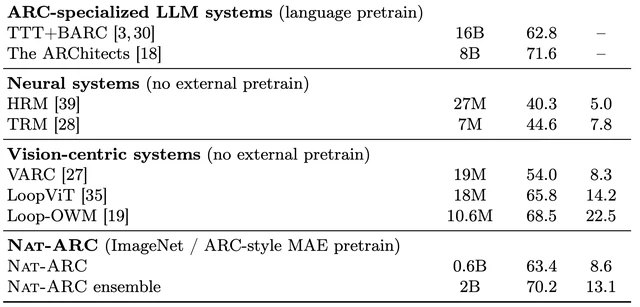
NAT-ARCのARC-1での最終成績は以下の通りです。
最も良い成績を収めた単一モデルはhugeスケールを採用し、パラメータ数0.6Bで、pass@2成績は63.4±0.7%に達しました。
アンサンブルでは、研究者たちは三つの異なる事前訓練戦略(事前訓練なし、ImageNet MAE事前訓練、ARCスタイルのグリッドMAE事前訓練)でそれぞれ訓練したモデルをプールし、多数決を行うことで、70.2±0.6% pass@2を達成し、総パラメータ数は約2Bでした。
参照として、ARCに特化して微調整されたThe ARChitectsは、8Bの言語モデルを使って71.6%を達成しています。
視覚路線は四分の一のパラメータ数で、専用LLMシステムの城下まで迫ったのです。
数字を超えて、この論文の最も重要な発見は、事前訓練が視覚路線のscalingのボトルネックを突破したことです。
事前訓練がない場合、モデルが大きくなるほど逆に成績は悪化しましたが、事前訓練を加えると、scalingが初めて正のリターンをもたらし始めました。
まず訓練曲線を見てみましょう。オフライン訓練段階では、ImageNetで事前学習されたモデルの収束速度が明らかに速く、base、large、hugeの3つのスケールすべてでそうであり、最終精度もより高くなりました。
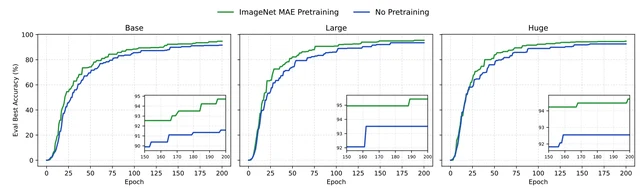
しかし最も興味深い発見は、スケーリング曲線の中に隠れていた。
プリトレーニングなしの場合、モデルはbaseからlargeへは性能が向上するが、largeからhugeにすると逆に精度が低下した。
モデルを大きくすると効果が悪化する、これは深層学習では一般的ではない現象であり、ARCというタスクのデータ量があまりに少なすぎることを示している。モデル容量の増大がもたらしたのはより強い汎化ではなく過学習である。
さらにImageNetの事前学習を加えると、scalingカーブは健全になり、base・large・hugeの3つのスケールがいずれも右肩上がりで、モデルが大きいほど効果が良い結果となりました。
論文の中で最もクールな実験の一つは、可視化による検証である。
研究者たちはautoencoderを訓練し、ImageNetの画像を60×60・10色の離散グリッド表現にマッピングしました。これは、猫の画像一枚をARCグリッドに「翻訳」したことに相当します。
その後、彼らはNAT-ARCを使ってこのグリッドにARC変換を実行し、180°回転させ、青い枠線を一周追加してから、再びピクセルにデコードし戻した。
その結果、猫は確かに変換され、枠線も確かに追加されました。猫から訓練されたこのモデルは、再びタスクの中で猫のもとへと戻ってきたのです。
この実験により、「自然画像とARCグリッドが同じ表現空間を共有する」ということが統計的な数字から可視化された証拠へと変わった。
ARCグリッド上で学習した変換規則は、自然画像の潜在表現にそのまま適用でき、逆もまた同様である。
抽象的なルールと視覚的表現の間のつながりは、この二つの世界がもともと備えているものです。
著者紹介
論文の筆頭著者はXiaoman Delores Ding、MIT CSAILのメンバーで、何愷明(Kaiming He)の研究グループ出身です。
彼女は同時にVARCの第一著者でもあり、このNAT-ARCは自身の前回の研究を基盤としてさらに前へ進めたものに相当する。
その他の著者には胡珂雅(Keya Hu)が含まれる。彼女は何恺明(Kaiming He)の最初の期の女性弟子の一人で、学部は上海交通大学。
同じくMIT出身のKatelyn GanとVictor Yinもおり、两人とも学部生で、CSAILでstudent researcherを務めています。
【翻訳対象テキスト】 通信著者の何愷明(か・かいめい)氏については言うまでもない。彼はResNetとMAEの著者であり、この2つの研究からこの10年近くの視覚AIの主要な流れをほぼたどることができる。
彼はMITに入学して以来、視覚分野の基礎研究を継続的に生み出してきた。この論文で使われているのは、まさに彼自身が4年前に提案したMAEを事前学習ツールとして用いたものであり、自らの古い武器で新しい道を切り開いたことになる。
VARCはCVPR 2026に採択されており、NAT-ARCはその直接の続編です。
このチームは2本の論文を通じて、純粋な視覚路線でARCの解決に取り組み続けており、LLMが支配的なこの分野で、実験データによって視覚路線の天井を突破し続けています。
論文のアドレス:
https://eccv.ecva.net/virtual/2026/poster/5527