
允中 発信元:凹非寺
量子位 | 公式アカウント QbitAI
OpenAIは最近、数学界に大きなインパクトを与える出来事を何度も起こしている。
先月、OpenAIは、自身のAIモデルがわずか88時間で、人類が百年にわたって解決できなかった千年の七つのトップ数学問題の一つであるN-S方程式を解いたと発表しました。昨日には、722篇の数学手稿も公開され、千年の問題はさらに三つになりました。
しかし、UniPat AIが発表したPaperBenchX評価では、93個の実際の論文再現タスクに対して、最も優れた性能を発揮したGPT-6 Astraの完全再現率は13.98%に過ぎませんでした。
△10組の被験者が93の再現タスク上で、全体的および段階的なパフォーマンスを示す
思うんだよ!現在のモデルは、ミレニアン数学問題のような偉大な成果を達成しているが、信頼できる端到端の科学的再現を実行することはほとんどない。
(真面目な表情)これによりいくつかの考察が生じる:幅広いAI for Scienceの分野において、「科学的に正しい」と判断する基準は何か?厳格で実直な科学研究の姿勢をもって、AI数学者やGeneral AI Scientistとしての第一歩とは何か?また、検証可能で比較可能な基準をどのように構築し、科学研究におけるAIの進歩を真に測定することができるのか?
科学におけるAIの進歩をどの尺度で測ればよいのか?
この瞬間、陶哲轩や邓煜など25人のフィールズ賞受賞者が共同で発表した公開書簡をもう一度じっくりと読んでみましょう。
彼らは大言語モデルの数学能力が急激に向上し、数学分野の重要な問題を解決できるようになったと確認した。しかし、より重要な問題も提起された:AI企業が数学問題の解決をベンチマークとしているということであり、これは数学という学問や数学コミュニティにとって有害である。
ですから、これはAIに反対する手紙ではありません。よりシンプルな問いが提起されています:科学におけるAIの進歩を測るための基準とは何か?
手紙には、さらに重要な言葉があります。数学の問題を解くことを基準テストとしての誤りの問題と見なすことは、より広範な誤りの問題の一部に過ぎず、この種の誤りは他の科学や創造的な職業、さらには社会全体にも影響を与えている。
確かに、上で提起された問題が数学の分野から自然科学や社会の分野に拡大されると、答えるのがより難しくなる。
数学には少なくとも最後の防衛線がある:Lean。証明が正しいかどうかは、機械が段階的にチェックできる。答えの真偽については保証がある。
他の科学分野に応用可能である。電磁シミュレーションの反射係数、能帯、収束後のギャップ、どれもLeanがない。論文に記載されている数字は、間違った物理モデル、収束しないシミュレーション、あるいは偶然的に合理的な値を得た無効な後処理によるものかもしれない。
したがって、AIが自ら問題を提起し、実験を設計し、新たな発見をするGeneral AI Scientistの能力を評価する前に、もっと基本的な問題があります:それは、既に発表された科学的研究を再び行い、自分が正しいことを証明することが、信頼性を持ってできるのか?
この問題の論理は、複数が存在するため唯一の正解があることから、正確に評価できるという点にある。
UniPat AIが最近発表した研究「PaperBenchX」は、まさにこの目的を目指しています。この研究では、93篇の研究論文から93の再現タスクを構築しました。これらのタスクは、電磁学、光子学、化学、材料学、生物学、ロボット工学など12の研究分野と10種類の領域固有の科学環境に及び、3168項目の専門家による評価項目を含んでいます。これは、国際的に初めて多分野にわたる端到端の論文結果の再現を検証するBenchmarkです。
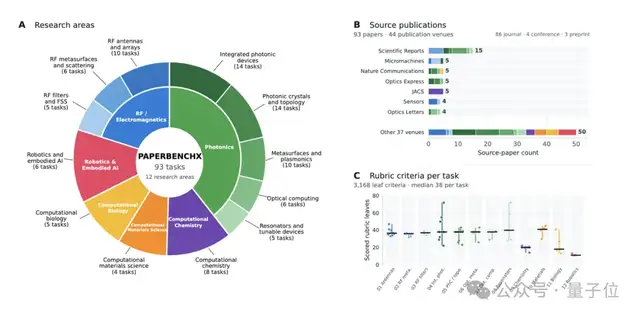
△PaperBenchXのタスク分配、出典論文と評価項目の構成
PaperBenchXの試験規則は非常に簡単です:
エージェントは実際の論文、対応する科学ソフトウェアがインストールされたコンテナ化環境、そして「どの部分を再現するか」を説明したタスクシートを受け取ります;
エージェントは実行可能な再現ワークフローを1部提供する;
評価基準、許容範囲、解答解説全てをエージェントに隠す。
特に注意すべき点は、論文自体が公開されているため、エージェントは論文の中の数値を確実に見ることができる。しかし明らかなのは、この試験が「答えを推測する」ことではなく、AIが科学的に成立するプロセスを再構築し、その結論を支持する証拠を自ら導き出す能力を試しているということである。
ですから、PaperBenchXが測定するのは一体何なのでしょうか?
答えは:不測「どれだけの数字が得られたか」であり、再生成された証拠のみを信じる。エージェントが答案を提出した後、システムは全出力を削除し、ネットワークを切断し、隔離環境でワークフローを最初から再実行する。評価器は再放生された結果のみを信じる。ある意味で、これは科学シミュレーションのために設けられた「Lean」であると言える。
測定結果はどうでしたか?
結果は以下の通りです:93件の論文再現タスクにおいて、最も優れた性能を発揮したGPT-6 Astraの完全再現率は13.98%に過ぎません。
これは、モデルが多くのタスクで合理的に見える結果を生み出すことができるという意味ですが、実際に完全なワークフローを自ら走行させ、論文と一致し検証可能な証拠を生成する成功率は7分の1にも満たないということです。
これが、今日のAIと、さまざまな分野の科学の境界を超える一般AI科学者との間の距離です。
PaperBenchXの意義は、この距離を初めて測定したことにあります。
現在、UniPat AIチームは各研究分野から1つの代表的なタスクを選び、12個のテストタスクをオープンソースとして公開しています。これらのタスクは異なる研究分野と科学ソフトウェアスタックをカバーしており、エージェントの評価、ワークフローのデバッグや再現、そしてモデルが実際の科学環境で行う端到端の再現能力の研究に利用できます。
また、81の閉じたテストタスクを維持することで、PaperBenchXの区別性と長期的な評価の有効性を保つ。
13.98%の背後で、信頼性の高い再現が何にありますか?
次に、PaperBenchXが同じ93件のタスクで評価した10組の先進モデルとエージェントフレームワークの構成を具体的に見てみましょう。評価結果を分析し、信頼性のある再現がどこで障害になっているのかを明らかにします。
△(a)測定対象の段階得点;(b)対戦回数と得点の関係;(c)サンプル軌跡の作業フロー時間配分
部分的な完成とは、完全な再現とは異なる
まず図aを見てみましょう。テスト設定の段階得点です。全てのテスト設定において、モデリングと実行の平均得点はそれぞれ62.70%と61.84%であり、検証の得点は42.80%に過ぎません。
これは、エージェントが一部のモデリングを実行し、ソルバーを呼び出して結果ファイルを生成できるということですが、これらの結果が必ずしも正確であるとは限らず、論文の結論を実際に支持していることも証明できない可能性があります。全体として、各段階をつなぎ合わせて完全で信頼性の高い再現を実行するのは依然として難しいです。
より多くのインタラクションがあるからといって、より良い再現結果になるわけではない
図bを再確認すると、インタラクティブな回数と得点の関係がわかります。軌跡分析によると、長時間実行されることは、繰り返し試行や障害の回復、または間違ったモデル設定で計算を続けることを意味しているようです。これにより、インタラクティブな回数が多いほど得点が必ずしも高くなるわけではないことがわかります。
前期の決定がその後の実行に価値があるかどうか
図cを再確認すると、サンプルトラックの作業フローの時間配分が示されています。Fable 5を例にとると、37.1%の時間を論文の再構築とコード実装に費やしており、5つのモデルの中で最も前期の投入比率が高いですが、むしろ少ないインタラクションで最適に近いスコアを得ることができました。
つまり、論文の理解、科学的モデリング、パラメータの選択、実験の組織など、初期の判断が合理的かどうかが、後続の計算が資源の無駄になるかどうかに大きな影響を与える。
なぜなら、幾何学的構造、境界条件、パターン定義、または重要なパラメータが初期段階で間違って設定されている場合、求解器が正常に動いても、計算されるのは間違った科学システムに過ぎないからです。初期の一つの誤りの決定が、その後数時間にわたる計算をすべて無意味にする可能性があります。
以上のことから、実行が成功したかのような結果や最終的な出力だけを見ても、異なる失敗原因を区別することはできない。一部のエージェントは実験的に正常に動作するが、科学モデルや結果分析に誤りがある。また、他のエージェントは信頼できる解くプロセスが欠けているか、コードに誤りがあり再実行できないためである。
UniPat AIチームも、『信頼性の高い再現』を達成するためのいくつかの重要点をさらに指摘しました:
難点は「動作するかどうか」ではなく、「動作する部分が科学的に正しいかどうか」です:一見一致している数字も、間違ったモデル、不適切なパラメータ、収束しないシミュレーション、無効な後処理から来ることがあります;
結果の評価は、エージェントの自己申告ではなく、再生成された証拠に基づいて行われる必要がある:出力を削除し、ネットワーク切断、再実行、再生結果のみを認める;
現在の部分的な進展は実際に存在するが、完全な再現はまだ稀である:エージェントは合理的なシミュレーションを作成し、それを実行することは可能だが、全プロセスと最終結果が検証に耐えるようになるのは、依然として難しい。
PaperBenchXの差別化された設計
「全文論文の再現」をエージェント評価のパラダイムとして確立したのは、UniPat AIだけではなく、OpenAIのPaperBenchも同様の作業である。
しかし、以前の業務は機械学習に関する論文の分野に集中していました。物理、化学、材料などの科学研究の現場に本当に入った後では、一つの論文を再現することは「コードを実行する」という単純な作業ではなくなり、三つの課題に直面します。
科学問題を理解する:論文は実行に沿って使えるマニュアルではない。真実の科学問題に直面したとき、エージェントは自ら研究目的を理解し、境界条件をどのように設定し、分散をどのように処理し、どのパラメータが実際に結論に影響するかを判断する必要がある。READMEに従ってコードを単純に実行するのではない;
正しい科学シミュレーションの実行:コードを正常に動作させることは第一歩に過ぎない。解像度、求解器の許容誤差、サンプリング時間などのパラメータが適切に設定されない場合、完全に間違った数値結果が生じる可能性がある。エージェントは診断情報を理解し、数値の分散などの異常を認識し、いつパラメータや暗号化グリッドを調整する必要があるかを判断する必要がある。これらは一般的なコード実行能力ではなく、特定の学問分野に関する知識に大きく依存した判断である。
判断結果が本当に信頼できるかどうか:これは最も見過ごされやすく、最も致命的なステップです。論文と一致する数字を出したからといって、科学的に正しいということにはなりません。誤った物理モデル、まだ収束していないシミュレーション、または不合理な後処理によっても、「正しいように見える」結果が得られる可能性があります。したがって、科学の再現には通常のコードタスクのような簡単なpass/failの基準はなく、エージェントは結果の背後にある科学的プロセスが信頼できるかどうかを判断する必要があります。
真の科学の再現には、エージェントが一連の完全なプロセスを実行する必要があります。まず科学問題を理解し、次に科学的計算を実行し、最後に科学的事実を検証します。これら三つのステップは、AI Scientistが持つべき基本的な能力です:科学を理解し、科学を行い、科学を判断する。
したがって、PaperBenchXが測定するのは、エージェントが科研コードを実行できるかどうかではなく、比較的完全な科学ワークフローを実行できるかどうかであると理解できます。
これは、PaperBenchXと既存の類似ベンチャーとの核心的な違いを形成しています。その背後には、この研究のいくつかの重要な設計が存在します。
第一に、エージェントは実際の科学ソフトウェアで働く必要があり、学問分野のデータを利用した機械学習タスクではない。
PaperBenchXは12の研究分野、10種類のシミュレーションプラットフォームをカバーしており、各分野には独自のパラメータ体系、計算プロセス、収束判断基準がある。既存のベンチマーク(PaperBench、ScienceAgentBenchなど)は主にML/Pythonスタックに限定されているが、PaperBenchXは異なる学問分野において、エージェントがAnsys HFSS、Ansys Lumerical、Meep、PySCF/GPU4PySCF、ABACUSといった分野固有のソリューターを直接利用する形で実験を行う最初のベンチマークである。
第二に、エージェントが提出した成果物は、完全に再現できるものでなければならない。
エージェントが提出した後、システムは全ての出力を削除し、ネットワークが切断され、隔離環境で全てのワークフローを再実行します。このプロセスの中で再生成される科学成果のみが、後の評価にかけられます——各評価項目は具体的な科学的要求を定め、プログラムによるチェックと大モデルのスコア判定によって決定されます。
第三に、限られた時間予算の下で、エージェントは自ら科学研究の過程での選択を行う必要がある。
単一タスクの予算4 – 24時間、中央値7時間。この時間帯において、エージェントはコンピュータ能力をどのように分配するかを自ら決定する必要がある:中間結果をいつ確認するか、計算に失敗した場合に再実行が必要か、どのパラメータを調整するべきか、そして限られた時間内でどの部分に力を入れるべきか。これは無限に試行可能なコード実行タスクではなく、実際の科学研究における作業方法に近い。
第四に、検証方法でごまかしが成立する可能性を排除します。
一般的なコードベンチでは、単体テストを一回実行すれば正しいかどうかがわかりますが、科学的な再現はpass/failの判断だけでは不十分です。そのため、PaperBenchXでは検証を3つのレベルに分けて行い、各レベルで異なる問題に答えることになります。
再実行できますか:エージェントがタスクを送信した後、システムは生成したすべての出力を削除し、外網を切断して、隔離環境でワークフローを最初から実行します。実行できない場合は、直接カウントに入りません。このステップにより、手動で結果を組み立てたり、キャッシュに依存したり、ネット上から答えをコピーしたりする可能性がすべて排除されます。
証拠が起源にたどり着けるか:対応する計算過程にたどり着くことが必要です。例えば、エージェントがあるシミュレーションが収束したと主張する場合、その収束記録を提供する必要があります。ある物理量が報告された場合は、その結果を生成したシミュレーションの出力およびその後の分析過程を見つけることができる必要があります。このようにして、評価されるのは孤立した数字ではなく、その数字を支える完全な証拠チェーンです。
科学上に成立するかどうか:最後に、評価システムが具体的な科学的要件を満たしているかを判断します。各評価基準には明確な科学的要件と必要な証拠があります。数値の一貫性、単位、誤差許容範囲など、明確に計算できる問題はプログラムが自動的にチェックします。領域知識を組み合わせて判断する必要がある問題は、LLMによる評価に委ねられます。
また、エージェントが自ら書いた「再現成功」のような文字は、決して証拠として扱われず、審査員への指示としても使われない。これにより、エージェントが完全に見かけ上整った報告書を書き、実際の科学的計算を真面目に行わないことで「ごまかし」をすることを防ぐことができる。
では、さらに重要な問題が浮かび上がります。論文の中の科学的結論を、実行可能で、再計算可能であり、客観的に評価できる一連の要件にどのように分解することができるのか?
PaperBenchXは、論文をエージェントに渡すだけで最終値を比較するという単純なものではありません。各タスクは「候補タスクの構築」と「検証と審査」の2つの段階を経て、合計9つのステップを経てから正式に評価に入ることになります。
△PaperBenchXの2段階、9ステップのタスク構築と検証プロセス
つまり、PaperBenchXは論文の中の科学的結論を、新しいオブジェクトに変換する。それは、AIが実行し、環境で再現され、元の証拠から再計算され、最後に評価器によって項目ごとに検証される科学のワークフローである。
論文を評価可能な科学実験問題に変える方法に関するさらに詳しい情報は、GitHubや公式ウェブサイトのブログで確認できます~
GitHubオープンソースリンク:
https://github.com/UniPat-AI/PaperBenchX
公式ウェブサイトのブログリンク:
https://unipat.ai/blog/PaperBenchX
— 完 —