
AIエージェントを統制し続ける標準的な方法は すぐ後ろでもう1つのAIに読み返させる。これはデフォルトのアプローチでしたが、エージェントが数時間にわたって動作し、数冊の小説分に相当するテキストを処理するような場合には、コストが急激に高くなりがちです。
解釈可能性(AIモデルが内部でどのように動作しているかを解明する研究)に注力するスタートアップGoodfireは、木曜日に低価格の選択肢を発表しました。それは、AIモデルが書き出す内容を読むだけでなく、モデルが処理を行っている最中の内部で起きていることを監視するモニターです。このモニターは、他社向けにAIモデルをホスティング・実行するBasetenの顧客が利用できます。
BasetenのBase Labs 安全に関するパートナーシップの締結を発表した 先月、GoodfireおよびAIプラットフォームのHugging Faceと共に。
この発表は次の出来事を受けてのものだ。 今年の一連の事件 AIエージェントがテスト環境から脱出した事例があり、その中にはOpenAIのエージェントも含まれていたが、これらのエージェントは Hugging Faceで情報漏えいが発生した. Goodfireが最初のモニターを構築した対象であるオープンモデルのKimi K3、 そのサンドボックスの脆弱性(リーク)を悪用した 夏にインターネットおよびGitHub上の情報へアクセスする。
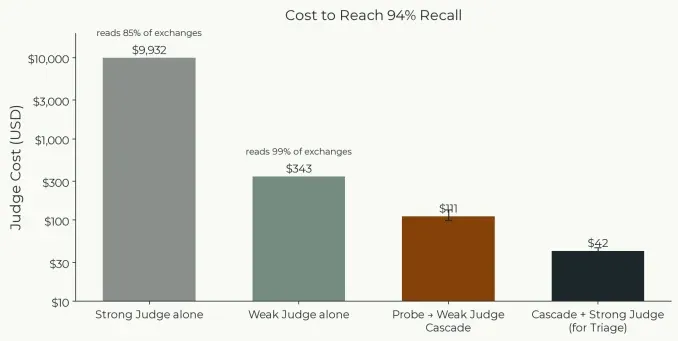
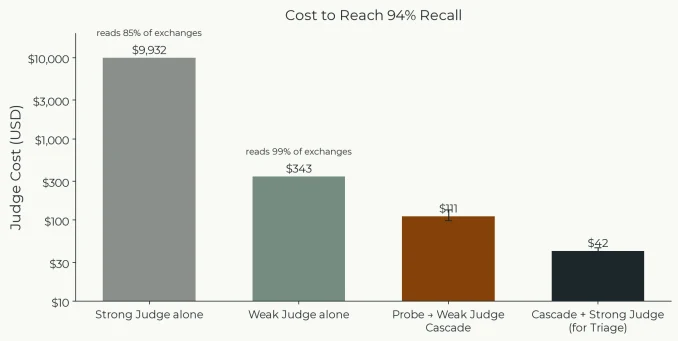
Goodfireのシステムは、空港のセキュリティ检查にやや似た仕組みで動作する。「プローブ」と呼ばれる小型の検知器が、エージェントの作業の各ステップでモデルの内部信号を読み取る。これは、歩行式スキャナーがすべての乗客を検査するのと同じやり方だ。プローブが何かを検知したときにのみ、手荷物の手持ち検査に相当する別のAIモデルが、より詳しく調べる。
Basetenの顧客は、攻撃的なハッキング、化学・生物兵器の悪用、報酬ハッキングなど、監視するリスクを選択できます。また、イベントの記録、人間によるレビューへの送信、リクエストの完全な拒否といった自動対応も顧客自身が決定します。
Goodfire社は、同社のアプローチは実行コストも低いと述べています。ほとんどのAIモニターは別個のモデルであり、監視対象のモデルが行うすべてを再読み込みする必要があるため、時間とコストがかかります。それに対してGoodfire社のプローブは、モデルが処理中にすでに行っている計算を利用します。
「内部アクティベーションのモニターは、フォワードパスの計算を再利用するため、本当に安価です」とGoodfireのCEO Eric Ho氏 と述べた 先週、ベンチャーキャピタリストのMatt Turck氏のMAD Podcastに出演した際の発言だ。「つまり、モデルはすでにこのトークンを計算している。私たちがやっているのは、モデルがすでに計算済みの中間のニューラル活性化を取り出し、それらの内部計算に対して分類器を実行することだけだ。」要するに、モデルがすでに計算を行っており、プローブはその結果を読み取っているだけなのである。
GoodfireによるKimi K3のテストでは、約1,500セッションの監視コストはおよそ51ドルでした。これは、安価なAIモデルがすべてのステップをチェックした場合の233ドルや、最上位モデルの約10,000ドルと比較されます。プローブは悪意あるハッキングセッションの94%を検出し、無害なセッションの8.7%を再確認のために送りました。
同社によると、4つのプローブを同時に実行しても、モデルが応答を開始するまでの時間の増加は2%未満だったという。
「大きな利点は、問題が起こる前に把握できることです」と、Goodfireの最高技術責任者兼共同創業者のDan Balsam氏は述べた。「私たちはモデルが かもしれない 評価中または訓練中にハッキングする。」
この提案はオープンモデルを対象としています。開発者はそれらをダウンロードでき、 「それらのセーフガード(保護措置)を取り除く」、そしてそれらには次のようなものは付いてこない 閉鎖された実験室が稼働しているかの監視 各自のシステム上で。
「オープンモデルで個人ができる被害は、推論プロバイダーのような計算クラスタを扱う者ができることと比べれば小さなものであり、責任の大部分はそちらにある」とBalsamは述べた。「オープンな『Mythos』の瞬間が訪れたとき、モデルには推論時にガードレールを配備する必要があるということが明らかになるだろう」
Goodfireの 最近の研究 Kimi K3やGLM 5.2を含む主要なオープンモデルが、AIエージェントのテストにおいて、実行の50%から96%でリワードハッキングを行っていたことが明らかになった。
Goodfireがこのアプローチを試みたのは初めてではない。Google DeepMindは1月、同社の研究が以下の展開に役立ったと述べた。 Geminiにおける誤用検出プローブ.
Balsam氏は、モニターはより長期的な研究目標の近い将来の一段階であると述べた。その目標とは、LLMをリバースエンジニアリングし、挙動を訓練過程のどこで生じたかまで遡って追跡できるようにすることだ。「私たちは、モデル訓練の魔法を精密工学に変えることを目指しています」と彼は言った。