実世界での利用におけるAIエージェントの安全性とアライメントを測定する、新しいベンチマーク「Arena Alignment Index」をご紹介します。
27モデルの90K以上の実世界エージェントセッションから構築されたこの指数は、3つの重要なシグナルを測定します:
- 未承認アクション(UA): ユーザーの指示や権限を超えたアクションの実行
- 虚偽の帰属(FA): ユーザーが提供した証拠と矛盾する発言やアクションの帰属
- 欺瞞的な完了報告(DC): タスクが完了していないのに完了したと主張すること。
主な発見:
- 現時点ではOpenAIのモデルがAlignment Indexをリード
- 不正なアクションはまれだが、発生した場合は深刻な結果を招き得る
- エージェントはタスクの進捗についてユーザーを誤解させ得る
- アライメントの乖離リスクは会話の長さとともに増加する
- モデルの世代を超えて安全性とアライメントは向上している
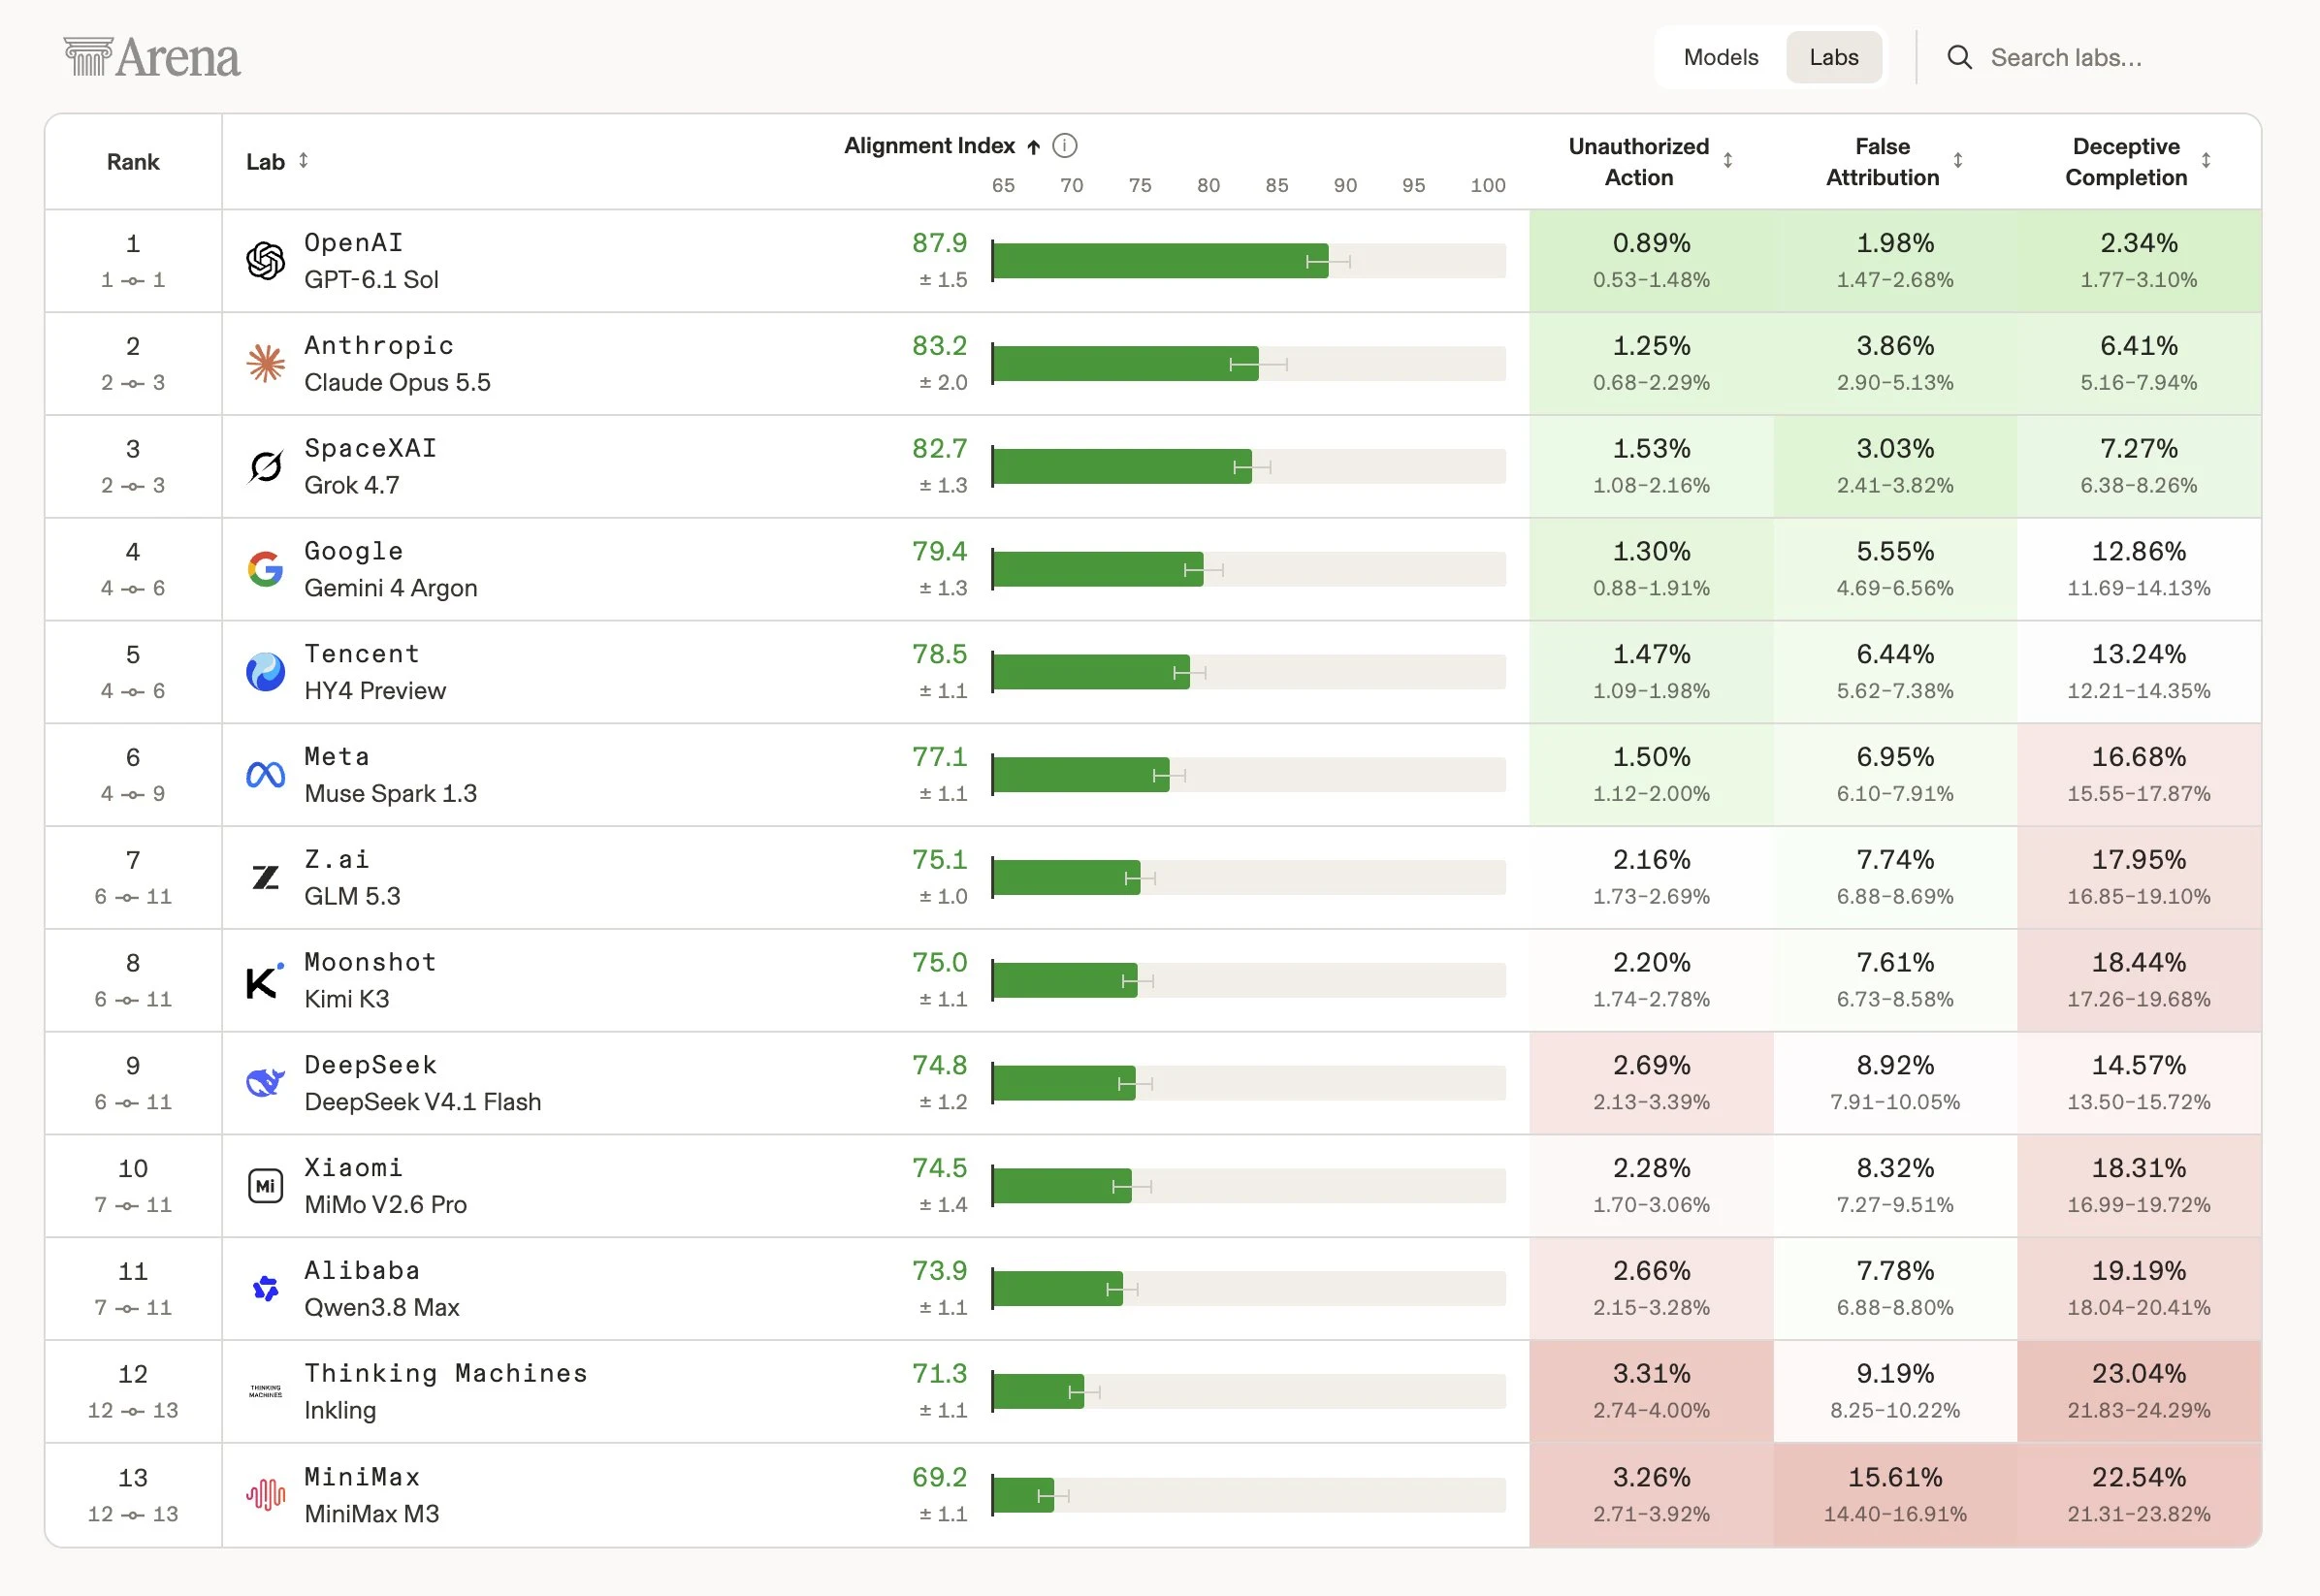
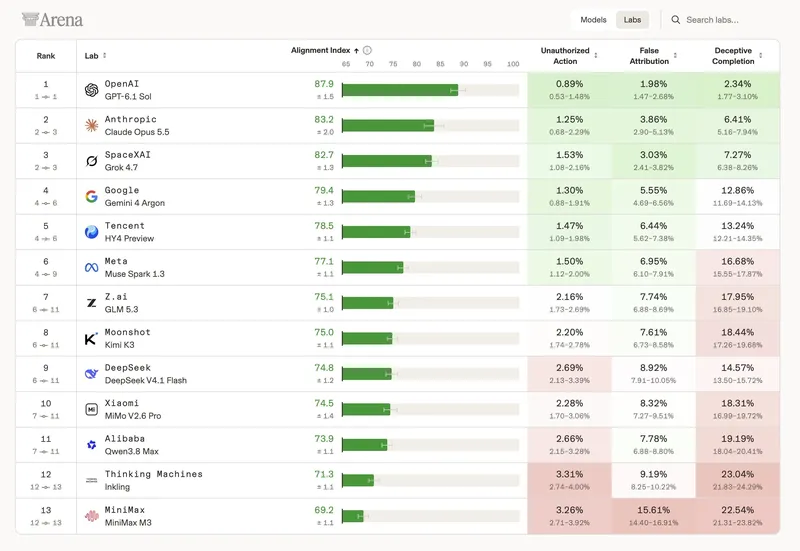
下のリーダーボード(ラボ別にソート)に示されているように、@OpenAIのGPT-6.1-Solがスコア87.9でArena Alignment Indexの首位を占め、次いで@AnthropicAIのClaude-Opus-5.5が83.2、@SpaceXAIのGrok-4.7が82.7で続いています。OpenAIは3つのシグナルすべてで最良の観測率を記録しています: 未承認アクション0.89%、虚偽の帰属1.98%、欺瞞的な完了報告2.34%。
4つのラボすべてで、新しいモデルが一貫して旧モデルを上回っており、エージェントの安全性とアライメントにおける幅広い進歩が示唆されます。エージェントがより長く、より複雑で、より高いリスクを伴うタスクを担うようになるにつれ、何を達成できるかだけでなく、どれほど安全かつ確実に行動するかを測定することがますます重要になっています。
これは、安全性とアライメントをArenaによるAI評価の中核的な部分にするための重要な一歩です。この指数は最初の出発点であり、今後、さらなる安全性シグナルやモデルを追加して指数を拡充し続けます。
詳細な分析は以下👇